
PerfectScale
Aislamiento de namespaces en Kubernetes: RBAC y Network Policy
Cómo namespaces, RBAC, NetworkPolicy y ResourceQuota funcionan en conjunto para aislar tenants en Kubernetes, con ejemplos en YAML y una checklist práctica.
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Un namespace traza una frontera de nombres, no de seguridad. Por sí solo, no impide el acceso a la API entre namespaces, el tráfico de red ni la contención de recursos.
- RBAC controla quién puede actuar sobre los recursos de un namespace. Deniega por defecto: nadie tiene acceso hasta que otorgas un Role y lo vinculas.
- NetworkPolicy controla qué puede comunicarse con qué. Aquí Kubernetes hace lo contrario de RBAC: cada pod puede alcanzar a cualquier otro pod hasta que agregas una política que lo restrinja.
- ResourceQuota y LimitRange limitan cuánto puede consumir un namespace, tanto en cómputo como en cantidad de objetos, para que un tenant no deje sin recursos al resto del clúster ni al plano de control.
- Nada de esto viene configurado. Tienes que agregar cada control, namespace por namespace, o el aislamiento simplemente no existe.
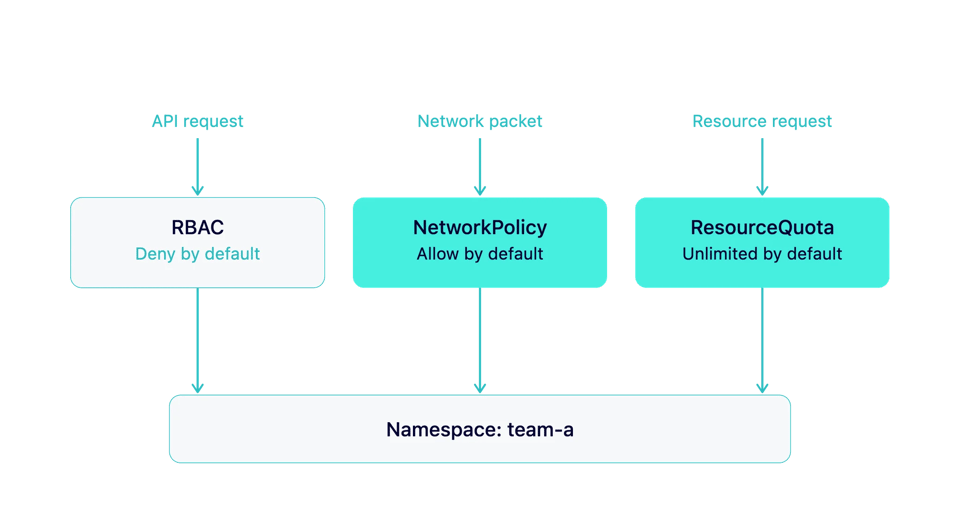
Los namespaces parecen aislamiento. Crea uno para el equipo A y otro para el equipo B, y los pods, servicios y configuraciones de ambos equipos quedan en compartimentos separados con nombres separados. Ahí termina la frontera. Nada en un namespace, por sí mismo, impide que la service account del equipo A lea los secrets del equipo B, que los pods del equipo A abran una conexión a la base de datos del equipo B, o que los workloads del equipo A dejen sin recursos a los pods del equipo B en un nodo compartido.
La multitenencia en Kubernetes se apoya en tres controles que convierten esa frontera de nombres en una frontera real de seguridad y recursos: RBAC, NetworkPolicy y ResourceQuota. Cada uno gobierna un tipo de acceso distinto, y cada uno tiene un valor por defecto que toma a los equipos por sorpresa.
RBAC: controlar quién puede actuar
RBAC decide qué usuarios, grupos y service accounts pueden hacer qué sobre qué recursos y en qué namespaces. Su estado por defecto juega a tu favor: una service account o un usuario tiene cero permisos hasta que un Role otorga algunos y un RoleBinding se lo asigna. Nada se filtra por accidente.
Un Role con alcance de namespace limita el radio de impacto de ese permiso a un solo namespace:
apiVersion: rbac.authorization.k8s.io/v1kind: Rolemetadata: namespace: team-a name: team-a-editorrules: - apiGroups: ["", "apps"] resources: ["pods", "deployments", "services"] verbs: ["get", "list", "watch", "create", "update", "patch"]---apiVersion: rbac.authorization.k8s.io/v1kind: RoleBindingmetadata: name: team-a-editor-binding namespace: team-asubjects: - kind: Group name: team-a-engineers apiGroup: rbac.authorization.k8s.ioroleRef: kind: Role name: team-a-editor apiGroup: rbac.authorization.k8s.ioTres hábitos evitan que RBAC se convierta en un riesgo por sí mismo:
Vincula a grupos, no a usuarios individuales. Un RoleBinding atado a usuarios con nombre queda obsoleto en cuanto alguien cambia de equipo; un binding a grupos se actualiza automáticamente cuando cambia la membresía de grupos en tu proveedor de identidad.
Vigila los ClusterRoleBindings otorgados por conveniencia del tenant. Un ClusterRole vinculado a nivel de clúster reparte acceso a todos los namespaces del clúster, lo que anula por completo el propósito de acotar un Role a team-a. Recurre a un ClusterRole solo cuando realmente lo necesites, y vincúlalo con un RoleBinding acotado al namespace siempre que sea posible.
Revisa los bindings con regularidad. La proliferación de RBAC (decenas de Roles casi duplicados y bindings obsoletos de personas que dejaron el equipo) hace que una auditoría tome días en lugar de minutos. Una revisión trimestral detecta las desviaciones antes de que se conviertan en un incidente de seguridad.
RBAC también decide quién puede leer los Kubernetes Secrets y gestionar la propiedad de los recursos dentro de un namespace, así que un Role demasiado amplio expone más que el acceso a cómputo. Y cuando RBAC bloquea una solicitud, Kubernetes devuelve un error Forbidden en lugar de un 404, una distinción que vale la pena conocer cuando depuras errores del clúster.
NetworkPolicy: controlar qué puede comunicarse con qué
Invierte el default de RBAC y obtienes el estado inicial de NetworkPolicy. Kubernetes viene con una red plana: cualquier pod puede abrir una conexión a cualquier otro pod del clúster, a través de todos los namespaces, a menos que algo lo bloquee. Una NetworkPolicy lo bloquea en cuanto agregas una; hasta entonces, el estricto control de acceso de RBAC no hace nada para impedir que un pod comprometido cruce las fronteras entre namespaces a través de la red.
Empieza con una política de denegación por defecto en cada namespace:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: default-deny-all namespace: team-aspec: podSelector: {} policyTypes: - Ingress - EgressCuando deniegas el egress, también bloqueas el DNS. CoreDNS normalmente se ejecuta en el namespace kube-system en el puerto 53. Sin acceso a DNS, los pods de team-a no pueden resolver los nombres de servicio, así que las aplicaciones que dependen del DNS empezarán a fallar. Permite el DNS antes de agregar otras reglas de egress: apiVersion: networking.k8s.io/v1 kind: NetworkPolicy metadata: name: allow-dns namespace: team-a spec: podSelector: {} policyTypes: - Egress egress: - to: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: kube-system ports: - protocol: UDP port: 53 - protocol: TCP port: 53
Luego agrega permisos explícitos para lo que realmente necesita comunicarse. Esta política solo permite el tráfico de otros pods del mismo namespace:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: allow-same-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-aHay un detalle que sorprende a los equipos que nunca lo han sufrido: NetworkPolicy solo funciona si tu plugin CNI la aplica. Calico, Cilium y unos cuantos más implementan la API de NetworkPolicy; algunos plugins CNI no lo hacen, y en esos casos, el servidor de API acepta tus políticas cuidadosamente escritas y la capa de red las ignora en silencio. Confirma que tu CNI aplica NetworkPolicy antes de tratarla como una frontera real, no después.
ResourceQuota y LimitRange: limitar cuánto puede usar un namespace
RBAC y NetworkPolicy frenan el acceso. ResourceQuota frena el consumo. Sin una cuota, un namespace puede solicitar suficiente CPU y memoria como para no dejar nada al resto del clúster, o crear tantos objetos que ralentice el servidor de API para todos los tenants, lo que activa el mismo mecanismo detrás del problema del vecino ruidoso.
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50" count/deployments.apps: "20"Esa última línea importa tanto como los límites de cómputo que la preceden. Una cuota solo de cómputo sigue permitiendo que un namespace cree Deployments, ConfigMaps o Services sin límite, lo que sobrecarga etcd y ralentiza el plano de control para todos los demás tenants del clúster. Limitar la cantidad de objetos protege aquello que todos los namespaces comparten.
Acompaña la cuota con un LimitRange para que los pods que no declaran sus propios requests y limits reciban valores por defecto razonables en lugar de ser rechazados de plano, y define un máximo por contenedor para que ningún pod pueda reclamar todo el presupuesto del namespace. Para conocer la mecánica completa, incluyendo cómo dimensionar los números según el uso real en lugar de adivinar, consulta la guía dedicada a ResourceQuotas y LimitRanges.
Checklist de aislamiento de namespaces
- Trata el namespace como una etiqueta, no como una frontera; agrega RBAC, NetworkPolicy y ResourceQuota antes de considerarlo aislado
- Vincula los Roles de RBAC a grupos y acótalos al namespace, salvo que un workload realmente necesite acceso a todo el clúster
- Agrega una NetworkPolicy de denegación por defecto a cada namespace de tenant y luego suma permisos explícitos
- Confirma que tu CNI realmente aplica NetworkPolicy antes de confiar en ella
- Define cuotas de cómputo y de cantidad de objetos en cada namespace de tenant
- Acompaña cada ResourceQuota con un LimitRange para que los pods reciban valores por defecto razonables en lugar de ser rechazados
- Revisa los bindings de RBAC y los valores de las cuotas con regularidad; ambos se desvían a medida que cambian los equipos y los workloads
Preguntas frecuentes
¿Cuál es la diferencia entre RBAC y NetworkPolicy en Kubernetes? RBAC controla el acceso a la API: qué usuarios, grupos y service accounts pueden crear, leer, actualizar o eliminar qué objetos de Kubernetes. NetworkPolicy controla el tráfico de red: qué pods pueden enviar paquetes a qué otros pods. Un usuario puede tener acceso RBAC completo a un namespace y aun así tener sus pods bloqueados para comunicarse con otro namespace a través de la red, y a la inversa: el acceso abierto a la red no otorga ningún permiso de API.
¿NetworkPolicy de Kubernetes funciona con cualquier CNI? No. Kubernetes expone NetworkPolicy como una API, pero aplicarla es responsabilidad del plugin CNI. Calico, Cilium y varios otros la implementan; algunos plugins CNI aceptan objetos NetworkPolicy sin aplicarlos en absoluto. Revisa la documentación de tu CNI antes de tratar NetworkPolicy como una frontera de seguridad real.
¿Las ResourceQuotas se aplican automáticamente a los namespaces nuevos? No. Creas una ResourceQuota por namespace, igual que cualquier otro objeto de Kubernetes. Los equipos que quieren que cada namespace reciba una cuota automáticamente suelen imponerlo mediante plantillas de GitOps o un controlador de admisión (como Kyverno u OPA Gatekeeper) que genera una cuota por defecto en el momento en que alguien crea un namespace.
El aislamiento solo se sostiene si los números se mantienen al día
Una vez configurados, RBAC y NetworkPolicy solo necesitan auditorías periódicas. ResourceQuota funciona distinto: solo protege el clúster cuando los requests y limits que la respaldan coinciden con lo que los workloads realmente usan, y esa coincidencia se rompe cada vez que un workload cambia. PerfectScale by DoiT mantiene los requests y limits ajustados al uso real a medida que los workloads evolucionan, de modo que a los namespaces regidos por cuotas se les aplica right-sizing en lugar de dejarlos sobreaprovisionados para mantenerse con margen bajo el tope, y te da la visibilidad por namespace para detectar qué tenant está más cerca de su límite antes de que se convierta en un incidente.
¿Quieres verlo en un clúster real? Únete al taller en vivo sobre multitenencia el 29 de septiembre o agenda una sesión técnica.