
PerfectScale
Namespace Kubernetes: come trasformarli in un vero confine di sicurezza
Come namespace, RBAC, NetworkPolicy e ResourceQuota lavorano insieme per isolare i tenant in Kubernetes, con esempi YAML e una checklist pratica.
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Un namespace delimita i nomi, non la sicurezza. Da solo non impedisce l'accesso API tra namespace, il traffico di rete o la contesa di risorse.
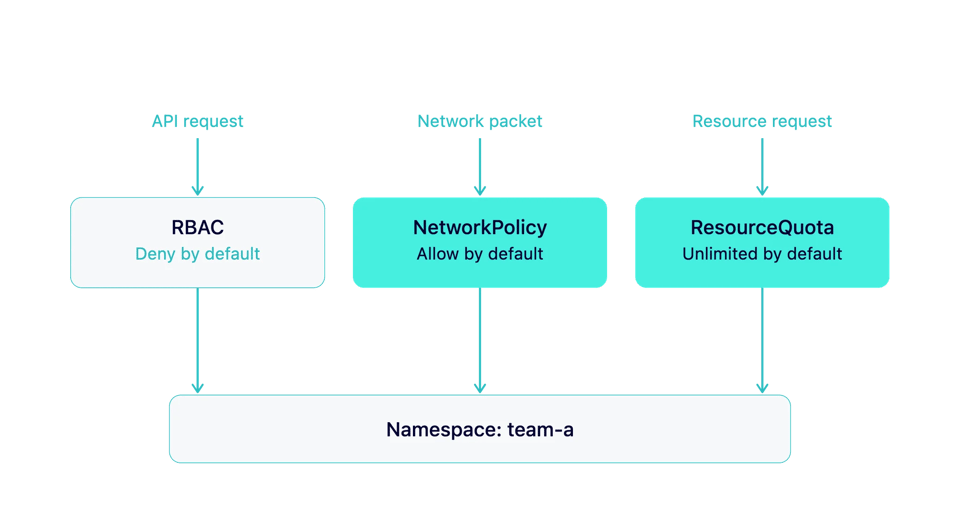
- RBAC controlla chi può agire sulle risorse di un namespace. Nega per impostazione predefinita: nessuno ottiene accesso finché non si concede un Role e lo si assegna con un binding.
- NetworkPolicy controlla cosa può comunicare con cosa. Qui Kubernetes fa l'esatto contrario di RBAC: ogni pod può raggiungere qualsiasi altro pod finché non si aggiunge una policy che lo limita.
- ResourceQuota e LimitRange pongono un tetto a quanto un namespace può consumare, sia in risorse di calcolo sia in numero di oggetti, così un singolo tenant non può sottrarre risorse al resto del cluster o al control plane.
- Nulla di tutto questo arriva già configurato. Ognuno di questi controlli va aggiunto, namespace per namespace, altrimenti l'isolamento semplicemente non esiste.
I namespace sembrano garantire isolamento. Se ne crea uno per il team A e uno per il team B, e i pod, i service e le configurazioni dei due team finiscono in contenitori separati con nomi separati. Ma il confine si ferma lì. Nulla in un namespace, di per sé, impedisce al service account del team A di leggere i secret del team B, ai pod del team A di aprire una connessione verso il database del team B, o ai workloads del team A di sottrarre risorse ai pod del team B su un nodo condiviso.
La multi-tenancy in Kubernetes si regge su tre controlli che trasformano quel confine di nomi in un vero confine di sicurezza e di risorse: RBAC, NetworkPolicy e ResourceQuota. Ognuno governa un tipo diverso di accesso, e ognuno ha un comportamento predefinito che coglie i team di sorpresa.
RBAC: controllare chi può agire
RBAC decide quali utenti, gruppi e service account possono fare cosa, su quali risorse e in quali namespace. Il suo stato predefinito gioca a nostro favore: un service account o un utente ha zero permessi finché un Role non ne concede alcuni e un RoleBinding non glielo assegna. Nulla viene esposto per errore.
Un Role con scope di namespace limita il raggio d'impatto di quella concessione a un singolo namespace:
apiVersion: rbac.authorization.k8s.io/v1kind: Rolemetadata: namespace: team-a name: team-a-editorrules: - apiGroups: ["", "apps"] resources: ["pods", "deployments", "services"] verbs: ["get", "list", "watch", "create", "update", "patch"]---apiVersion: rbac.authorization.k8s.io/v1kind: RoleBindingmetadata: name: team-a-editor-binding namespace: team-asubjects: - kind: Group name: team-a-engineers apiGroup: rbac.authorization.k8s.ioroleRef: kind: Role name: team-a-editor apiGroup: rbac.authorization.k8s.ioTre abitudini evitano che RBAC diventi a sua volta un rischio:
Creare binding verso gruppi, non verso singoli utenti. Un RoleBinding legato a utenti nominali diventa obsoleto nel momento in cui qualcuno cambia team; un binding a un gruppo si aggiorna automaticamente quando cambia la composizione del gruppo nell'identity provider.
Fare attenzione ai ClusterRoleBinding concessi per comodità dei tenant. Un ClusterRole associato a livello di cluster distribuisce l'accesso a ogni namespace del cluster, vanificando in partenza il senso di limitare un Role a team-a. Ricorrere a un ClusterRole solo quando serve davvero, e associarlo con un RoleBinding con scope di namespace quando possibile.
Rivedere i binding a scadenze regolari. La proliferazione di RBAC (decine di Role quasi identici e binding obsoleti riferiti a persone che hanno lasciato il team) trasforma un audit da questione di minuti a questione di giorni. Un controllo trimestrale intercetta le derive prima che diventino un incidente di sicurezza.
RBAC decide anche chi può leggere i Kubernetes Secrets e gestire la ownership delle risorse all'interno di un namespace, quindi un Role troppo ampio espone ben più del semplice accesso alle risorse di calcolo. E quando RBAC blocca una richiesta, Kubernetes restituisce un errore Forbidden anziché un 404, una distinzione utile da conoscere quando si fa il debug degli errori del cluster.
NetworkPolicy: controllare cosa può comunicare con cosa
Basta capovolgere il default di RBAC per ottenere lo stato di partenza di NetworkPolicy. Kubernetes nasce con una rete piatta: qualsiasi pod può aprire una connessione verso qualsiasi altro pod del cluster, attraverso tutti i namespace, a meno che qualcosa non lo blocchi. Una NetworkPolicy lo blocca, ma solo dopo che è stata aggiunta; fino a quel momento, il rigoroso controllo degli accessi di RBAC non fa nulla per impedire a un pod compromesso di attraversare i confini dei namespace via rete.
Il punto di partenza è una policy default-deny per ogni namespace:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: default-deny-all namespace: team-aspec: podSelector: {} policyTypes: - Ingress - EgressNegando l'egress si blocca anche il DNS. CoreDNS gira normalmente nel namespace kube-system sulla porta 53. Senza accesso al DNS, i pod in team-a non possono risolvere i nomi dei service, quindi le applicazioni che dipendono dal DNS inizieranno a fallire. Consentire il DNS prima di aggiungere altre regole di egress: apiVersion: networking.k8s.io/v1 kind: NetworkPolicy metadata: name: allow-dns namespace: team-a spec: podSelector: {} policyTypes: - Egress egress: - to: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: kube-system ports: - protocol: UDP port: 53 - protocol: TCP port: 53
A quel punto si aggiungono permessi espliciti per ciò che deve davvero comunicare. Questa policy consente il traffico solo dai pod dello stesso namespace:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: allow-same-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-aC'è un tranello che coglie di sorpresa chi non l'ha mai incontrato: NetworkPolicy funziona solo se il plugin CNI la applica. Calico, Cilium e pochi altri implementano l'API NetworkPolicy; alcuni plugin CNI no, e su questi le policy scritte con cura vengono accettate dall'API server e silenziosamente ignorate a livello di rete. Verificare che il proprio CNI applichi le NetworkPolicy prima di considerarle un confine reale, non dopo.
ResourceQuota e LimitRange: limitare quanto un namespace può consumare
RBAC e NetworkPolicy fermano gli accessi. ResourceQuota ferma i consumi. Senza una quota, un namespace può richiedere abbastanza CPU e memoria da non lasciare nulla al resto del cluster, o creare abbastanza oggetti da rallentare l'API server per tutti i tenant, innescando lo stesso meccanismo alla base del problema del noisy neighbor.
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50" count/deployments.apps: "20"Quell'ultima riga conta quanto i limiti di calcolo che la precedono. Una quota limitata al solo compute lascia comunque che un namespace crei Deployment, ConfigMap o Service senza limiti, sovraccaricando etcd e rallentando il control plane per tutti gli altri tenant del cluster. Limitare il numero di oggetti protegge ciò che ogni namespace condivide.
È bene abbinare la quota a un LimitRange, così i pod che non dichiarano richieste e limiti propri ricevono valori predefiniti sensati invece di essere rifiutati, e impostare un massimo per container in modo che nessun singolo pod possa accaparrarsi l'intero budget del namespace. Per il funzionamento completo, incluso come dimensionare i valori sull'uso reale invece di tirare a indovinare, si veda la guida dedicata a ResourceQuota e LimitRange.
Checklist per l'isolamento dei namespace
- Trattare il namespace come un'etichetta, non come un confine; aggiungere RBAC, NetworkPolicy e ResourceQuota prima di considerarlo isolato
- Associare i Role RBAC ai gruppi e limitarli al namespace, a meno che un workload non richieda davvero un accesso a livello di cluster
- Aggiungere una NetworkPolicy default-deny a ogni namespace tenant, per poi stratificare permessi espliciti
- Verificare che il CNI applichi effettivamente le NetworkPolicy prima di farvi affidamento
- Impostare sia quote di calcolo sia quote sul numero di oggetti in ogni namespace tenant
- Abbinare ogni ResourceQuota a un LimitRange, così i pod ricevono valori predefiniti sensati invece di essere rifiutati
- Rivedere binding RBAC e valori delle quote a scadenze regolari; entrambi si disallineano man mano che team e workloads cambiano
FAQ
Qual è la differenza tra RBAC e NetworkPolicy in Kubernetes? RBAC controlla l'accesso alle API: quali utenti, gruppi e service account possono creare, leggere, aggiornare o eliminare quali oggetti Kubernetes. NetworkPolicy controlla il traffico di rete: quali pod possono inviare pacchetti a quali altri pod. Un utente può avere pieno accesso RBAC a un namespace e vedere comunque i propri pod bloccati nel comunicare con un altro namespace via rete, e vale anche il contrario: un accesso di rete aperto non concede alcun permesso API.
NetworkPolicy di Kubernetes funziona con qualsiasi CNI? No. Kubernetes espone NetworkPolicy come API, ma la sua applicazione spetta al plugin CNI. Calico, Cilium e diversi altri la implementano; alcuni plugin CNI accettano gli oggetti NetworkPolicy senza applicarli affatto. Prima di considerare NetworkPolicy un vero confine di sicurezza, consultare la documentazione del proprio CNI.
Le ResourceQuota si applicano automaticamente ai nuovi namespace? No. La ResourceQuota va creata per ciascun namespace, come qualsiasi altro oggetto Kubernetes. I team che vogliono assegnare automaticamente una quota a ogni namespace di solito lo impongono tramite template GitOps o un admission controller (come Kyverno o OPA Gatekeeper) che genera una quota predefinita nel momento in cui qualcuno crea un namespace.
L'isolamento regge solo se i numeri restano corretti
Una volta impostati, RBAC e NetworkPolicy richiedono per lo più audit periodici. ResourceQuota funziona diversamente: protegge il cluster solo quando le richieste e i limiti su cui si basa corrispondono a ciò che i workloads usano davvero, e questa corrispondenza cambia ogni volta che un workload cambia. PerfectScale by DoiT mantiene richieste e limiti allineati all'uso reale man mano che i workloads evolvono: i namespace governati da quote ricevono così un right-sizing continuo invece di restare sovradimensionati per stare al sicuro sotto il tetto, e offre la visibilità per namespace necessaria a individuare quale tenant è più vicino al proprio limite prima che diventi un incidente.
Vuole vederlo all'opera su un cluster reale? Partecipi al workshop live sulla multitenancy del 29 settembre, oppure prenoti una sessione tecnica.