
PerfectScale
Kubernetes-Namespaces wirklich isolieren: RBAC & Network Policy
Wie Namespaces, RBAC, NetworkPolicy und ResourceQuota Tenants in Kubernetes gemeinsam isolieren – mit YAML-Beispielen und praktischer Checkliste.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Ein Namespace zieht eine Namensgrenze, keine Sicherheitsgrenze. Er verhindert für sich genommen weder namespace-übergreifende API-Zugriffe noch Netzwerkverkehr noch Ressourcenkonflikte.
- RBAC steuert, wer auf die Ressourcen eines Namespace zugreifen darf. Standardmäßig wird alles verweigert: Niemand erhält Zugriff, bis Sie eine Role anlegen und per Binding zuweisen.
- NetworkPolicy steuert, was mit wem kommunizieren darf. Hier macht Kubernetes das Gegenteil von RBAC: Jeder Pod erreicht jeden anderen Pod, bis Sie eine Policy hinzufügen, die das einschränkt.
- ResourceQuota und LimitRange begrenzen, wie viel ein Namespace verbrauchen darf – sowohl bei den Rechenressourcen als auch bei der Objektanzahl –, damit ein einzelner Tenant nicht den Rest des Clusters oder die Control Plane aushungert.
- Nichts davon ist vorkonfiguriert. Sie müssen jede dieser Maßnahmen pro Namespace selbst einrichten, sonst existiert die Isolation nicht.
Namespaces sehen aus wie Isolation. Legen Sie einen für Team A und einen für Team B an, und die Pods, Services und Configs der beiden Teams liegen sauber getrennt in eigenen Bereichen mit eigenen Namen. Genau dort endet die Grenze aber auch. Nichts an einem Namespace verhindert für sich genommen, dass der Service-Account von Team A die Secrets von Team B liest, dass Pods von Team A eine Verbindung zur Datenbank von Team B öffnen oder dass Workloads von Team A die Pods von Team B auf einem gemeinsamen Node aushungern.
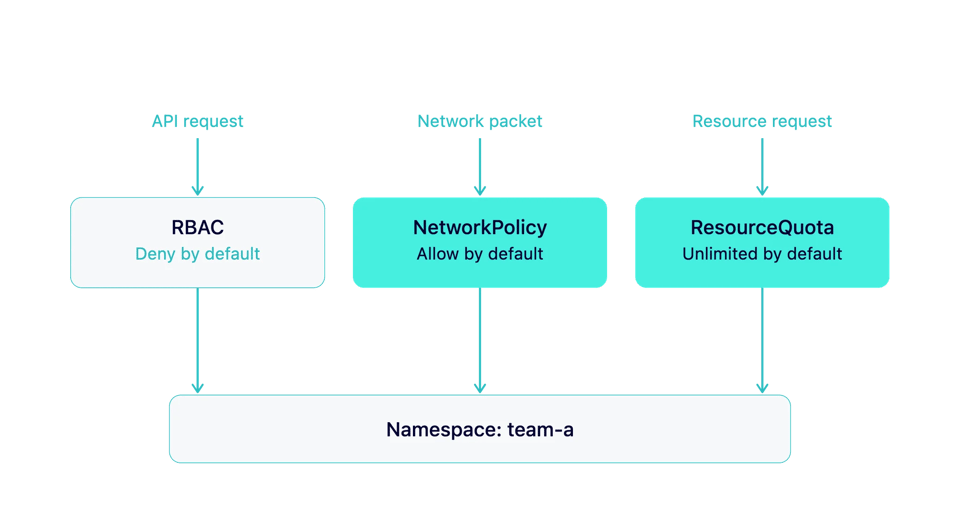
Kubernetes-Multi-Tenancy basiert auf drei Kontrollmechanismen, die aus dieser Namensgrenze eine echte Sicherheits- und Ressourcengrenze machen: RBAC, NetworkPolicy und ResourceQuota. Jeder regelt eine andere Art von Zugriff, und jeder hat einen eigenen Standardzustand, der Teams kalt erwischt.
RBAC: Wer darf was?
RBAC entscheidet, welche User, Gruppen und Service-Accounts was mit welchen Ressourcen in welchen Namespaces tun dürfen. Der Standardzustand kommt Ihnen dabei entgegen: Ein Service-Account oder User hat null Berechtigungen, bis eine Role welche gewährt und ein RoleBinding diese Role zuweist. So gelangt nichts versehentlich nach außen.
Eine namespace-gebundene Role begrenzt den Wirkungsbereich dieser Berechtigung auf einen einzigen Namespace:
apiVersion: rbac.authorization.k8s.io/v1kind: Rolemetadata: namespace: team-a name: team-a-editorrules: - apiGroups: ["", "apps"] resources: ["pods", "deployments", "services"] verbs: ["get", "list", "watch", "create", "update", "patch"]---apiVersion: rbac.authorization.k8s.io/v1kind: RoleBindingmetadata: name: team-a-editor-binding namespace: team-asubjects: - kind: Group name: team-a-engineers apiGroup: rbac.authorization.k8s.ioroleRef: kind: Role name: team-a-editor apiGroup: rbac.authorization.k8s.ioDrei Gewohnheiten verhindern, dass RBAC selbst zum Risiko wird:
Binden Sie an Gruppen, nicht an einzelne User. Ein RoleBinding auf namentlich genannte User veraltet in dem Moment, in dem jemand das Team wechselt; ein Gruppen-Binding aktualisiert sich automatisch, sobald sich die Gruppenmitgliedschaft in Ihrem Identity Provider ändert.
Achten Sie auf ClusterRoleBindings, die aus Bequemlichkeit für einzelne Tenants vergeben wurden. Eine clusterweit gebundene ClusterRole gewährt Zugriff auf jeden Namespace im Cluster – und macht damit den Sinn einer auf team-a begrenzten Role zunichte. Greifen Sie nur dann zu einer ClusterRole, wenn Sie sie wirklich brauchen, und binden Sie sie wenn möglich mit einem namespace-gebundenen RoleBinding.
Überprüfen Sie Bindings regelmäßig. RBAC-Wildwuchs (Dutzende nahezu identische Roles und verwaiste Bindings für Personen, die das Team längst verlassen haben) lässt ein Audit Tage statt Minuten dauern. Ein vierteljährlicher Check fängt Drift ab, bevor daraus ein Sicherheitsvorfall wird.
RBAC entscheidet außerdem, wer Kubernetes Secrets lesen und Resource Ownership innerhalb eines Namespace verwalten darf – eine zu breit gefasste Role gibt also mehr preis als nur Compute-Zugriff. Und wenn RBAC eine Anfrage blockiert, liefert Kubernetes einen Forbidden-Fehler statt eines 404 – ein Unterschied, den man beim Debuggen von Cluster-Fehlern kennen sollte.
NetworkPolicy: Wer darf mit wem sprechen?
Drehen Sie den RBAC-Standard um, und Sie haben den Ausgangszustand von NetworkPolicy. Kubernetes bringt von Haus aus ein flaches Netzwerk mit: Jeder Pod kann eine Verbindung zu jedem anderen Pod im Cluster öffnen, über alle Namespaces hinweg – solange nichts das blockiert. Eine NetworkPolicy blockiert es, sobald Sie eine anlegen; bis dahin nützt die strikte Zugriffskontrolle von RBAC nichts, um einen kompromittierten Pod daran zu hindern, über das Netzwerk Namespace-Grenzen zu überschreiten.
Starten Sie mit einer Default-Deny-Policy pro Namespace:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: default-deny-all namespace: team-aspec: podSelector: {} policyTypes: - Ingress - EgressWenn Sie Egress verweigern, blockieren Sie damit auch DNS. CoreDNS läuft normalerweise im Namespace kube-system auf Port 53. Ohne DNS-Zugriff können Pods in team-a keine Service-Namen auflösen, sodass Anwendungen, die auf DNS angewiesen sind, ausfallen. Erlauben Sie daher DNS, bevor Sie weitere Egress-Regeln hinzufügen: apiVersion: networking.k8s.io/v1 kind: NetworkPolicy metadata: name: allow-dns namespace: team-a spec: podSelector: {} policyTypes: - Egress egress: - to: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: kube-system ports: - protocol: UDP port: 53 - protocol: TCP port: 53
Fügen Sie anschließend explizite Freigaben für das hinzu, was tatsächlich kommunizieren muss. Diese Policy erlaubt Traffic nur von anderen Pods im selben Namespace:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: allow-same-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-aEin Stolperstein erwischt jedes Team, das ihn noch nicht kennt: NetworkPolicy funktioniert nur, wenn Ihr CNI-Plugin sie durchsetzt. Calico, Cilium und eine Handvoll anderer implementieren die NetworkPolicy-API; manche CNI-Plugins tun das nicht – dort nimmt der API-Server Ihre sorgfältig geschriebenen Policies an, und auf Netzwerkebene werden sie stillschweigend ignoriert. Prüfen Sie, ob Ihr CNI NetworkPolicy durchsetzt, bevor Sie sie als echte Grenze behandeln – nicht danach.
ResourceQuota und LimitRange: Wie viel darf ein Namespace verbrauchen?
RBAC und NetworkPolicy stoppen Zugriffe. ResourceQuota stoppt den Verbrauch. Ohne Quota kann ein einzelner Namespace so viel CPU und Speicher anfordern, dass für den Rest des Clusters nichts übrig bleibt – oder so viele Objekte anlegen, dass der API-Server für alle Tenants langsamer wird. Das ist derselbe Mechanismus wie beim Noisy-Neighbor-Problem.
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50" count/deployments.apps: "20"Die letzte Zeile ist genauso wichtig wie die Compute-Limits darüber. Eine reine Compute-Quota erlaubt einem Namespace weiterhin, unbegrenzt Deployments, ConfigMaps oder Services zu erstellen – das überlastet etcd und bremst die Control Plane für alle anderen Tenants im Cluster aus. Die Objektanzahl zu begrenzen schützt genau das, was sich alle Namespaces teilen.
Kombinieren Sie die Quota mit einer LimitRange, damit Pods, die keine eigenen Requests und Limits deklarieren, sinnvolle Defaults erhalten, statt direkt abgelehnt zu werden – und setzen Sie ein Maximum pro Container, damit kein einzelner Pod das gesamte Namespace-Budget beansprucht. Die vollständige Mechanik, inklusive der Frage, wie Sie die Werte an der tatsächlichen Nutzung ausrichten, statt zu raten, finden Sie im ausführlichen Guide zu ResourceQuotas und LimitRanges.
Checkliste für die Namespace-Isolation
- Behandeln Sie den Namespace als Label, nicht als Grenze; fügen Sie RBAC, NetworkPolicy und ResourceQuota hinzu, bevor Sie von Isolation sprechen
- Binden Sie RBAC-Roles an Gruppen und begrenzen Sie sie auf den Namespace, sofern ein Workload nicht wirklich clusterweiten Zugriff benötigt
- Legen Sie in jedem Tenant-Namespace eine Default-Deny-NetworkPolicy an und ergänzen Sie dann explizite Freigaben
- Stellen Sie sicher, dass Ihr CNI NetworkPolicy tatsächlich durchsetzt, bevor Sie sich darauf verlassen
- Setzen Sie in jedem Tenant-Namespace sowohl Compute-Quotas als auch Quotas für die Objektanzahl
- Kombinieren Sie jede ResourceQuota mit einer LimitRange, damit Pods sinnvolle Defaults erhalten, statt abgelehnt zu werden
- Überprüfen Sie RBAC-Bindings und Quota-Werte regelmäßig; beide driften, wenn sich Teams und Workloads ändern
FAQ
Was ist der Unterschied zwischen RBAC und NetworkPolicy in Kubernetes? RBAC steuert den API-Zugriff: welche User, Gruppen und Service-Accounts welche Kubernetes-Objekte erstellen, lesen, aktualisieren oder löschen dürfen. NetworkPolicy steuert den Netzwerkverkehr: welche Pods an welche anderen Pods Pakete senden dürfen. Ein User kann vollen RBAC-Zugriff auf einen Namespace haben, während seine Pods trotzdem daran gehindert werden, über das Netzwerk mit einem anderen Namespace zu kommunizieren – und umgekehrt: Offener Netzwerkzugriff gewährt keinerlei API-Berechtigungen.
Funktioniert Kubernetes NetworkPolicy mit jedem CNI? Nein. Kubernetes stellt NetworkPolicy als API bereit, die Durchsetzung übernimmt jedoch das CNI-Plugin. Calico, Cilium und einige andere implementieren sie; manche CNI-Plugins akzeptieren NetworkPolicy-Objekte, ohne sie überhaupt durchzusetzen. Prüfen Sie die Dokumentation Ihres CNI, bevor Sie NetworkPolicy als echte Sicherheitsgrenze behandeln.
Gelten ResourceQuotas automatisch für neue Namespaces? Nein. Sie legen eine ResourceQuota pro Namespace an, wie jedes andere Kubernetes-Objekt auch. Teams, die automatisch für jeden Namespace eine Quota wollen, setzen das typischerweise über GitOps-Templates oder einen Admission Controller (wie Kyverno oder OPA Gatekeeper) durch, der eine Standard-Quota erzeugt, sobald jemand einen Namespace anlegt.
Isolation hält nur, wenn die Zahlen stimmen
RBAC und NetworkPolicy brauchen nach der Einrichtung vor allem regelmäßige Audits. ResourceQuota funktioniert anders: Sie schützt den Cluster nur dann, wenn die dahinterliegenden Requests und Limits dem tatsächlichen Verbrauch der Workloads entsprechen – und dieser Abgleich verschiebt sich mit jeder Änderung an einem Workload. PerfectScale by DoiT hält Requests und Limits fortlaufend am realen Verbrauch ausgerichtet, sodass quota-gesteuerte Namespaces per Right-Sizing passend dimensioniert werden, statt überprovisioniert zu bleiben, nur um sicher unter dem Limit zu liegen – und liefert Ihnen die Transparenz pro Namespace, um zu erkennen, welcher Tenant seinem Limit am nächsten ist, bevor daraus ein Incident wird.
Sie möchten das auf einem echten Cluster sehen? Nehmen Sie am Live-Workshop zu Multitenancy am 29. September teil oder buchen Sie eine technische Session.