
PerfectScale
namespaceを本物の分離境界に変える:RBACとNetwork Policy
namespace、RBAC、NetworkPolicy、ResourceQuotaを組み合わせてKubernetesでテナントを分離する方法を、YAML例と実践チェックリスト付きで解説します。
このページはEnglish、Deutsch、Español、Français、Italiano、Portuguêsでもご覧いただけます。


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal page要点まとめ
- namespaceが引くのは名前の境界であり、セキュリティ境界ではありません。それ単体では、namespaceをまたいだAPIアクセスも、ネットワークトラフィックも、リソースの奪い合いも防げません。
- RBACは、namespace内のリソースを誰が操作できるかを制御します。デフォルトは拒否で、Roleを作成してバインドするまで誰もアクセスできません。
- NetworkPolicyは、何が何と通信できるかを制御します。ここでのKubernetesの挙動はRBACと正反対で、制限するポリシーを追加するまで、すべてのPodは他のすべてのPodに到達できます。
- ResourceQuotaとLimitRangeは、コンピュートとオブジェクト数の両面でnamespaceの消費量に上限を設け、1つのテナントがクラスタの残りやコントロールプレーンを枯渇させないようにします。
- これらはどれも最初から設定されていません。namespaceごとにすべて自分で追加しない限り、分離は存在しません。
一見すると、namespaceは分離そのもののように見えます。チームA用とチームB用にそれぞれ作成すれば、両チームのPod、Service、設定は別々の名前を持つ別々の入れ物に収まります。しかし境界はそこまでです。namespace自体には、チームAのサービスアカウントがチームBのSecretを読むこと、チームAのPodがチームBのデータベースへ接続を開くこと、チームAのワークロードが共有ノード上でチームBのPodのリソースを奪うことを防ぐ仕組みは何もありません。
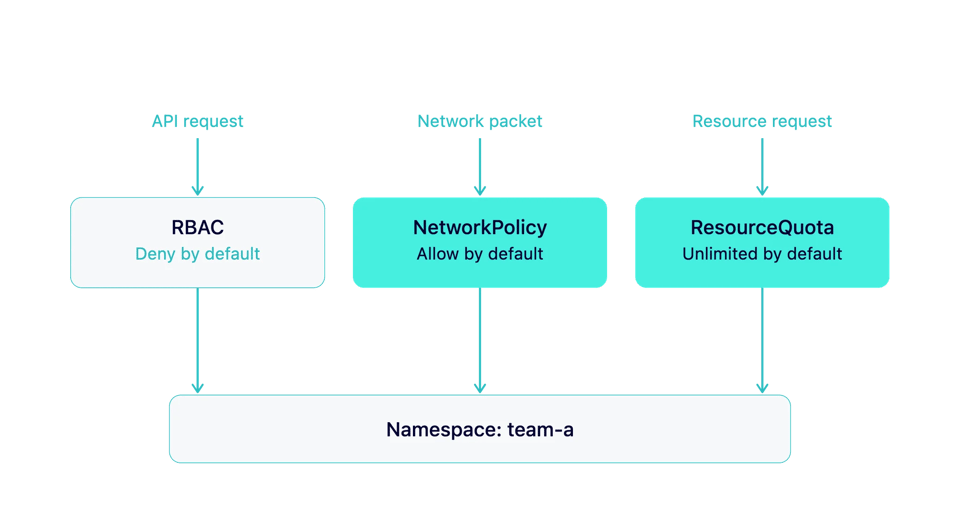
Kubernetesのマルチテナンシーは、その名前の境界を実際のセキュリティ境界・リソース境界へと変える3つの仕組みの上に成り立っています。RBAC、NetworkPolicy、ResourceQuotaです。それぞれが異なる種類のアクセスを制御し、それぞれに、チームの想定を裏切りがちなデフォルト挙動があります。
RBAC:誰が操作できるかを制御する
RBACは、どのユーザー、グループ、サービスアカウントが、どのnamespaceのどのリソースに対して何をできるかを決めます。デフォルトの挙動は安全側に倒れています。Roleで権限を付与し、RoleBindingでそのRoleを割り当てるまで、サービスアカウントやユーザーの権限はゼロです。うっかり権限が漏れることはありません。
namespaceスコープのRoleは、その権限付与の影響範囲を1つのnamespaceに限定します:
apiVersion: rbac.authorization.k8s.io/v1kind: Rolemetadata: namespace: team-a name: team-a-editorrules: - apiGroups: ["", "apps"] resources: ["pods", "deployments", "services"] verbs: ["get", "list", "watch", "create", "update", "patch"]---apiVersion: rbac.authorization.k8s.io/v1kind: RoleBindingmetadata: name: team-a-editor-binding namespace: team-asubjects: - kind: Group name: team-a-engineers apiGroup: rbac.authorization.k8s.ioroleRef: kind: Role name: team-a-editor apiGroup: rbac.authorization.k8s.io次の3つの習慣を守れば、RBAC自体がリスクになるのを防げます。
個々のユーザーではなくグループにバインドする。特定のユーザーに紐づけたRoleBindingは、誰かがチームを異動した瞬間に陳腐化します。グループへのバインドなら、IDプロバイダー側のグループメンバーシップが変わると自動的に反映されます。
テナントの利便性のために付与されたClusterRoleBindingに注意する。クラスタ全体にバインドされたClusterRoleは、クラスタ上のすべてのnamespaceへのアクセスを与えてしまい、そもそもRoleをteam-aにスコープした意味がなくなります。ClusterRoleは本当に必要な場合にだけ使い、可能な限りnamespaceスコープのRoleBindingでバインドしましょう。
バインディングを定期的に見直す。RBACの無秩序な増殖(ほぼ重複したRoleが何十個も存在し、チームを去った人向けの古いバインディングが残ったままの状態)は、監査を数分ではなく数日がかりの作業にします。四半期ごとの棚卸しで、セキュリティインシデントになる前にドリフトを捕捉できます。
RBACは、namespace内で誰がKubernetes Secretsを読めるか、リソースのオーナーシップを管理できるかも決めるため、広すぎるRoleはコンピュートへのアクセス以上のものを晒します。また、RBACがリクエストをブロックした場合、Kubernetesは404ではなくForbiddenエラーを返します。これはクラスタのエラーをデバッグする際に知っておく価値のある違いです。
NetworkPolicy:何が何と通信できるかを制御する
RBACのデフォルトを反転させると、NetworkPolicyの初期状態になります。Kubernetesは標準でフラットなネットワーク構成になっており、何かがブロックしない限り、あらゆるPodはすべてのnamespaceをまたいで、クラスタ上のあらゆるPodへ接続を開けます。ブロックされるのはNetworkPolicyを追加して初めてです。それまでは、RBACでアクセスを厳格に制御していても、侵害されたPodがネットワーク経由でnamespaceの境界を越えるのを止めることはできません。
まずは、namespaceごとにデフォルト拒否のポリシーから始めます:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: default-deny-all namespace: team-aspec: podSelector: {} policyTypes: - Ingress - Egressegressを拒否すると、DNSもブロックされます。CoreDNSは通常、kube-system namespaceのポート53で稼働しています。DNSにアクセスできないと、team-aのPodはサービス名を解決できず、DNSに依存するアプリケーションは失敗し始めます。 他のegressルールを追加する前に、DNSを許可しておきましょう: apiVersion: networking.k8s.io/v1 kind: NetworkPolicy metadata: name: allow-dns namespace: team-a spec: podSelector: {} policyTypes: - Egress egress: - to: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: kube-system ports: - protocol: UDP port: 53 - protocol: TCP port: 53
そのうえで、実際に通信が必要なものだけを明示的に許可します。次の例では、同じnamespace内の他のPodからのトラフィックのみを許可します:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: allow-same-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-a経験したことのないチームほどはまりやすい落とし穴が1つあります。NetworkPolicyは、CNIプラグインが強制して初めて機能します。CalicoやCiliumをはじめいくつかのプラグインはNetworkPolicy APIを実装していますが、実装していないCNIプラグインも存在し、その場合、丹念に書いたポリシーはAPIサーバーには受理されるものの、ネットワーク層では黙って無視されます。NetworkPolicyを本物の境界として扱うのは、CNIがNetworkPolicyを強制することを確認してからにしてください。事後ではなく、事前の確認が必要です。
ResourceQuotaとLimitRange:namespaceの使用量に上限を設ける
RBACとNetworkPolicyはアクセスを止めます。ResourceQuotaは消費を止めます。クォータがなければ、1つのnamespaceがクラスタの残りに何も残らないほどのCPUとメモリを要求したり、クラスタ上のすべてのテナントにとってAPIサーバーが遅くなるほど大量のオブジェクトを作成したりできます。これはノイジーネイバー問題の背後にあるのと同じメカニズムです。
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50" count/deployments.apps: "20"最後の行は、その上にあるコンピュート制限と同じくらい重要です。コンピュートのみのクォータでは、namespaceはDeployment、ConfigMap、Serviceを無制限に作成でき、etcdを圧迫してクラスタ上の他のすべてのテナントのコントロールプレーンを遅くします。オブジェクト数に上限を設けることで、すべてのnamespaceが共有しているものを守れます。
クォータにはLimitRangeを組み合わせましょう。requestsとlimitsを自分で宣言しないPodが、即座に拒否されるのではなく妥当なデフォルト値を得られるようにし、さらにコンテナごとの上限を設定して、単一のPodがnamespaceの予算全体を占有できないようにします。数値を推測ではなく実際の使用量に合わせてサイジングする方法を含む詳しい仕組みは、ResourceQuotaとLimitRangeの専用ガイドを参照してください。
namespace分離チェックリスト
- namespaceは境界ではなくラベルとして扱い、RBAC、NetworkPolicy、ResourceQuotaを追加してから初めて「分離済み」と呼ぶ
- RBACのRoleはグループにバインドし、ワークロードが本当にクラスタ全体のアクセスを必要とする場合を除いてnamespaceにスコープする
- すべてのテナントnamespaceにデフォルト拒否のNetworkPolicyを追加し、その上に明示的な許可を重ねる
- NetworkPolicyに依存する前に、CNIが実際にそれを強制することを確認する
- すべてのテナントnamespaceに、コンピュートのクォータとオブジェクト数のクォータの両方を設定する
- すべてのResourceQuotaにLimitRangeを組み合わせ、Podが拒否されるのではなく妥当なデフォルト値を得られるようにする
- RBACバインディングとクォータ値を定期的に見直す。どちらもチームやワークロードの変化とともにドリフトする
FAQ
KubernetesにおけるRBACとNetworkPolicyの違いは何ですか? RBACはAPIアクセスを制御します。つまり、どのユーザー、グループ、サービスアカウントが、どのKubernetesオブジェクトを作成・読み取り・更新・削除できるかです。NetworkPolicyはネットワークトラフィックを制御します。つまり、どのPodがどのPodにパケットを送れるかです。あるユーザーがnamespaceへの完全なRBACアクセスを持っていても、そのPodはネットワーク経由で別のnamespaceと通信することをブロックされ得ます。逆もまた同様で、ネットワークアクセスが開いていてもAPIパーミッションは一切付与されません。
KubernetesのNetworkPolicyはどのCNIでも機能しますか? いいえ。KubernetesはNetworkPolicyをAPIとして公開していますが、その強制はCNIプラグインの役割です。CalicoやCiliumをはじめいくつかのプラグインは実装していますが、NetworkPolicyオブジェクトを受け入れながらまったく強制しないCNIプラグインもあります。NetworkPolicyを実際のセキュリティ境界として扱う前に、お使いのCNIのドキュメントを確認してください。
ResourceQuotaは新しいnamespaceに自動的に適用されますか? いいえ。ResourceQuotaは他のKubernetesオブジェクトと同様、namespaceごとに作成します。すべてのnamespaceに自動でクォータを付与したいチームは、通常、GitOpsテンプレートや、namespaceの作成と同時にデフォルトのクォータを生成するアドミッションコントローラー(KyvernoやOPA Gatekeeperなど)でそれを強制します。
分離は数値が正しくてこそ保たれる
RBACとNetworkPolicyは、一度設定すればあとは定期的な監査が中心です。ResourceQuotaは事情が異なります。その背後にあるrequestsとlimitsがワークロードの実際の使用量と一致している場合にのみクラスタを守れますが、その一致はワークロードが変わるたびにずれていきます。PerfectScale by DoiTは、ワークロードの変化に合わせてrequestsとlimitsを実使用量に一致させ続けるため、クォータで管理されるnamespaceは、上限を安全に下回るよう過剰にプロビジョニングされたまま放置されるのではなく、適切にライトサイジングされます。さらに、どのテナントが上限に最も近いかをインシデントになる前に把握できる、namespace単位の可視性も得られます。
実際のクラスタで見てみませんか?9月29日開催のマルチテナンシー・ライブワークショップに参加するか、技術セッションを予約してください。