
自律的なライトサイジングで回復性を高め、重要なサービスの速度と可用性を維持します。

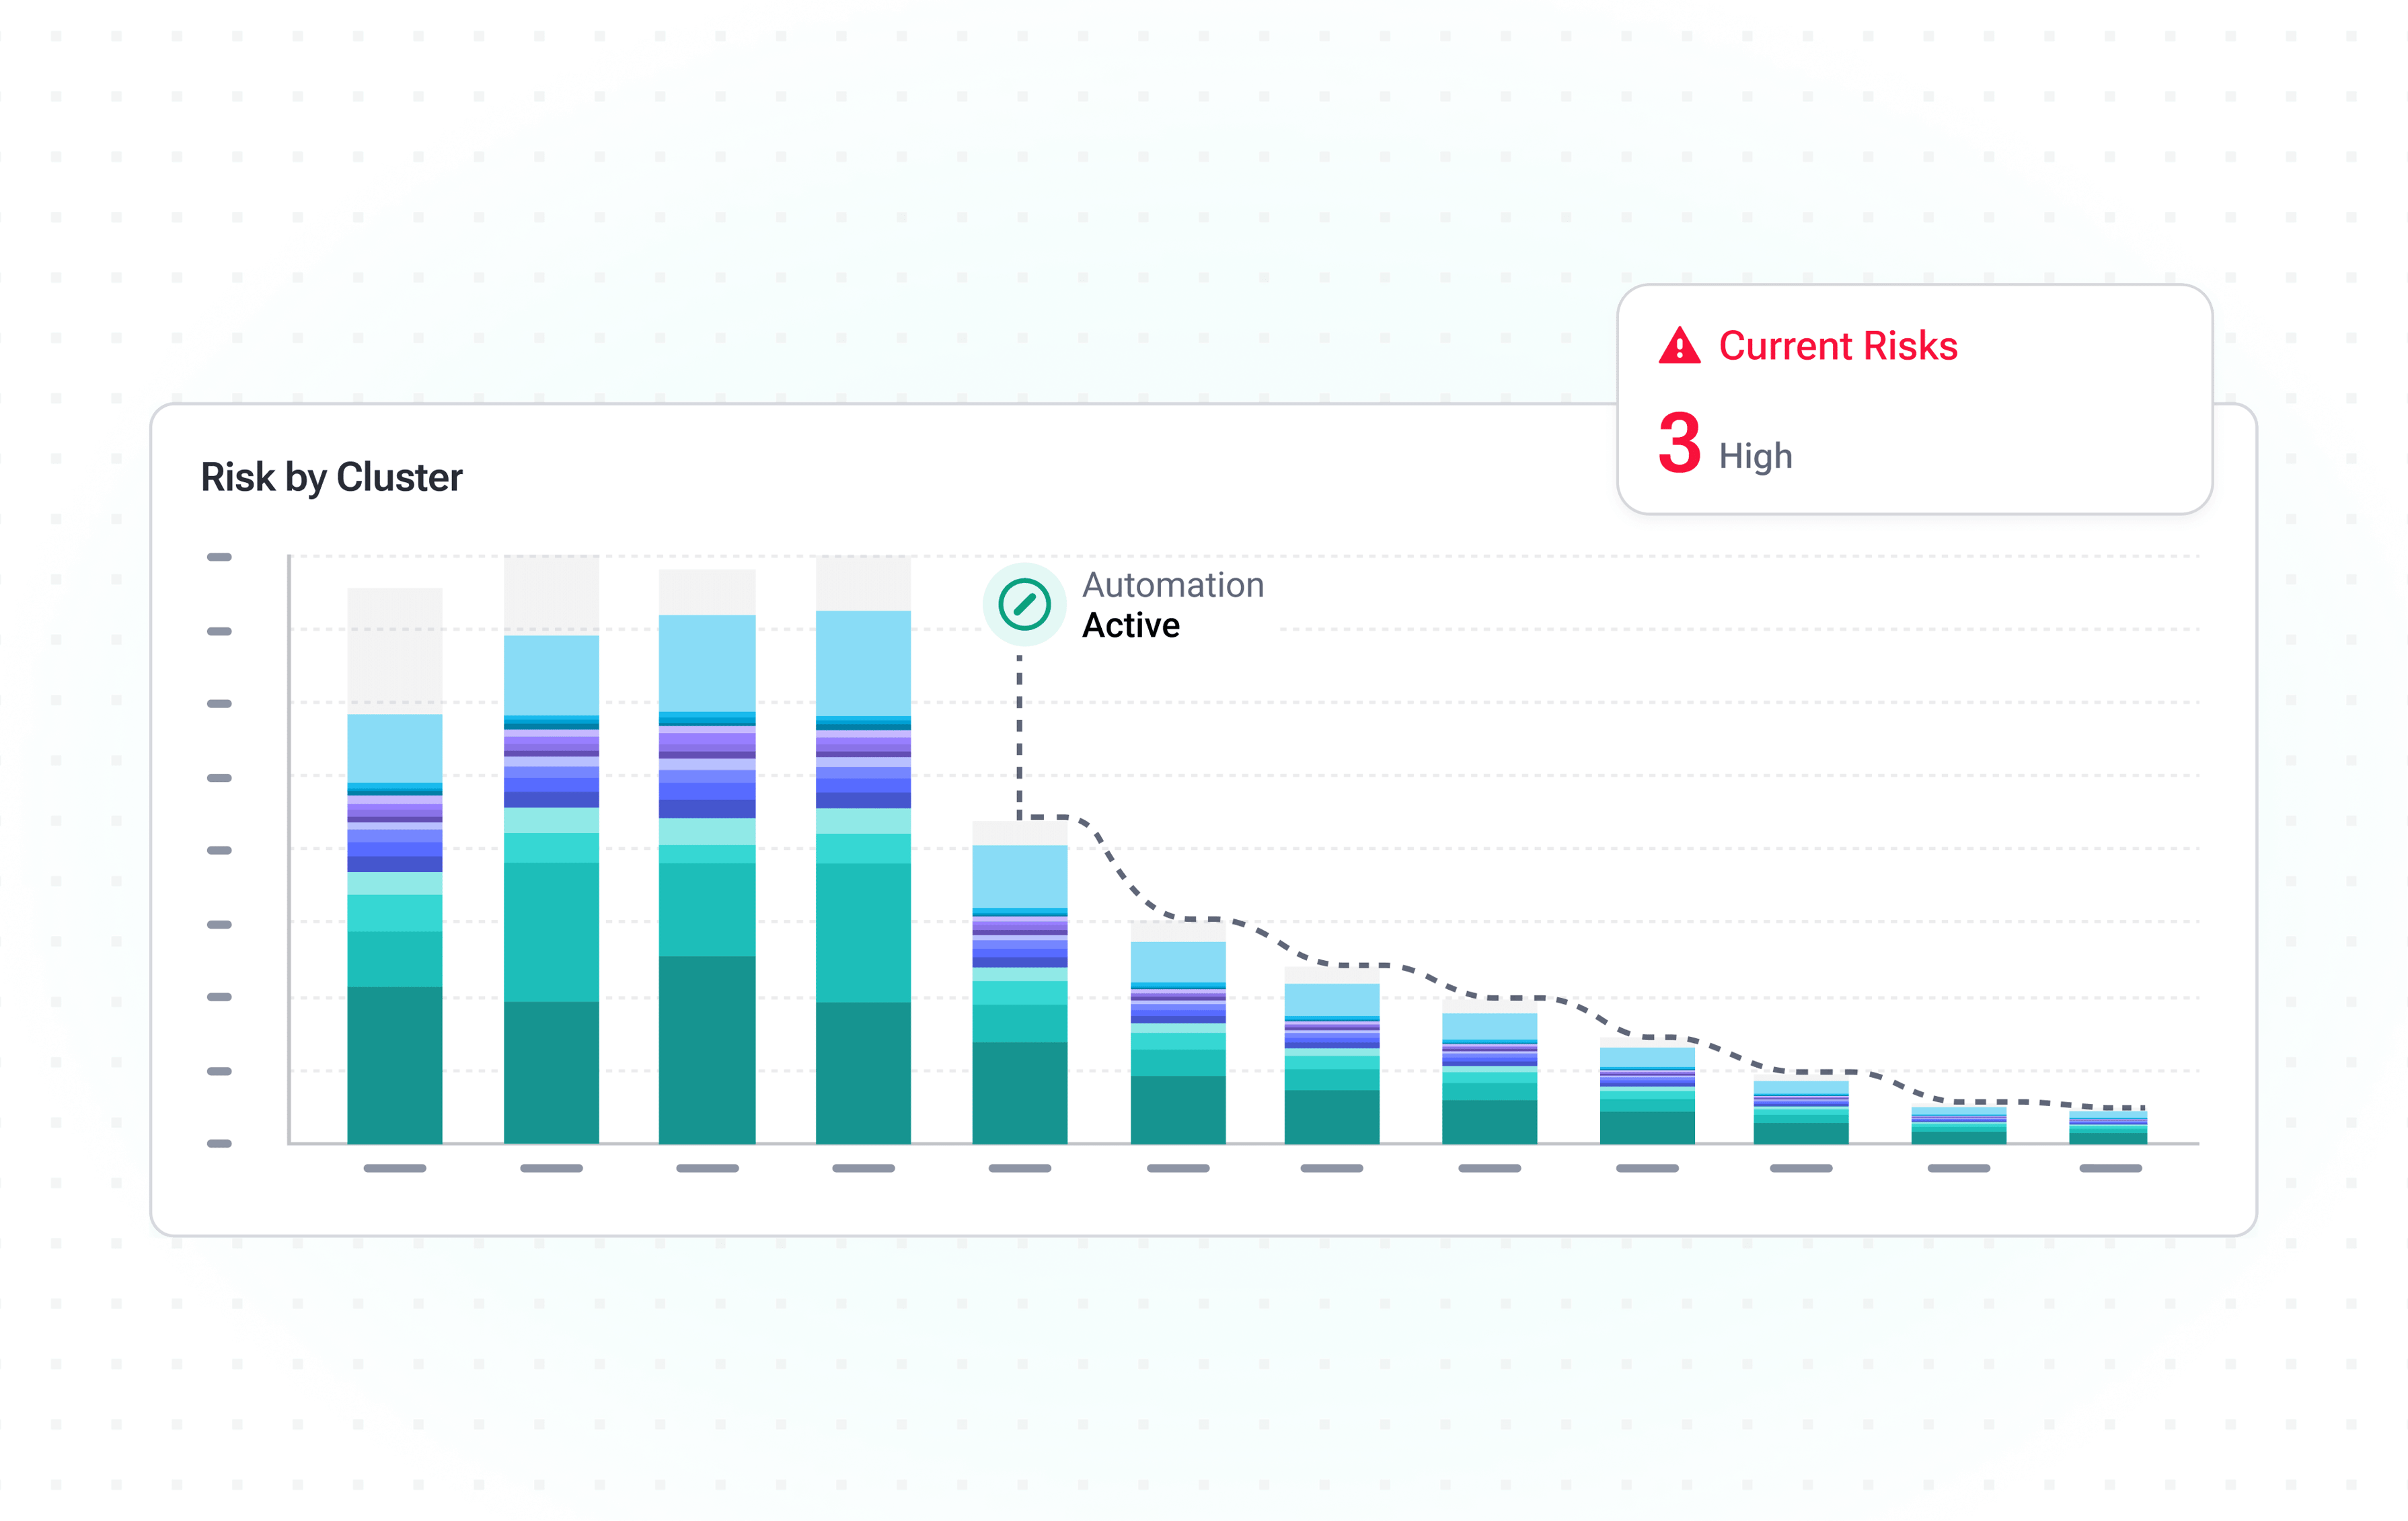
問題の自動修復
回復性のリスクを即座に特定・修正することで、稼働時間を最大化し、レイテンシを排除。常に安定した高品質なサービスを提供します。
- 設定ミスを防止: CPUリクエスト未設定、メモリリクエスト未設定、メモリリミット未設定など
- リソースのプロビジョニング不足を回避: OOM、CPUスロットリング、Evictionなど
- コードやオートスケーリング設定の誤りを排除: メモリリークの疑い、最大レプリカ数への到達など
インフラの強化
ノード全体を包括的に可視化し、インフラに悪影響を及ぼしかねない設定ミスを事前に特定できます。
- ノードのオーバーコミットを防止: 正確なメモリリミットの推奨値により、ノードを安定させEvictionを回避します。
- ノードアフィニティとTaintを適切に設定: ノードグループ全体のワークロードのスケジューリングパターンを分析し、設定ミスを素早く発見します。
- 最適なノードを選択: Podに最も適したノードタイプを選択し、リソースをワークロードの需要に合わせます。
影響度に基づく優先順位付け
高度な自動優先順位付けにより、重大な問題にリアルタイムで集中して対処し、サービスの一貫性を確保します。
- SLA/SLOに合わせたアラート設定: アラートをカスタマイズし、サービスを目標レベル内に保ちます。
- 即時通知を受信: Slack、MS Teams、DataDog Alertsなど、お好みのコミュニケーションチャネルと連携して常に状況を把握できます。
- 既存のワークフローでエスカレーション: ワンクリックでチケットを作成し、すべての問題を確実に処理します。
プラットフォームの機能と検出されるリスク
機能一覧
リアルタイムの問題検出と優先順位付け
発生した問題を即座に検出し、優先順位を付けます。
推奨される解決策
明確で実行可能な修正案を提示します。
自律的な修復
手作業なしで修正を自動適用します。
アラート・チケットシステム連携
Slack、MS Teams、DataDog、各種チケットツールと連携できます。
Eviction
ユーザーに影響が及ぶ前にPodのEvictionを検出します。
Out of Memory
OOMイベントとその根本原因を捉えます。
メモリリークの疑い
メモリリークの兆候を示すワークロードを特定します。
CPUスロットリング
パフォーマンスを損なうスロットリング中のワークロードを可視化します。
Podの再起動
再起動のパターンと根本原因を追跡します。
HPAの最大レプリカ数到達
上限に達したオートスケーラーを検出します。
メモリのプロビジョニング不足
メモリのリクエストとリミットが不足しているワークロードを発見します。
CPUのプロビジョニング不足
CPUのリクエストとリミットが不足しているワークロードを発見します。
メモリ未設定
メモリのリクエストとリミットが未設定のワークロードを検出します。
CPU未設定
CPUのリクエストとリミットが未設定のワークロードを検出します。
Frequently asked
questions
Kubernetesのパフォーマンスとは何ですか?
Kubernetesのパフォーマンスとは、クラスタがワークロードをどれだけ高い信頼性と回復性で稼働させられるかを示すものです。可用性、継続的な稼働時間、通常時およびトラフィック急増時の安定性によって測定され、アプリケーションが定められたサービスレベルを満たすことを保証します。
Kubernetesのパフォーマンスを素早く改善するには?
パフォーマンスを迅速かつ効率的に改善するには、まず最も差し迫った問題を特定する必要があります。Podのライトサイジングを行い、深刻なCPUスロットリングやメモリプレッシャーなどのリスクに対処することで、即座に効果が現れ、クラスタの安定性を大きく向上させられます。
ただし、パフォーマンスは「設定して終わり」というものではありません。クラスタの回復性と信頼性を保つには、継続的な最適化と先を見越したチューニングが欠かせません。ここで力を発揮するのがスケーリングの自動化です。水平・垂直、あるいはその両方のオートスケーリングを設定することで、実際の需要に応じてリソースを動的に調整し、クラスタが安定して稼働し続けるのに十分なリソースを確保できます。
ノードが正常に見えるのにPodが再起動するのはなぜですか?
ノードが正常に見えるのにPodが再起動するのは、K8sクラスタを運用するチームがよく直面する課題です。多くの場合、問題はノードレベルではなくPod側にあります。OOMやOOMKilledイベント、CPUスロットリング、メモリリーク、不正確なリクエストやリミットは、いずれも再起動の原因となり得ます。ノードに空き容量があっても、設定が不適切なワークロードは、基盤となるインフラが正常であっても失敗することがあります。一方で、ノード自体は正常でもワークロードの要件に合わないノード(たとえば、メモリ集約型のワークロードをCPU最適化インスタンスで実行する場合)も、不安定さの原因になります。
PerfectScaleはK8s最適化に多面的なアプローチを提供し、ワークロードのライトサイジングから最適なノードの選択まで、環境のあらゆるレイヤーを最適化できるようにします。
オートスケーリングはパフォーマンスにどのような影響を与えますか?
オートスケーリングは、実際の需要に基づいてリソースをリアルタイムに調整することで、クラスタのパフォーマンス維持に貢献します。正しく設定すれば、通常時やトラフィック急増時にも可用性と安定性を保てます。Karpenterのようなクラスタオートスケーラーは、需要に応じてノードリソースを調整することでクラスタを垂直方向にスケールさせ、稼働に十分なリソースを確保します。HPAやKEDAといったソリューションは、Podのレプリカ数を自動的に調整して水平方向にスケールし、リソース使用率を定義されたしきい値内に保ってプロビジョニング不足を防ぎます。
PerfectScaleは設定を細かくチューニングして正確なスケーリングトリガーを実現し、オートスケーリングの効率を最大化します。
過剰プロビジョニングせずにCPUスロットリングを防げますか?
リソースを過剰にプロビジョニングすればクラスタの安定性が保証され、CPUスロットリングもなくなると考えるチームは少なくありません。しかし、リクエストやリミットの設定が誤っていれば、必要以上にCPUを追加してもスロットリングは防げません。場合によってはスケジューリングの問題を引き起こし、不安定化やダウンタイムにつながるなど、クラスタに悪影響を及ぼすこともあります。
PerfectScaleはK8sワークロードを継続的に分析し、実際の需要に基づいてCPUのリクエストとリミットを自律的にライトサイジングします。これにより、スロットリングのリスクを低減し、クラウドコストを削減しながら最高のパフォーマンスを維持できます。
クラウドコストを削減、パフォーマンスは最高水準に
数分でインストールでき、自律的な最適化インサイトをすぐに得られます。