
PerfectScale
Namespaces Kubernetes : une vraie isolation avec RBAC et Network Policy
Comment namespaces, RBAC, NetworkPolicy et ResourceQuota s'articulent pour isoler les tenants dans Kubernetes, avec des exemples YAML et une checklist pratique.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Un namespace trace une frontière de noms, pas de sécurité. À lui seul, il n'empêche ni l'accès API inter-namespaces, ni le trafic réseau, ni la contention de ressources.
- RBAC contrôle qui peut agir sur les ressources d'un namespace. Il refuse par défaut : personne n'a accès tant que vous n'accordez pas un Role et ne le liez pas.
- NetworkPolicy contrôle ce qui peut communiquer avec quoi. Kubernetes fait ici l'inverse de RBAC : chaque pod peut joindre tous les autres pods tant qu'aucune policy ne le restreint.
- ResourceQuota et LimitRange plafonnent ce qu'un namespace peut consommer, en compute comme en nombre d'objets, afin qu'un tenant ne puisse pas priver de ressources le reste du cluster ou le control plane.
- Rien de tout cela n'est configuré d'origine. Vous devez ajouter chacun de ces contrôles, namespace par namespace, sinon l'isolation n'existe pas.
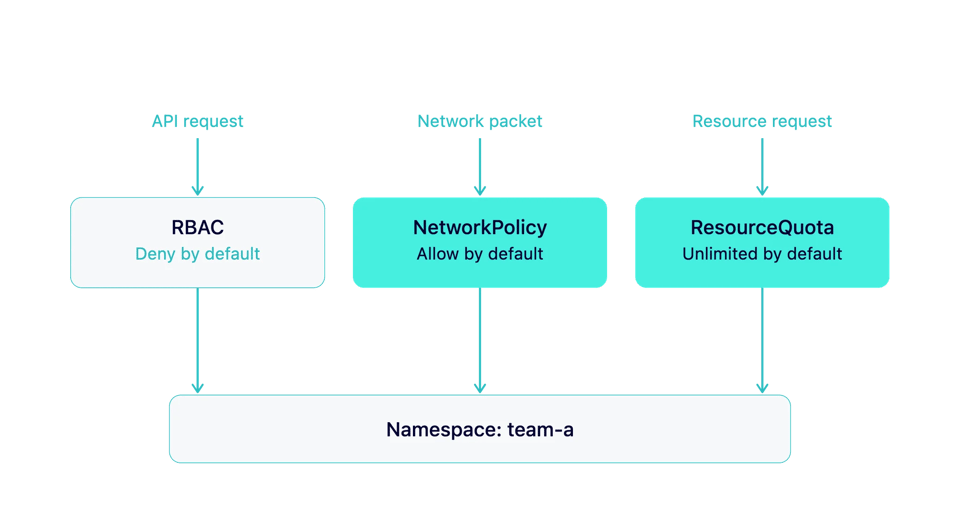
Les namespaces donnent une impression d'isolation. Créez-en un pour l'équipe A et un pour l'équipe B : les pods, services et configs des deux équipes se retrouvent dans des compartiments séparés, avec des noms distincts. Mais la frontière s'arrête là. Rien, dans un namespace en soi, n'empêche le service account de l'équipe A de lire les secrets de l'équipe B, n'empêche les pods de l'équipe A d'ouvrir une connexion vers la base de données de l'équipe B, ni n'empêche les workloads de l'équipe A de priver de ressources les pods de l'équipe B sur un nœud partagé.
La multi-tenancy Kubernetes repose sur trois contrôles qui transforment cette frontière de noms en véritable frontière de sécurité et de ressources : RBAC, NetworkPolicy et ResourceQuota. Chacun régit un type d'accès différent, et chacun a un comportement par défaut qui prend les équipes au dépourvu.
RBAC : contrôler qui peut agir
RBAC détermine quels utilisateurs, groupes et service accounts peuvent faire quoi, sur quelles ressources et dans quels namespaces. Son état par défaut joue en votre faveur : un service account ou un utilisateur n'a aucune permission tant qu'un Role ne lui en accorde pas et qu'un RoleBinding ne lui attribue pas ce Role. Aucune fuite accidentelle.
Un Role limité à un namespace restreint la portée de cette autorisation à un seul namespace :
apiVersion: rbac.authorization.k8s.io/v1kind: Rolemetadata: namespace: team-a name: team-a-editorrules: - apiGroups: ["", "apps"] resources: ["pods", "deployments", "services"] verbs: ["get", "list", "watch", "create", "update", "patch"]---apiVersion: rbac.authorization.k8s.io/v1kind: RoleBindingmetadata: name: team-a-editor-binding namespace: team-asubjects: - kind: Group name: team-a-engineers apiGroup: rbac.authorization.k8s.ioroleRef: kind: Role name: team-a-editor apiGroup: rbac.authorization.k8s.ioTrois habitudes évitent que RBAC ne devienne lui-même un risque :
Liez les Roles à des groupes, pas à des utilisateurs individuels. Un RoleBinding rattaché à des utilisateurs nommés devient obsolète dès que quelqu'un change d'équipe ; un binding de groupe se met à jour automatiquement quand l'appartenance aux groupes évolue dans votre fournisseur d'identité.
Méfiez-vous des ClusterRoleBindings accordés par commodité pour un tenant. Un ClusterRole lié à l'échelle du cluster donne accès à tous les namespaces du cluster, ce qui ruine l'intérêt même d'avoir limité un Role à team-a. Ne recourez à un ClusterRole que lorsque vous en avez réellement besoin, et liez-le avec un RoleBinding limité au namespace quand c'est possible.
Passez les bindings en revue à intervalles réguliers. La prolifération RBAC (des dizaines de Roles quasi identiques et des bindings obsolètes pour des personnes qui ont quitté l'équipe) transforme un audit de quelques minutes en plusieurs jours. Une revue trimestrielle détecte les dérives avant qu'elles ne deviennent un incident de sécurité.
RBAC détermine aussi qui peut lire les Kubernetes Secrets et gérer la propriété des ressources au sein d'un namespace : un Role trop large expose donc bien plus qu'un simple accès au compute. Et lorsque RBAC bloque une requête, Kubernetes renvoie une erreur Forbidden plutôt qu'une 404, une distinction utile à connaître lorsque vous déboguez des erreurs de cluster.
NetworkPolicy : contrôler ce qui peut communiquer avec quoi
Inversez le comportement par défaut de RBAC et vous obtenez l'état initial de NetworkPolicy. Kubernetes est livré avec un réseau à plat : n'importe quel pod peut ouvrir une connexion vers n'importe quel autre pod du cluster, tous namespaces confondus, tant que rien ne l'en empêche. Une NetworkPolicy bloque ce trafic dès que vous en ajoutez une ; en attendant, le contrôle d'accès strict de RBAC ne fait rien pour empêcher un pod compromis de franchir les frontières de namespaces par le réseau.
Commencez par une policy default-deny dans chaque namespace :
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: default-deny-all namespace: team-aspec: podSelector: {} policyTypes: - Ingress - EgressEn refusant l'egress, vous bloquez aussi le DNS. CoreDNS tourne normalement dans le namespace kube-system sur le port 53. Sans accès DNS, les pods de team-a ne peuvent plus résoudre les noms de services, et les applications qui dépendent du DNS commencent à échouer. Autorisez le DNS avant d'ajouter d'autres règles egress : apiVersion: networking.k8s.io/v1 kind: NetworkPolicy metadata: name: allow-dns namespace: team-a spec: podSelector: {} policyTypes: - Egress egress: - to: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: kube-system ports: - protocol: UDP port: 53 - protocol: TCP port: 53
Ajoutez ensuite des autorisations explicites pour ce qui a réellement besoin de communiquer. Celle-ci n'autorise que le trafic provenant d'autres pods du même namespace :
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: allow-same-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-aUn piège attend les équipes qui ne l'ont jamais rencontré : NetworkPolicy ne fonctionne que si votre plugin CNI l'applique. Calico, Cilium et quelques autres implémentent l'API NetworkPolicy ; certains plugins CNI ne le font pas, et sur ceux-là, vos policies soigneusement rédigées sont acceptées par l'API server puis silencieusement ignorées au niveau réseau. Vérifiez que votre CNI applique NetworkPolicy avant de la considérer comme une véritable frontière, pas après.
ResourceQuota et LimitRange : plafonner ce qu'un namespace peut consommer
RBAC et NetworkPolicy bloquent les accès. ResourceQuota bloque la consommation. Sans quota, un namespace peut demander assez de CPU et de mémoire pour ne rien laisser au reste du cluster, ou créer assez d'objets pour ralentir l'API server pour tous les tenants — le même mécanisme qui est à l'œuvre dans le problème du noisy neighbor.
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50" count/deployments.apps: "20"Cette dernière ligne compte autant que les limites de compute qui la précèdent. Un quota limité au compute laisse un namespace créer des Deployments, ConfigMaps ou Services sans limite, ce qui sature etcd et ralentit le control plane pour tous les autres tenants du cluster. Plafonner le nombre d'objets protège ce que tous les namespaces partagent.
Associez le quota à un LimitRange pour que les pods qui ne déclarent pas leurs propres requests et limits reçoivent des valeurs par défaut raisonnables au lieu d'être rejetés d'emblée, et fixez un maximum par conteneur afin qu'aucun pod ne puisse accaparer tout le budget du namespace. Pour la mécanique complète, y compris comment dimensionner les valeurs à partir de l'usage réel plutôt qu'au jugé, consultez le guide dédié aux ResourceQuotas et LimitRanges.
Checklist d'isolation des namespaces
- Considérez le namespace comme une étiquette, pas comme une frontière ; ajoutez RBAC, NetworkPolicy et ResourceQuota avant de le déclarer isolé
- Liez les Roles RBAC à des groupes et limitez-les au namespace, sauf si un workload a réellement besoin d'un accès à l'échelle du cluster
- Ajoutez une NetworkPolicy default-deny à chaque namespace de tenant, puis superposez des autorisations explicites
- Vérifiez que votre CNI applique réellement NetworkPolicy avant de vous y fier
- Définissez à la fois des quotas de compute et des quotas de nombre d'objets sur chaque namespace de tenant
- Associez chaque ResourceQuota à un LimitRange pour que les pods reçoivent des valeurs par défaut raisonnables au lieu d'être rejetés
- Passez régulièrement en revue les bindings RBAC et les valeurs de quotas ; les deux dérivent à mesure que les équipes et les workloads évoluent
FAQ
Quelle est la différence entre RBAC et NetworkPolicy dans Kubernetes ? RBAC contrôle l'accès à l'API : quels utilisateurs, groupes et service accounts peuvent créer, lire, modifier ou supprimer quels objets Kubernetes. NetworkPolicy contrôle le trafic réseau : quels pods peuvent envoyer des paquets à quels autres pods. Un utilisateur peut disposer d'un accès RBAC complet à un namespace et voir malgré tout ses pods empêchés de communiquer avec un autre namespace via le réseau, et inversement : un accès réseau ouvert n'accorde aucune permission API.
La NetworkPolicy Kubernetes fonctionne-t-elle avec n'importe quel CNI ? Non. Kubernetes expose NetworkPolicy sous forme d'API, mais son application revient au plugin CNI. Calico, Cilium et plusieurs autres l'implémentent ; certains plugins CNI acceptent les objets NetworkPolicy sans les appliquer du tout. Consultez la documentation de votre CNI avant de considérer NetworkPolicy comme une véritable frontière de sécurité.
Les ResourceQuotas s'appliquent-ils automatiquement aux nouveaux namespaces ? Non. Vous créez un ResourceQuota par namespace, comme n'importe quel autre objet Kubernetes. Les équipes qui veulent qu'un quota soit appliqué automatiquement à chaque namespace passent généralement par des templates GitOps ou un admission controller (comme Kyverno ou OPA Gatekeeper) qui génère un quota par défaut dès qu'un namespace est créé.
L'isolation ne tient que si les chiffres restent justes
Une fois en place, RBAC et NetworkPolicy demandent surtout des audits périodiques. ResourceQuota fonctionne différemment : il ne protège le cluster que si les requests et limits qui le sous-tendent correspondent à ce que les workloads consomment réellement, et cette correspondance évolue à chaque changement de workload. PerfectScale by DoiT maintient les requests et limits alignés sur l'usage réel à mesure que les workloads évoluent : les namespaces soumis à quota bénéficient d'un right-sizing au lieu de rester surprovisionnés pour tenir confortablement sous le plafond, et vous disposez d'une visibilité par namespace pour repérer le tenant le plus proche de sa limite avant que cela ne devienne un incident.
Envie de le voir sur un vrai cluster ? Rejoignez le workshop multi-tenancy en direct le 29 septembre ou réservez une session technique.