
Des gains de performance sans surprovisionnement
Le right-sizing autonome renforce la résilience et garantit des services critiques rapides et disponibles.

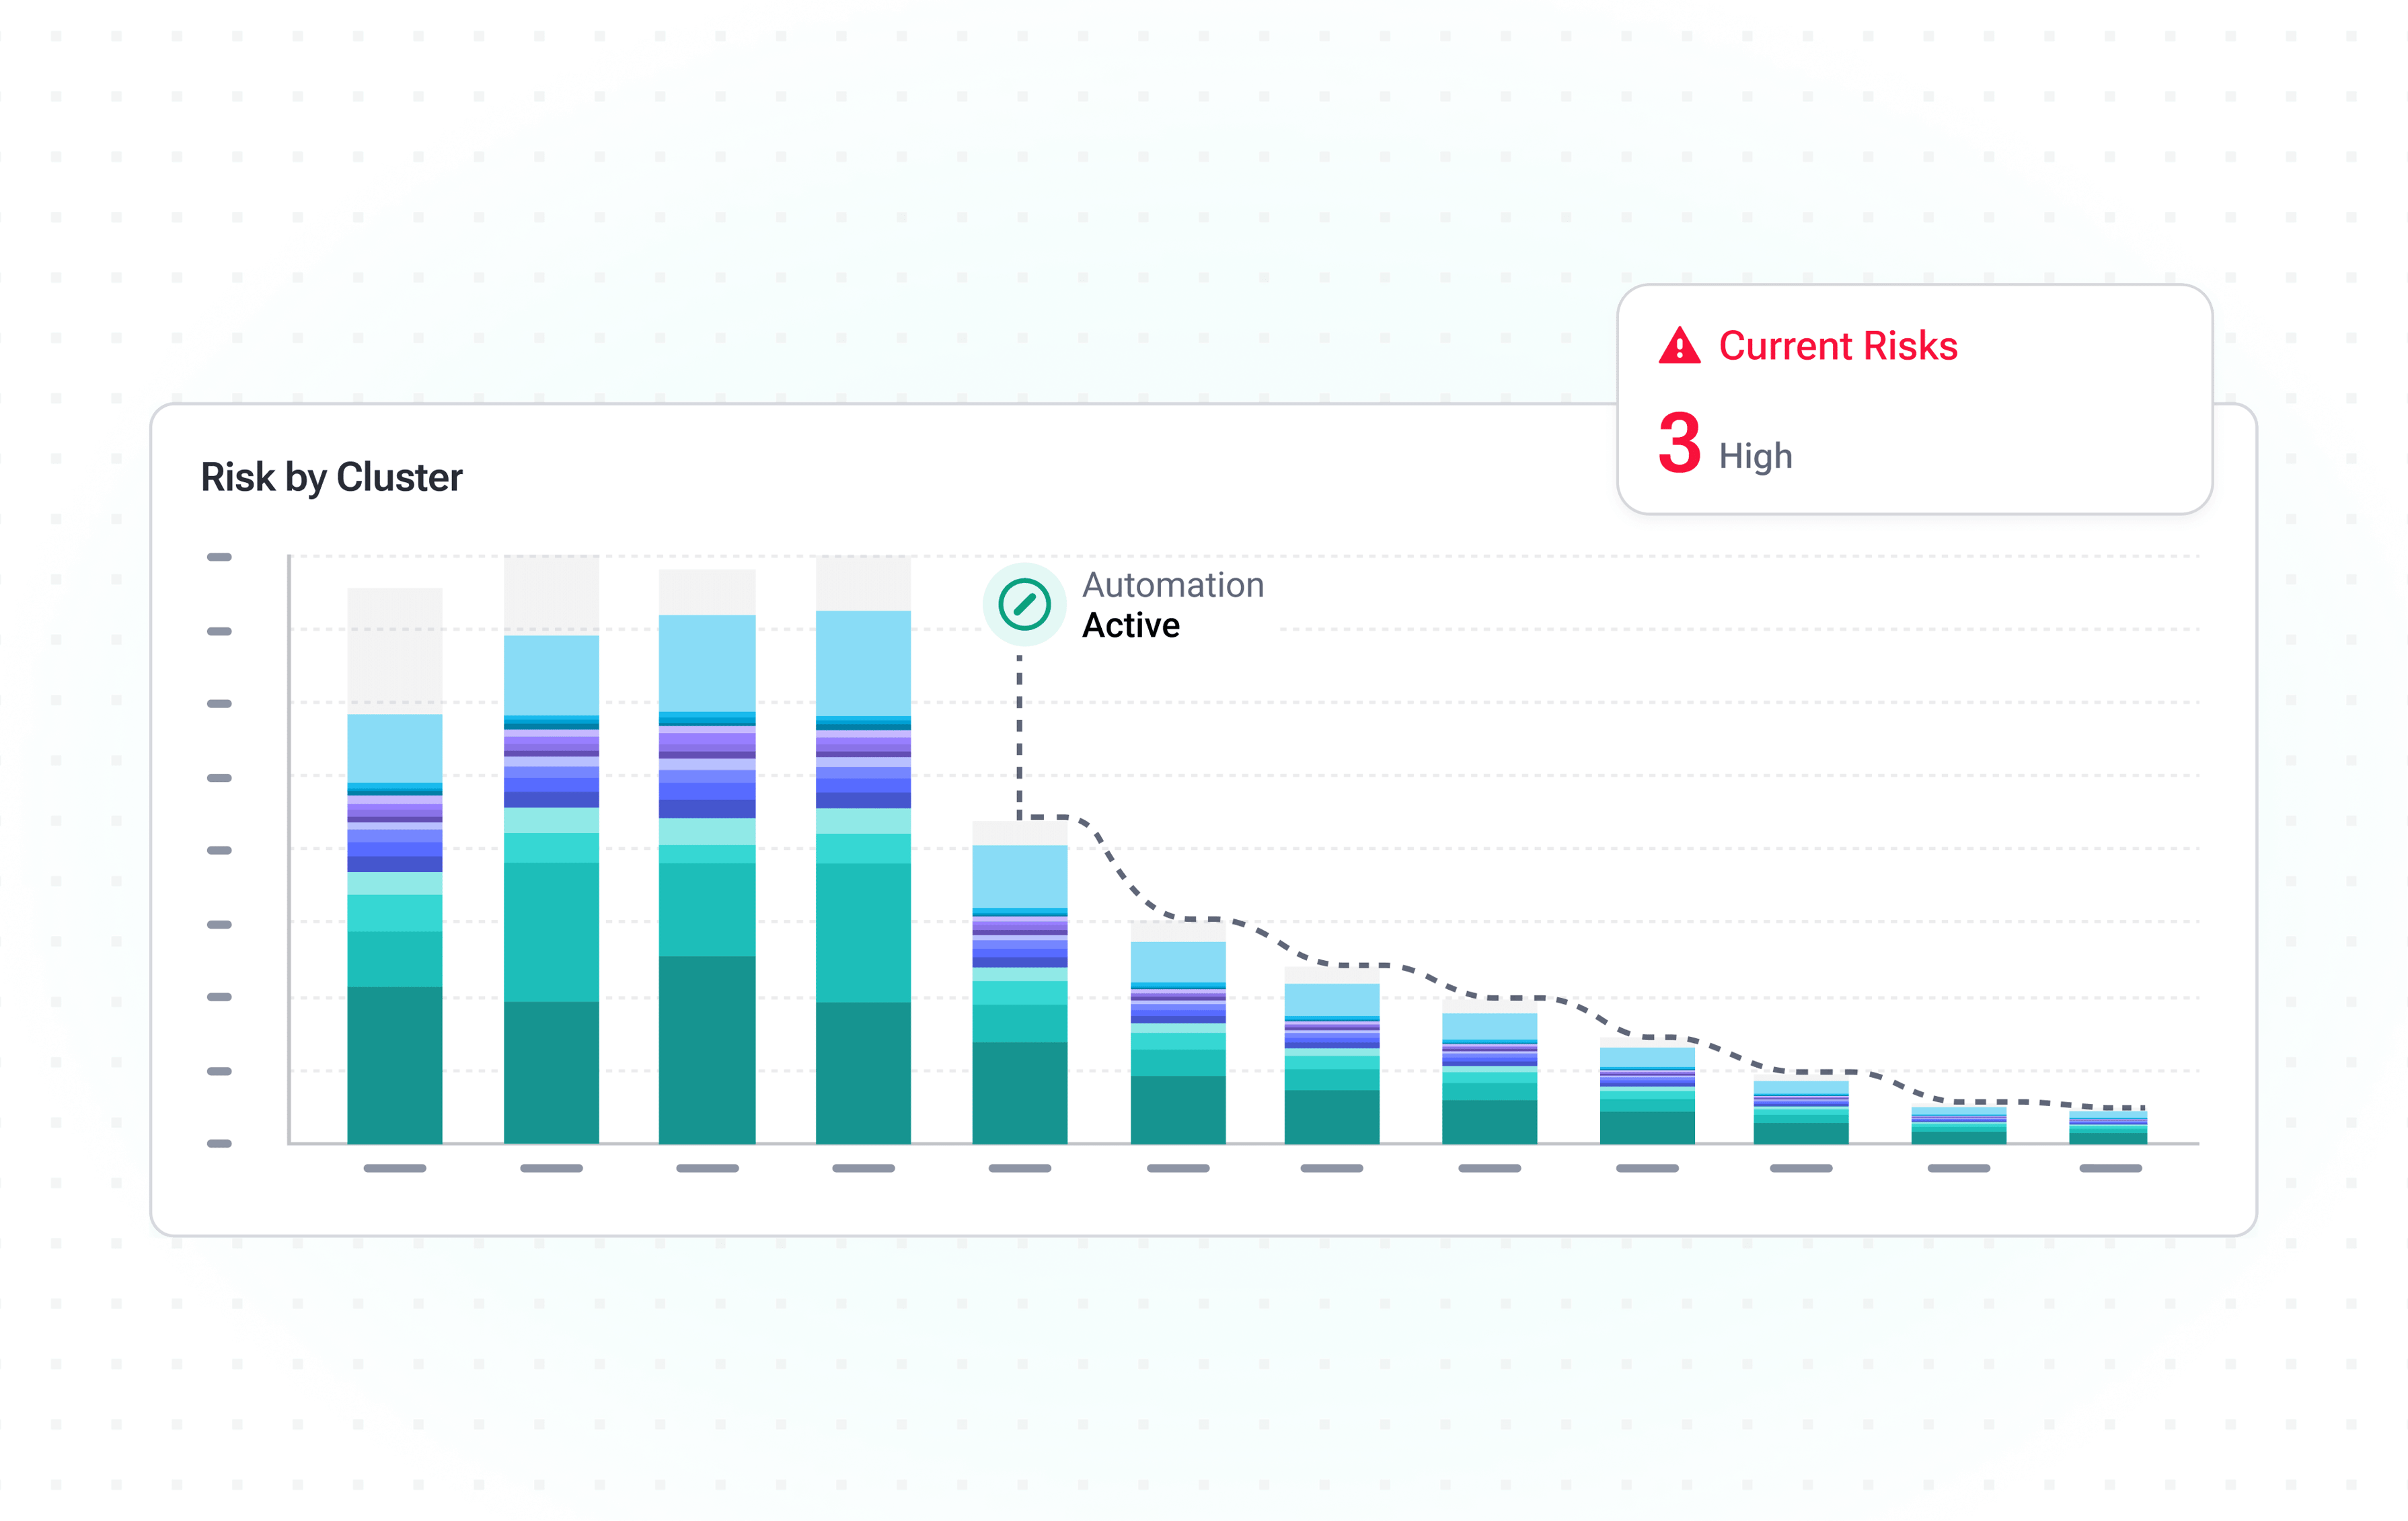
Remédiation automatique des incidents
Maximisez la disponibilité et éliminez la latence en identifiant et corrigeant instantanément les risques de résilience, pour une excellence de service constante.
- Prévenez les erreurs de configuration : absence de CPU Request, de Memory Request, de Memory Limits, etc.
- Évitez le sous-provisionnement des ressources : OOM, CPU throttling, évictions, etc.
- Éliminez les erreurs de code et de configuration d'autoscaling : fuite mémoire suspectée, nombre maximal de réplicas atteint, etc.
Renforcement de l'infrastructure
Bénéficiez d'une visibilité globale sur vos nœuds pour identifier de manière proactive les mauvaises configurations susceptibles de nuire à votre infrastructure.
- Prévenez la surcharge des nœuds : assurez la stabilité de vos nœuds et évitez les évictions grâce à des recommandations précises de limites mémoire.
- Garantissez des node affinities et taints appropriés : repérez rapidement les mauvaises configurations en analysant les schémas de planification des workloads entre les groupes de nœuds.
- Choisissez les nœuds optimaux : alignez les ressources sur les besoins des workloads en sélectionnant les types de nœuds les mieux adaptés à vos pods.
Priorisation basée sur l'impact
Garantissez la cohérence de vos services en vous concentrant sur les incidents critiques et en les résolvant en temps réel grâce à une priorisation automatique avancée.
- Alignez les alertes sur vos SLA/SLO : personnalisez les alertes pour maintenir votre service dans les niveaux cibles.
- Recevez des notifications instantanées : restez informé en connectant votre canal de communication préféré, comme Slack, MS Teams ou DataDog Alerts.
- Faites remonter les incidents selon vos workflows établis : assurez le bon traitement de chaque incident en créant un ticket en un clic.
Capacités de la plateforme et risques identifiés
Tableau des fonctionnalités
Détection et priorisation des incidents en temps réel
Repérez et hiérarchisez les incidents dès qu'ils surviennent.
Résolutions recommandées
Recevez des recommandations de correction claires et actionnables.
Remédiation autonome
Appliquez les correctifs automatiquement, sans intervention manuelle.
Intégrations d'alertes et de ticketing
Connectez Slack, MS Teams, DataDog et vos outils de ticketing.
Évictions
Détectez les évictions de pods avant qu'elles n'impactent vos utilisateurs.
Out of Memory
Repérez les événements OOM et leurs causes sous-jacentes.
Fuite mémoire suspectée
Identifiez les workloads présentant des signes de fuite mémoire.
CPU Throttling
Identifiez les workloads bridés qui pénalisent les performances.
Redémarrages de pods
Suivez les schémas de redémarrage et leurs causes profondes.
HPA au maximum de réplicas
Repérez les autoscalers qui atteignent leur plafond.
Mémoire sous-provisionnée
Identifiez les workloads dont les memory requests et limits sont insuffisants.
CPU sous-provisionné
Identifiez les workloads dont les CPU requests et limits sont insuffisants.
Mémoire non définie
Repérez les workloads sans memory request ni limit.
CPU non défini
Repérez les workloads sans CPU request ni limit.
Frequently asked
questions
Qu'est-ce que la performance Kubernetes ?
La performance Kubernetes reflète la fiabilité et la résilience avec lesquelles les clusters exécutent les workloads. Elle se mesure par la disponibilité, l'uptime continu et la stabilité, aussi bien en activité normale que lors des pics de trafic, garantissant que les applications respectent leurs niveaux de service déclarés.
Comment améliorer rapidement la performance Kubernetes ?
Pour améliorer la performance rapidement et efficacement, il faut d'abord identifier les problèmes les plus urgents. Le right-sizing des pods et le traitement des risques tels qu'un CPU throttling élevé ou la pression mémoire peuvent produire des résultats immédiats et améliorer sensiblement la stabilité des clusters.
Cela dit, la performance n'est jamais acquise une fois pour toutes. Elle exige une optimisation continue et des ajustements proactifs pour garder des clusters résilients et fiables. C'est là que l'automatisation du scaling entre en jeu. En configurant l'autoscaling horizontal, vertical ou les deux, vous ajustez dynamiquement les ressources en fonction de la demande réelle, garantissant à vos clusters des ressources suffisantes pour des performances constantes.
Pourquoi les pods redémarrent-ils alors que les nœuds semblent sains ?
Les redémarrages de pods, même lorsque les nœuds semblent sains, sont un défi courant pour les équipes qui gèrent des clusters K8s. Dans la plupart des cas, le problème ne se situe pas au niveau du nœud, mais du pod. Les événements OOM et OOMKilled, le CPU throttling, les fuites mémoire ou des requests et limits mal calibrés peuvent tous déclencher des redémarrages. Même avec de la capacité disponible sur les nœuds, des workloads mal configurés peuvent échouer, alors que l'infrastructure sous-jacente est saine. À l'inverse, des nœuds sains mais inadaptés peuvent aussi provoquer de l'instabilité s'ils ne correspondent pas aux besoins des workloads (par exemple, des instances optimisées CPU exécutant des workloads gourmands en mémoire).
PerfectScale offre une approche multidimensionnelle de l'optimisation K8s, permettant aux équipes d'optimiser chaque couche de leur environnement, du right-sizing des workloads à la sélection des nœuds les mieux adaptés.
Quel est l'impact de l'autoscaling sur la performance ?
L'autoscaling contribue à la performance des clusters en ajustant les ressources en temps réel selon la demande réelle. Correctement configuré, il maintient la disponibilité et la stabilité en activité normale comme lors des pics de trafic. Les autoscalers de cluster comme Karpenter font évoluer les clusters verticalement en ajustant les ressources des nœuds selon les besoins, garantissant aux clusters suffisamment de ressources pour fonctionner. Des solutions comme HPA ou KEDA scalent horizontalement en ajustant automatiquement le nombre de réplicas de pods, maintenant l'utilisation des ressources dans les seuils définis et évitant le sous-provisionnement.
PerfectScale affine les configurations pour garantir des déclencheurs de scaling précis et maximiser l'efficacité de l'autoscaling.
Peut-on prévenir le CPU throttling sans surprovisionner ?
Les équipes supposent souvent que le surprovisionnement des ressources garantit la stabilité des clusters et élimine le CPU throttling. Or, ajouter plus de CPU que nécessaire n'empêche pas le throttling si les requests et limits sont mal configurés ; dans certains cas, cela peut même nuire aux clusters, en causant des problèmes de scheduling, source d'instabilité et d'indisponibilité.
PerfectScale analyse en continu les workloads K8s et ajuste de manière autonome les CPU requests et limits selon la demande réelle, réduisant le risque de throttling et maintenant des performances optimales tout en diminuant les coûts cloud.
Réduisez vos coûts cloud sans sacrifier les performances
Installez la solution en quelques minutes et bénéficiez d'insights d'optimisation autonomes.