
PerfectScale
Isolamento de verdade em namespaces do Kubernetes: RBAC e Network Policy
Como namespaces, RBAC, NetworkPolicy e ResourceQuota trabalham juntos para isolar tenants no Kubernetes, com exemplos em YAML e um checklist prático.
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Um namespace traça uma fronteira de nomes, não de segurança. Sozinho, ele não impede acesso à API entre namespaces, tráfego de rede nem disputa por recursos.
- O RBAC controla quem pode agir sobre os recursos de um namespace. Ele nega por padrão: ninguém tem acesso até você conceder um Role e vinculá-lo a alguém.
- A NetworkPolicy controla o que pode se comunicar com o quê. Aqui o Kubernetes faz o oposto do RBAC: todo pod consegue alcançar qualquer outro pod até que você adicione uma política restringindo isso.
- ResourceQuota e LimitRange limitam quanto um namespace pode consumir, tanto em computação quanto em quantidade de objetos, para que um tenant não deixe o resto do cluster ou o control plane sem recursos.
- Nada disso vem configurado. Você precisa adicionar cada um deles, namespace por namespace — ou o isolamento simplesmente não existe.
Namespaces parecem isolamento. Crie um para o time A e outro para o time B, e os pods, services e configs dos dois times ficam em compartimentos separados, com nomes separados. Só que a fronteira para por aí. Nada em um namespace, por si só, impede que a service account do time A leia os secrets do time B, que os pods do time A abram uma conexão com o banco de dados do time B, ou que os workloads do time A deixem os pods do time B sem recursos em um node compartilhado.
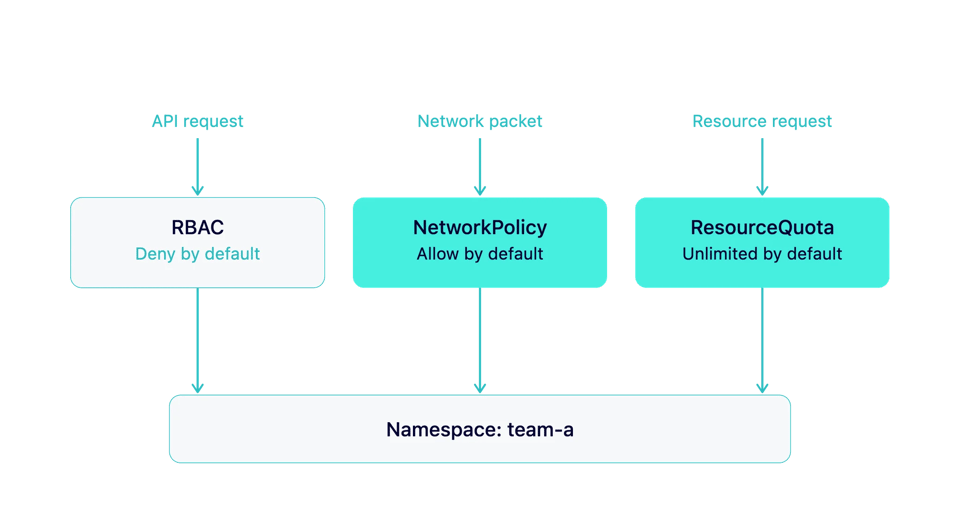
A multi-tenancy no Kubernetes se apoia em três controles que transformam essa fronteira de nomes em uma fronteira real de segurança e de recursos: RBAC, NetworkPolicy e ResourceQuota. Cada um governa um tipo diferente de acesso, e cada um tem um padrão próprio que pega os times de surpresa.
RBAC: controlando quem pode agir
O RBAC decide quais usuários, grupos e service accounts podem fazer o quê, em quais recursos e em quais namespaces. Seu estado padrão trabalha a seu favor: uma service account ou usuário tem zero permissões até que um Role conceda algumas e um RoleBinding entregue esse Role a eles. Nada vaza por acidente.
Um Role com escopo de namespace limita o raio de impacto dessa concessão a um único namespace:
apiVersion: rbac.authorization.k8s.io/v1kind: Rolemetadata: namespace: team-a name: team-a-editorrules: - apiGroups: ["", "apps"] resources: ["pods", "deployments", "services"] verbs: ["get", "list", "watch", "create", "update", "patch"]---apiVersion: rbac.authorization.k8s.io/v1kind: RoleBindingmetadata: name: team-a-editor-binding namespace: team-asubjects: - kind: Group name: team-a-engineers apiGroup: rbac.authorization.k8s.ioroleRef: kind: Role name: team-a-editor apiGroup: rbac.authorization.k8s.ioTrês hábitos evitam que o RBAC vire um problema por conta própria:
Vincule a grupos, não a usuários individuais. Um RoleBinding amarrado a usuários nomeados apodrece no momento em que alguém troca de time; um binding por grupo se atualiza automaticamente quando a composição do grupo muda no seu provedor de identidade.
Fique de olho em ClusterRoleBindings concedidos por conveniência do tenant. Um ClusterRole vinculado em todo o cluster distribui acesso a todos os namespaces, o que anula justamente o propósito de restringir um Role ao team-a. Recorra a um ClusterRole apenas quando realmente precisar de um, e vincule-o com um RoleBinding restrito ao namespace sempre que puder.
Revise os bindings com regularidade. A proliferação de RBAC (dezenas de Roles quase duplicados e bindings obsoletos de pessoas que saíram do time) faz uma auditoria levar dias em vez de minutos. Uma revisão trimestral detecta o desvio antes que ele vire um incidente de segurança.
O RBAC também decide quem pode ler Secrets do Kubernetes e gerenciar a propriedade de recursos dentro de um namespace, então um Role amplo demais expõe mais do que acesso a recursos de computação. E quando o RBAC bloqueia uma requisição, o Kubernetes retorna um erro Forbidden em vez de um 404, uma distinção que vale conhecer na hora de depurar erros no cluster.
NetworkPolicy: controlando o que pode se comunicar com o quê
Inverta o padrão do RBAC e você tem o estado inicial da NetworkPolicy. O Kubernetes vem com rede plana: qualquer pod pode abrir uma conexão com qualquer outro pod do cluster, em todos os namespaces, a menos que algo bloqueie. Uma NetworkPolicy bloqueia assim que você adiciona uma; até lá, o controle de acesso rigoroso do RBAC não faz nada para impedir que um pod comprometido cruze fronteiras de namespace pela rede.
Comece com uma política default-deny por namespace:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: default-deny-all namespace: team-aspec: podSelector: {} policyTypes: - Ingress - EgressAo negar egress, você também bloqueia o DNS. O CoreDNS normalmente roda no namespace kube-system na porta 53. Sem acesso ao DNS, os pods do team-a não conseguem resolver nomes de services, então aplicações que dependem de DNS começam a falhar. Libere o DNS antes de adicionar outras regras de egress: apiVersion: networking.k8s.io/v1 kind: NetworkPolicy metadata: name: allow-dns namespace: team-a spec: podSelector: {} policyTypes: - Egress egress: - to: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: kube-system ports: - protocol: UDP port: 53 - protocol: TCP port: 53
Depois, adicione liberações explícitas para o que realmente precisa se comunicar. Esta aqui permite tráfego apenas de outros pods do mesmo namespace:
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: allow-same-namespace namespace: team-aspec: podSelector: {} policyTypes: - Ingress ingress: - from: - namespaceSelector: matchLabels: kubernetes.io/metadata.name: team-aUma pegadinha surpreende quem nunca passou por isso: a NetworkPolicy só funciona se o seu plugin CNI a aplicar de fato. Calico, Cilium e alguns outros implementam a API de NetworkPolicy; alguns plugins CNI não implementam, e nesses casos suas políticas cuidadosamente escritas são aceitas pelo API server e silenciosamente ignoradas na camada de rede. Confirme que seu CNI aplica NetworkPolicy antes de tratá-la como uma fronteira real, não depois.
ResourceQuota e LimitRange: limitando quanto um namespace pode usar
RBAC e NetworkPolicy barram o acesso. ResourceQuota barra o consumo. Sem uma quota, um namespace pode solicitar CPU e memória suficientes para não sobrar nada para o resto do cluster, ou criar objetos suficientes para deixar o API server lento para todos os tenants — o mesmo mecanismo por trás do problema do noisy neighbor.
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50" count/deployments.apps: "20"Essa última linha importa tanto quanto os limites de computação acima dela. Uma quota só de computação ainda permite que um namespace crie Deployments, ConfigMaps ou Services sem limite, o que sobrecarrega o etcd e deixa o control plane lento para todos os outros tenants do cluster. Limitar a quantidade de objetos protege aquilo que todos os namespaces compartilham.
Combine a quota com um LimitRange para que pods que não declaram seus próprios requests e limits recebam padrões sensatos em vez de serem rejeitados de cara, e defina um máximo por container para que nenhum pod sozinho consiga tomar para si todo o orçamento do namespace. Para a mecânica completa, incluindo como dimensionar os números com base no uso real em vez de chutar, veja o guia dedicado sobre ResourceQuotas e LimitRanges.
Checklist de isolamento de namespaces
- Trate o namespace como um rótulo, não como uma fronteira; adicione RBAC, NetworkPolicy e ResourceQuota antes de chamá-lo de isolado
- Vincule Roles de RBAC a grupos e restrinja-os ao namespace, a menos que um workload realmente precise de acesso em todo o cluster
- Adicione uma NetworkPolicy default-deny a todo namespace de tenant e depois acrescente liberações explícitas
- Confirme que seu CNI realmente aplica NetworkPolicy antes de confiar nela
- Defina quotas de computação e de quantidade de objetos em todo namespace de tenant
- Combine toda ResourceQuota com um LimitRange para que os pods recebam padrões sensatos em vez de serem rejeitados
- Revise bindings de RBAC e valores de quota com regularidade; ambos se desviam à medida que times e workloads mudam
FAQ
Qual é a diferença entre RBAC e NetworkPolicy no Kubernetes? O RBAC controla o acesso à API: quais usuários, grupos e service accounts podem criar, ler, atualizar ou excluir quais objetos do Kubernetes. A NetworkPolicy controla o tráfego de rede: quais pods podem enviar pacotes para quais outros pods. Um usuário pode ter acesso RBAC completo a um namespace e ainda assim ter seus pods impedidos de se comunicar com outro namespace pela rede, e o inverso também: acesso de rede aberto não concede nenhuma permissão de API.
A NetworkPolicy do Kubernetes funciona com qualquer CNI? Não. O Kubernetes expõe a NetworkPolicy como uma API, mas a aplicação fica a cargo do plugin CNI. Calico, Cilium e vários outros a implementam; alguns plugins CNI aceitam objetos NetworkPolicy sem aplicá-los de forma alguma. Verifique a documentação do seu CNI antes de tratar a NetworkPolicy como uma fronteira de segurança de verdade.
ResourceQuotas se aplicam automaticamente a namespaces novos? Não. Você cria uma ResourceQuota por namespace, como qualquer outro objeto do Kubernetes. Times que querem que todo namespace receba uma quota automaticamente costumam garantir isso por meio de templates de GitOps ou de um admission controller (como Kyverno ou OPA Gatekeeper) que gera uma quota padrão no momento em que alguém cria um namespace.
O isolamento só se mantém se os números continuarem certos
RBAC e NetworkPolicy, uma vez configurados, precisam principalmente de auditorias periódicas. Com a ResourceQuota é diferente: ela só protege o cluster quando os requests e limits por trás dela correspondem ao que os workloads realmente usam, e essa correspondência muda toda vez que um workload muda. O PerfectScale by DoiT mantém requests e limits alinhados ao uso real conforme os workloads evoluem, para que namespaces governados por quota passem por right-sizing em vez de ficarem superprovisionados só para manter uma folga segura abaixo do teto — e ainda dá a você visibilidade por namespace para ver qual tenant está mais perto do limite antes que isso vire um incidente.
Quer ver isso em um cluster de verdade? Participe do workshop ao vivo sobre multitenancy em 29 de setembro ou agende uma sessão técnica.