
Aumente a utilização, elimine o desperdício com recursos ociosos e mantenha seus workloads de IA rápidos com sinais de otimização em tempo real.

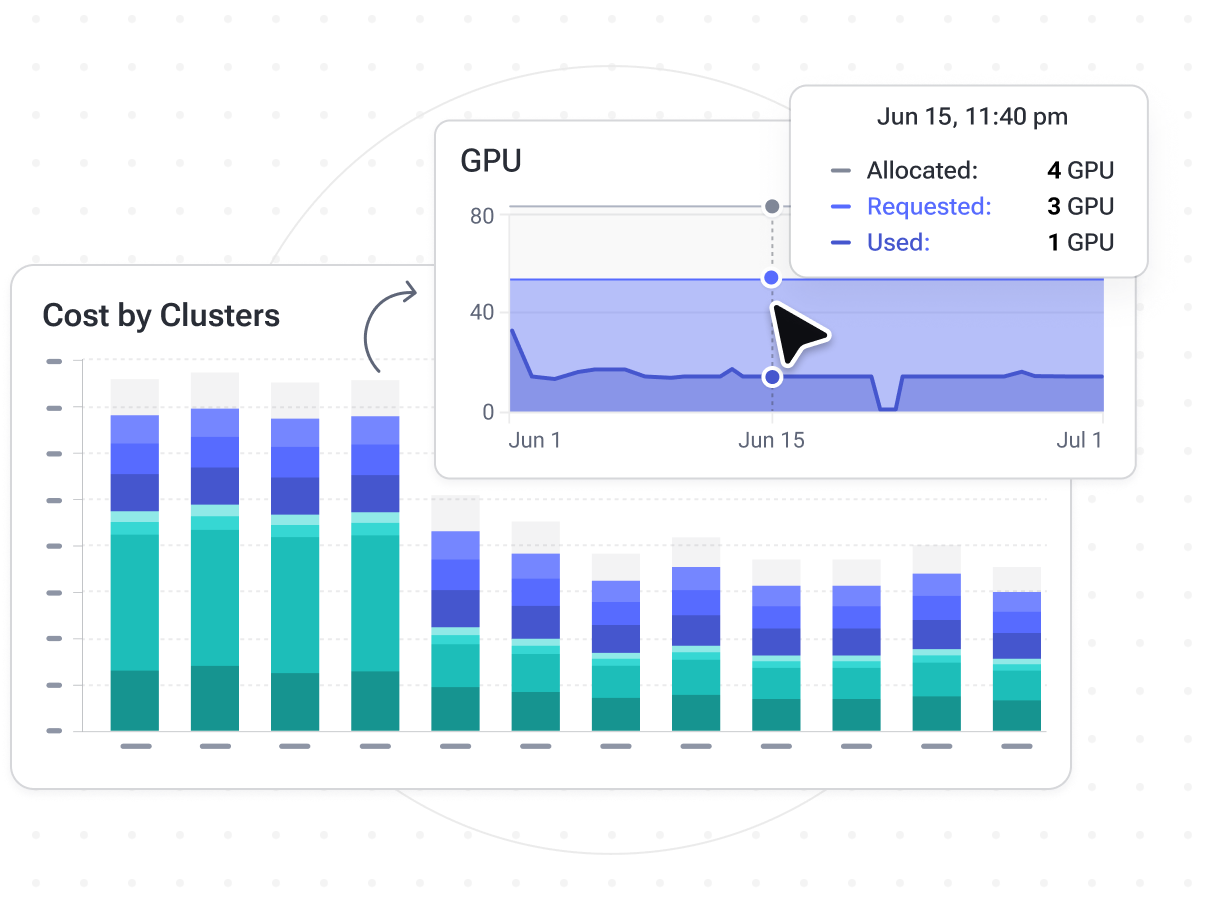
Impulsione a inovação, não a sua conta de nuvem: mantenha as GPUs sob controle
A PerfectScale monitora seus clusters continuamente e revela oportunidades de otimização de GPU, ajudando você a reduzir significativamente os gastos com nuvem.
Visibilidade granular da utilização de GPU
Tenha insights completos sobre a utilização de GPU em clusters e grupos de nós para identificar padrões de uso e tendências ao longo do tempo.
Detecção instantânea de desperdício de GPU
Identifique ineficiências em toda a sua infraestrutura de IA sem complicação, localizando nós ociosos, subutilizados ou mal configurados para evitar custos desnecessários e eventos de scaling.
Infraestrutura de GPU enxuta
Faça o right-sizing dos workloads que rodam em nós de GPU com recomendações baseadas em dados ou automação para melhorar o scheduling e eliminar nós desnecessários e caros.
Corte custos de nuvem sem abrir mão da performance
Instale em minutos e receba insights de otimização autônoma.
Frequently asked
questions
Posso testar a PerfectScale gratuitamente?
Sim, o pacote Community da PerfectScale é gratuito para sempre. Recursos premium, como automação, ficam disponíveis para usuários Community nos primeiros 30 dias após a criação da conta. Cadastre-se em https://app.perfectscale.io/account/sign-up.
O que é otimização de GPU no Kubernetes?
A otimização de GPU no Kubernetes é um processo complexo de alinhar a alocação de recursos de GPU à demanda real dos workloads para eliminar desperdícios, melhorar a eficiência de utilização e reduzir os gastos de nuvem com K8s. Ela garante que os workloads tenham exatamente o número de GPUs necessário para funcionar bem, sem comprometer a performance.
Como posso reduzir os custos de GPU em clusters K8s?
Para reduzir os custos de GPU no Kubernetes, você precisa de visibilidade precisa da utilização de GPU em tempo real, dos padrões de comportamento dos workloads ao longo do tempo e também de visibilidade no nível dos nós para avaliar a eficiência do bin packing, identificar capacidade ociosa e convertê-la em oportunidades de otimização. Fazendo o right-sizing dos workloads de GPU conforme a demanda, melhorando o bin packing e escolhendo as instâncias de GPU com melhor custo-benefício, você reduz os gastos com nuvem sem complicação, mantendo a performance e a estabilidade dos serviços de IA.