
O rightsizing autônomo melhora a resiliência e mantém os serviços críticos rápidos e disponíveis.

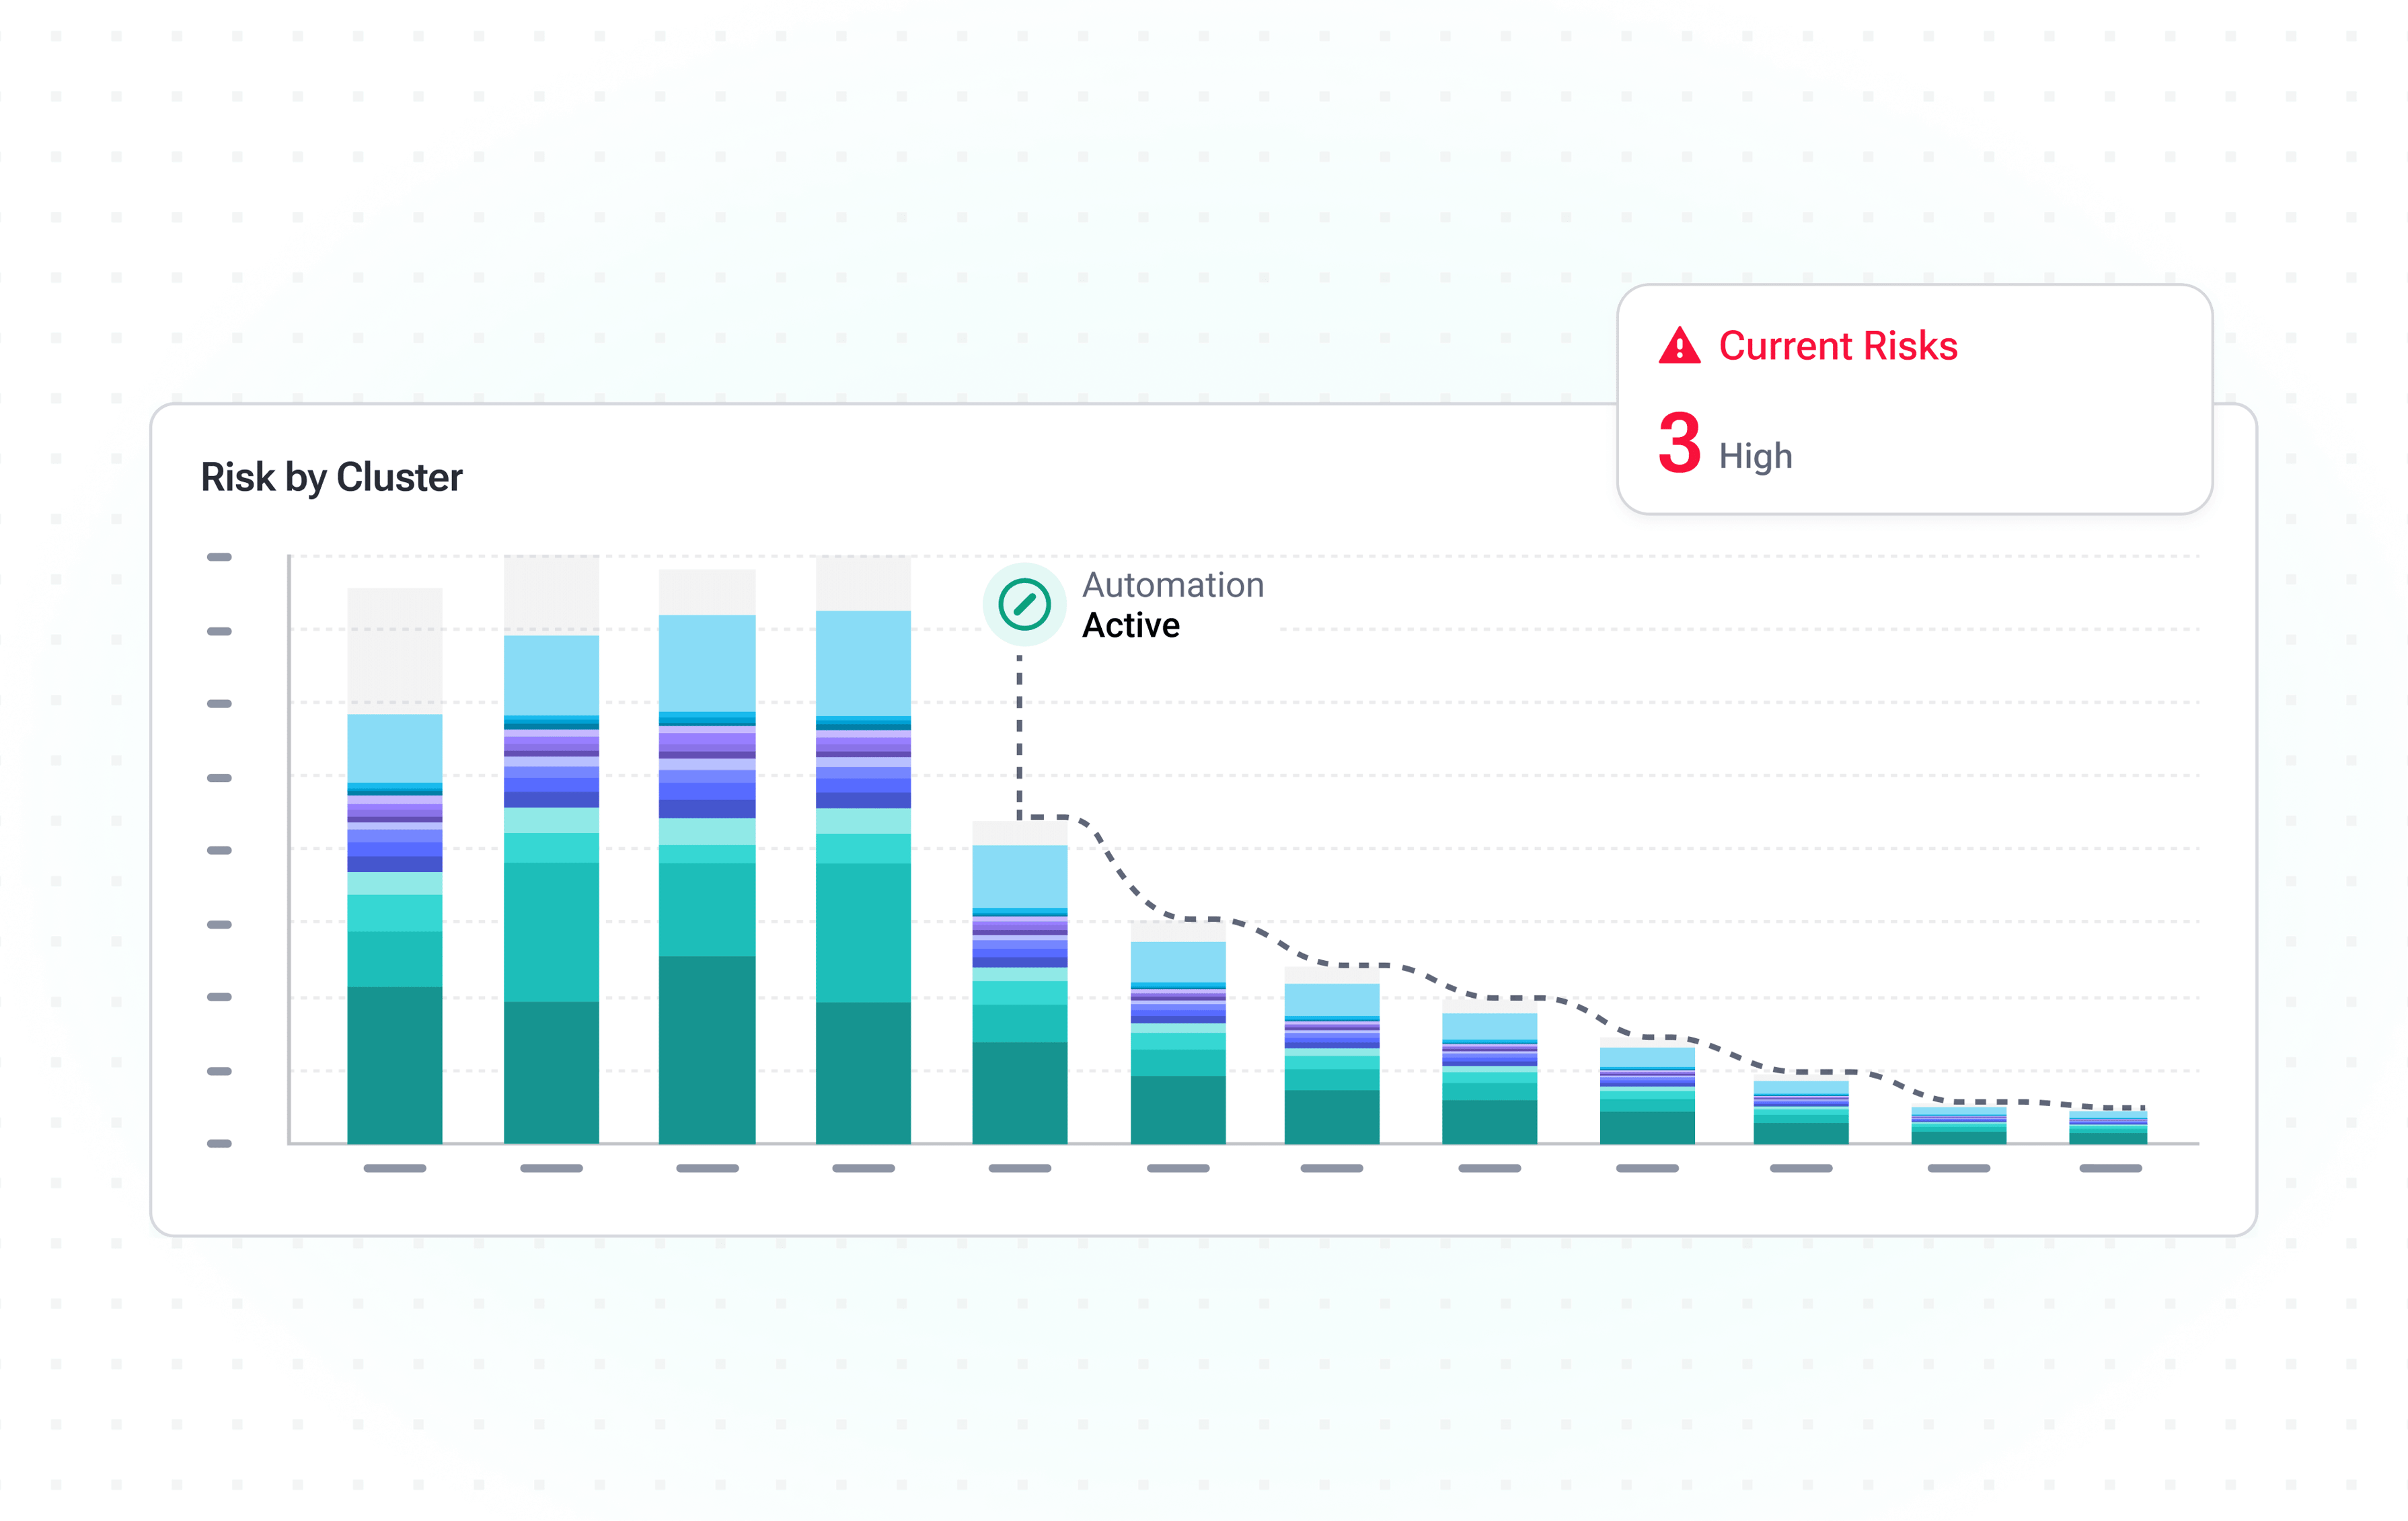
Correção automática de problemas
Maximize o uptime e elimine a latência identificando e corrigindo riscos de resiliência na hora, para entregar um serviço de excelência de forma consistente.
- Previna erros de configuração: sem CPU Request, sem Memory Request, sem Memory Limits, etc.
- Evite o subprovisionamento de recursos: OOM, CPU Throttling, Eviction, etc.
- Elimine erros de código e de configuração de autoscaling: suspeita de memory leak, limite máximo de réplicas atingido, etc.
Fortalecimento da infraestrutura
Tenha visibilidade completa dos seus nodes para identificar proativamente configurações incorretas que podem prejudicar sua infraestrutura.
- Previna o over-commitment de nodes: garanta nodes estáveis e evite evictions com recomendações precisas de limite de memória.
- Garanta node affinities e taints adequados: identifique rapidamente configurações incorretas analisando os padrões de agendamento de workloads entre grupos de nodes.
- Escolha os nodes ideais: alinhe os recursos às demandas dos workloads escolhendo os tipos de node mais adequados para seus pods.
Priorização orientada por impacto
Garanta a consistência do serviço focando nos problemas críticos e resolvendo-os em tempo real com priorização automática avançada.
- Alinhe os alertas aos seus SLAs/SLOs: personalize os alertas para manter seu serviço dentro dos níveis desejados.
- Receba notificações instantâneas: fique por dentro de tudo conectando seu canal de comunicação preferido, como Slack, MS Teams ou DataDog Alerts.
- Escalone com o workflow já estabelecido: garanta que cada problema seja tratado corretamente criando um ticket com um clique.
Capacidades da plataforma e riscos identificados
Tabela de recursos
Indicação e priorização de problemas em tempo real
Detecte e classifique problemas no momento em que acontecem.
Resoluções recomendadas
Receba recomendações de correção claras e acionáveis.
Correção autônoma
Aplique correções automaticamente, sem etapas manuais.
Integrações de alertas e tickets
Conecte Slack, MS Teams, DataDog e ferramentas de tickets.
Evictions
Detecte evictions de pods antes que afetem os usuários.
Out of Memory
Capture eventos de OOM e suas causas subjacentes.
Suspeita de memory leak
Identifique workloads com padrões de memory leak.
CPU Throttling
Revele workloads com throttling que prejudicam a performance.
Restarts de pods
Acompanhe padrões de restart e suas causas raiz.
HPA no máximo de réplicas
Detecte autoscalers atingindo seu teto.
Memória subprovisionada
Encontre workloads com requests e limits de memória insuficientes.
CPU subprovisionada
Encontre workloads com requests e limits de CPU insuficientes.
Memória não definida
Detecte workloads sem request e limit de memória.
CPU não definida
Detecte workloads sem request e limit de CPU.
Frequently asked
questions
O que é performance de Kubernetes?
A performance de Kubernetes indica o quão confiável e resiliente é a execução de workloads pelos clusters. Ela pode ser medida por disponibilidade, uptime contínuo e estabilidade durante a operação normal e os picos de tráfego, garantindo que as aplicações atendam aos níveis de serviço declarados.
Como melhorar a performance do Kubernetes rapidamente?
Para melhorar a performance de forma rápida e eficiente, primeiro é preciso identificar os problemas mais urgentes. Fazer o rightsizing dos pods e tratar riscos como alto CPU throttling, pressão de memória, etc., pode gerar resultados imediatos e melhorar significativamente a estabilidade do cluster.
No entanto, performance nunca é algo do tipo "configure e esqueça". Ela exige otimização contínua e ajustes proativos para manter os clusters resilientes e confiáveis. É aí que a automação de escalonamento entra em cena. Ao configurar autoscaling horizontal, vertical ou ambos, você pode ajustar os recursos dinamicamente com base na demanda real, garantindo que seus clusters tenham recursos suficientes para performar continuamente.
Por que os pods reiniciam mesmo quando os nodes parecem saudáveis?
Restarts de pods, mesmo quando os nodes parecem saudáveis, são um desafio comum que as equipes enfrentam ao gerenciar clusters K8s. Na maioria dos casos, o problema não está no nível do node, e sim no pod. Eventos de OOM e OOMKilled, CPU throttling, memory leaks ou requests e limits imprecisos podem provocar restarts. Mesmo com capacidade disponível nos nodes, workloads mal configurados podem falhar, ainda que a infraestrutura subjacente esteja saudável. Ao mesmo tempo, nodes saudáveis, porém inadequados, também podem causar instabilidade se não atenderem aos requisitos dos workloads (por exemplo, instâncias otimizadas para CPU executando workloads intensivos em memória).
A PerfectScale oferece uma abordagem multidimensional para a otimização de K8s, permitindo que as equipes otimizem cada camada do ambiente, do right-sizing de workloads à seleção dos nodes mais adequados para eles.
Como o autoscaling afeta a performance?
O autoscaling ajuda a manter os clusters performáticos ajustando os recursos em tempo real com base na demanda real. Quando configurado corretamente, ele mantém a disponibilidade e a estabilidade durante a operação normal e os picos de tráfego. Autoscalers de cluster como o Karpenter escalam os clusters verticalmente, ajustando os recursos dos nodes conforme a demanda e garantindo que os clusters tenham recursos suficientes para performar. Soluções como HPA ou KEDA escalam horizontalmente, ajustando automaticamente o número de réplicas de pods, mantendo a utilização de recursos dentro dos limites definidos e evitando o subprovisionamento.
A PerfectScale refina as configurações para garantir gatilhos de escalonamento precisos, maximizando a eficiência do autoscaling.
É possível prevenir CPU throttling sem overprovisioning?
Muitas vezes, as equipes presumem que o overprovisioning de recursos garante a estabilidade do cluster e elimina o CPU throttling. No entanto, adicionar mais CPU do que o necessário não previne o throttling se os requests e limits estiverem mal configurados e, em alguns casos, pode impactar negativamente os clusters, causando problemas de agendamento que levam a instabilidade e downtime.
A PerfectScale analisa continuamente os workloads K8s e faz o right-sizing autônomo dos requests e limits de CPU com base na demanda real, reduzindo o risco de throttling e mantendo a performance máxima enquanto diminui os custos de nuvem.
Reduza os custos de nuvem e mantenha a performance máxima
Instale em minutos e receba insights de otimização autônoma.