
Autonomes Right-Sizing verbessert die Resilienz und hält kritische Services schnell und verfügbar.

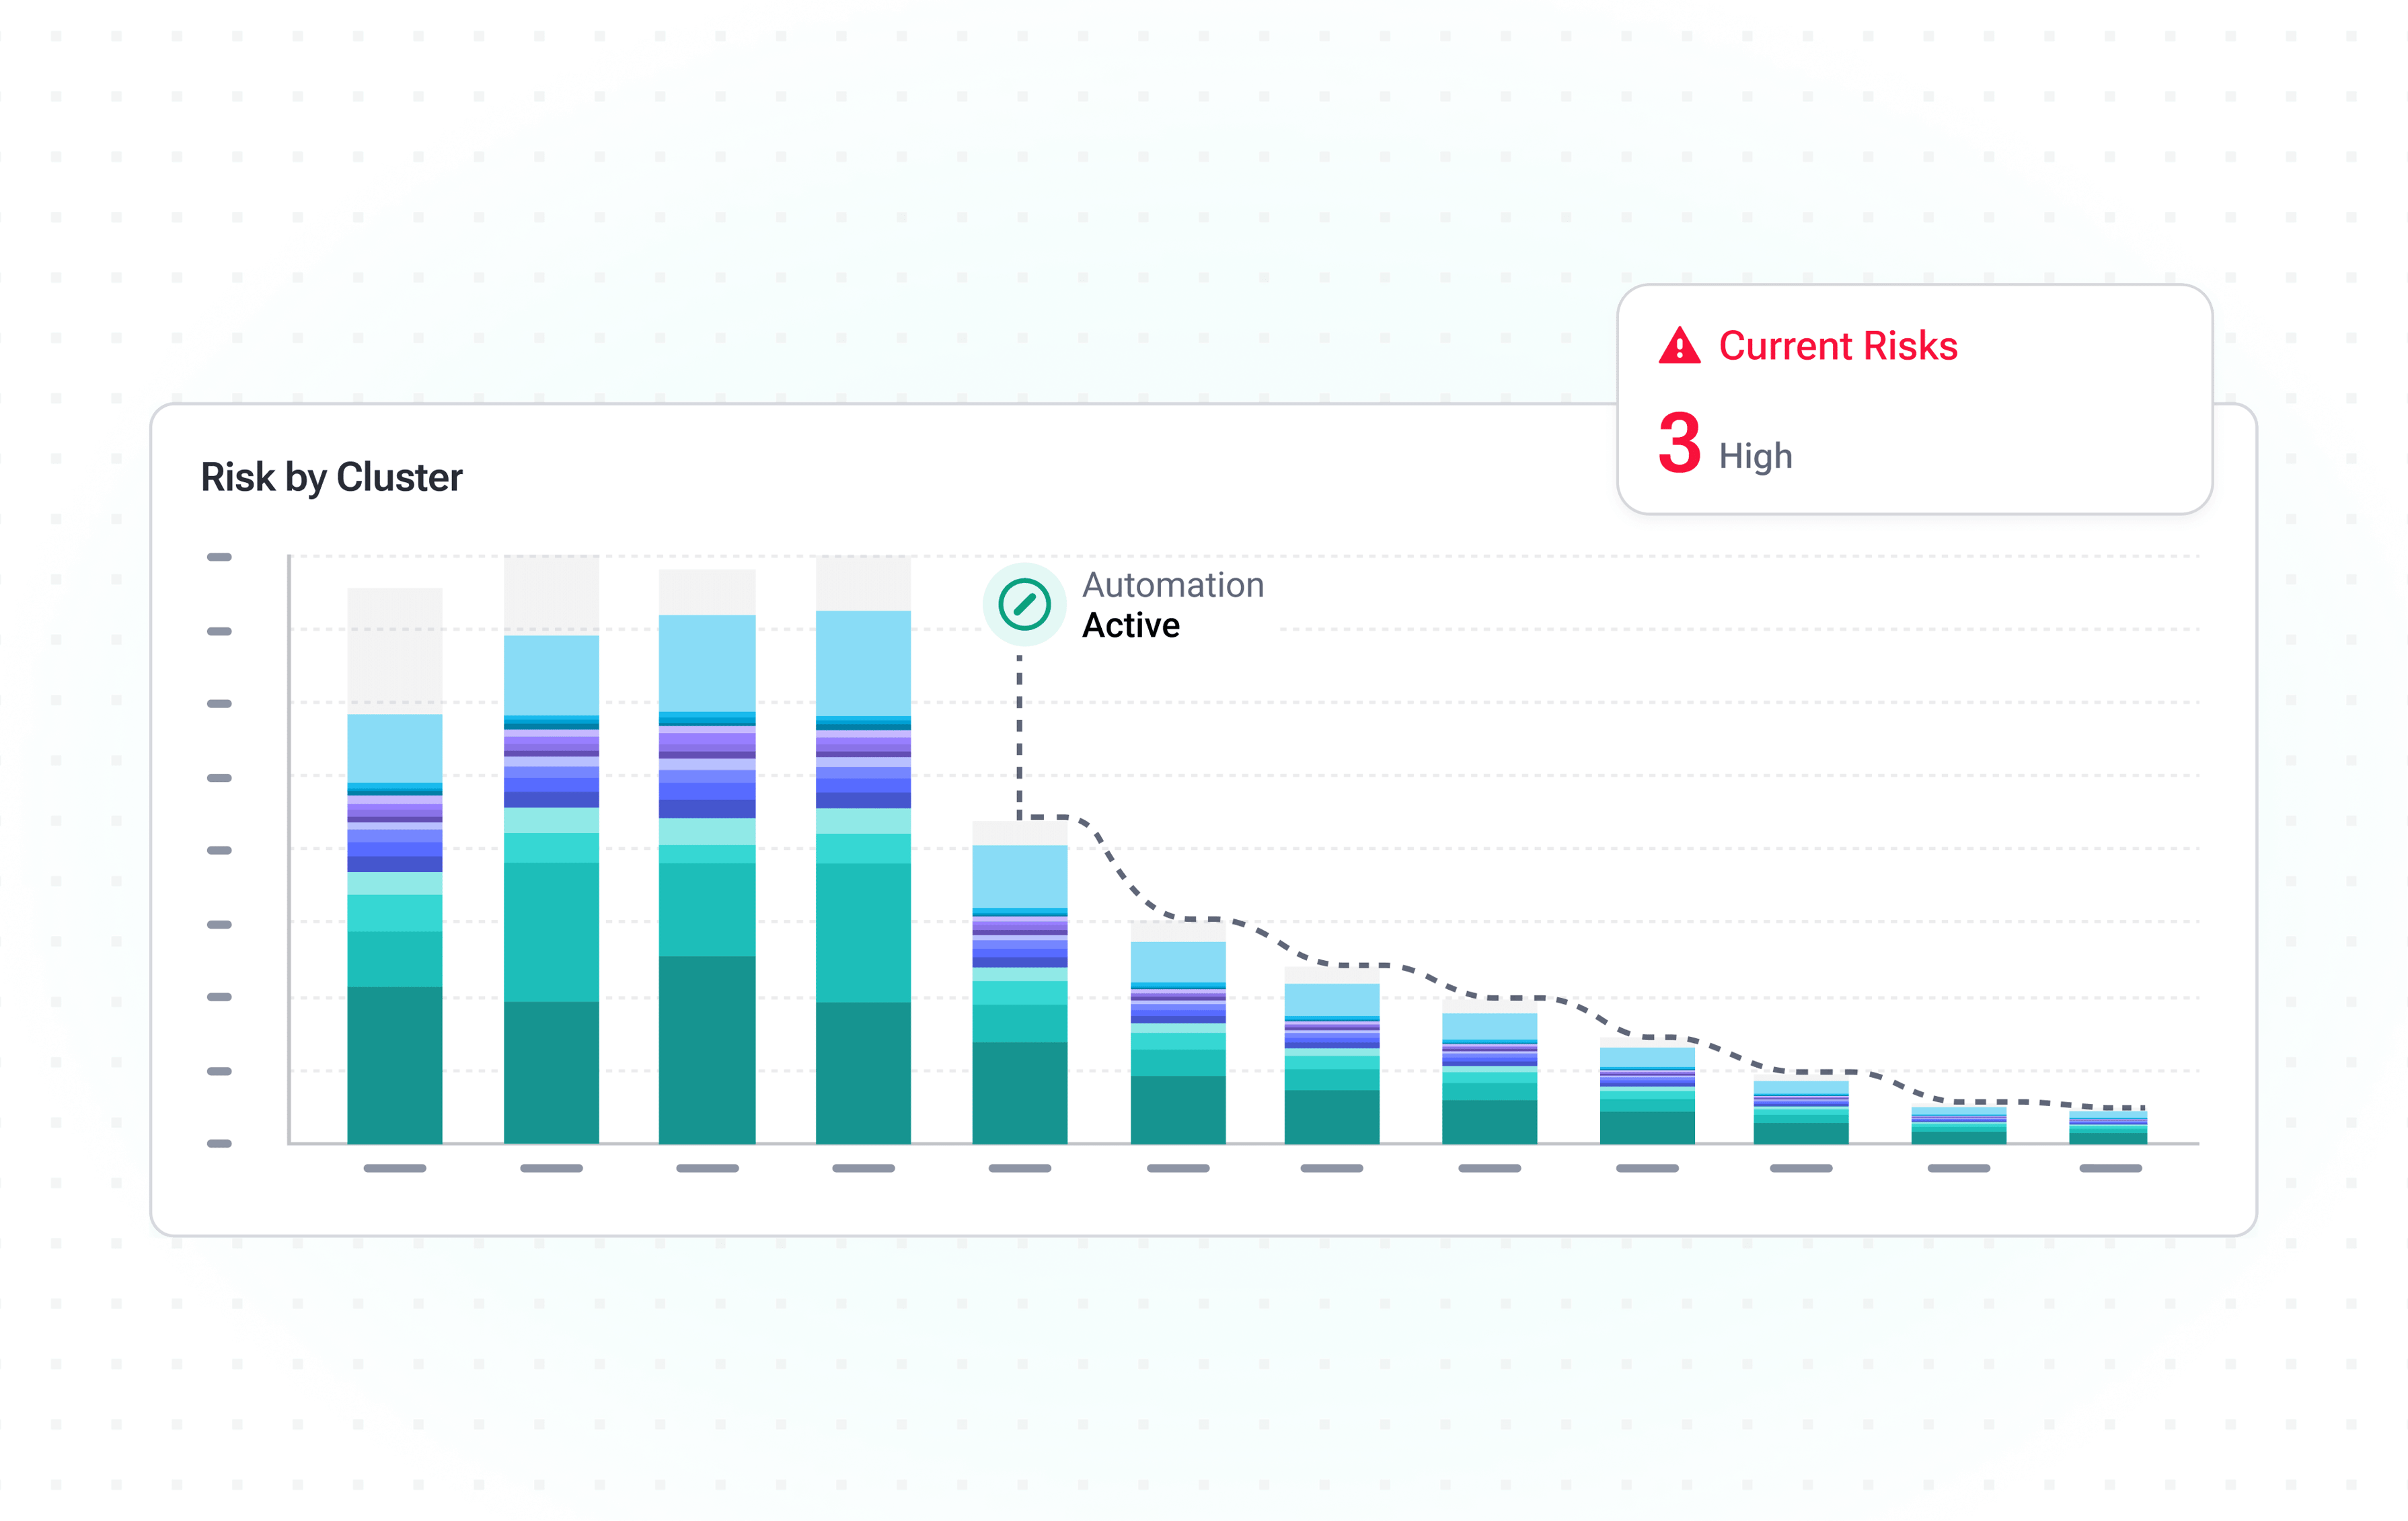
Automatische Problembehebung
Maximieren Sie die Uptime und eliminieren Sie Latenzen, indem Sie Resilienzrisiken sofort erkennen und beheben – für durchgehend exzellente Services.
- Konfigurationsfehler verhindern: kein CPU Request, kein Memory Request, keine Memory Limits usw.
- Underprovisioning von Ressourcen vermeiden: OOM, CPU Throttling, Eviction usw.
- Fehler im Code und in der Autoscaling-Konfiguration eliminieren: vermutetes Memory-Leak, Erreichen des Max-Replica-Limits usw.
Infrastruktur härten
Verschaffen Sie sich einen ganzheitlichen Überblick über Ihre Nodes und identifizieren Sie proaktiv Fehlkonfigurationen, die Ihrer Infrastruktur schaden könnten.
- Node-Overcommitment verhindern: Sorgen Sie mit präzisen Memory-Limit-Empfehlungen für stabile Nodes und vermeiden Sie Evictions.
- Korrekte Node Affinities und Taints sicherstellen: Erkennen Sie Fehlkonfigurationen schnell, indem Sie Scheduling-Muster Ihrer Workloads über Node-Gruppen hinweg analysieren.
- Optimale Nodes wählen: Stimmen Sie Ressourcen auf den Bedarf Ihrer Workloads ab, indem Sie die passendsten Node-Typen für Ihre Pods auswählen.
Impact-basierte Priorisierung
Sichern Sie konsistente Services, indem Sie kritische Probleme dank intelligenter Auto-Priorisierung in Echtzeit erkennen und beheben.
- Alerting an Ihren SLAs/SLOs ausrichten: Passen Sie das Alerting individuell an, um Ihre Services im Zielbereich zu halten.
- Sofortige Benachrichtigungen erhalten: Bleiben Sie informiert – über Ihren bevorzugten Kanal wie Slack, MS Teams oder DataDog Alerts.
- Über etablierte Workflows eskalieren: Stellen Sie sicher, dass jedes Problem sauber bearbeitet wird – mit einem Klick zum Ticket.
Plattform-Funktionen und erkannte Risiken
Feature-Übersicht
Echtzeit-Erkennung und Priorisierung von Problemen
Probleme sofort erkennen und nach Dringlichkeit einordnen.
Empfohlene Lösungen
Klare, umsetzbare Empfehlungen zur Behebung erhalten.
Autonome Remediation
Fixes automatisch anwenden – ganz ohne manuelle Schritte.
Alerts und Ticketing-Integrationen
Slack, MS Teams, DataDog und Ticketing-Tools anbinden.
Evictions
Pod-Evictions erkennen, bevor Nutzer betroffen sind.
Out of Memory
OOM-Events und ihre Ursachen aufdecken.
Vermutetes Memory-Leak
Workloads mit Memory-Leak-Mustern identifizieren.
CPU Throttling
Gedrosselte Workloads sichtbar machen, die die Performance beeinträchtigen.
Pod-Neustarts
Restart-Muster und ihre Ursachen nachverfolgen.
HPA am Replica-Limit
Autoscaler erkennen, die an ihre Obergrenze stoßen.
Zu wenig Memory zugewiesen
Workloads mit zu knappen Memory Requests und Limits finden.
Zu wenig CPU zugewiesen
Workloads mit zu knappen CPU Requests und Limits finden.
Memory nicht gesetzt
Workloads ohne Memory Request und Limit aufspüren.
CPU nicht gesetzt
Workloads ohne CPU Request und Limit aufspüren.
Frequently asked
questions
Was bedeutet Kubernetes-Performance?
Kubernetes-Performance beschreibt, wie zuverlässig und resilient Cluster ihre Workloads ausführen. Sie lässt sich an Verfügbarkeit, kontinuierlicher Uptime und Stabilität im Regelbetrieb sowie bei Traffic-Spitzen messen – damit Anwendungen ihre zugesicherten Service-Level einhalten.
Wie verbessere ich die Kubernetes-Performance schnell?
Um die Performance schnell und effizient zu verbessern, müssen Sie zunächst die dringendsten Probleme identifizieren. Das Right-Sizing von Pods und die Behebung von Risiken wie starkem CPU Throttling oder Memory Pressure liefern sofort spürbare Ergebnisse und verbessern die Cluster-Stabilität deutlich.
Performance funktioniert jedoch nie nach dem Prinzip "einmal einrichten und vergessen". Sie erfordert kontinuierliche Optimierung und proaktives Tuning, damit Cluster resilient und zuverlässig bleiben. Genau hier kommt Scaling-Automatisierung ins Spiel: Mit horizontalem, vertikalem oder kombiniertem Autoscaling passen Sie Ressourcen dynamisch an den tatsächlichen Bedarf an und stellen sicher, dass Ihre Cluster jederzeit über ausreichend Ressourcen verfügen.
Warum starten Pods neu, obwohl die Nodes gesund erscheinen?
Pod-Neustarts trotz scheinbar gesunder Nodes sind eine häufige Herausforderung beim Betrieb von K8s-Clustern. In den meisten Fällen liegt das Problem nicht auf Node-Ebene, sondern beim Pod: OOM- bzw. OOMKilled-Events, CPU Throttling, Memory-Leaks oder ungenaue Requests und Limits können Neustarts auslösen. Selbst bei freier Node-Kapazität können schlecht konfigurierte Workloads fehlschlagen – auch wenn die zugrunde liegende Infrastruktur gesund ist. Gleichzeitig können gesunde, aber falsch gewählte Nodes Instabilität verursachen, wenn sie nicht zu den Anforderungen der Workloads passen (zum Beispiel CPU-optimierte Instanzen für speicherintensive Workloads).
PerfectScale verfolgt einen mehrdimensionalen Ansatz für die K8s-Optimierung und ermöglicht es Teams, jede Ebene ihrer Umgebung zu optimieren – vom Right-Sizing der Workloads bis zur Auswahl der am besten geeigneten Nodes.
Wie wirkt sich Autoscaling auf die Performance aus?
Autoscaling hält Cluster performant, indem es Ressourcen in Echtzeit an den tatsächlichen Bedarf anpasst. Richtig konfiguriert sichert es Verfügbarkeit und Stabilität – im Regelbetrieb ebenso wie bei Traffic-Spitzen. Cluster-Autoscaler wie Karpenter skalieren Cluster vertikal, indem sie Node-Ressourcen bedarfsgerecht anpassen und so sicherstellen, dass Cluster über genügend Ressourcen verfügen. Lösungen wie HPA oder KEDA skalieren horizontal, indem sie die Anzahl der Pod-Replicas automatisch anpassen, die Ressourcenauslastung innerhalb definierter Schwellenwerte halten und Underprovisioning verhindern.
PerfectScale justiert die Konfigurationen für präzise Scaling-Trigger und maximiert so die Effizienz des Autoscalings.
Kann ich CPU Throttling ohne Overprovisioning verhindern?
Häufig gehen Teams davon aus, dass Overprovisioning die Cluster-Stabilität garantiert und CPU Throttling ausschließt. Mehr CPU als nötig verhindert Throttling jedoch nicht, wenn Requests und Limits falsch konfiguriert sind – in manchen Fällen schadet es den Clustern sogar, verursacht Scheduling-Probleme und führt zu Instabilität und Ausfällen.
PerfectScale analysiert K8s-Workloads kontinuierlich und passt CPU Requests und Limits autonom an den tatsächlichen Bedarf an. Das reduziert das Throttling-Risiko, sichert Spitzenperformance und senkt gleichzeitig die Cloud-Kosten.
Cloud-Kosten senken, Spitzenperformance halten
In wenigen Minuten installiert – mit autonomen Optimierungs-Insights.