
Latest
More Posts
242 published posts
DaemonSet in Kubernetes: tutorial, casi d'uso e best practice
Come un DaemonSet Kubernetes esegue un pod su ogni nodo idoneo: un tutorial pratico, i casi d'uso più comuni, le differenze rispetto a un Deployment e le best practice per risorse e aggiornamenti.
Il tuo servizio JVM ha bisogno di 2 CPU per 30 secondi e di 0,3 CPU per sempre
È nei primi secondi che una JVM richiede più CPU. Scopri come i limiti CPU di Kubernetes rallentano l'avvio della JVM, come misurarlo e come dimensionare i pod.
Cheat Sheet kubectl: lavorare con cluster, pod, deployment e molto altro
Una cheat sheet kubectl pronta all'uso che copre context, pod, deployment, service, RBAC, log e debugging, con consigli su alias e autocompletamento per lavorare più velocemente con Kubernetes.
NodeSelector in Kubernetes: sintassi, esempi e 5 best practice
Guida pratica a nodeSelector in Kubernetes: come lo scheduler confronta le label dei nodi, sintassi YAML, esempi reali, confronto con node affinity e nodeName, oltre a cinque best practice.
EKS Cluster Autoscaler: funzionamento, configurazione e best practice
Una guida pratica all'Amazon EKS Cluster Autoscaler: come scala i nodi, configurazione passo dopo passo, confronto con HPA ed EKS Auto Mode e sette best practice.
CPU throttling e OOM kill su Kubernetes: come scovare gli spike di avvio
Gli spike di avvio causano throttling, OOM kill con exit code 137 e rollout bloccati, per poi sparire dalle dashboard. Ecco come rilevarli filtrando le metriche per età del container.
Workloads Kubernetes: i 6 tipi, il ciclo di vita e le best practice
Scopra i sei tipi principali di workloads Kubernetes, come i workloads attraversano scheduling, scaling e terminazione, e le best practice per right-sizing e affidabilità.
Kubernetes Tolerations: esempi, casi d'uso e best practice
Scoprite come funzionano le tolerations di Kubernetes con i taint dei nodi: operatori Equal, Exists, Gt e Lt, effect NoSchedule e NoExecute, esempi YAML e best practice di scheduling.
Prezzi di GKE Autopilot: costi, esempi e 5 best practice
Un'analisi dei prezzi di GKE Autopilot: tariffe di gestione del cluster, fatturazione basata sui pod, Flex CUD ed esempi di costo, oltre a cinque pratiche per tenere la spesa sotto controllo.
Kubernetes Exit Code 143: le 8 cause e come risolverlo
L'exit code 143 segnala l'arresto di un container tramite SIGTERM, di norma non un errore applicativo. Scopra le 8 cause più comuni, un flusso di troubleshooting passo dopo passo e le best practice di prevenzione.
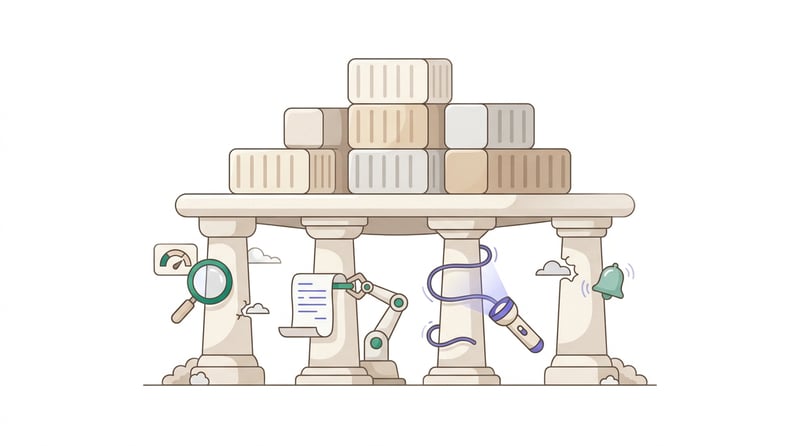
I 4 pilastri dell'osservabilità di Kubernetes: sfide e best practice
Scopra i quattro pilastri dell'osservabilità di Kubernetes — metriche, log, tracce e profili — oltre alle metriche chiave da monitorare, alle sfide comuni e alle best practice per cluster affidabili.