
Il right-sizing autonomo migliora la resilienza e mantiene i servizi critici veloci e sempre disponibili.

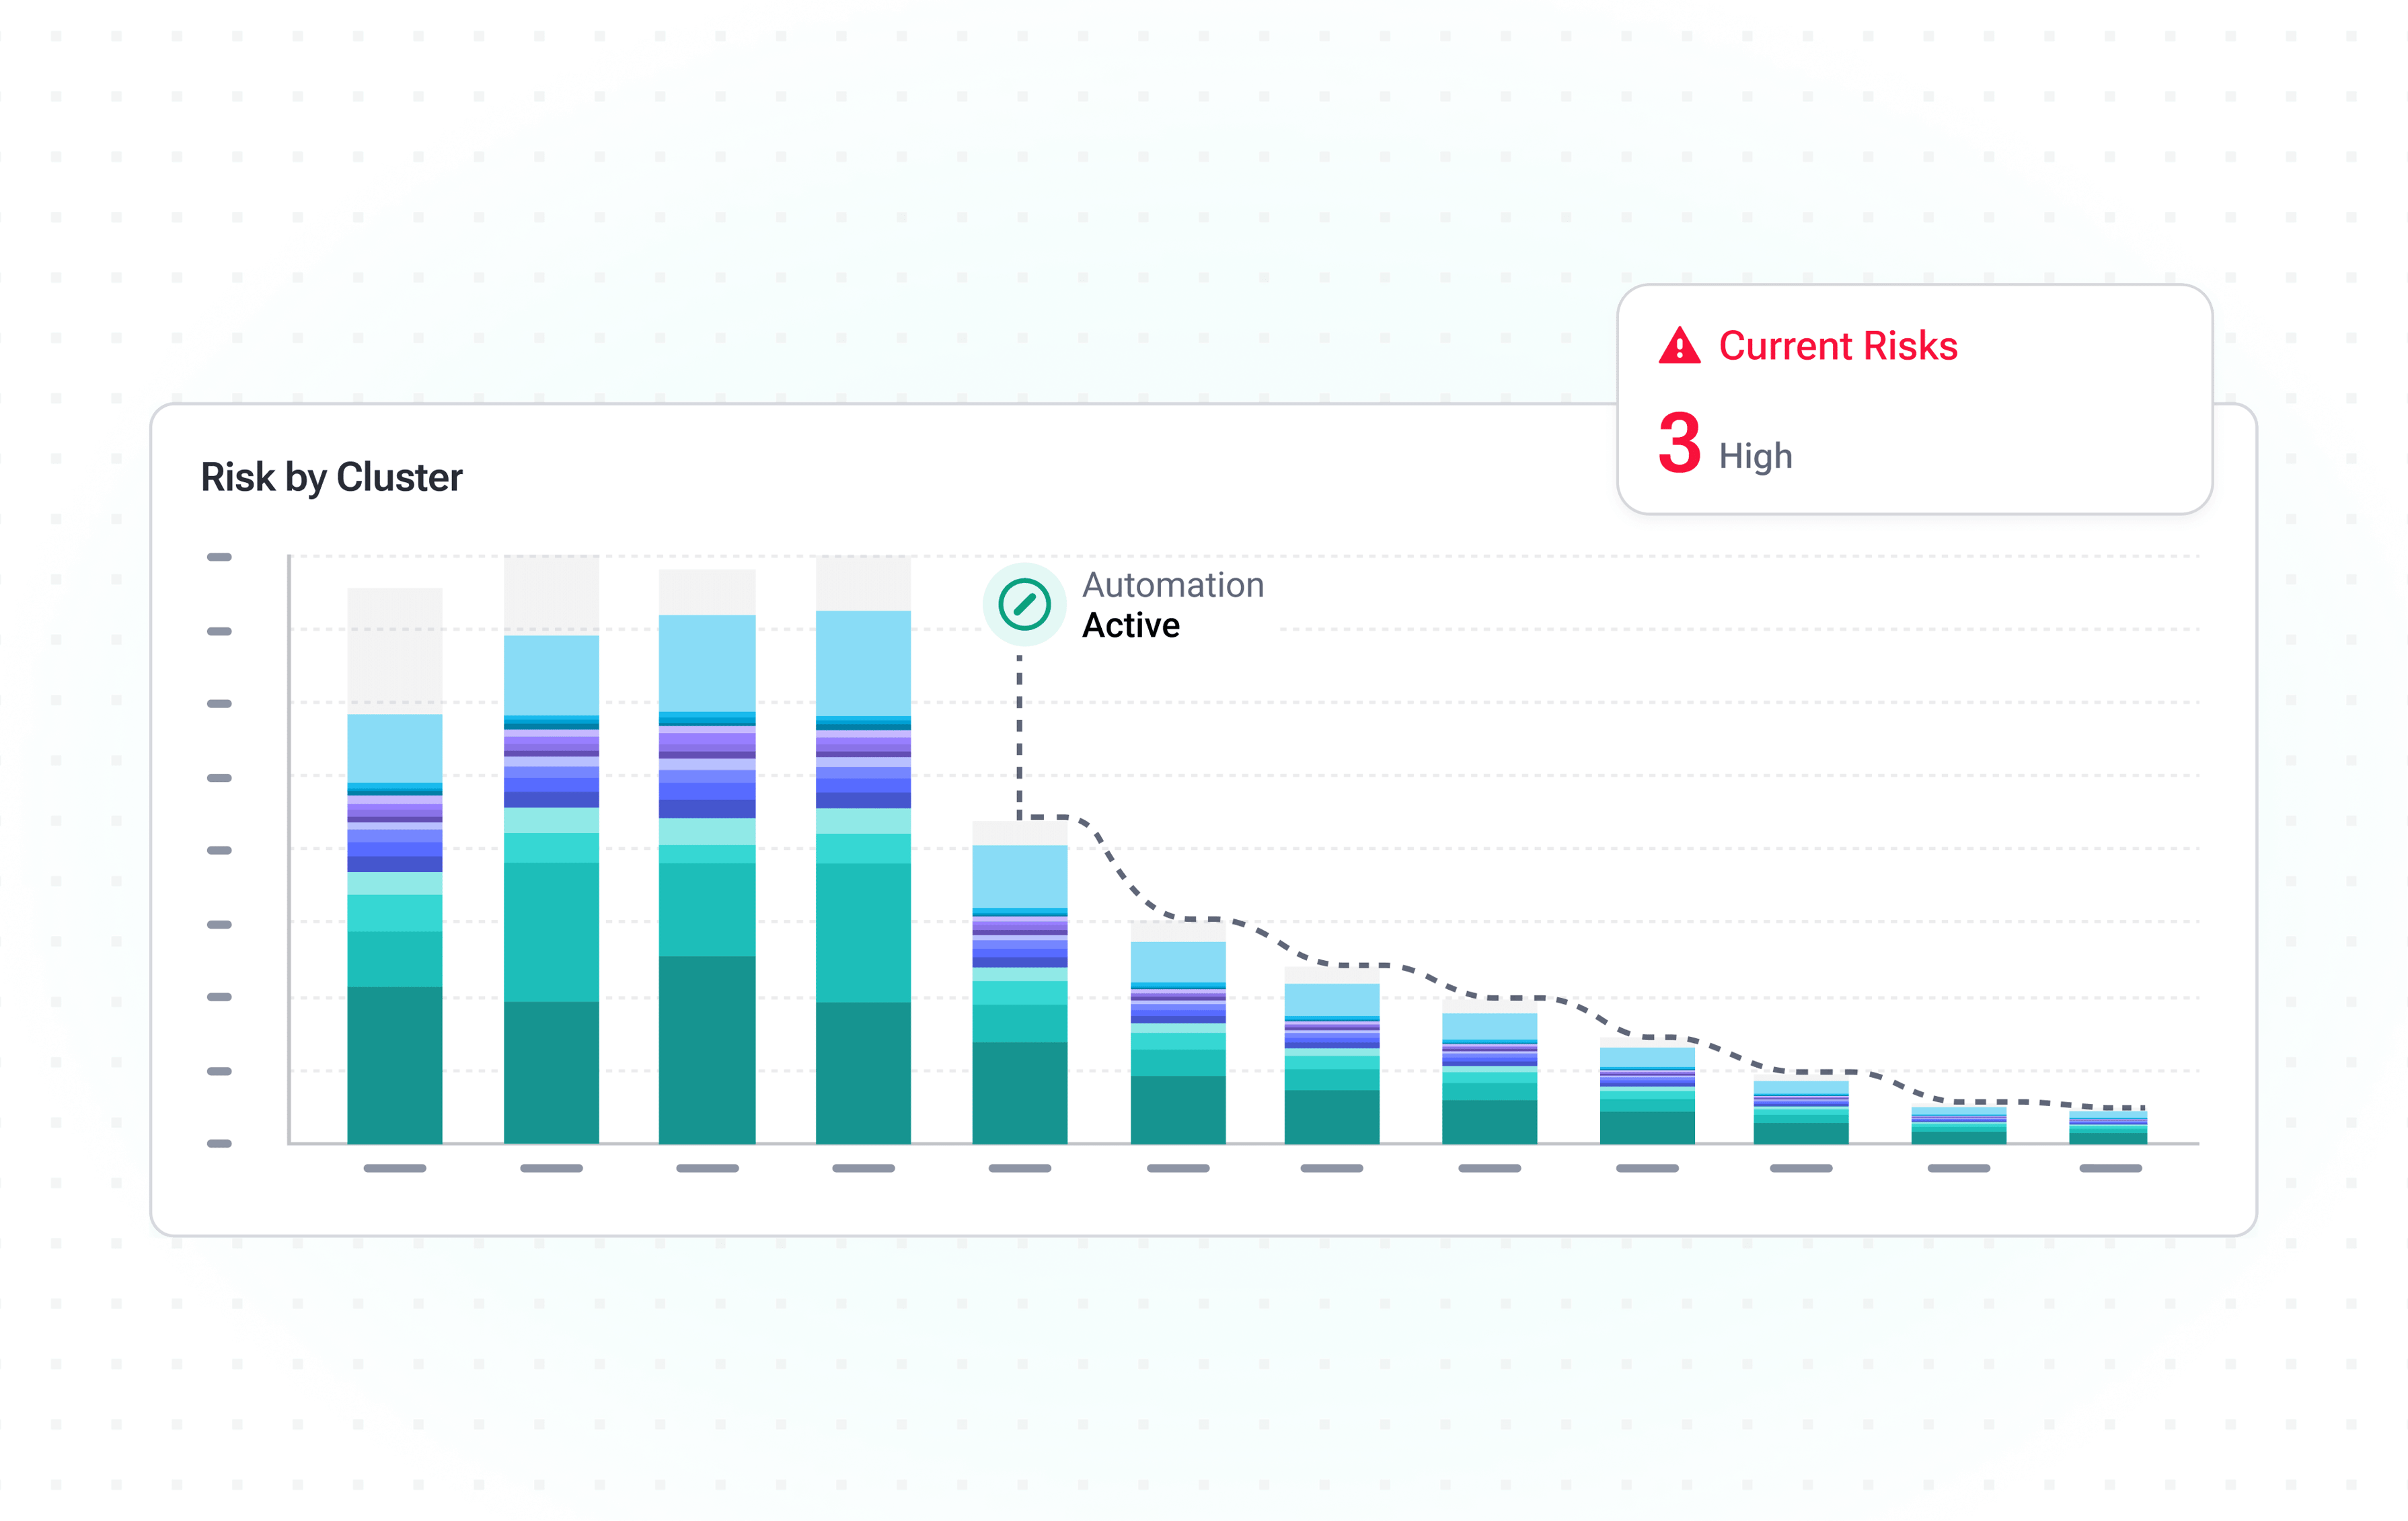
Risoluzione automatica dei problemi
Massimizzi l'uptime ed elimini la latenza identificando e risolvendo all'istante i rischi di resilienza, per garantire un servizio di eccellenza costante.
- Prevenzione degli errori di configurazione: assenza di CPU Request, Memory Request, Memory Limits, ecc.
- Nessun sottodimensionamento delle risorse: OOM, CPU Throttling, eviction, ecc.
- Eliminazione degli errori nel codice e nella configurazione dell'autoscaling: sospetti memory leak, raggiungimento del numero massimo di repliche, ecc.
Hardening dell'infrastruttura
Ottenga una visibilità completa su tutti i nodi per individuare in modo proattivo le configurazioni errate che potrebbero compromettere l'infrastruttura.
- Prevenzione dell'over-commitment dei nodi: nodi stabili e nessuna eviction grazie a raccomandazioni precise sui limiti di memoria.
- Node Affinity e Taint corretti: individui rapidamente le configurazioni errate analizzando i pattern di scheduling dei workloads tra i gruppi di nodi.
- Scelta dei nodi ottimali: allinei le risorse alle esigenze dei workloads selezionando i tipi di nodo più adatti ai suoi pod.
Prioritizzazione basata sull'impatto
Garantisca la coerenza del servizio concentrandosi sui problemi critici e risolvendoli in tempo reale grazie alla prioritizzazione automatica avanzata.
- Alert allineati a SLA e SLO: personalizzi gli avvisi per mantenere il servizio entro i livelli target.
- Notifiche istantanee: resti sempre informato collegando il canale di comunicazione che preferisce, come Slack, MS Teams o DataDog Alerts.
- Escalation con workflow consolidati: garantisca la corretta gestione di ogni problema creando un ticket con un solo clic.
Funzionalità della piattaforma e rischi identificati
Panoramica delle funzionalità
Individuazione e prioritizzazione dei problemi in tempo reale
Individui e classifichi i problemi nel momento in cui si verificano.
Risoluzioni consigliate
Riceva raccomandazioni di correzione chiare e attuabili.
Remediation autonoma
Applichi le correzioni in automatico, senza interventi manuali.
Integrazioni con alert e ticketing
Colleghi Slack, MS Teams, DataDog e gli strumenti di ticketing.
Eviction
Rilevi le eviction dei pod prima che impattino gli utenti.
Out of Memory
Intercetti gli eventi OOM e le relative cause.
Sospetto memory leak
Identifichi i workloads che mostrano pattern di memory leak.
CPU Throttling
Individui i workloads soggetti a throttling che penalizzano le performance.
Riavvii dei pod
Monitori i pattern di riavvio e le cause alla radice.
HPA al numero massimo di repliche
Individui gli autoscaler che raggiungono il proprio limite.
Memoria sottodimensionata
Trovi i workloads con request e limit di memoria insufficienti.
CPU sottodimensionata
Trovi i workloads con request e limit di CPU insufficienti.
Memoria non impostata
Individui i workloads privi di request e limit di memoria.
CPU non impostata
Individui i workloads privi di request e limit di CPU.
Frequently asked
questions
Cosa si intende per performance di Kubernetes?
Le performance di Kubernetes indicano quanto i cluster eseguono i workloads in modo affidabile e resiliente. Si misurano in termini di disponibilità, uptime continuo e stabilità sia durante l'attività ordinaria sia nei picchi di traffico, garantendo che le applicazioni rispettino i livelli di servizio dichiarati.
Come posso migliorare rapidamente le performance di Kubernetes?
Per migliorare le performance in modo rapido ed efficiente occorre innanzitutto identificare i problemi più urgenti. Il right-sizing dei pod e la gestione di rischi come CPU throttling elevato, memory pressure, ecc. possono produrre risultati immediati e migliorare in modo significativo la stabilità del cluster.
Tuttavia, le performance non sono mai un'attività "imposta e dimentica": richiedono un'ottimizzazione continua e un tuning proattivo per mantenere i cluster resilienti e affidabili. È qui che entra in gioco l'automazione dello scaling. Configurando l'autoscaling orizzontale, verticale o entrambi, è possibile adattare dinamicamente le risorse alla domanda effettiva, assicurando ai cluster risorse sufficienti per garantire performance costanti.
Perché i pod si riavviano anche quando i nodi sembrano in salute?
I riavvii dei pod, anche quando i nodi sembrano in salute, sono una sfida comune per i team che gestiscono cluster K8s. Nella maggior parte dei casi il problema non è a livello di nodo, ma di pod. Eventi OOM e OOMKilled, CPU throttling, memory leak oppure request e limit imprecisi possono tutti causare riavvii. Anche con capacità disponibile sui nodi, workloads configurati male possono fallire nonostante l'infrastruttura sottostante sia in salute. Allo stesso tempo, nodi sani ma inadeguati possono causare instabilità se non corrispondono ai requisiti dei workloads (ad esempio, istanze ottimizzate per la CPU che eseguono workloads a uso intensivo di memoria).
PerfectScale offre un approccio multidimensionale all'ottimizzazione di K8s, consentendo ai team di ottimizzare ogni livello del proprio ambiente, dal right-sizing dei workloads alla selezione dei nodi più adatti.
In che modo l'autoscaling influisce sulle performance?
L'autoscaling contribuisce a mantenere i cluster performanti adattando le risorse in tempo reale in base alla domanda effettiva. Se configurato correttamente, preserva disponibilità e stabilità sia durante l'attività ordinaria sia nei picchi di traffico. Autoscaler di cluster come Karpenter scalano i cluster verticalmente regolando le risorse dei nodi in base alla domanda, assicurando che i cluster dispongano di risorse sufficienti. Soluzioni come HPA o KEDA scalano orizzontalmente modificando in automatico il numero di repliche dei pod, mantenendo l'utilizzo delle risorse entro soglie definite e prevenendo il sottodimensionamento.
PerfectScale perfeziona le configurazioni per garantire trigger di scaling accurati, massimizzando l'efficienza dell'autoscaling.
Posso prevenire il CPU throttling senza overprovisioning?
Spesso i team presumono che l'overprovisioning delle risorse garantisca la stabilità del cluster ed elimini il CPU throttling. In realtà, aggiungere più CPU del necessario non previene il throttling se request e limit sono configurati male e, in alcuni casi, può avere effetti negativi sui cluster, generando problemi di scheduling che portano a instabilità e downtime.
PerfectScale analizza continuamente i workloads K8s ed esegue in autonomia il right-sizing di request e limit di CPU in base alla domanda effettiva, riducendo il rischio di throttling e mantenendo le massime performance, con costi cloud inferiori.
Riduca i costi cloud senza rinunciare alle massime performance
Installazione in pochi minuti e insight di ottimizzazione autonoma.