
Aumenti l'utilizzo, elimini gli sprechi da risorse inattive e mantenga veloci i workloads AI con segnali di ottimizzazione in tempo reale.

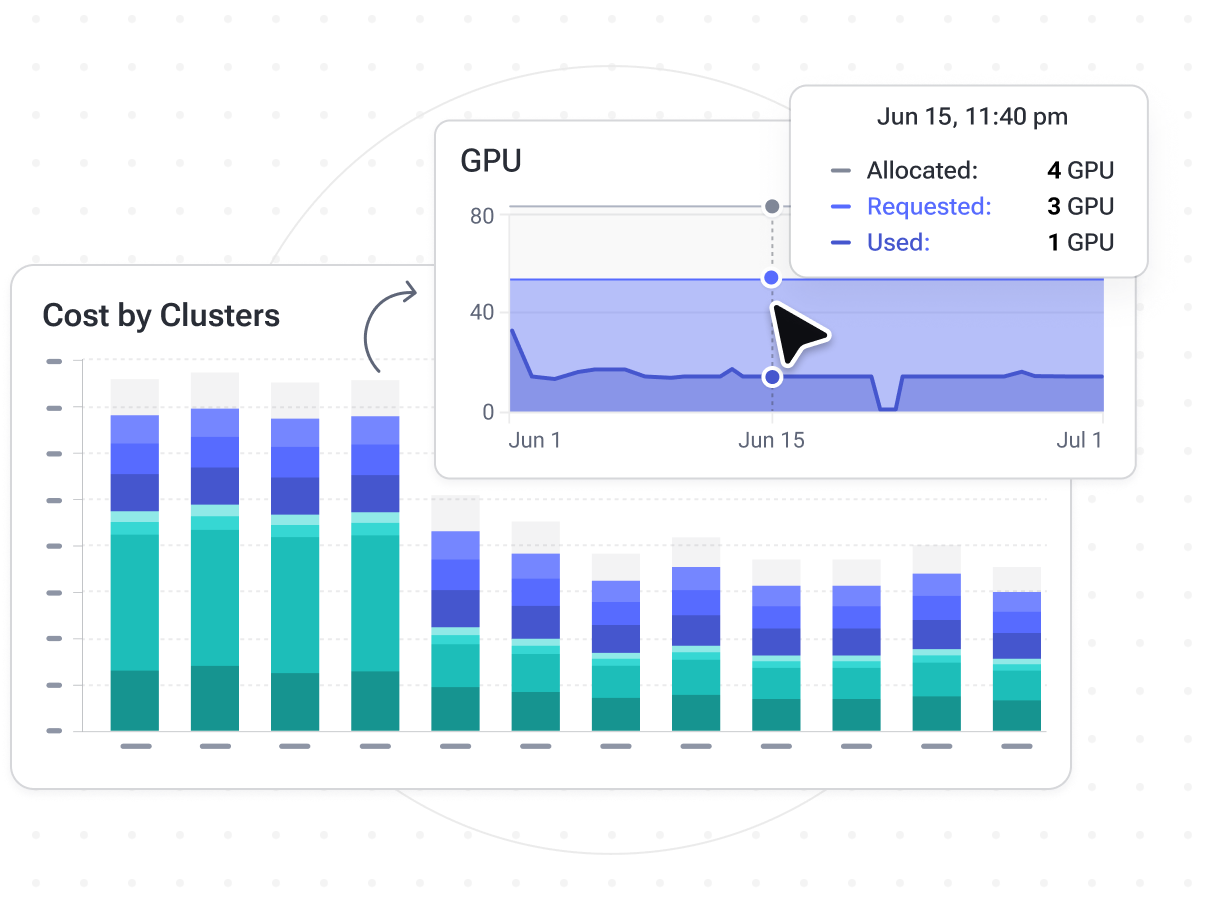
Alimenti l'innovazione, non la bolletta del cloud: tenga le GPU sotto controllo
PerfectScale monitora continuamente i suoi cluster e individua opportunità di ottimizzazione delle GPU, aiutandola a ridurre in modo significativo la spesa cloud.
Visibilità granulare sull'utilizzo delle GPU
Ottenga insight completi sull'utilizzo delle GPU nei cluster e nei gruppi di nodi per identificare pattern di utilizzo e tendenze nel tempo.
Rilevamento immediato degli sprechi GPU
Individui senza sforzo le inefficienze della sua infrastruttura AI identificando i nodi inattivi, sottoutilizzati o mal configurati, per prevenire costi superflui ed eventi di scaling non necessari.
Un'infrastruttura GPU snella
Applichi il right-sizing ai workloads in esecuzione sui nodi GPU con raccomandazioni basate sui dati o tramite automazione, per migliorare lo scheduling ed eliminare nodi superflui e costosi.
Riduca i costi cloud senza rinunciare alle massime prestazioni
Si installa in pochi minuti e fornisce insight di ottimizzazione autonomi.
Frequently asked
questions
Posso provare PerfectScale gratuitamente?
Sì, il Community Package di PerfectScale è gratuito per sempre. Le funzionalità premium, come l'automazione, sono disponibili per gli utenti Community nei primi 30 giorni dalla creazione dell'account. Si registri su https://app.perfectscale.io/account/sign-up.
Che cos'è l'ottimizzazione GPU per Kubernetes?
L'ottimizzazione GPU per Kubernetes è un processo complesso che allinea l'allocazione delle risorse GPU alla domanda effettiva dei workloads, per eliminare gli sprechi, migliorare l'efficienza di utilizzo e ridurre la spesa cloud su K8s. Garantisce che i workloads dispongano esattamente del numero di GPU necessario per funzionare bene senza compromettere le prestazioni.
Come posso ridurre i costi delle GPU nei cluster K8s?
Per ridurre i costi delle GPU in Kubernetes serve una visibilità accurata sull'utilizzo delle GPU in tempo reale, sui pattern di comportamento dei workloads nel tempo e a livello di nodo, per valutare l'efficienza del bin packing, identificare la capacità inattiva e trasformarla in opportunità di ottimizzazione. Applicando il right-sizing ai workloads GPU in base alla domanda, migliorando il bin packing e selezionando le istanze GPU più convenienti, può ridurre facilmente la spesa cloud mantenendo prestazioni e stabilità dei servizi AI.