
Mejora la utilización, elimina la pérdida por inactividad y mantén tus workloads de IA a toda velocidad con señales de optimización en tiempo real.

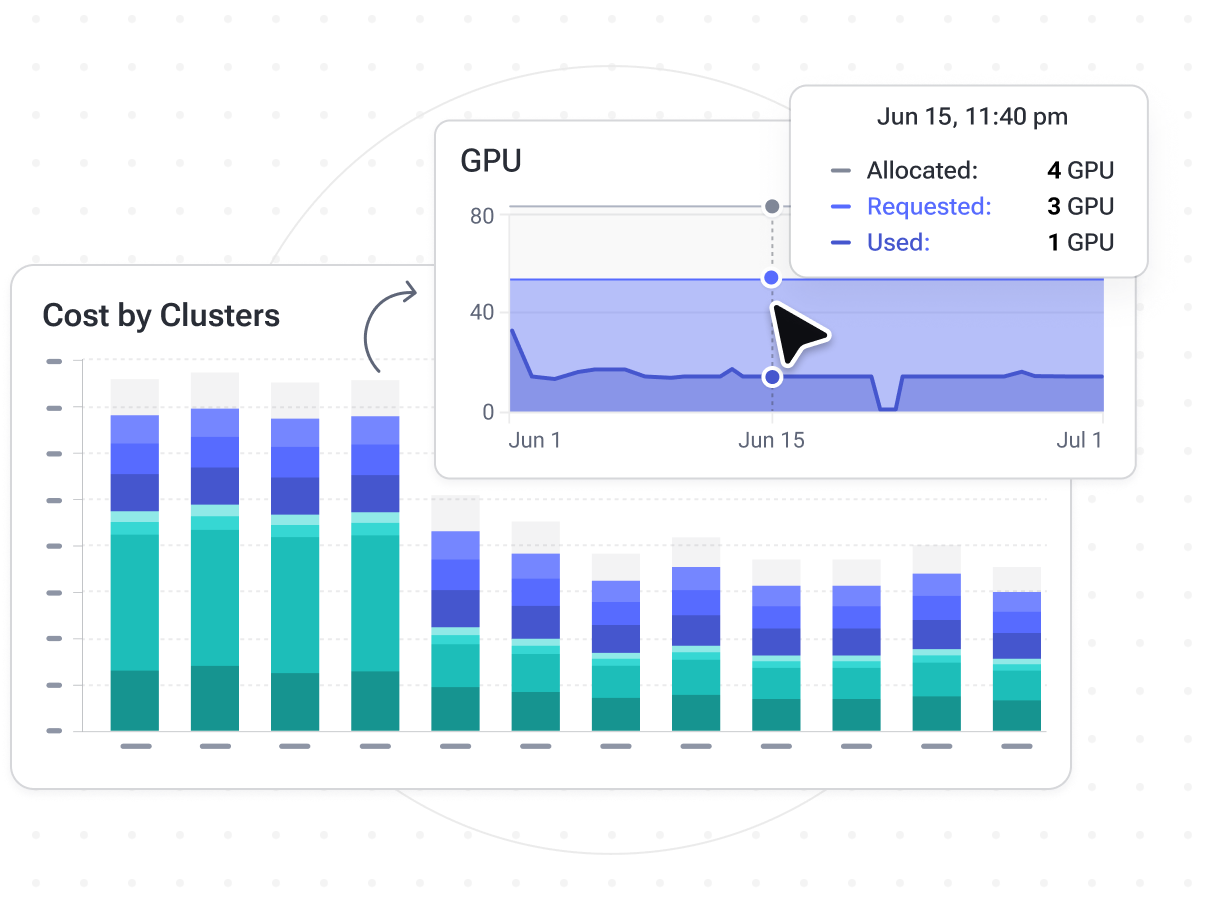
Impulsa la innovación, no tu factura de nube: mantén tus GPUs bajo control
PerfectScale monitorea tus clústeres de forma continua y detecta oportunidades de optimización de GPU para ayudarte a reducir significativamente el gasto en la nube.
Visibilidad granular de la utilización de GPU
Obtén una visión completa de la utilización de GPU en tus clústeres y grupos de nodos para identificar patrones de uso y tendencias a lo largo del tiempo.
Detección instantánea de pérdida en GPU
Identifica sin esfuerzo las ineficiencias en tu infraestructura de IA: detecta nodos inactivos, subutilizados o mal configurados para evitar costos innecesarios y eventos de escalado.
Infraestructura GPU sin excesos
Aplica right-sizing a los workloads que corren en nodos GPU con recomendaciones basadas en datos o automatización, para mejorar el scheduling y eliminar nodos innecesarios y costosos.
Reduce el costo de la nube sin sacrificar el rendimiento
Instálalo en minutos y obtén insights de optimización autónoma.
Frequently asked
questions
¿Puedo probar PerfectScale gratis?
Sí, el paquete Community de PerfectScale es gratuito de por vida. Las funciones premium, como la automatización, están disponibles para los usuarios Community durante los primeros 30 días después de crear una cuenta. Regístrate en https://app.perfectscale.io/account/sign-up.
¿Qué es la optimización de GPU en Kubernetes?
La optimización de GPU en Kubernetes es un proceso complejo que consiste en alinear la asignación de recursos GPU con la demanda real de los workloads para eliminar la pérdida, mejorar la eficiencia de utilización y reducir el gasto en la nube de K8s. Garantiza que los workloads tengan exactamente la cantidad de GPUs necesaria para funcionar bien sin comprometer el rendimiento.
¿Cómo puedo reducir los costos de GPU en clústeres de K8s?
Para reducir los costos de GPU en Kubernetes, necesitas visibilidad precisa de la utilización de GPU en tiempo real, de los patrones de comportamiento de los workloads a lo largo del tiempo y también a nivel de nodo, para evaluar la eficiencia del bin packing, identificar la capacidad inactiva y convertirla en oportunidades de optimización. Al aplicar right-sizing a los workloads de GPU según la demanda, mejorar el bin packing y elegir las instancias de GPU más rentables, se reduce el gasto en la nube sin sacrificar el rendimiento ni la estabilidad de los servicios de IA.