
PerfectScale
Garbage Collection de Java en Kubernetes: cómo elegir y dimensionar el recolector correcto
La JVM elige tu recolector de basura según los límites del pod, y un pequeño cambio de CPU puede cambiarlo sin aviso. Te mostramos cómo elegirlo, dimensionarlo y verificarlo.
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.


TL;DR
- Por defecto: G1 es el recolector ideal para empezar en la mayoría de los servicios Java en Kubernetes.
- El umbral: La JVM selecciona G1 solo con 2 o más CPUs y al menos 1792 MB de memoria. Por debajo de eso, selecciona Serial sin avisar.
- Defínelo explícitamente: Fija el recolector con un flag para que un cambio en el límite de CPU o memoria no pueda cambiarlo.
- Elige según el tamaño del pod: G1 para servicios típicos, Parallel para procesos batch, y ZGC o Shenandoah para servicios sensibles a la latencia que tengan margen de CPU y memoria.
- Memoria: El heap es solo una parte del proceso. Deja margen más allá de
-Xmx, o el pod terminará OOMKilled con el heap sin llenar.
Para la mayoría de los servicios Java en Kubernetes, G1 es el recolector de basura correcto, y la JVM lo elige por ti solo cuando el pod tiene al menos 2 CPUs y alrededor de 1.75 GB de memoria. Por debajo de eso, la JVM recurre en silencio al recolector Serial. Por eso, un pequeño cambio en el límite de CPU puede cambiar la forma en que tu servicio recolecta basura, y nadie recibe una alerta cuando ocurre.
Este artículo explica qué hace la recolección de basura de Java, cómo la JVM elige un recolector a partir de los límites de tu contenedor, en qué se diferencian G1, ZGC, Shenandoah, Parallel y Serial, y cuál conviene usar según el tamaño de cada pod. También muestra cómo ver qué está haciendo tu JVM hoy, y cómo la configuración del GC se conecta con los pods OOMKilled y el throttling de CPU.
Si tus pods de Java se reinician o sufren throttling al arrancar, lee primero JVM startup CPU throttling. Este artículo cubre la parte de estado estable del mismo problema.
¿Quieres verlo en vivo? Únete al taller práctico Java on K8s: The Startup vs. Steady-State Sizing Dilemma el 28 de octubre de 2026 a las 11 AM ET.
¿Qué es la recolección de basura en Java?
La recolección de basura de Java es el proceso automático de la JVM para encontrar objetos que la aplicación ya no usa y liberar su memoria. El desarrollador no llama a free(). El recolector hace el trabajo mientras la aplicación se ejecuta.
La mayoría de los recolectores se apoyan en la hipótesis generacional: la mayoría de los objetos mueren jóvenes. El heap se divide en una generación joven, donde empiezan los objetos nuevos, y una generación vieja, donde terminan los objetos de larga vida. Una recolección joven es frecuente y barata. Una recolección vieja o completa es rara y costosa.
El costo se manifiesta de dos maneras:
- Tiempo de pausa. Algunas fases detienen todos los hilos de la aplicación (una pausa stop-the-world). Las solicitudes que llegan durante una pausa esperan, lo que eleva la latencia de cola.
- Sobrecarga de CPU. Los hilos del recolector compiten con los hilos de la aplicación por la misma CPU.
En un contenedor, ambos costos están acotados por los límites que defines en la especificación del pod. El límite de CPU acota cuánta CPU comparten el recolector y la aplicación. El límite de memoria acota cuánto pueden crecer el heap y todo lo demás en el proceso. Un recolector que se comporta bien en una VM de 16 núcleos puede comportarse de forma muy distinta en un pod limitado a 1 CPU.
¿Cómo elige la JVM un recolector de basura en Kubernetes?
Si no defines un recolector, la JVM elige uno al arrancar a partir de dos números: la cantidad de CPUs que ve y la memoria que ve. La guía de ajuste de GC de HotSpot de Oracle llama a una máquina de clase servidor cuando tiene al menos 2 procesadores y al menos 1792 MB de memoria. En una máquina de clase servidor, la JVM selecciona G1. En caso contrario, selecciona Serial.
En un contenedor, la JVM lee esos números del cgroup, no del nodo:
- La cantidad de CPUs proviene del límite de CPU. La JVM divide la cuota entre el período y redondea hacia arriba, así que un límite de 1001m cuenta como 2 CPUs. Desde JDK 19, no usa el request de CPU (
cpu.shares) para este conteo. - La memoria proviene del límite de memoria. El heap máximo por defecto es 1/4 de esa memoria, y el heap inicial es 1/64.
Eso da una tabla de resultados simple:
| Límite de CPU | Límite de memoria | CPUs que ve la JVM | Recolector que selecciona la JVM |
|---|---|---|---|
| 1 (o 500m) | 2Gi | 1 | Serial |
| 1100m | 2Gi | 2 | G1 |
| 2 | 1Gi | 2 | Serial (memoria por debajo de 1792 MB) |
| 2 | 2Gi | 2 | G1 |
| Sin límite | Cualquiera | Todas las CPUs del nodo | G1 en un nodo típico, con muchos hilos de GC |
Por eso un límite de CPU de 1 y uno de 1100m pueden comportarse de forma distinta aunque la diferencia parezca mínima. La JVM también dimensiona sus hilos de trabajo de GC a partir de la cantidad de CPUs, así que la misma especificación de pod puede mostrar un comportamiento de GC distinto con límites distintos. El efecto es fácil de pasar por alto: no se genera ningún evento, y los logs del pod no muestran nada a menos que el logging de GC esté activado.
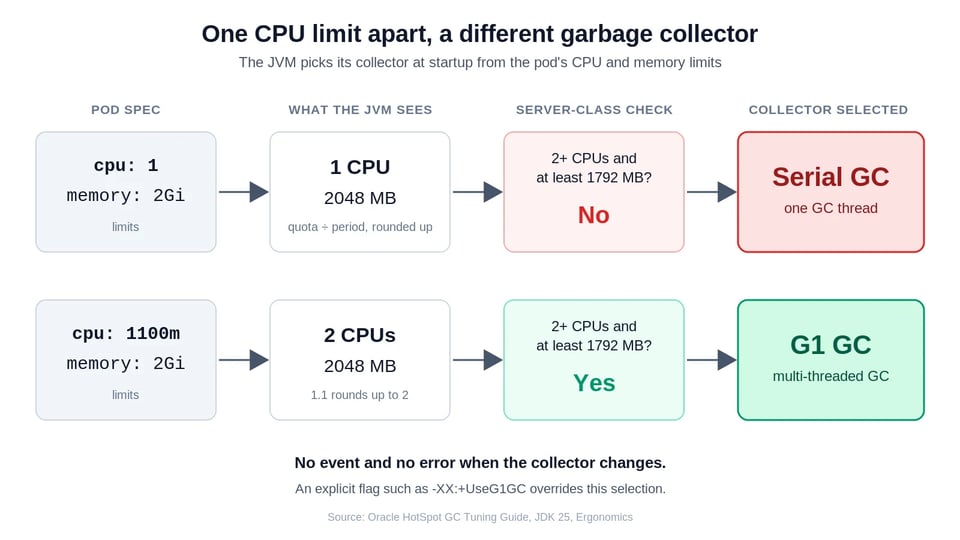
Un flag explícito siempre gana. Si defines -XX:+UseG1GC o -XX:+UseSerialGC, la JVM lo usa sin importar el tamaño del contenedor. Una propuesta en borrador de OpenJDK (JEP draft 8359802) haría de G1 el valor por defecto incluso en despliegues pequeños. Sigue siendo un borrador, así que no cuentes con él. Define el recolector explícitamente si quieres el mismo comportamiento en todas las versiones de JDK y tamaños de pod.
El límite de CPU también afecta cómo se ejecuta el recolector. Los hilos de GC concurrentes comparten la cuota de CPU del contenedor con los hilos de tu aplicación. Cuando la cuota se agota, el kernel los pausa a todos, incluido el recolector. Consulta Kubernetes CPU limits para entender cómo funciona esa cuota, y Kubernetes CPU throttling para saber cómo detectarla.
G1 vs ZGC vs Shenandoah vs Parallel vs Serial: ¿cómo se comparan los recolectores de basura de Java?
HotSpot incluye cinco recolectores que puedes elegir con un solo flag. Cada uno equilibra throughput, tiempo de pausa y huella de memoria de forma distinta.
| Recolector | Flag | Cómo funciona | Mejor caso de uso | A tener en cuenta |
|---|---|---|---|---|
| Serial | -XX:+UseSerialGC |
Un hilo de GC, stop-the-world | Pods con 1 CPU y un heap pequeño | Pausas largas a medida que crece el heap |
| Parallel | -XX:+UseParallelGC |
Varios hilos de GC, stop-the-world | Trabajos batch y workloads orientados al throughput | Las pausas crecen con el tamaño del heap |
| G1 | -XX:+UseG1GC |
Basado en regiones, mayormente concurrente, apunta a un objetivo de pausa | La mayoría de los servicios: la opción equilibrada por defecto | Necesita CPU libre para sus hilos concurrentes |
| ZGC | -XX:+UseZGC |
Concurrente, generacional desde JDK 23, pausas muy bajas | Servicios sensibles a la latencia con heaps más grandes | Mayor costo de CPU y memoria que G1 |
| Shenandoah | -XX:+UseShenandoahGC |
Compactación concurrente, pausas bajas | Servicios sensibles a la latencia en builds de OpenJDK que lo incluyan | No está en todas las builds de proveedores; el modo generacional es una funcionalidad oficial recién desde JDK 25 |
Hay tres notas de versión que importan si estás eligiendo hoy:
- ZGC es generacional por defecto desde JDK 23 (JEP 474). JDK 24 eliminó el modo no generacional (JEP 490), así que
-XX:+UseZGCahora siempre significa ZGC generacional. - Shenandoah generacional pasó a ser una funcionalidad oficial en JDK 25 (JEP 521). Shenandoah todavía usa una sola generación por defecto.
- G1 es el valor por defecto en máquinas de clase servidor, y lo ha sido desde JDK 9.
Los recolectores de pausas bajas hacen más trabajo de forma concurrente, así que usan más CPU y memoria para lograrlo. En un pod con un límite de CPU ajustado, ese trabajo extra compite con tu aplicación. Esta es la razón principal por la que ZGC y Shenandoah suelen ser una mala opción para pods pequeños, y por la que debes medir antes de cambiar.
¿Qué recolector de basura deberías usar para tu pod?
Comienza por el tamaño del pod y el workload, y luego confírmalo con los logs de GC y los números de latencia de tu propio servicio. Estos son puntos de partida, no benchmarks.
| Pod y workload | Empieza con | Por qué |
|---|---|---|
| Menos de 2 CPUs o menos de unos 1.75 GiB, heap pequeño | Serial, o G1 como decisión deliberada | Este es el rango donde la JVM selecciona Serial por su cuenta. Define el flag explícitamente para que la decisión sea tuya. |
| 2 o más CPUs, servicio web o API típico | G1 | Equilibra throughput y tiempo de pausa, y es el valor por defecto de la JVM para este tamaño. |
| Batch, ETL o procesamiento offline donde las pausas no importan | Parallel | Maximiza el throughput cuando ningún usuario espera una respuesta. |
| Servicio sensible a la latencia de cola con un heap más grande y margen de CPU | ZGC, y luego Shenandoah si tu JDK lo incluye | La recolección concurrente mantiene las pausas bajas, a costa de CPU y memoria. |
| Límite de CPU por debajo de lo que necesita el recolector | Sube el límite, o elige un recolector más ligero | Un recolector concurrente con throttling puede pausar más tiempo que G1. |
Dos reglas mantienen esto en terreno práctico. Primero, cambia una sola cosa a la vez: cambiar el recolector y el tamaño del heap al mismo tiempo oculta cuál de los dos cambios ayudó. Segundo, decide con datos. Compara la latencia p99, el tiempo de GC, el throttling de CPU y el working set de memoria antes y después, bajo carga realista.
Un cambio de recolector es también un cambio de dimensionamiento. Un recolector de pausas bajas puede necesitar más CPU y más memoria que G1 para el mismo servicio, así que un pod dimensionado para G1 puede necesitar nuevos requests y limits tras el cambio. Para entender cómo interactúan los requests y limits, consulta Kubernetes resource limits vs requests.
¿Cómo se relaciona la recolección de basura con OOMKilled y los límites de memoria del contenedor?
El GC trabaja dentro del heap. El límite de memoria del contenedor abarca todo el proceso. Las dos fallas se parecen, pero tienen causas distintas:
| Falla | Quién la genera | Qué significa | Primera solución |
|---|---|---|---|
java.lang.OutOfMemoryError: Java heap space |
La JVM | El heap alcanzó -Xmx y el GC no pudo liberar lo suficiente |
Encuentra la fuga o aumenta el heap |
| OOMKilled (código de salida 137) | El kernel, a través del cgroup | La memoria total del proceso superó el límite del contenedor | Deja más espacio fuera del heap, o sube el límite |
El heap es solo una parte de lo que usa una JVM. El proceso también incluye el metaspace, las pilas de hilos, la caché de código JIT, los buffers directos y las estructuras nativas del propio recolector. Los recolectores difieren en esta última parte, así que cambiar de recolector puede mover la memoria total incluso cuando -Xmx se mantiene igual.
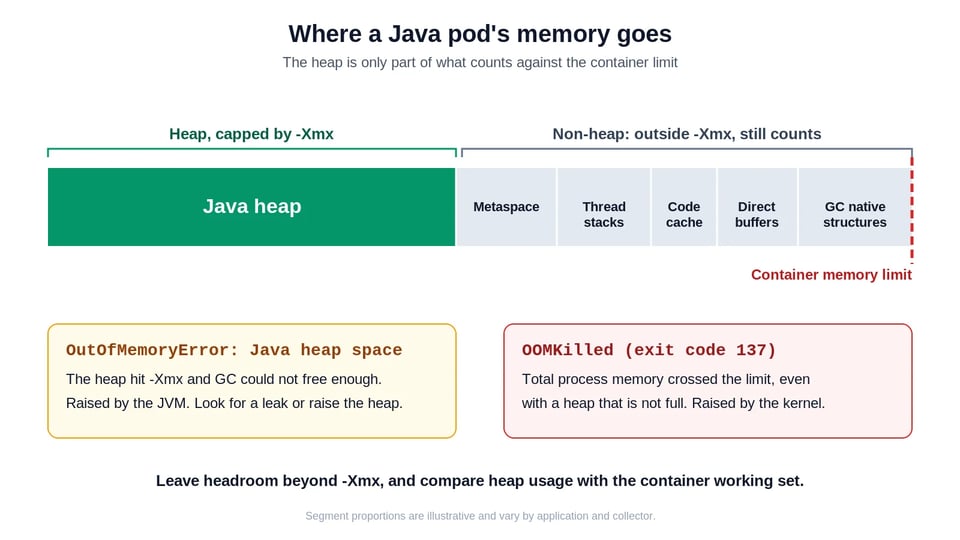
El heap máximo por defecto es 1/4 de la memoria del contenedor, lo que a menudo desperdicia memoria. Muchos equipos lo aumentan con -XX:MaxRAMPercentage, empezando comúnmente entre 50 y 70 por ciento y ajustando a partir del uso medido fuera del heap. Trata ese rango como un punto de partida: un servicio con muchos hilos o un uso intensivo de buffers directos necesita más margen.
Para un enfoque de heap fijo (-Xms igual a -Xmx) y más ajustes de la JVM pensados para contenedores, consulta 5 Strategies to Optimize Java in 2026.
Dos flags hacen que las fallas sean más fáciles de diagnosticar:
-XX:+ExitOnOutOfMemoryError-XX:+HeapDumpOnOutOfMemoryErrorEl primero hace que la JVM termine ante un OOM del heap, para que Kubernetes reinicie el pod de forma limpia en lugar de dejar un proceso a medio funcionar. El segundo escribe un volcado del heap que puedes inspeccionar. Mantén la ruta del volcado en un volumen que sobreviva al reinicio. Para el lado de Kubernetes de esta falla, consulta OOMKilled.
¿Cómo ver qué está haciendo el recolector de basura de tu JVM?
Revisa tres cosas: qué recolector se está ejecutando, cuánto te cuesta el GC, y si el contenedor está sufriendo throttling.
Qué recolector y cuántas CPUs eligió la JVM
kubectl exec <pod-name> -- jcmd 1 VM.flags -all \ | grep -E 'UseSerialGC|UseG1GC|UseZGC|UseParallelGC|ParallelGCThreads|ConcGCThreads'Esto requiere jcmd en la imagen y que la JVM se ejecute como proceso 1. Una imagen que solo incluye el JRE no trae jcmd.
Logs de GC
Activa el logging unificado de GC con una variable de entorno, y lee las líneas de pausa:
env: - name: JAVA_TOOL_OPTIONS value: "-Xlog:gc*:stdout:time,uptime"Fíjate en la frecuencia de las recolecciones jóvenes, la duración de las pausas, y si aparecen recolecciones completas. Si las recolecciones completas son frecuentes, el heap es demasiado pequeño para los datos vivos.
Métricas sobre las que vale la pena alertar
Si usas Micrometer o el exportador JMX de Prometheus, estas muestran el costo del GC a lo largo del tiempo:
| Señal | Métrica de ejemplo | Cómo se ve un valor problemático |
|---|---|---|
| Tiempo de pausa del GC | jvm_gc_pause_seconds_sum |
Una proporción creciente del tiempo total se va en GC |
| Heap en uso | jvm_memory_used_bytes{area="heap"} |
Se mantiene cerca del máximo después de las recolecciones |
| Memoria del contenedor | container_memory_working_set_bytes |
Se acerca al límite de memoria |
| Throttling de CPU | container_cpu_cfs_throttled_periods_total sobre container_cpu_cfs_periods_total |
Una proporción alta de períodos con throttling mientras corre el GC |
Lee juntas las líneas del heap y de la memoria del contenedor. Un heap muy por debajo del límite con el working set cerca del límite apunta a memoria fuera del heap, no al recolector. Una proporción alta de throttling durante el GC apunta a un límite de CPU demasiado ajustado para el recolector que elegiste.
La presión de GC y de CPU suele alcanzar su pico en los primeros segundos tras el arranque de un pod, y luego desaparece de los dashboards de cinco minutos. Para detectarla, consulta cómo detectar picos de arranque en Kubernetes.
¿Qué flags de la JVM hacen que la recolección de basura tenga en cuenta el contenedor?
La JVM lee los límites del contenedor por defecto (-XX:+UseContainerSupport). Estos flags hacen que el resultado sea explícito y repetible:
| Flag | Qué hace | Cuándo configurarlo |
|---|---|---|
-XX:+UseG1GC (u otro recolector) |
Fija el recolector | Siempre, para que los cambios de tamaño del pod no lo cambien |
-XX:MaxRAMPercentage=<n> |
Define el heap máximo como porcentaje de la memoria del contenedor | Cuando el 25% por defecto deja memoria sin usar |
-XX:ActiveProcessorCount=<n> |
Sobrescribe la cantidad de CPUs detectada | Cuando quieres la misma cantidad de hilos en todos los entornos |
-XX:ParallelGCThreads=<n> |
Define los hilos de trabajo de GC stop-the-world | Cuando el valor derivado de la CPU es demasiado alto para un pod con throttling |
-XX:ConcGCThreads=<n> |
Define los hilos de trabajo de GC concurrentes | Cuando el GC concurrente compite con la aplicación por la CPU |
-XX:MaxGCPauseMillis=<n> |
Define un objetivo de tiempo de pausa para G1 | Solo después de haber medido las pausas |
-Xlog:gc* |
Activa el logging de GC | Siempre en producción |
Un conjunto inicial para un pod de API típico con 2 CPUs y 2 GiB de memoria se ve así:
env: - name: JAVA_TOOL_OPTIONS value: >- -XX:+UseG1GC -XX:MaxRAMPercentage=65 -XX:+ExitOnOutOfMemoryError -Xlog:gc*:stdout:time,uptimeEl valor 65 es un punto de partida, no una recomendación para todos los servicios. Mide primero la huella fuera del heap, y luego ajusta. Evita copiar conjuntos grandes de flags de ajuste de posts antiguos. Los valores por defecto han cambiado entre versiones de JDK, y los flags extra suelen hacer que el comportamiento del GC sea más difícil de entender.
Cómo PerfectScale ayuda con el right-sizing de los workloads Java
La configuración del GC, el tamaño del heap y los requests y limits del pod se afectan entre sí. Cambiar uno sin tocar los demás es la razón por la que los equipos terminan con pods con throttling o reinicios por OOMKilled. PerfectScale muestra estas señales en conjunto.
Para los contenedores Java, PerfectScale recopila datos del heap, de la memoria fuera del heap y de la recolección de basura. Muestra el tiempo de GC, la cantidad de procesadores activos y el tipo de GC, para que puedas ver qué recolector ejecuta cada workload y cuánto cuesta. Puedes activar la recopilación de métricas de la JVM al instalar el agente de PerfectScale. Solo es compatible con nodos Linux.
PerfectScale también respeta la configuración de tu JVM. Cuando defines un tamaño de heap máximo o mínimo, PerfectScale no aplica recomendaciones que salgan de ese rango. Para redimensionar pods sin reinicios, consulta in-place right-sizing y el Vertical Pod Autoscaler.

Taller: Java on K8s: The Startup vs. Steady-State Sizing Dilemma. Vikram Seshadri de DoiT recorre el pico de arranque de la JVM, lo que cuesta en throttling, OOM kills y requests sobredimensionados, y cómo dimensionar pods para el estado estable con un redimensionamiento in-place y sin reinicio. 28 de octubre de 2026 a las 11 AM ET. Reserva tu lugar.
¿Quieres ver cómo PerfectScale aplica right-sizing a tus workloads Java? Comienza gratis o agenda una demo.
Preguntas frecuentes
¿Cuál es el recolector de basura por defecto en Java? G1 en una máquina de clase servidor, es decir, con 2 o más procesadores y al menos 1792 MB de memoria. En caso contrario, la JVM selecciona Serial. En un contenedor, la JVM lee el límite de CPU y el límite de memoria para decidir.
¿Qué recolector de basura es el mejor en Java? Ningún recolector gana en todos los casos. G1 es el mejor punto de partida para la mayoría de los servicios. Parallel se adapta al trabajo batch, y ZGC o Shenandoah se adaptan a servicios sensibles a la latencia que tienen margen de CPU y memoria.
¿Java hace recolección de basura automática? Sí. La JVM encuentra objetos sin uso y libera su memoria sin llamadas del desarrollador. Se ajusta con la elección del recolector, el tamaño del heap y los flags de GC.
¿Cómo funciona la recolección de basura en Java? El recolector encuentra objetos que la aplicación ya no puede alcanzar, libera su memoria y, a menudo, compacta lo que queda. La mayoría de los recolectores dividen el heap en generaciones joven y vieja porque la mayoría de los objetos mueren jóvenes.
¿Es ZGC mejor que G1? ZGC apunta a pausas más bajas, y lo paga con más CPU y memoria. Tiende a ayudar más en heaps grandes con CPU libre. En pods pequeños, G1 suele ser la opción más segura. Prueba con tu propio tráfico.
¿Por qué mi pod de Java termina OOMKilled si el heap no está lleno?
El límite del contenedor abarca el metaspace, las pilas de hilos, la caché de código, los buffers directos y las estructuras del recolector, además del heap. Deja margen más allá de -Xmx, y compara el uso del heap con el working set del contenedor.
¿Un límite de CPU afecta la recolección de basura de Java? Sí, de dos maneras. El límite define la cantidad de CPUs que la JVM usa para dimensionar los hilos de GC y, junto con la memoria, para elegir el recolector. También acota la CPU que comparten los hilos de GC y los de la aplicación, así que el throttling pausa a ambos.
Lecturas relacionadas
- 5 Strategies to Optimize Java in 2026: configuración de heap, CPU y GC pensada para contenedores
- JVM startup CPU throttling: por qué la JVM necesita más CPU en sus primeros segundos
- Detect Kubernetes startup spikes: encuentra el throttling y los OOM kills que los dashboards ocultan
- Fix Kubernetes resource policies that optimize for the wrong phase: cuotas y LimitRanges para el arranque vs el estado estable
- How to fix OOMKilled in Kubernetes
- Kubernetes CPU throttling
- Kubernetes CPU limits
- Kubernetes resource limits vs requests
- We can resize pods without restarts! Or can't we?
- Kubernetes Vertical Pod Autoscaler (VPA)
- Kubernetes Horizontal Pod Autoscaler (HPA)