
PerfectScale
Java Garbage Collection in Kubernetes: Den richtigen Collector wählen und dimensionieren
Die JVM wählt Ihren Garbage Collector anhand der Pod-Limits – schon eine kleine CPU-Änderung kann ihn umschalten. So wählen, dimensionieren und prüfen Sie ihn.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.


TL;DR
- Standard: G1 ist für die meisten Java-Services auf Kubernetes der richtige Einstiegs-Collector.
- Die Schwelle: Die JVM wählt G1 nur bei 2 oder mehr CPUs und mindestens 1792 MB Arbeitsspeicher. Darunter wählt sie stillschweigend Serial.
- Explizit setzen: Fixieren Sie den Collector per Flag, damit eine Änderung am CPU- oder Memory-Limit ihn nicht umschalten kann.
- Nach Pod-Größe wählen: G1 für typische Services, Parallel für Batch, ZGC oder Shenandoah für latenzkritische Services mit CPU- und Memory-Reserven.
- Memory: Der Heap ist nur ein Teil des Prozesses. Lassen Sie Spielraum jenseits von
-Xmx, sonst wird der Pod OOMKilled, obwohl der Heap gar nicht voll ist.
Für die meisten Java-Services auf Kubernetes ist G1 der richtige Garbage Collector – und die JVM wählt ihn nur dann automatisch, wenn der Pod mindestens 2 CPUs und rund 1,75 GB Arbeitsspeicher hat. Darunter fällt die JVM stillschweigend auf den Serial Collector zurück. Schon eine kleine Änderung an einem CPU-Limit kann also verändern, wie Ihr Service Garbage Collection betreibt – und niemand bekommt einen Alert, wenn es passiert.
Dieser Artikel erklärt, was Java Garbage Collection leistet, wie die JVM anhand Ihrer Container-Limits einen Collector auswählt, worin sich G1, ZGC, Shenandoah, Parallel und Serial unterscheiden und welcher Collector zu welcher Pod-Größe passt. Außerdem zeigt er, wie Sie herausfinden, was Ihre JVM heute tut, und wie GC-Einstellungen mit OOMKilled-Pods und CPU-Throttling zusammenhängen.
Wenn Ihre Java-Pods beim Start neu starten oder gedrosselt werden, lesen Sie zuerst JVM startup CPU throttling. Dieser Artikel behandelt die Steady-State-Seite desselben Problems.
Sie möchten das live sehen? Nehmen Sie am praxisnahen Workshop Java on K8s: The Startup vs. Steady-State Sizing Dilemma am 28. Oktober 2026 um 11 Uhr ET teil.
Was ist Java Garbage Collection?
Java Garbage Collection ist der automatische Prozess der JVM, der Objekte aufspürt, die die Anwendung nicht mehr verwendet, und deren Speicher freigibt. Der Entwickler ruft kein free() auf. Der Collector erledigt die Arbeit, während die Anwendung läuft.
Die meisten Collectors stützen sich auf die Generationen-Hypothese: Die meisten Objekte sterben jung. Der Heap ist in eine Young Generation, in der neue Objekte starten, und eine Old Generation aufgeteilt, in der langlebige Objekte landen. Eine Young Collection ist häufig und günstig. Eine Old oder Full Collection ist selten und teuer.
Die Kosten zeigen sich auf zwei Arten:
- Pausenzeit. Manche Phasen stoppen alle Anwendungs-Threads (eine Stop-the-World-Pause). Requests, die während einer Pause eintreffen, müssen warten – das erhöht die Tail-Latenz.
- CPU-Overhead. Collector-Threads konkurrieren mit Anwendungs-Threads um dieselbe CPU.
In einem Container werden beide Kosten durch die Limits begrenzt, die Sie in der Pod-Spezifikation setzen. Das CPU-Limit deckelt, wie viel CPU sich Collector und Anwendung teilen. Das Memory-Limit deckelt, wie groß der Heap – und alles andere im Prozess – werden kann. Ein Collector, der sich auf einer VM mit 16 Kernen gut verhält, kann sich in einem Pod mit einem Limit von 1 CPU völlig anders verhalten.
Wie wählt die JVM in Kubernetes einen Garbage Collector aus?
Wenn Sie keinen Collector setzen, wählt die JVM beim Start einen anhand von zwei Zahlen: der CPU-Anzahl, die sie sieht, und dem Arbeitsspeicher, den sie sieht. Oracles HotSpot GC tuning guide bezeichnet eine Maschine als server-class, wenn sie mindestens 2 Prozessoren und mindestens 1792 MB Arbeitsspeicher hat. Auf einer server-class Maschine wählt die JVM G1. Andernfalls wählt sie Serial.
In einem Container liest die JVM diese Zahlen aus der cgroup, nicht vom Node:
- Die CPU-Anzahl stammt aus dem CPU-Limit. Die JVM teilt die Quota durch die Periode und rundet auf, sodass ein Limit von 1001m als 2 CPUs zählt. Seit JDK 19 verwendet sie den CPU-Request (
cpu.shares) nicht mehr für diese Zählung. - Der Arbeitsspeicher stammt aus dem Memory-Limit. Der Standard-Maximal-Heap beträgt 1/4 dieses Speichers, der initiale Heap 1/64.
Daraus ergibt sich eine einfache Ergebnistabelle:
| CPU-Limit | Memory-Limit | CPUs, die die JVM sieht | Collector, den die JVM wählt |
|---|---|---|---|
| 1 (oder 500m) | 2Gi | 1 | Serial |
| 1100m | 2Gi | 2 | G1 |
| 2 | 1Gi | 2 | Serial (Arbeitsspeicher unter 1792 MB) |
| 2 | 2Gi | 2 | G1 |
| Kein Limit | Beliebig | Alle CPUs des Nodes | G1 auf einem typischen Node, mit vielen GC-Threads |
Deshalb können sich ein CPU-Limit von 1 und ein Limit von 1100m unterschiedlich verhalten, obwohl der Unterschied winzig wirkt. Die JVM dimensioniert auch ihre GC-Worker-Threads anhand der CPU-Anzahl, sodass dieselbe Pod-Spezifikation bei unterschiedlichen Limits unterschiedliches GC-Verhalten zeigen kann. Der Effekt ist leicht zu übersehen: Es wird kein Event ausgelöst, und in den Pod-Logs steht nichts, solange GC-Logging nicht aktiviert ist.
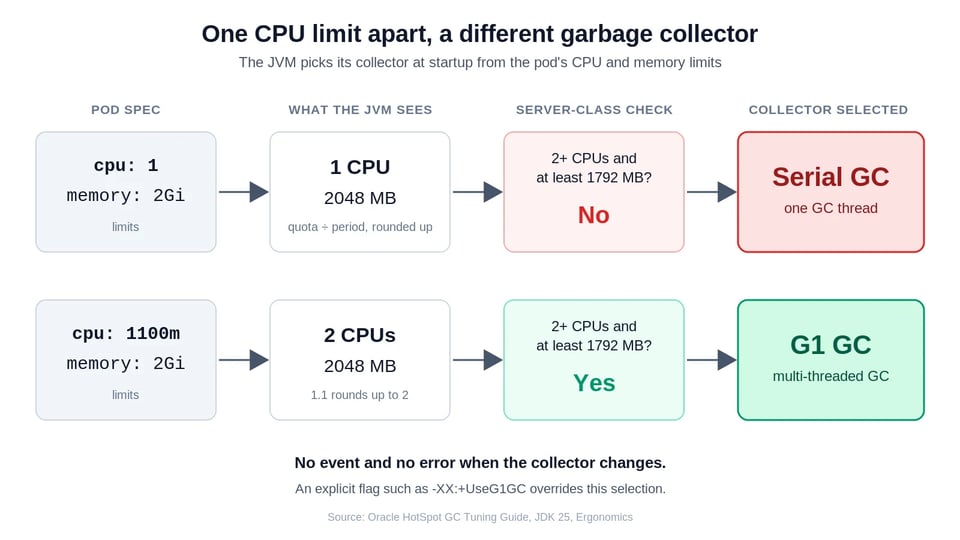
Ein explizites Flag gewinnt immer. Wenn Sie -XX:+UseG1GC oder -XX:+UseSerialGC setzen, verwendet die JVM es unabhängig von der Container-Größe. Ein OpenJDK-Entwurf (JEP draft 8359802) würde G1 auch auf kleinen Deployments zum Standard machen. Er ist aber noch ein Entwurf – verlassen Sie sich nicht darauf. Setzen Sie den Collector explizit, wenn Sie über JDK-Versionen und Pod-Größen hinweg dasselbe Verhalten wollen.
Das CPU-Limit beeinflusst auch, wie der Collector läuft. Nebenläufige GC-Threads teilen sich die CPU-Quota des Containers mit Ihren Anwendungs-Threads. Ist die Quota aufgebraucht, pausiert der Kernel alle – auch den Collector. Wie diese Quota funktioniert, zeigt Kubernetes CPU limits; wie Sie Throttling erkennen, steht in Kubernetes CPU throttling.
G1 vs. ZGC vs. Shenandoah vs. Parallel vs. Serial: Wie schneiden die Java Garbage Collectors im Vergleich ab?
HotSpot liefert fünf Collectors mit, die Sie mit einem einzigen Flag auswählen können. Sie wägen Durchsatz, Pausenzeit und Footprint gegeneinander ab.
| Collector | Flag | Funktionsweise | Beste Eignung | Vorsicht bei |
|---|---|---|---|---|
| Serial | -XX:+UseSerialGC |
Ein GC-Thread, Stop-the-World | Pods mit 1 CPU und kleinem Heap | Lange Pausen, wenn der Heap wächst |
| Parallel | -XX:+UseParallelGC |
Mehrere GC-Threads, Stop-the-World | Batch-Jobs und durchsatzorientierte Workloads | Pausen wachsen mit der Heap-Größe |
| G1 | -XX:+UseG1GC |
Regionsbasiert, überwiegend nebenläufig, verfolgt ein Pausenziel | Die meisten Services: der ausgewogene Standard | Benötigt freie CPU für seine nebenläufigen Threads |
| ZGC | -XX:+UseZGC |
Nebenläufig, seit JDK 23 generational, sehr niedrige Pausen | Latenzkritische Services mit größeren Heaps | Höhere CPU- und Memory-Kosten als G1 |
| Shenandoah | -XX:+UseShenandoahGC |
Nebenläufige Kompaktierung, niedrige Pausen | Latenzkritische Services auf OpenJDK-Builds, die ihn enthalten | Nicht in jedem Vendor-Build; der Generational-Modus ist erst ab JDK 25 ein Produkt-Feature |
Drei Versionshinweise sind wichtig, wenn Sie heute wählen:
- ZGC ist seit JDK 23 standardmäßig generational (JEP 474). JDK 24 hat den nicht-generationalen Modus entfernt (JEP 490),
-XX:+UseZGCbedeutet also jetzt immer generationales ZGC. - Generational Shenandoah wurde mit JDK 25 zum Produkt-Feature (JEP 521). Standardmäßig verwendet Shenandoah weiterhin eine einzige Generation.
- G1 ist der Standard auf server-class Maschinen – und zwar seit JDK 9.
Die Low-Pause-Collectors erledigen mehr Arbeit nebenläufig und brauchen dafür mehr CPU und Memory. In einem Pod mit engem CPU-Limit konkurriert diese zusätzliche Arbeit mit Ihrer Anwendung. Das ist der Hauptgrund, warum ZGC und Shenandoah für kleine Pods meist schlecht geeignet sind – und warum Sie messen sollten, bevor Sie wechseln.
Welchen Garbage Collector sollten Sie für Ihren Pod verwenden?
Gehen Sie von der Pod-Größe und dem Workload aus und bestätigen Sie die Wahl mit GC-Logs und Latenzwerten aus Ihrem eigenen Service. Das sind Startpunkte, keine Benchmarks.
| Pod und Workload | Starten Sie mit | Warum |
|---|---|---|
| Unter 2 CPUs oder unter rund 1,75 GiB, kleiner Heap | Serial, oder G1 als bewusste Entscheidung | In diesem Bereich wählt die JVM von sich aus Serial. Setzen Sie das Flag explizit, damit die Entscheidung bei Ihnen liegt. |
| 2 oder mehr CPUs, typischer Web- oder API-Service | G1 | Ausgewogenes Verhältnis von Durchsatz und Pausenzeit – und der JVM-Standard für diese Größe. |
| Batch, ETL oder Offline-Verarbeitung, bei der Pausen keine Rolle spielen | Parallel | Maximiert den Durchsatz, wenn kein Nutzer auf eine Antwort wartet. |
| Tail-latenzkritischer Service mit größerem Heap und CPU-Reserven | ZGC, dann Shenandoah, falls Ihr JDK ihn enthält | Nebenläufige Collection hält die Pausen niedrig – zum Preis von CPU und Memory. |
| CPU-Limit unterhalb des Bedarfs des Collectors | Limit erhöhen oder einen leichteren Collector wählen | Ein gedrosselter nebenläufiger Collector kann länger pausieren, als G1 es würde. |
Zwei Regeln halten das praktikabel. Erstens: Ändern Sie immer nur eine Sache. Wer Collector und Heap-Größe gleichzeitig umstellt, sieht nicht mehr, welche Änderung geholfen hat. Zweitens: Entscheiden Sie anhand von Daten. Vergleichen Sie p99-Latenz, GC-Zeit, CPU-Throttling und Memory Working Set vorher und nachher – unter realistischer Last.
Ein Collector-Wechsel ist auch eine Sizing-Änderung. Ein Low-Pause-Collector kann für denselben Service mehr CPU und Memory brauchen als G1, sodass ein für G1 dimensionierter Pod nach dem Wechsel neue Requests und Limits benötigen kann. Wie Requests und Limits zusammenspielen, zeigt Kubernetes resource limits vs requests.
Wie hängt Garbage Collection mit OOMKilled und Container-Memory-Limits zusammen?
GC arbeitet innerhalb des Heaps. Das Container-Memory-Limit gilt für den gesamten Prozess. Die beiden Fehlerbilder sehen ähnlich aus, haben aber unterschiedliche Ursachen:
| Fehler | Wer ihn auslöst | Was er bedeutet | Erste Maßnahme |
|---|---|---|---|
java.lang.OutOfMemoryError: Java heap space |
Die JVM | Der Heap hat -Xmx erreicht, und die GC konnte nicht genug Speicher freigeben |
Leck finden oder Heap vergrößern |
| OOMKilled (Exit-Code 137) | Der Kernel, über die cgroup | Der gesamte Prozessspeicher hat das Container-Limit überschritten | Mehr Spielraum außerhalb des Heaps lassen oder das Limit erhöhen |
Der Heap ist nur ein Teil dessen, was eine JVM nutzt. Der Prozess hält außerdem Metaspace, Thread-Stacks, den JIT-Code-Cache, Direct Buffers und die nativen Strukturen des Collectors. Bei Letzterem unterscheiden sich die Collectors – ein Collector-Wechsel kann den Gesamtspeicher also verändern, selbst wenn -Xmx gleich bleibt.
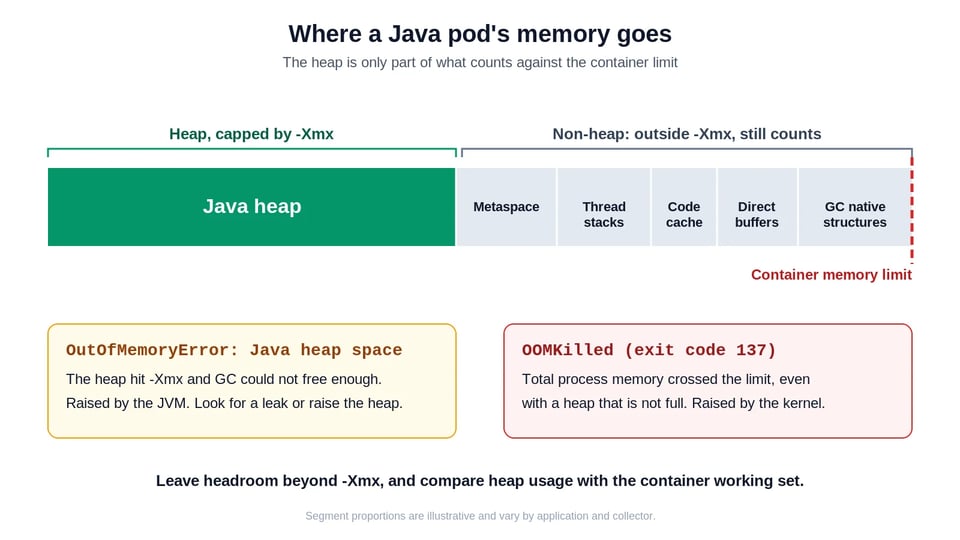
Der Standard-Maximal-Heap beträgt 1/4 des Container-Speichers, was häufig Speicher verschwendet. Viele Teams erhöhen ihn mit -XX:MaxRAMPercentage, üblicherweise mit einem Startwert zwischen 50 und 70 Prozent, und justieren anhand der gemessenen Non-Heap-Nutzung nach. Behandeln Sie diesen Bereich als Startpunkt: Ein Service mit vielen Threads oder intensiver Direct-Buffer-Nutzung braucht mehr Spielraum.
Für einen Fixed-Heap-Ansatz (-Xms gleich -Xmx) und weitere container-aware JVM-Einstellungen siehe 5 Strategies to Optimize Java in 2026.
Zwei Flags erleichtern die Diagnose von Fehlern:
-XX:+ExitOnOutOfMemoryError-XX:+HeapDumpOnOutOfMemoryErrorMit dem ersten beendet sich die JVM bei einem Heap-OOM, sodass Kubernetes den Pod sauber neu startet, statt einen halb funktionierenden Prozess zurückzulassen. Das zweite schreibt einen Heap Dump, den Sie untersuchen können. Legen Sie den Dump-Pfad auf ein Volume, das den Neustart überlebt. Zur Kubernetes-Seite dieses Fehlers siehe OOMKilled.
Wie sehen Sie, was der Garbage Collector Ihrer JVM gerade tut?
Prüfen Sie drei Dinge: welcher Collector läuft, was die GC Sie kostet und ob der Container gedrosselt wird.
Welchen Collector und welche CPU-Anzahl die JVM gewählt hat
kubectl exec <pod-name> -- jcmd 1 VM.flags -all \ | grep -E 'UseSerialGC|UseG1GC|UseZGC|UseParallelGC|ParallelGCThreads|ConcGCThreads'Das setzt jcmd im Image und die JVM als Prozess 1 voraus. Ein reines JRE-Image enthält jcmd nicht.
GC-Logs
Aktivieren Sie Unified GC Logging über eine Umgebungsvariable und lesen Sie die Pausenzeilen:
env: - name: JAVA_TOOL_OPTIONS value: "-Xlog:gc*:stdout:time,uptime"Achten Sie darauf, wie häufig Young Collections laufen, wie lang die Pausen sind und ob Full Collections auftauchen. Häufige Full Collections bedeuten, dass der Heap für die Live-Daten zu klein ist.
Metriken, für die sich Alerts lohnen
Wenn Sie Micrometer oder den Prometheus JMX Exporter nutzen, zeigen diese Metriken die GC-Kosten im Zeitverlauf:
| Signal | Beispiel-Metrik | Wie ein schlechter Wert aussieht |
|---|---|---|
| GC-Pausenzeit | jvm_gc_pause_seconds_sum |
Steigender Anteil der Wall-Clock-Zeit in der GC |
| Genutzter Heap | jvm_memory_used_bytes{area="heap"} |
Bleibt nach Collections nahe am Maximum |
| Container-Memory | container_memory_working_set_bytes |
Nähert sich dem Memory-Limit |
| CPU-Throttling | container_cpu_cfs_throttled_periods_total geteilt durch container_cpu_cfs_periods_total |
Hoher Anteil gedrosselter Perioden, während die GC läuft |
Lesen Sie Heap- und Container-Memory-Werte zusammen. Ein Heap deutlich unter dem Limit bei einem Working Set nahe am Limit deutet auf Non-Heap-Speicher hin, nicht auf den Collector. Ein hoher Throttling-Anteil während der GC deutet auf ein CPU-Limit hin, das für den gewählten Collector zu eng ist.
GC- und CPU-Druck erreichen ihren Höhepunkt oft in den ersten Sekunden nach dem Pod-Start und verschwinden dann aus Fünf-Minuten-Dashboards. Wie Sie sie trotzdem erwischen, zeigt Detect Kubernetes startup spikes.
Welche JVM-Flags machen Garbage Collection container-aware?
Die JVM liest Container-Limits standardmäßig aus (-XX:+UseContainerSupport). Diese Flags machen das Ergebnis explizit und reproduzierbar:
| Flag | Wirkung | Wann setzen |
|---|---|---|
-XX:+UseG1GC (oder ein anderer Collector) |
Fixiert den Collector | Immer, damit Änderungen der Pod-Größe ihn nicht umschalten |
-XX:MaxRAMPercentage=<n> |
Setzt den maximalen Heap als Anteil des Container-Speichers | Wenn der 25-%-Standard Speicher ungenutzt lässt |
-XX:ActiveProcessorCount=<n> |
Überschreibt die erkannte CPU-Anzahl | Wenn Sie in jeder Umgebung dieselben Thread-Zahlen wollen |
-XX:ParallelGCThreads=<n> |
Setzt die Stop-the-World-GC-Worker-Threads | Wenn der aus der CPU abgeleitete Standard für einen gedrosselten Pod zu hoch ist |
-XX:ConcGCThreads=<n> |
Setzt die nebenläufigen GC-Worker-Threads | Wenn die nebenläufige GC mit der Anwendung um CPU konkurriert |
-XX:MaxGCPauseMillis=<n> |
Setzt ein Pausenzeit-Ziel für G1 | Erst, nachdem Sie Pausen gemessen haben |
-Xlog:gc* |
Aktiviert GC-Logging | In Produktion immer |
Ein Start-Set für einen typischen API-Pod mit 2 CPUs und 2 GiB Speicher sieht so aus:
env: - name: JAVA_TOOL_OPTIONS value: >- -XX:+UseG1GC -XX:MaxRAMPercentage=65 -XX:+ExitOnOutOfMemoryError -Xlog:gc*:stdout:time,uptimeDer Wert 65 ist ein Startpunkt, keine Empfehlung für jeden Service. Messen Sie zuerst den Non-Heap-Footprint und justieren Sie dann nach. Kopieren Sie keine großen Sammlungen von Tuning-Flags aus alten Blogposts. Die Standardwerte haben sich über die JDK-Versionen hinweg geändert, und zusätzliche Flags machen das GC-Verhalten oft schwerer nachvollziehbar.
Wie PerfectScale beim Right-Sizing von Java-Workloads hilft
GC-Einstellungen, Heap-Größe sowie Pod-Requests und -Limits beeinflussen sich gegenseitig. Wer eines ohne die anderen ändert, landet bei gedrosselten Pods oder OOMKilled-Neustarts. PerfectScale zeigt diese Signale gemeinsam an.
Für Java-Container sammelt PerfectScale Heap-, Non-Heap- und Garbage-Collection-Daten. Es zeigt die GC-Zeit, die aktive Prozessoranzahl und den GC-Typ, sodass Sie sehen, mit welchem Collector jeder Workload läuft und was er kostet. Die Erfassung von JVM-Metriken können Sie bei der Installation des PerfectScale-Agents aktivieren. Unterstützt werden ausschließlich Linux-Nodes.
PerfectScale respektiert außerdem Ihre JVM-Einstellungen. Wenn Sie eine maximale oder minimale Heap-Größe setzen, wendet PerfectScale keine Empfehlung an, die diese Grenzen verletzt. Wie Sie Pods ohne Neustarts anpassen, zeigen In-Place-Right-Sizing und der Vertical Pod Autoscaler.

Workshop: Java on K8s: The Startup vs. Steady-State Sizing Dilemma. Vikram Seshadri von DoiT zeigt den JVM-Boot-Spike, was er an Throttling, OOM-Kills und überdimensionierten Requests kostet und wie Sie Pods mit einem In-Place-Resize ohne Neustart für den Steady State dimensionieren. 28. Oktober 2026 um 11 Uhr ET. Sichern Sie sich Ihren Platz.
Möchten Sie sehen, wie PerfectScale das Right-Sizing Ihrer Java-Workloads übernimmt? Kostenlos starten oder Demo buchen.
FAQ
Was ist der Standard-Garbage-Collector in Java? G1 auf einer server-class Maschine, also bei 2 oder mehr Prozessoren und mindestens 1792 MB Arbeitsspeicher. Andernfalls wählt die JVM Serial. In einem Container liest die JVM für diese Entscheidung CPU-Limit und Memory-Limit aus.
Welcher Garbage Collector ist in Java der beste? Kein Collector gewinnt überall. G1 ist für die meisten Services der beste Startpunkt. Parallel eignet sich für Batch-Verarbeitung, ZGC oder Shenandoah für latenzkritische Services mit CPU- und Memory-Reserven.
Hat Java eine automatische Garbage Collection? Ja. Die JVM findet ungenutzte Objekte und gibt deren Speicher ohne Entwickleraufrufe frei. Sie steuern das Verhalten über die Collector-Wahl, die Heap-Größe und GC-Flags.
Wie funktioniert Garbage Collection in Java? Der Collector findet Objekte, die die Anwendung nicht mehr erreichen kann, gibt deren Speicher frei und kompaktiert häufig den verbleibenden Speicher. Die meisten Collectors teilen den Heap in Young und Old Generations, weil die meisten Objekte jung sterben.
Ist ZGC besser als G1? ZGC zielt auf niedrigere Pausen und bezahlt dafür mit mehr CPU und Memory. Am meisten hilft er in der Regel bei größeren Heaps mit freier CPU. Auf kleinen Pods ist G1 meist die sicherere Wahl. Testen Sie mit Ihrem eigenen Traffic.
Warum wird mein Java-Pod OOMKilled, obwohl der Heap nicht voll ist?
Das Container-Limit deckt neben dem Heap auch Metaspace, Thread-Stacks, den Code-Cache, Direct Buffers und Collector-Strukturen ab. Lassen Sie Spielraum jenseits von -Xmx und vergleichen Sie die Heap-Nutzung mit dem Container Working Set.
Beeinflusst ein CPU-Limit die Java Garbage Collection? Ja, auf zwei Arten. Das Limit bestimmt die CPU-Anzahl, mit der die JVM GC-Threads dimensioniert und – zusammen mit dem Speicher – den Collector wählt. Es deckelt außerdem die CPU, die sich GC-Threads und Anwendungs-Threads teilen, sodass Throttling beide pausiert.
Weiterführende Artikel
- 5 Strategies to Optimize Java in 2026: container-aware Heap-, CPU- und GC-Einstellungen
- JVM startup CPU throttling: warum die JVM in ihren ersten Sekunden am meisten CPU braucht
- Detect Kubernetes startup spikes: Throttling und OOM-Kills finden, die Dashboards verbergen
- Fix Kubernetes resource policies that optimize for the wrong phase: Quotas und LimitRanges für Startup vs. Steady State
- How to fix OOMKilled in Kubernetes
- Kubernetes CPU throttling
- Kubernetes CPU limits
- Kubernetes resource limits vs requests
- We can resize pods without restarts! Or can't we?
- Kubernetes Vertical Pod Autoscaler (VPA)
- Kubernetes Horizontal Pod Autoscaler (HPA)