
PerfectScale
Garbage Collection Java su Kubernetes: come scegliere e dimensionare il collector giusto
La JVM sceglie il garbage collector in base ai limiti del pod, e una piccola modifica alla CPU può cambiarlo. Ecco come sceglierlo, dimensionarlo e verificarlo.
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.


TL;DR
- Default: G1 è il collector di partenza giusto per la maggior parte dei servizi Java su Kubernetes.
- La soglia: la JVM seleziona G1 solo con 2 o più CPU e almeno 1792 MB di memoria. Al di sotto, seleziona Serial senza alcun avviso.
- Impostarlo esplicitamente: fissare il collector con un flag, così una modifica al limite di CPU o di memoria non può cambiarlo.
- Scegliere in base alla dimensione del pod: G1 per i servizi tipici, Parallel per i batch, ZGC o Shenandoah per i servizi sensibili alla latenza con margine di CPU e memoria.
- Memoria: l'heap è solo una parte del processo. Lasciare margine oltre
-Xmx, altrimenti il pod viene terminato con OOMKilled anche con l'heap non pieno.
Per la maggior parte dei servizi Java su Kubernetes, G1 è il garbage collector giusto, e la JVM lo sceglie automaticamente solo quando il pod ha almeno 2 CPU e circa 1,75 GB di memoria. Al di sotto di questa soglia, la JVM ripiega silenziosamente sul collector Serial. Una piccola modifica a un limite di CPU può quindi cambiare il modo in cui il servizio esegue la garbage collection, e nessuno riceve un avviso quando succede.
Questo articolo spiega cosa fa la garbage collection in Java, come la JVM sceglie un collector in base ai limiti del container, in cosa differiscono G1, ZGC, Shenandoah, Parallel e Serial e quale usare per ogni dimensione di pod. Mostra inoltre come capire cosa sta facendo la sua JVM oggi e come le impostazioni del GC si collegano ai pod OOMKilled e al throttling della CPU.
Se i suoi pod Java si riavviano o subiscono throttling all'avvio, legga prima Throttling della CPU all'avvio della JVM. Questo articolo copre il lato steady-state dello stesso problema.
Vuole vederlo dal vivo? Partecipi al workshop pratico Java on K8s: The Startup vs. Steady-State Sizing Dilemma il 28 ottobre 2026 alle 11:00 ET.
Che cos'è la garbage collection in Java?
La garbage collection in Java è il processo automatico con cui la JVM individua gli oggetti che l'applicazione non usa più e ne libera la memoria. Lo sviluppatore non chiama free(). Il collector fa il lavoro mentre l'applicazione è in esecuzione.
La maggior parte dei collector si basa sull'ipotesi generazionale: la maggior parte degli oggetti muore giovane. L'heap è diviso in una young generation, dove iniziano i nuovi oggetti, e una old generation, dove finiscono quelli a vita lunga. Una young collection è frequente ed economica. Una old o full collection è rara e costosa.
Il costo si manifesta in due modi:
- Tempo di pausa. Alcune fasi fermano tutti i thread dell'applicazione (una pausa stop-the-world). Le richieste che arrivano durante una pausa restano in attesa, e questo aumenta la latenza di coda.
- Overhead di CPU. I thread del collector competono con i thread dell'applicazione per la stessa CPU.
In un container, entrambi i costi sono vincolati dai limiti impostati nella spec del pod. Il limite di CPU determina quanta CPU condividono collector e applicazione. Il limite di memoria determina quanto possono crescere l'heap e tutto il resto del processo. Un collector che si comporta bene su una VM a 16 core può comportarsi in modo molto diverso in un pod limitato a 1 CPU.
Come sceglie la JVM il garbage collector in Kubernetes?
Se non si imposta un collector, la JVM ne sceglie uno all'avvio in base a due numeri: il numero di CPU che vede e la memoria che vede. La guida al tuning del GC di HotSpot di Oracle definisce server-class una macchina con almeno 2 processori e almeno 1792 MB di memoria. Su una macchina server-class la JVM seleziona G1. In caso contrario seleziona Serial.
In un container, la JVM legge questi numeri dal cgroup, non dal nodo:
- Il numero di CPU deriva dal limite di CPU. La JVM divide la quota per il periodo e arrotonda per eccesso, quindi un limite di 1001m conta come 2 CPU. Da JDK 19 in poi, non usa la CPU request (
cpu.shares) per questo conteggio. - La memoria deriva dal limite di memoria. L'heap massimo predefinito è 1/4 di quella memoria, e l'heap iniziale è 1/64.
Il risultato è questa semplice tabella:
| Limite di CPU | Limite di memoria | CPU viste dalla JVM | Collector selezionato dalla JVM |
|---|---|---|---|
| 1 (o 500m) | 2Gi | 1 | Serial |
| 1100m | 2Gi | 2 | G1 |
| 2 | 1Gi | 2 | Serial (memoria sotto i 1792 MB) |
| 2 | 2Gi | 2 | G1 |
| Nessun limite | Qualsiasi | Tutte le CPU del nodo | G1 su un nodo tipico, con molti thread GC |
Ecco perché un limite di CPU di 1 e uno di 1100m possono comportarsi diversamente anche se la differenza sembra minima. La JVM dimensiona anche i suoi thread di lavoro GC in base al numero di CPU, quindi la stessa spec del pod può mostrare un comportamento GC diverso con limiti diversi. È un effetto che passa facilmente inosservato: non viene generato alcun evento e i log del pod non mostrano nulla, a meno che il logging del GC non sia attivo.
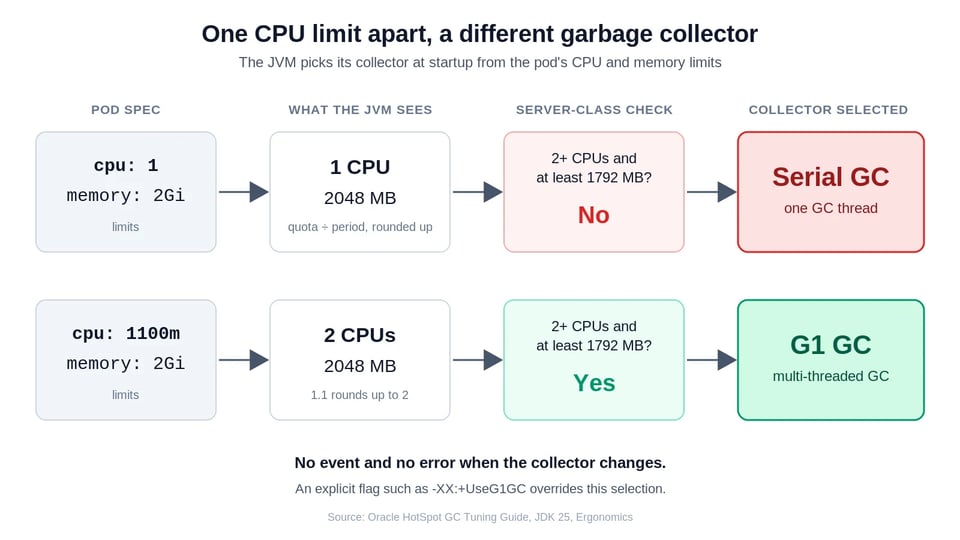
Un flag esplicito vince sempre. Se si imposta -XX:+UseG1GC o -XX:+UseSerialGC, la JVM lo usa indipendentemente dalla dimensione del container. Una proposta OpenJDK in bozza (JEP draft 8359802) renderebbe G1 il default anche sui deployment di piccole dimensioni. È ancora una bozza, quindi non conviene farci affidamento. Imposti il collector esplicitamente se vuole lo stesso comportamento su tutte le versioni di JDK e le dimensioni di pod.
Il limite di CPU influisce anche su come il collector viene eseguito. I thread GC concorrenti condividono la quota di CPU del container con i thread dell'applicazione. Quando la quota si esaurisce, il kernel li mette tutti in pausa, collector compreso. Veda Limiti di CPU in Kubernetes per il funzionamento della quota e Throttling della CPU in Kubernetes per come rilevarlo.
G1 vs ZGC vs Shenandoah vs Parallel vs Serial: come si confrontano i garbage collector Java?
HotSpot include cinque collector selezionabili con un singolo flag. Ognuno offre un compromesso diverso tra throughput, tempo di pausa e footprint.
| Collector | Flag | Come funziona | Ideale per | Attenzione a |
|---|---|---|---|---|
| Serial | -XX:+UseSerialGC |
Un solo thread GC, stop-the-world | Pod con 1 CPU e heap piccolo | Pause lunghe man mano che l'heap cresce |
| Parallel | -XX:+UseParallelGC |
Più thread GC, stop-the-world | Job batch e workloads orientati al throughput | Le pause crescono con la dimensione dell'heap |
| G1 | -XX:+UseG1GC |
Basato su regioni, in gran parte concorrente, punta a un obiettivo di pausa | La maggior parte dei servizi: il default bilanciato | Richiede CPU libera per i suoi thread concorrenti |
| ZGC | -XX:+UseZGC |
Concorrente, generazionale da JDK 23, pause molto basse | Servizi sensibili alla latenza con heap più grandi | Costo di CPU e memoria più alto rispetto a G1 |
| Shenandoah | -XX:+UseShenandoahGC |
Compattazione concorrente, pause basse | Servizi sensibili alla latenza su build OpenJDK che lo includono | Non presente in tutte le build dei vendor; la modalità generazionale è una funzionalità di prodotto solo da JDK 25 |
Se deve scegliere oggi, ci sono tre note sulle versioni da tenere presenti:
- ZGC è generazionale di default da JDK 23 (JEP 474). JDK 24 ha rimosso la modalità non generazionale (JEP 490), quindi
-XX:+UseZGCora significa sempre ZGC generazionale. - Shenandoah generazionale è diventato una funzionalità di prodotto in JDK 25 (JEP 521). Shenandoah usa ancora per default una singola generazione.
- G1 è il default sulle macchine server-class, e lo è da JDK 9.
I collector a pause ridotte svolgono più lavoro in modo concorrente, e per farlo usano più CPU e memoria. In un pod con un limite di CPU stretto, quel lavoro extra compete con l'applicazione. È il motivo principale per cui ZGC e Shenandoah di solito non sono adatti ai pod piccoli, e per cui conviene misurare prima di cambiare.
Quale garbage collector usare per il suo pod?
Parta dalla dimensione del pod e dal workload, poi confermi con i log del GC e i numeri di latenza del suo servizio. Questi sono punti di partenza, non benchmark.
| Pod e workload | Iniziare con | Perché |
|---|---|---|
| Meno di 2 CPU o meno di circa 1,75 GiB, heap piccolo | Serial, oppure G1 come scelta deliberata | È l'intervallo in cui la JVM seleziona Serial da sola. Impostare il flag esplicitamente, così la scelta resta sua. |
| 2 o più CPU, servizio web o API tipico | G1 | Throughput e tempo di pausa bilanciati, ed è il default della JVM per questa dimensione. |
| Batch, ETL o elaborazione offline dove le pause non contano | Parallel | Massimizza il throughput quando nessun utente attende una risposta. |
| Servizio sensibile alla latenza di coda con heap più grande e margine di CPU | ZGC, poi Shenandoah se il suo JDK lo include | La collection concorrente mantiene basse le pause, al costo di CPU e memoria. |
| Limite di CPU inferiore alle esigenze del collector | Alzare il limite o scegliere un collector più leggero | Un collector concorrente sottoposto a throttling può restare in pausa più a lungo di quanto farebbe G1. |
Per restare sul pratico, bastano due regole. Primo: cambiare una cosa alla volta; cambiare insieme collector e dimensione dell'heap nasconde quale modifica ha aiutato. Secondo: decidere con i dati. Confrontare latenza p99, tempo di GC, throttling della CPU e working set di memoria prima e dopo, sotto carico realistico.
Un cambio di collector è anche un cambio di dimensionamento. Un collector a pause ridotte può richiedere più CPU e più memoria di G1 per lo stesso servizio, quindi un pod dimensionato per G1 potrebbe aver bisogno di nuove request e nuovi limit dopo il passaggio. Per capire come interagiscono request e limit, veda Limit vs request delle risorse in Kubernetes.
Che relazione c'è tra garbage collection, OOMKilled e limiti di memoria del container?
Il GC lavora all'interno dell'heap. Il limite di memoria del container copre l'intero processo. I due errori sembrano simili ma hanno cause diverse:
| Errore | Chi lo genera | Cosa significa | Primo intervento |
|---|---|---|---|
java.lang.OutOfMemoryError: Java heap space |
La JVM | L'heap ha raggiunto -Xmx e il GC non è riuscito a liberare abbastanza memoria |
Trovare il leak o aumentare l'heap |
| OOMKilled (exit code 137) | Il kernel, tramite il cgroup | La memoria totale del processo ha superato il limite del container | Lasciare più spazio fuori dall'heap o aumentare il limite |
L'heap è solo una parte di ciò che una JVM usa. Il processo contiene anche metaspace, stack dei thread, la code cache del JIT, direct buffer e le strutture native del collector stesso. I collector differiscono proprio in quest'ultima parte, quindi cambiare collector può spostare la memoria totale anche quando -Xmx resta invariato.
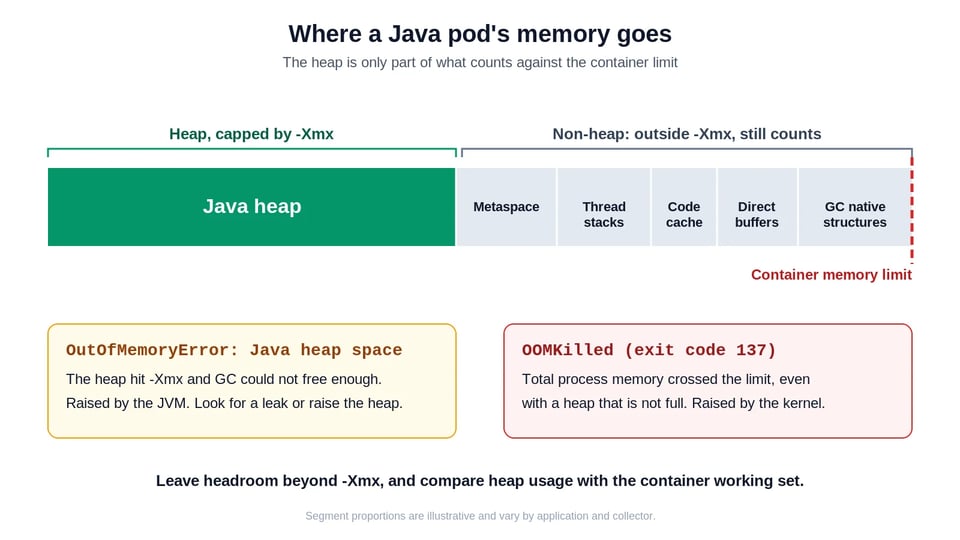
L'heap massimo predefinito è 1/4 della memoria del container, il che spesso spreca memoria. Molti team lo aumentano con -XX:MaxRAMPercentage, partendo in genere tra il 50 e il 70 percento e regolando in base all'uso non-heap misurato. Quell'intervallo va trattato come punto di partenza: un servizio con molti thread o un uso intenso di direct buffer ha bisogno di più margine.
Per un approccio a heap fisso (-Xms uguale a -Xmx) e altre impostazioni JVM container-aware, veda 5 strategie per ottimizzare Java nel 2026.
Due flag rendono gli errori più facili da diagnosticare:
-XX:+ExitOnOutOfMemoryError-XX:+HeapDumpOnOutOfMemoryErrorIl primo fa uscire la JVM in caso di OOM dell'heap, così Kubernetes riavvia il pod in modo pulito invece di lasciare un processo che funziona a metà. Il secondo scrive un heap dump da ispezionare. Mantenga il percorso del dump su un volume che sopravvive al riavvio. Per il lato Kubernetes di questo errore, veda OOMKilled.
Come vedere cosa sta facendo il garbage collector della JVM?
Controlli tre cose: quale collector è in esecuzione, quanto costa il GC e se il container è sottoposto a throttling.
Quale collector e quante CPU ha scelto la JVM
kubectl exec <pod-name> -- jcmd 1 VM.flags -all \ | grep -E 'UseSerialGC|UseG1GC|UseZGC|UseParallelGC|ParallelGCThreads|ConcGCThreads'Servono jcmd nell'immagine e la JVM in esecuzione come processo 1. Un'immagine con il solo JRE non include jcmd.
Log del GC
Attivi il logging unificato del GC con una variabile d'ambiente e legga le righe delle pause:
env: - name: JAVA_TOOL_OPTIONS value: "-Xlog:gc*:stdout:time,uptime"Osservi con quale frequenza vengono eseguite le young collection, quanto durano le pause e se compaiono full collection. Full collection frequenti indicano che l'heap è troppo piccolo per i dati live.
Metriche su cui vale la pena impostare alert
Se usa Micrometer o il Prometheus JMX exporter, queste metriche mostrano il costo del GC nel tempo:
| Segnale | Metrica di esempio | Come si presenta un valore problematico |
|---|---|---|
| Tempo di pausa del GC | jvm_gc_pause_seconds_sum |
Quota crescente del tempo totale trascorso in GC |
| Heap in uso | jvm_memory_used_bytes{area="heap"} |
Resta vicino al massimo dopo le collection |
| Memoria del container | container_memory_working_set_bytes |
Si avvicina al limite di memoria |
| Throttling della CPU | container_cpu_cfs_throttled_periods_total su container_cpu_cfs_periods_total |
Una quota elevata di periodi throttled mentre il GC è in esecuzione |
Legga insieme le righe dell'heap e della memoria del container. Un heap ben al di sotto del limite con il working set vicino al limite indica memoria non-heap, non il collector. Una quota elevata di throttling durante il GC indica un limite di CPU troppo stretto per il collector scelto.
GC e pressione sulla CPU raggiungono spesso il picco nei primi secondi dopo l'avvio di un pod, per poi sparire dalle dashboard a cinque minuti. Per intercettarli, veda come rilevare i picchi di avvio in Kubernetes.
Quali flag JVM rendono la garbage collection container-aware?
La JVM legge i limiti del container per default (-XX:+UseContainerSupport). Questi flag rendono il risultato esplicito e ripetibile:
| Flag | Cosa fa | Quando impostarlo |
|---|---|---|
-XX:+UseG1GC (o un altro collector) |
Fissa il collector | Sempre, così le modifiche alla dimensione del pod non lo cambiano |
-XX:MaxRAMPercentage=<n> |
Imposta l'heap massimo come quota della memoria del container | Quando il default del 25% lascia memoria inutilizzata |
-XX:ActiveProcessorCount=<n> |
Sovrascrive il numero di CPU rilevato | Quando si vogliono gli stessi conteggi di thread in ogni ambiente |
-XX:ParallelGCThreads=<n> |
Imposta i thread di lavoro GC stop-the-world | Quando il default derivato dalla CPU è troppo alto per un pod sottoposto a throttling |
-XX:ConcGCThreads=<n> |
Imposta i thread di lavoro GC concorrenti | Quando il GC concorrente compete con l'applicazione per la CPU |
-XX:MaxGCPauseMillis=<n> |
Imposta un obiettivo di tempo di pausa per G1 | Solo dopo aver misurato le pause |
-Xlog:gc* |
Attiva il logging del GC | Sempre in produzione |
Ecco un set di partenza per un tipico pod API con 2 CPU e 2 GiB di memoria:
env: - name: JAVA_TOOL_OPTIONS value: >- -XX:+UseG1GC -XX:MaxRAMPercentage=65 -XX:+ExitOnOutOfMemoryError -Xlog:gc*:stdout:time,uptimeIl valore 65 è un punto di partenza, non una raccomandazione valida per ogni servizio. Misuri prima il footprint non-heap, poi regoli. Eviti di copiare lunghe liste di flag di tuning da vecchi post. I default sono cambiati tra le versioni del JDK, e i flag extra rendono spesso più difficile ragionare sul comportamento del GC.
Come PerfectScale aiuta nel right-sizing dei workloads Java
Impostazioni del GC, dimensione dell'heap e request e limit dei pod si influenzano a vicenda. Modificarne uno senza considerare gli altri è il modo più rapido per ritrovarsi con pod sottoposti a throttling o riavvii per OOMKilled. PerfectScale mostra questi segnali insieme.
Per i container Java, PerfectScale raccoglie dati su heap, non-heap e garbage collection. Mostra il tempo di GC, il numero di processori attivi e il tipo di GC, così può vedere quale collector esegue ogni workload e quanto costa. Può attivare la raccolta delle metriche JVM quando installa l'agente PerfectScale. Supporta solo nodi Linux.
PerfectScale rispetta inoltre le sue impostazioni JVM. Quando imposta una dimensione massima o minima dell'heap, PerfectScale non applica raccomandazioni che escano da quei limiti. Per ridimensionare i pod senza riavvii, veda il right-sizing in-place e il Vertical Pod Autoscaler.

Workshop: Java on K8s: The Startup vs. Steady-State Sizing Dilemma. Vikram Seshadri di DoiT illustra il picco di boot della JVM, quanto costa in termini di throttling, OOM kill e request sovradimensionate, e come dimensionare i pod per lo steady state con un resize in-place e senza riavvio. 28 ottobre 2026 alle 11:00 ET. Riservi il suo posto.
Vuole vedere come PerfectScale ottimizza il dimensionamento dei suoi workloads Java? Inizi gratis o prenoti una demo.
FAQ
Qual è il garbage collector predefinito in Java? G1 su una macchina server-class, ossia con 2 o più processori e almeno 1792 MB di memoria. Altrimenti la JVM seleziona Serial. In un container, la JVM legge il limite di CPU e il limite di memoria per decidere.
Qual è il miglior garbage collector in Java? Nessun collector vince in ogni scenario. G1 è il miglior punto di partenza per la maggior parte dei servizi. Parallel è adatto ai job batch, mentre ZGC o Shenandoah sono indicati per i servizi sensibili alla latenza con margine di CPU e memoria.
Java esegue la garbage collection automaticamente? Sì. La JVM individua gli oggetti inutilizzati e ne libera la memoria senza chiamate da parte dello sviluppatore. Si regola con la scelta del collector, la dimensione dell'heap e i flag del GC.
Come funziona la garbage collection in Java? Il collector individua gli oggetti che l'applicazione non può più raggiungere, ne libera la memoria e spesso compatta ciò che resta. La maggior parte dei collector divide l'heap in generazioni young e old perché la maggior parte degli oggetti muore giovane.
ZGC è meglio di G1? ZGC punta a pause più basse, e lo paga con più CPU e memoria. Tende a dare i maggiori benefici su heap più grandi con CPU libera. Sui pod piccoli, G1 è di solito la scelta più sicura. Testare con il proprio traffico.
Perché il mio pod Java viene terminato con OOMKilled se l'heap non è pieno?
Il limite del container copre metaspace, stack dei thread, code cache, direct buffer e strutture del collector, oltre all'heap. Lasciare margine oltre -Xmx e confrontare l'uso dell'heap con il working set del container.
Un limite di CPU influisce sulla garbage collection di Java? Sì, in due modi. Il limite determina il numero di CPU che la JVM usa per dimensionare i thread GC e, insieme alla memoria, per scegliere il collector. Inoltre limita la CPU condivisa tra thread GC e thread dell'applicazione, quindi il throttling mette in pausa entrambi.
Letture correlate
- 5 strategie per ottimizzare Java nel 2026: impostazioni container-aware per heap, CPU e GC
- Throttling della CPU all'avvio della JVM: perché la JVM ha più bisogno di CPU nei suoi primi secondi
- Rilevare i picchi di avvio in Kubernetes: individuare il throttling e gli OOM kill che le dashboard nascondono
- Correggere le policy di risorse Kubernetes che ottimizzano la fase sbagliata: quote e LimitRanges per avvio vs steady state
- Come risolvere OOMKilled in Kubernetes
- Throttling della CPU in Kubernetes
- Limiti di CPU in Kubernetes
- Limit vs request delle risorse in Kubernetes
- Possiamo ridimensionare i pod senza riavvii! O forse no?
- Kubernetes Vertical Pod Autoscaler (VPA)
- Kubernetes Horizontal Pod Autoscaler (HPA)