
PerfectScale
Garbage collection Java sur Kubernetes : choisir et dimensionner le bon collecteur
La JVM choisit votre garbage collector à partir des limites du pod, et une petite modification de la limite CPU peut suffire à en changer. Voici comment le choisir, le dimensionner et le vérifier.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


TL;DR
- Par défaut : G1 est le bon collecteur de départ pour la plupart des services Java sur Kubernetes.
- Le seuil : la JVM ne sélectionne G1 qu'avec 2 CPU ou plus et au moins 1792 Mo de mémoire. En dessous, elle sélectionne Serial en silence.
- Définissez-le explicitement : figez le collecteur avec un flag pour qu'un changement de limite CPU ou mémoire ne puisse pas le modifier.
- Choisissez selon la taille du pod : G1 pour les services classiques, Parallel pour le batch, ZGC ou Shenandoah pour les services sensibles à la latence disposant d'une marge CPU et mémoire.
- Mémoire : le heap n'est qu'une partie du processus. Gardez de la marge au-delà de
-Xmx, sinon le pod se fait OOMKilled alors que le heap n'est pas plein.
Pour la plupart des services Java sur Kubernetes, G1 est le bon garbage collector, et la JVM ne le choisit pour vous que si le pod dispose d'au moins 2 CPU et d'environ 1,75 Go de mémoire. En dessous, la JVM bascule silencieusement sur le collecteur Serial. Une petite modification d'une limite CPU peut donc changer la façon dont votre service effectue son garbage collection, et personne ne reçoit d'alerte quand cela se produit.
Cet article explique ce que fait le garbage collection Java, comment la JVM choisit un collecteur à partir des limites de vos conteneurs, en quoi G1, ZGC, Shenandoah, Parallel et Serial diffèrent, et lequel utiliser selon la taille du pod. Il montre aussi comment lire ce que fait votre JVM aujourd'hui, et comment les réglages GC sont liés aux pods OOMKilled et au throttling CPU.
Si vos pods Java redémarrent ou subissent du throttling au démarrage, lisez d'abord le throttling CPU au démarrage de la JVM. Cet article couvre le volet régime permanent du même problème.
Envie de le voir en direct ? Participez au workshop pratique Java on K8s: The Startup vs. Steady-State Sizing Dilemma le 28 octobre 2026 à 11 h (heure de l'Est).
Qu'est-ce que le garbage collection Java ?
Le garbage collection Java est le mécanisme automatique par lequel la JVM identifie les objets que l'application n'utilise plus et libère leur mémoire. Le développeur n'appelle pas free(). Le collecteur fait le travail pendant que l'application s'exécute.
La plupart des collecteurs s'appuient sur l'hypothèse générationnelle : la plupart des objets meurent jeunes. Le heap est divisé en une jeune génération, où naissent les nouveaux objets, et une ancienne génération, où finissent les objets à longue durée de vie. Une collecte de la jeune génération est fréquente et peu coûteuse. Une collecte de l'ancienne génération, ou complète, est rare et coûteuse.
Le coût se manifeste de deux manières :
- Temps de pause. Certaines phases arrêtent tous les threads applicatifs (pause stop-the-world). Les requêtes qui arrivent pendant une pause attendent, ce qui augmente la latence en queue de distribution.
- Surcoût CPU. Les threads du collecteur se disputent le CPU avec les threads applicatifs.
Dans un conteneur, ces deux coûts sont bornés par les limites que vous définissez dans la spec du pod. La limite CPU plafonne le CPU que se partagent le collecteur et l'application. La limite mémoire plafonne la taille du heap, et de tout le reste du processus. Un collecteur qui se comporte bien sur une VM à 16 cœurs peut se comporter très différemment dans un pod limité à 1 CPU.
Comment la JVM choisit-elle un garbage collector dans Kubernetes ?
Si vous ne définissez pas de collecteur, la JVM en choisit un au démarrage à partir de deux nombres : le nombre de CPU qu'elle voit et la mémoire qu'elle voit. Le guide de tuning GC HotSpot d'Oracle qualifie une machine de server-class lorsqu'elle dispose d'au moins 2 processeurs et d'au moins 1792 Mo de mémoire. Sur une machine server-class, la JVM sélectionne G1. Sinon, elle sélectionne Serial.
Dans un conteneur, la JVM lit ces nombres depuis le cgroup, pas depuis le nœud :
- Le nombre de CPU provient de la limite CPU. La JVM divise le quota par la période et arrondit au supérieur, si bien qu'une limite de 1001m compte pour 2 CPU. Depuis le JDK 19, elle n'utilise pas la request CPU (
cpu.shares) pour ce calcul. - La mémoire provient de la limite mémoire. Le heap maximal par défaut correspond à 1/4 de cette mémoire, et le heap initial à 1/64.
D'où ce tableau de résultats simple :
| Limite CPU | Limite mémoire | CPU vus par la JVM | Collecteur sélectionné par la JVM |
|---|---|---|---|
| 1 (ou 500m) | 2Gi | 1 | Serial |
| 1100m | 2Gi | 2 | G1 |
| 2 | 1Gi | 2 | Serial (mémoire sous 1792 Mo) |
| 2 | 2Gi | 2 | G1 |
| Aucune limite | Indifférente | Tous les CPU du nœud | G1 sur un nœud classique, avec de nombreux threads GC |
C'est pourquoi une limite CPU de 1 et une limite de 1100m peuvent se comporter différemment, alors que la différence paraît minuscule. La JVM dimensionne aussi ses threads GC à partir du nombre de CPU, si bien que la même spec de pod peut présenter un comportement GC différent selon les limites. L'effet passe facilement inaperçu : aucun événement n'est émis, et les logs du pod ne montrent rien si le logging GC n'est pas activé.
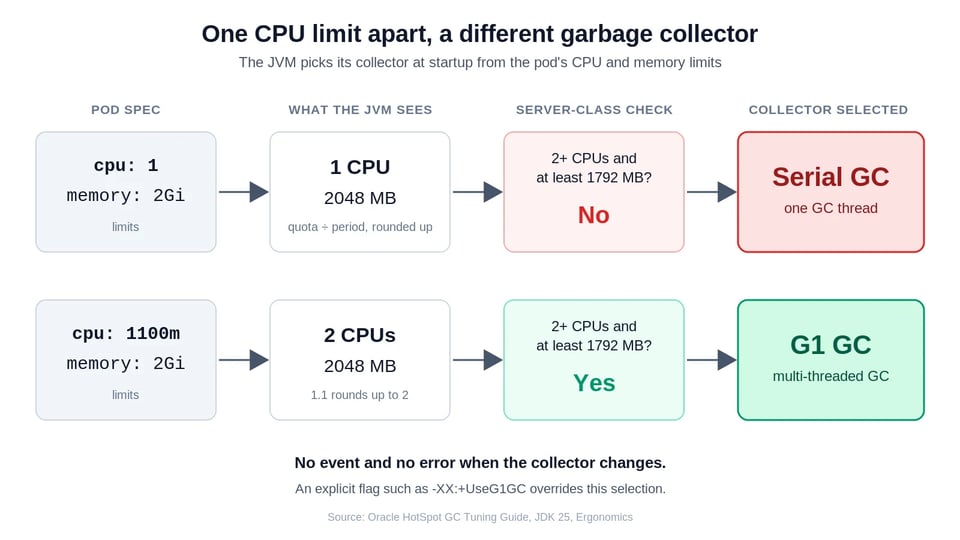
Un flag explicite l'emporte toujours. Si vous définissez -XX:+UseG1GC ou -XX:+UseSerialGC, la JVM l'utilise quelle que soit la taille du conteneur. Un brouillon de proposition OpenJDK (JEP draft 8359802) ferait de G1 le collecteur par défaut même sur les petits déploiements. Il ne s'agit encore que d'un brouillon, ne vous y fiez donc pas. Définissez le collecteur explicitement si vous voulez le même comportement sur toutes les versions de JDK et toutes les tailles de pod.
La limite CPU influe aussi sur le fonctionnement du collecteur. Les threads GC concurrents partagent le quota CPU du conteneur avec vos threads applicatifs. Quand le quota est épuisé, le noyau les met tous en pause, collecteur compris. Voir les limites CPU dans Kubernetes pour le fonctionnement de ce quota, et le throttling CPU dans Kubernetes pour savoir comment le détecter.
G1 vs ZGC vs Shenandoah vs Parallel vs Serial : quelles différences entre les garbage collectors Java ?
HotSpot est livré avec cinq collecteurs que vous pouvez choisir avec un seul flag. Ils arbitrent entre débit, temps de pause et empreinte mémoire.
| Collecteur | Flag | Fonctionnement | Cas d'usage idéal | Points de vigilance |
|---|---|---|---|---|
| Serial | -XX:+UseSerialGC |
Un seul thread GC, stop-the-world | Pods à 1 CPU avec un petit heap | Pauses longues à mesure que le heap grandit |
| Parallel | -XX:+UseParallelGC |
Plusieurs threads GC, stop-the-world | Jobs batch et workloads orientés débit | Les pauses augmentent avec la taille du heap |
| G1 | -XX:+UseG1GC |
Par régions, majoritairement concurrent, vise un objectif de pause | La plupart des services : le choix par défaut équilibré | A besoin de CPU disponible pour ses threads concurrents |
| ZGC | -XX:+UseZGC |
Concurrent, générationnel depuis le JDK 23, pauses très courtes | Services sensibles à la latence avec des heaps plus grands | Coût CPU et mémoire supérieur à G1 |
| Shenandoah | -XX:+UseShenandoahGC |
Compaction concurrente, pauses courtes | Services sensibles à la latence sur les builds OpenJDK qui l'incluent | Absent de certains builds ; le mode générationnel n'est une fonctionnalité officielle que depuis le JDK 25 |
Trois notes de version comptent si vous choisissez aujourd'hui :
- ZGC est générationnel par défaut depuis le JDK 23 (JEP 474). Le JDK 24 a supprimé le mode non générationnel (JEP 490), donc
-XX:+UseZGCsignifie désormais toujours ZGC générationnel. - Shenandoah générationnel est devenu une fonctionnalité officielle avec le JDK 25 (JEP 521). Shenandoah reste par défaut sur une seule génération.
- G1 est le collecteur par défaut sur les machines server-class, et ce depuis le JDK 9.
Les collecteurs à faibles pauses effectuent davantage de travail de manière concurrente, et consomment donc plus de CPU et de mémoire pour y parvenir. Dans un pod avec une limite CPU serrée, ce travail supplémentaire entre en concurrence avec votre application. C'est la raison principale pour laquelle ZGC et Shenandoah conviennent généralement mal aux petits pods, et pourquoi il faut mesurer avant de changer.
Quel garbage collector utiliser pour votre pod ?
Partez de la taille du pod et du workload, puis confirmez avec les logs GC et les chiffres de latence de votre propre service. Ce sont des points de départ, pas des benchmarks.
| Pod et workload | Commencez avec | Pourquoi |
|---|---|---|
| Moins de 2 CPU ou moins d'environ 1,75 Gio, petit heap | Serial, ou G1 par choix délibéré | C'est la plage où la JVM sélectionne Serial d'elle-même. Définissez le flag explicitement pour que le choix vous appartienne. |
| 2 CPU ou plus, service web ou API classique | G1 | Débit et temps de pause équilibrés, et c'est le choix par défaut de la JVM pour cette taille. |
| Batch, ETL ou traitement hors ligne où les pauses n'ont pas d'importance | Parallel | Maximise le débit quand aucun utilisateur n'attend de réponse. |
| Service sensible à la latence de queue avec un heap plus grand et de la marge CPU | ZGC, puis Shenandoah si votre JDK l'inclut | La collecte concurrente garde des pauses courtes, au prix d'un surcoût CPU et mémoire. |
| Limite CPU inférieure aux besoins du collecteur | Augmentez la limite, ou choisissez un collecteur plus léger | Un collecteur concurrent soumis au throttling peut marquer des pauses plus longues que G1 ne le ferait. |
Deux règles pour garder une démarche pragmatique. D'abord, changez une seule chose à la fois : modifier en même temps le collecteur et la taille du heap empêche de savoir quel changement a été utile. Ensuite, décidez avec des données. Comparez la latence p99, le temps GC, le throttling CPU et le working set mémoire avant et après, sous une charge réaliste.
Changer de collecteur, c'est aussi changer de dimensionnement. Un collecteur à faibles pauses peut avoir besoin de plus de CPU et de mémoire que G1 pour le même service : un pod dimensionné pour G1 peut donc nécessiter de nouvelles requests et limits après le changement. Pour l'interaction entre requests et limits, voir limits vs requests de ressources Kubernetes.
Quel lien entre garbage collection, OOMKilled et limites mémoire des conteneurs ?
Le GC travaille à l'intérieur du heap. La limite mémoire du conteneur couvre l'ensemble du processus. Les deux défaillances se ressemblent, mais ont des causes différentes :
| Défaillance | Qui la déclenche | Ce que cela signifie | Premier correctif |
|---|---|---|---|
java.lang.OutOfMemoryError: Java heap space |
La JVM | Le heap a atteint -Xmx et le GC n'a pas pu libérer assez de mémoire |
Trouvez la fuite ou augmentez le heap |
| OOMKilled (code de sortie 137) | Le noyau, via le cgroup | La mémoire totale du processus a dépassé la limite du conteneur | Laissez plus de place hors du heap, ou augmentez la limite |
Le heap n'est qu'une partie de ce qu'utilise une JVM. Le processus contient aussi la metaspace, les piles des threads, le cache de code JIT, les buffers directs et les structures natives propres au collecteur. Les collecteurs diffèrent sur ce dernier point : en changer peut faire varier la mémoire totale même si -Xmx reste identique.
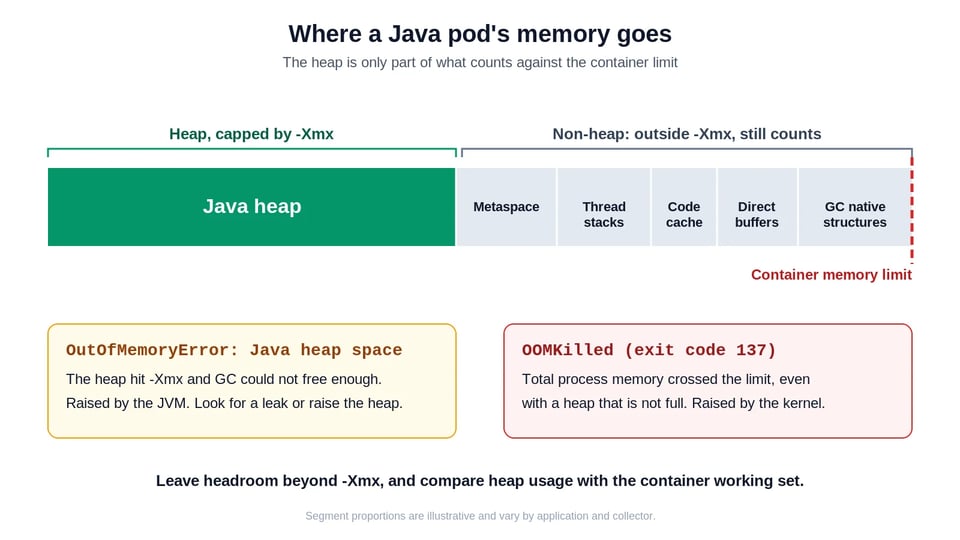
Le heap maximal par défaut correspond à 1/4 de la mémoire du conteneur, ce qui gaspille souvent de la mémoire. Beaucoup d'équipes l'augmentent avec -XX:MaxRAMPercentage, en commençant généralement entre 50 et 70 % et en ajustant d'après l'usage non-heap mesuré. Considérez cette plage comme un point de départ : un service avec de nombreux threads ou un usage intensif de buffers directs a besoin de plus de marge.
Pour une approche à heap fixe (-Xms égal à -Xmx) et d'autres réglages JVM adaptés aux conteneurs, voir 5 stratégies pour optimiser Java en 2026.
Deux flags facilitent le diagnostic des défaillances :
-XX:+ExitOnOutOfMemoryError-XX:+HeapDumpOnOutOfMemoryErrorLe premier fait quitter la JVM en cas d'OOM du heap, pour que Kubernetes redémarre le pod proprement au lieu de laisser un processus à moitié fonctionnel. Le second écrit un heap dump que vous pouvez inspecter. Gardez le chemin du dump sur un volume qui survit au redémarrage. Pour le versant Kubernetes de cette défaillance, voir OOMKilled.
Comment voir ce que fait le garbage collector de votre JVM ?
Vérifiez trois choses : quel collecteur tourne, ce que le GC vous coûte, et si le conteneur subit du throttling.
Quel collecteur et quel nombre de CPU la JVM a choisis
kubectl exec <pod-name> -- jcmd 1 VM.flags -all \ | grep -E 'UseSerialGC|UseG1GC|UseZGC|UseParallelGC|ParallelGCThreads|ConcGCThreads'Cela nécessite jcmd dans l'image et une JVM tournant en tant que processus 1. Une image JRE seule n'inclut pas jcmd.
Les logs GC
Activez le logging GC unifié avec une variable d'environnement, et lisez les lignes de pause :
env: - name: JAVA_TOOL_OPTIONS value: "-Xlog:gc*:stdout:time,uptime"Regardez la fréquence des collectes de la jeune génération, la durée des pauses et l'apparition éventuelle de collectes complètes. Des collectes complètes fréquentes signifient que le heap est trop petit pour les données vivantes.
Les métriques qui méritent des alertes
Si vous utilisez Micrometer ou l'exporteur JMX de Prometheus, ces signaux montrent le coût du GC dans le temps :
| Signal | Exemple de métrique | À quoi ressemble une mauvaise valeur |
|---|---|---|
| Temps de pause GC | jvm_gc_pause_seconds_sum |
Part croissante du temps réel passée en GC |
| Heap utilisé | jvm_memory_used_bytes{area="heap"} |
Reste proche du maximum après les collectes |
| Mémoire du conteneur | container_memory_working_set_bytes |
S'approche de la limite mémoire |
| Throttling CPU | container_cpu_cfs_throttled_periods_total rapporté à container_cpu_cfs_periods_total |
Une part élevée de périodes throttled pendant le GC |
Lisez ensemble les lignes heap et mémoire du conteneur. Un heap bien en dessous de la limite avec un working set proche de la limite pointe vers la mémoire non-heap, pas vers le collecteur. Une part élevée de throttling pendant le GC pointe vers une limite CPU trop serrée pour le collecteur choisi.
Le GC et la pression CPU culminent souvent dans les premières secondes après le démarrage d'un pod, puis disparaissent des dashboards agrégés sur cinq minutes. Pour les repérer, voir comment détecter les pics de démarrage Kubernetes.
Quels flags JVM adaptent le garbage collection aux conteneurs ?
La JVM lit les limites du conteneur par défaut (-XX:+UseContainerSupport). Ces flags rendent le résultat explicite et reproductible :
| Flag | Rôle | Quand le définir |
|---|---|---|
-XX:+UseG1GC (ou un autre collecteur) |
Fixe le collecteur | Toujours, pour qu'un changement de taille de pod ne le modifie pas |
-XX:MaxRAMPercentage=<n> |
Définit le heap maximal en pourcentage de la mémoire du conteneur | Quand la valeur par défaut de 25 % laisse de la mémoire inutilisée |
-XX:ActiveProcessorCount=<n> |
Remplace le nombre de CPU détecté | Quand vous voulez les mêmes nombres de threads dans tous les environnements |
-XX:ParallelGCThreads=<n> |
Définit les threads GC stop-the-world | Quand la valeur par défaut dérivée du CPU est trop élevée pour un pod soumis au throttling |
-XX:ConcGCThreads=<n> |
Définit les threads GC concurrents | Quand le GC concurrent dispute le CPU à l'application |
-XX:MaxGCPauseMillis=<n> |
Définit un objectif de temps de pause pour G1 | Seulement après avoir mesuré les pauses |
-Xlog:gc* |
Active le logging GC | Toujours en production |
Un jeu de départ pour un pod API classique avec 2 CPU et 2 Gio de mémoire ressemble à ceci :
env: - name: JAVA_TOOL_OPTIONS value: >- -XX:+UseG1GC -XX:MaxRAMPercentage=65 -XX:+ExitOnOutOfMemoryError -Xlog:gc*:stdout:time,uptimeLa valeur 65 est un point de départ, pas une recommandation valable pour chaque service. Mesurez d'abord l'empreinte non-heap, puis ajustez. Évitez de copier de grands jeux de flags de tuning depuis de vieux articles de blog. Les valeurs par défaut ont changé au fil des versions du JDK, et des flags superflus rendent souvent le comportement du GC plus difficile à comprendre.
Comment PerfectScale facilite le right-sizing des workloads Java
Les réglages GC, la taille du heap et les requests et limits des pods s'influencent mutuellement. Modifier l'un sans tenir compte des autres, c'est ainsi que des équipes se retrouvent avec des pods soumis au throttling ou des redémarrages OOMKilled. PerfectScale montre ces signaux ensemble.
Pour les conteneurs Java, PerfectScale collecte les données de heap, de non-heap et de garbage collection. Il affiche le temps GC, le nombre de processeurs actifs et le type de GC, pour que vous puissiez voir quel collecteur chaque workload exécute et ce qu'il coûte. Vous pouvez activer la collecte des métriques JVM lors de l'installation de l'agent PerfectScale. Seuls les nœuds Linux sont pris en charge.
PerfectScale respecte aussi vos réglages JVM. Lorsque vous définissez une taille de heap maximale ou minimale, PerfectScale n'applique pas de recommandation qui en sortirait. Pour redimensionner les pods sans redémarrage, voir le right-sizing in-place et le Vertical Pod Autoscaler.

Workshop : Java on K8s: The Startup vs. Steady-State Sizing Dilemma. Vikram Seshadri, de DoiT, décortique le pic de démarrage de la JVM, ce qu'il coûte en throttling, en OOM kills et en requests surdimensionnées, et comment dimensionner les pods pour le régime permanent avec un redimensionnement in-place, sans redémarrage. Le 28 octobre 2026 à 11 h (heure de l'Est). Réservez votre place.
Envie de voir comment PerfectScale optimise le dimensionnement de vos workloads Java ? Commencez gratuitement ou réservez une démo.
FAQ
Quel est le garbage collector par défaut en Java ? G1 sur une machine server-class, c'est-à-dire 2 processeurs ou plus et au moins 1792 Mo de mémoire. Sinon, la JVM sélectionne Serial. Dans un conteneur, la JVM lit la limite CPU et la limite mémoire pour décider.
Quel est le meilleur garbage collector en Java ? Aucun collecteur ne gagne partout. G1 est le meilleur point de départ pour la plupart des services. Parallel convient au batch, et ZGC ou Shenandoah aux services sensibles à la latence disposant de marge CPU et mémoire.
Java fait-il du garbage collection automatique ? Oui. La JVM trouve les objets inutilisés et libère leur mémoire sans appel du développeur. Vous l'ajustez via le choix du collecteur, la taille du heap et les flags GC.
Comment fonctionne le garbage collection en Java ? Le collecteur trouve les objets que l'application ne peut plus atteindre, libère leur mémoire et compacte souvent ce qui reste. La plupart des collecteurs divisent le heap en une jeune et une ancienne génération, car la plupart des objets meurent jeunes.
ZGC est-il meilleur que G1 ? ZGC vise des pauses plus courtes, et le paie avec plus de CPU et de mémoire. Il aide surtout sur les heaps plus grands avec du CPU disponible. Sur les petits pods, G1 est généralement le choix le plus sûr. Testez avec votre propre trafic.
Pourquoi mon pod Java se fait-il OOMKilled alors que le heap n'est pas plein ?
La limite du conteneur couvre la metaspace, les piles des threads, le cache de code, les buffers directs et les structures du collecteur, en plus du heap. Gardez de la marge au-delà de -Xmx, et comparez l'usage du heap avec le working set du conteneur.
Une limite CPU affecte-t-elle le garbage collection Java ? Oui, de deux manières. La limite fixe le nombre de CPU que la JVM utilise pour dimensionner les threads GC et, avec la mémoire, pour choisir le collecteur. Elle plafonne aussi le CPU que partagent threads GC et threads applicatifs, si bien que le throttling met les deux en pause.
À lire également
- 5 stratégies pour optimiser Java en 2026 : réglages heap, CPU et GC adaptés aux conteneurs
- Le throttling CPU au démarrage de la JVM : pourquoi la JVM a le plus besoin de CPU dans ses premières secondes
- Détecter les pics de démarrage Kubernetes : repérer le throttling et les OOM kills que les dashboards cachent
- Corriger les politiques de ressources Kubernetes qui optimisent la mauvaise phase : quotas et LimitRanges pour le démarrage face au régime permanent
- Comment corriger OOMKilled dans Kubernetes
- Le throttling CPU dans Kubernetes
- Les limites CPU dans Kubernetes
- Limits vs requests de ressources Kubernetes
- On peut redimensionner les pods sans redémarrage ! Vraiment ?
- Kubernetes Vertical Pod Autoscaler (VPA)
- Kubernetes Horizontal Pod Autoscaler (HPA)