
PerfectScale
Garbage Collection Java no Kubernetes: como escolher e dimensionar o coletor certo
A JVM escolhe o garbage collector a partir dos limites do pod — e uma pequena mudança na CPU pode trocá-lo. Veja como escolher, dimensionar e verificar.
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.


Resumo
- Padrão: o G1 é o coletor certo para começar na maioria dos serviços Java no Kubernetes.
- O ponto de corte: a JVM só seleciona o G1 com 2 ou mais CPUs e pelo menos 1792 MB de memória. Abaixo disso, ela seleciona o Serial silenciosamente.
- Defina explicitamente: fixe o coletor com uma flag para que uma mudança no limite de CPU ou memória não possa trocá-lo.
- Escolha pelo tamanho do pod: G1 para serviços típicos, Parallel para batch, ZGC ou Shenandoah para serviços sensíveis a latência que tenham folga de CPU e memória.
- Memória: o heap é só uma parte do processo. Deixe folga além de
-Xmx, ou o pod leva OOMKilled mesmo com o heap longe de cheio.
Para a maioria dos serviços Java no Kubernetes, o G1 é o garbage collector certo — e a JVM só o escolhe por você quando o pod tem pelo menos 2 CPUs e cerca de 1,75 GB de memória. Abaixo disso, a JVM recorre silenciosamente ao coletor Serial. Ou seja: uma pequena mudança em um limite de CPU pode mudar a forma como seu serviço coleta lixo, e ninguém recebe alerta quando isso acontece.
Este artigo explica o que o garbage collection do Java faz, como a JVM escolhe um coletor a partir dos limites do seu container, em que G1, ZGC, Shenandoah, Parallel e Serial diferem e qual usar em cada tamanho de pod. Ele também mostra como descobrir o que sua JVM está fazendo hoje e como as configurações de GC se conectam a pods com OOMKilled e ao throttling de CPU.
Se seus pods Java reiniciam ou sofrem throttling na inicialização, leia primeiro JVM startup CPU throttling. Este artigo cobre o lado de steady state do mesmo problema.
Quer ver isso ao vivo? Participe do workshop prático Java on K8s: The Startup vs. Steady-State Sizing Dilemma em 28/10/2026, às 11h (horário do leste dos EUA, ET).
O que é o garbage collection do Java?
O garbage collection do Java é o processo automático da JVM para encontrar objetos que a aplicação não usa mais e liberar a memória deles. O desenvolvedor não chama free(). O coletor faz o trabalho enquanto a aplicação roda.
A maioria dos coletores se baseia na hipótese geracional: a maior parte dos objetos morre jovem. O heap é dividido em uma geração jovem, onde os novos objetos começam, e uma geração velha, onde os objetos de vida longa acabam. Uma coleta da geração jovem é frequente e barata. Uma coleta da geração velha, ou uma coleta completa, é rara e cara.
O custo aparece de duas formas:
- Tempo de pausa. Algumas fases param todas as threads da aplicação (uma pausa stop-the-world). Requisições que chegam durante uma pausa ficam esperando, o que eleva a latência de cauda.
- Overhead de CPU. As threads do coletor competem com as threads da aplicação pela mesma CPU.
Em um container, ambos os custos são limitados pelos limits que você define na especificação do pod. O limite de CPU restringe quanta CPU o coletor e a aplicação compartilham. O limite de memória restringe o quanto o heap — e tudo o mais no processo — pode crescer. Um coletor que se comporta bem em uma VM de 16 núcleos pode se comportar de forma muito diferente em um pod limitado a 1 CPU.
Como a JVM escolhe um garbage collector no Kubernetes?
Se você não definir um coletor, a JVM escolhe um na inicialização a partir de dois números: a contagem de CPUs que ela enxerga e a memória que ela enxerga. O guia de tuning de GC do HotSpot da Oracle chama uma máquina de server-class quando ela tem pelo menos 2 processadores e pelo menos 1792 MB de memória. Em uma máquina server-class, a JVM seleciona o G1. Caso contrário, seleciona o Serial.
Em um container, a JVM lê esses números do cgroup, não do node:
- A contagem de CPUs vem do limite de CPU. A JVM divide a quota pelo período e arredonda para cima, então um limite de 1001m conta como 2 CPUs. Desde o JDK 19, ela não usa o request de CPU (
cpu.shares) para essa contagem. - A memória vem do limite de memória. O heap máximo padrão é 1/4 dessa memória, e o heap inicial é 1/64.
Isso resulta em uma tabela simples:
| Limite de CPU | Limite de memória | CPUs que a JVM enxerga | Coletor que a JVM seleciona |
|---|---|---|---|
| 1 (ou 500m) | 2Gi | 1 | Serial |
| 1100m | 2Gi | 2 | G1 |
| 2 | 1Gi | 2 | Serial (memória abaixo de 1792 MB) |
| 2 | 2Gi | 2 | G1 |
| Sem limite | Qualquer | Todas as CPUs do node | G1 em um node típico, com muitas threads de GC |
É por isso que um limite de CPU de 1 e um de 1100m podem se comportar de forma diferente, mesmo que a diferença pareça mínima. A JVM também dimensiona suas threads de trabalho de GC a partir da contagem de CPUs, então a mesma especificação de pod pode mostrar comportamentos de GC diferentes com limits diferentes. O efeito passa despercebido com facilidade: nenhum evento é gerado e os logs do pod não mostram nada, a menos que o logging de GC esteja ativado.
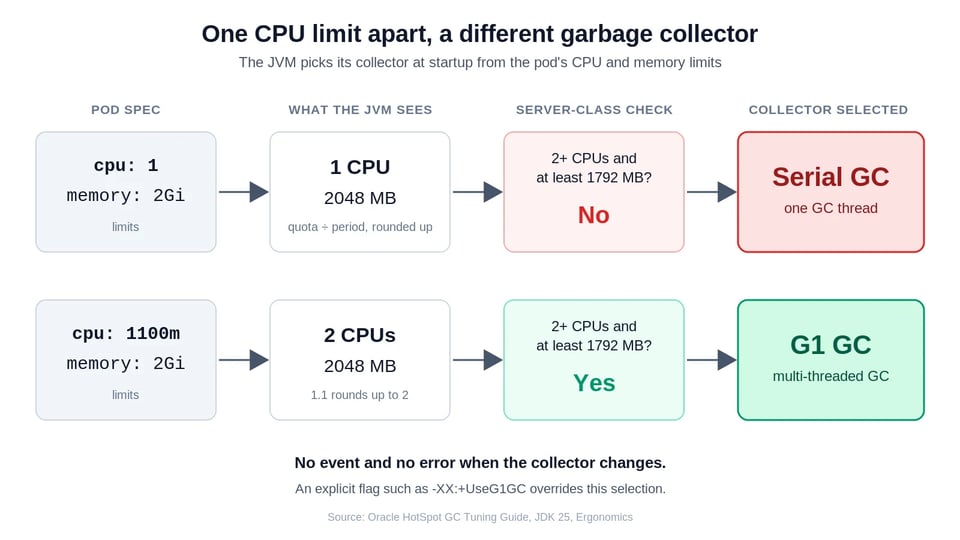
Uma flag explícita sempre vence. Se você definir -XX:+UseG1GC ou -XX:+UseSerialGC, a JVM usa essa flag independentemente do tamanho do container. Uma proposta em rascunho do OpenJDK (JEP draft 8359802) tornaria o G1 o padrão até em deployments pequenos. Ainda é um rascunho, então não conte com isso. Defina o coletor explicitamente se quiser o mesmo comportamento em todas as versões do JDK e tamanhos de pod.
O limite de CPU também afeta como o coletor roda. As threads concorrentes de GC compartilham a quota de CPU do container com as threads da sua aplicação. Quando a quota acaba, o kernel pausa todas elas, inclusive o coletor. Veja Kubernetes CPU limits para entender como essa quota funciona e Kubernetes CPU throttling para saber como detectá-la.
G1 vs ZGC vs Shenandoah vs Parallel vs Serial: qual a diferença entre os garbage collectors do Java?
O HotSpot traz cinco coletores que você pode escolher com uma única flag. Cada um faz trade-offs diferentes entre throughput, tempo de pausa e footprint.
| Coletor | Flag | Como funciona | Indicado para | Fique de olho em |
|---|---|---|---|---|
| Serial | -XX:+UseSerialGC |
Uma thread de GC, stop-the-world | Pods com 1 CPU e heap pequeno | Pausas longas conforme o heap cresce |
| Parallel | -XX:+UseParallelGC |
Várias threads de GC, stop-the-world | Jobs batch e workloads focados em throughput | Pausas crescem com o tamanho do heap |
| G1 | -XX:+UseG1GC |
Baseado em regiões, majoritariamente concorrente, trabalha com uma meta de pausa | Maioria dos serviços: o padrão equilibrado | Precisa de CPU sobrando para suas threads concorrentes |
| ZGC | -XX:+UseZGC |
Concorrente, geracional desde o JDK 23, pausas muito baixas | Serviços sensíveis a latência com heaps maiores | Custo de CPU e memória maior que o do G1 |
| Shenandoah | -XX:+UseShenandoahGC |
Compactação concorrente, pausas baixas | Serviços sensíveis a latência em builds do OpenJDK que o incluem | Não está em todos os builds de fornecedores; o modo geracional só é recurso de produto a partir do JDK 25 |
Três observações de versão importam se você está escolhendo hoje:
- O ZGC é geracional por padrão desde o JDK 23 (JEP 474). O JDK 24 removeu o modo não geracional (JEP 490), então
-XX:+UseZGCagora sempre significa ZGC geracional. - O Shenandoah geracional virou recurso de produto no JDK 25 (JEP 521). O Shenandoah ainda usa uma única geração por padrão.
- O G1 é o padrão em máquinas server-class desde o JDK 9.
Os coletores de baixa pausa fazem mais trabalho de forma concorrente e, por isso, usam mais CPU e memória para dar conta. Em um pod com limite de CPU apertado, esse trabalho extra compete com a sua aplicação. É o principal motivo pelo qual ZGC e Shenandoah costumam ser uma má escolha para pods pequenos — e por que você deve medir antes de trocar.
Qual garbage collector usar no seu pod?
Comece pelo tamanho do pod e pelo workload, depois confirme com logs de GC e números de latência do seu próprio serviço. Estes são pontos de partida, não benchmarks.
| Pod e workload | Comece com | Por quê |
|---|---|---|
| Menos de 2 CPUs ou menos de cerca de 1,75 GiB, heap pequeno | Serial, ou G1 como escolha deliberada | Esta é a faixa em que a JVM seleciona o Serial por conta própria. Defina a flag explicitamente para que a escolha seja sua. |
| 2 ou mais CPUs, serviço web ou API típico | G1 | Equilíbrio entre throughput e tempo de pausa, e é o padrão da JVM para esse tamanho. |
| Batch, ETL ou processamento offline em que pausas não importam | Parallel | Maximiza o throughput quando nenhum usuário espera por uma resposta. |
| Serviço sensível a latência de cauda, com heap maior e folga de CPU | ZGC e, depois, Shenandoah se o seu JDK o incluir | A coleta concorrente mantém as pausas baixas, a um custo de CPU e memória. |
| Limite de CPU abaixo do que o coletor precisa | Aumente o limite ou escolha um coletor mais leve | Um coletor concorrente sob throttling pode pausar por mais tempo do que o G1 pausaria. |
Duas regras ajudam na prática. Primeira: mude uma coisa de cada vez — trocar o coletor e o tamanho do heap juntos esconde qual mudança ajudou. Segunda: decida com dados. Compare latência p99, tempo de GC, throttling de CPU e working set de memória antes e depois, sob carga realista.
Uma troca de coletor também é uma mudança de dimensionamento. Um coletor de baixa pausa pode precisar de mais CPU e mais memória do que o G1 para o mesmo serviço, então um pod dimensionado para o G1 pode precisar de novos requests e limits após a troca. Para entender como requests e limits interagem, veja Kubernetes resource limits vs requests.
Qual a relação entre garbage collection, OOMKilled e limites de memória do container?
O GC trabalha dentro do heap. O limite de memória do container cobre o processo inteiro. As duas falhas parecem similares, mas têm causas diferentes:
| Falha | Quem dispara | O que significa | Primeira correção |
|---|---|---|---|
java.lang.OutOfMemoryError: Java heap space |
A JVM | O heap atingiu -Xmx e o GC não conseguiu liberar o suficiente |
Encontre o vazamento ou aumente o heap |
| OOMKilled (exit code 137) | O kernel, via cgroup | A memória total do processo ultrapassou o limite do container | Deixe mais espaço fora do heap, ou aumente o limite |
O heap é só uma parte do que a JVM usa. O processo também mantém metaspace, pilhas de threads, o cache de código do JIT, buffers diretos e as estruturas nativas do próprio coletor. Os coletores diferem nessa última parte, então trocar de coletor pode alterar a memória total mesmo com o -Xmx inalterado.
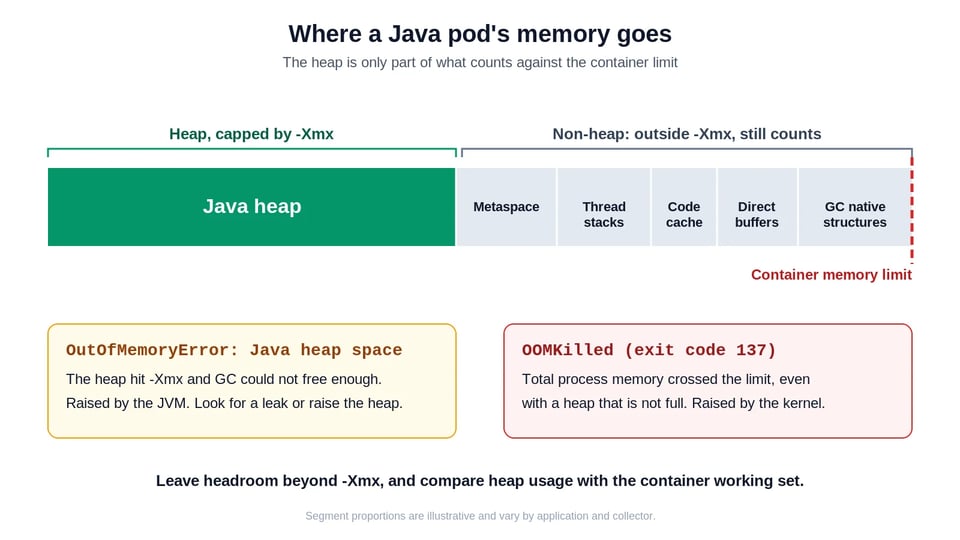
O heap máximo padrão é 1/4 da memória do container, o que frequentemente desperdiça memória. Muitos times o aumentam com -XX:MaxRAMPercentage, geralmente começando entre 50% e 70% e ajustando a partir do uso medido de memória fora do heap. Trate essa faixa como ponto de partida: um serviço com muitas threads ou uso intenso de buffers diretos precisa de mais folga.
Para uma abordagem de heap fixo (-Xms igual a -Xmx) e mais configurações da JVM que levam o container em conta, veja 5 Strategies to Optimize Java in 2026.
Duas flags facilitam o diagnóstico de falhas:
-XX:+ExitOnOutOfMemoryError-XX:+HeapDumpOnOutOfMemoryErrorA primeira faz a JVM encerrar em um OOM de heap, de modo que o Kubernetes reinicie o pod de forma limpa em vez de deixar um processo funcionando pela metade. A segunda grava um heap dump que você pode inspecionar. Mantenha o caminho do dump em um volume que sobreviva ao restart. Para o lado Kubernetes dessa falha, veja OOMKilled.
Como ver o que o garbage collector da sua JVM está fazendo?
Verifique três coisas: qual coletor está rodando, quanto o GC custa e se o container está sofrendo throttling.
Qual coletor e contagem de CPUs a JVM escolheu
kubectl exec <pod-name> -- jcmd 1 VM.flags -all \ | grep -E 'UseSerialGC|UseG1GC|UseZGC|UseParallelGC|ParallelGCThreads|ConcGCThreads'Isso exige o jcmd na imagem e a JVM rodando como processo 1. Uma imagem só com JRE não inclui o jcmd.
Logs de GC
Ative o logging unificado de GC com uma variável de ambiente e leia as linhas de pausa:
env: - name: JAVA_TOOL_OPTIONS value: "-Xlog:gc*:stdout:time,uptime"Observe com que frequência as coletas da geração jovem rodam, quanto duram as pausas e se aparecem coletas completas. Coletas completas frequentes significam que o heap é pequeno demais para os dados vivos.
Métricas que merecem alerta
Se você usa Micrometer ou o Prometheus JMX exporter, estas métricas mostram o custo do GC ao longo do tempo:
| Sinal | Métrica de exemplo | O que caracteriza um valor ruim |
|---|---|---|
| Tempo de pausa de GC | jvm_gc_pause_seconds_sum |
Parcela crescente do tempo total gasta em GC |
| Heap em uso | jvm_memory_used_bytes{area="heap"} |
Permanece perto do máximo após as coletas |
| Memória do container | container_memory_working_set_bytes |
Se aproxima do limite de memória |
| Throttling de CPU | container_cpu_cfs_throttled_periods_total sobre container_cpu_cfs_periods_total |
Alta proporção de períodos sob throttling enquanto o GC roda |
Leia as linhas de heap e de memória do container em conjunto. Heap bem abaixo do limite com o working set perto do limite aponta para memória fora do heap, não para o coletor. Uma alta proporção de throttling durante o GC aponta para um limite de CPU apertado demais para o coletor que você escolheu.
A pressão de GC e de CPU costuma atingir o pico nos primeiros segundos após o pod iniciar e depois some dos dashboards de cinco minutos. Para capturar esses picos, veja como detectar picos de startup no Kubernetes.
Quais flags da JVM adaptam o garbage collection ao container?
A JVM lê os limites do container por padrão (-XX:+UseContainerSupport). Estas flags tornam o resultado explícito e reproduzível:
| Flag | O que faz | Quando definir |
|---|---|---|
-XX:+UseG1GC (ou outro coletor) |
Fixa o coletor | Sempre, para que mudanças no tamanho do pod não o troquem |
-XX:MaxRAMPercentage=<n> |
Define o heap máximo como fração da memória do container | Quando o padrão de 25% deixa memória sem uso |
-XX:ActiveProcessorCount=<n> |
Sobrescreve a contagem de CPUs detectada | Quando você quer as mesmas contagens de threads em todos os ambientes |
-XX:ParallelGCThreads=<n> |
Define as threads de trabalho de GC stop-the-world | Quando o padrão derivado da CPU é alto demais para um pod sob throttling |
-XX:ConcGCThreads=<n> |
Define as threads de trabalho de GC concorrentes | Quando o GC concorrente compete com a aplicação por CPU |
-XX:MaxGCPauseMillis=<n> |
Define uma meta de tempo de pausa para o G1 | Só depois de ter medido as pausas |
-Xlog:gc* |
Ativa o logging de GC | Sempre em produção |
Um conjunto inicial para um pod de API típico com 2 CPUs e 2 GiB de memória fica assim:
env: - name: JAVA_TOOL_OPTIONS value: >- -XX:+UseG1GC -XX:MaxRAMPercentage=65 -XX:+ExitOnOutOfMemoryError -Xlog:gc*:stdout:time,uptimeO valor 65 é um ponto de partida, não uma recomendação para todo serviço. Meça primeiro o footprint fora do heap e então ajuste. Evite copiar conjuntos grandes de flags de tuning de posts antigos. Os padrões mudaram entre as versões do JDK, e flags extras muitas vezes tornam o comportamento do GC mais difícil de entender.
Como a PerfectScale ajuda a fazer right-sizing de workloads Java
Configurações de GC, tamanho do heap e os requests e limits do pod afetam uns aos outros. Mudar um sem mudar os outros é o que leva times a acabar com pods sob throttling ou restarts por OOMKilled. A PerfectScale mostra esses sinais em conjunto.
Para containers Java, a PerfectScale coleta dados de heap, de memória fora do heap e de garbage collection. Ela mostra o tempo de GC, a contagem de processadores ativos e o tipo de GC, para que você veja qual coletor cada workload roda e quanto ele custa. Você pode ativar a coleta de métricas de JVM ao instalar o agente da PerfectScale. Há suporte apenas para nodes Linux.
A PerfectScale também respeita as configurações da sua JVM. Quando você define um tamanho máximo ou mínimo de heap, a PerfectScale não aplica uma recomendação que fique fora desse intervalo. Para redimensionar pods sem restarts, veja in-place right-sizing e o Vertical Pod Autoscaler.

Workshop: Java on K8s: The Startup vs. Steady-State Sizing Dilemma. Vikram Seshadri, da DoiT, mostra o pico de boot da JVM, quanto ele custa em throttling, OOM kills e requests superdimensionados, e como dimensionar pods para o steady state com um resize in-place e sem restart. 28/10/2026, às 11h (horário do leste dos EUA, ET). Garanta sua vaga.
Quer ver como a PerfectScale faz o right-sizing dos seus workloads Java? Comece grátis ou agende uma demo.
Perguntas frequentes
Qual é o garbage collector padrão do Java? O G1 em uma máquina server-class, ou seja, com 2 ou mais processadores e pelo menos 1792 MB de memória. Caso contrário, a JVM seleciona o Serial. Em um container, a JVM lê o limite de CPU e o limite de memória para decidir.
Qual é o melhor garbage collector do Java? Nenhum coletor vence em todos os cenários. O G1 é o melhor ponto de partida para a maioria dos serviços. O Parallel se encaixa em trabalho batch, e ZGC ou Shenandoah atendem serviços sensíveis a latência com folga de CPU e memória.
O Java faz garbage collection automático? Sim. A JVM encontra objetos sem uso e libera a memória deles sem chamadas do desenvolvedor. Você faz o ajuste com a escolha do coletor, o tamanho do heap e as flags de GC.
Como funciona o garbage collection no Java? O coletor encontra objetos que a aplicação não consegue mais alcançar, libera a memória deles e, muitas vezes, compacta o que sobra. A maioria dos coletores divide o heap em gerações jovem e velha, porque a maioria dos objetos morre jovem.
O ZGC é melhor que o G1? O ZGC mira pausas menores e paga por isso com mais CPU e memória. Ele tende a ajudar mais em heaps maiores com CPU sobrando. Em pods pequenos, o G1 costuma ser a escolha mais segura. Teste com o seu próprio tráfego.
Por que meu pod Java recebe OOMKilled se o heap não está cheio?
O limite do container cobre metaspace, pilhas de threads, cache de código, buffers diretos e estruturas do coletor, além do heap. Deixe folga além de -Xmx e compare o uso do heap com o working set do container.
Um limite de CPU afeta o garbage collection do Java? Sim, de duas formas. O limite define a contagem de CPUs que a JVM usa para dimensionar as threads de GC e, junto com a memória, para escolher o coletor. Ele também restringe a CPU que as threads de GC e as da aplicação compartilham, então o throttling pausa as duas.
Leitura relacionada
- 5 Strategies to Optimize Java in 2026: configurações de heap, CPU e GC que levam o container em conta
- JVM startup CPU throttling: por que a JVM precisa de mais CPU nos primeiros segundos
- Detect Kubernetes startup spikes: encontre o throttling e os OOM kills que os dashboards escondem
- Fix Kubernetes resource policies that optimize for the wrong phase: quotas e LimitRanges para startup vs steady state
- How to fix OOMKilled in Kubernetes
- Kubernetes CPU throttling
- Kubernetes CPU limits
- Kubernetes resource limits vs requests
- We can resize pods without restarts! Or can't we?
- Kubernetes Vertical Pod Autoscaler (VPA)
- Kubernetes Horizontal Pod Autoscaler (HPA)