


TL;DR
- デフォルト: Kubernetes上のほとんどのJavaサービスでは、G1が最初に選ぶべきコレクタです。
- 境界値: JVMがG1を選択するのは、CPUが2以上かつメモリが1792 MB以上の場合のみ。それ未満では、何の通知もなくSerialが選択されます。
- 明示的に指定する: CPUやメモリ制限の変更でコレクタが切り替わらないよう、フラグで固定しましょう。
- Podサイズで選ぶ: 一般的なサービスにはG1、バッチにはParallel、CPUとメモリに余裕があるレイテンシ重視のサービスにはZGCまたはShenandoah。
- メモリ: ヒープはプロセスの一部にすぎません。
-Xmxの外側に余裕を確保しておかないと、ヒープが満杯でなくてもPodはOOMKilledになります。
Kubernetes上のほとんどのJavaサービスにとって、G1は適切なガベージコレクタです。ただし、JVMが自動的にG1を選択するのは、Podに2以上のCPUと約1.75 GBのメモリがある場合に限られます。それ未満では、JVMは何の通知もなくSerialコレクタにフォールバックします。つまり、CPU制限のわずかな変更がサービスのガベージコレクション方式を変えてしまう可能性があり、その際に誰にもアラートは届きません。
本記事では、Javaのガベージコレクションの役割、JVMがコンテナの制限値からコレクタを選択する仕組み、G1・ZGC・Shenandoah・Parallel・Serialの違い、そしてPodサイズごとにどれを使うべきかを解説します。また、現在のJVMの動作を確認する方法や、GC設定がOOMKilledやCPUスロットリングとどう関係するかも紹介します。
JavaのPodが起動時に再起動やスロットリングを起こしている場合は、まずJVM起動時のCPUスロットリングをお読みください。本記事では同じ問題の定常状態側を扱います。
実際の動作を見てみたい方は、2026年10月28日 午前11時(米国東部時間)開催のハンズオンワークショップJava on K8s: The Startup vs. Steady-State Sizing Dilemmaにぜひご参加ください。
Javaのガベージコレクションとは?
Javaのガベージコレクションとは、アプリケーションが使わなくなったオブジェクトを見つけ、そのメモリを解放するJVMの自動プロセスです。開発者がfree()を呼ぶ必要はありません。アプリケーションの実行中に、コレクタがその作業を行います。
ほとんどのコレクタは世代仮説、つまり「ほとんどのオブジェクトは短命である」という前提に基づいています。ヒープは、新しいオブジェクトが最初に置かれるYoung世代と、長寿命のオブジェクトが移されるOld世代に分かれています。Young世代のコレクションは頻繁に実行されますが、コストは小さく済みます。OldコレクションやFullコレクションはまれにしか発生しませんが、コストは大きくなります。
コストは2つの形で現れます。
- 一時停止時間。 一部のフェーズでは、すべてのアプリケーションスレッドが停止します(ストップ・ザ・ワールドの一時停止)。一時停止中に到着したリクエストは待たされ、テールレイテンシが悪化します。
- CPUオーバーヘッド。 コレクタのスレッドは、同じCPUをめぐってアプリケーションのスレッドと競合します。
コンテナでは、これらのコストはどちらもPod specで設定した制限値によって上限が決まります。CPU制限は、コレクタとアプリケーションが共有できるCPUの上限を定めます。メモリ制限は、ヒープを含むプロセス内のすべてがどこまで大きくなれるかを定めます。16コアのVMでは問題なく動くコレクタも、CPU 1個に制限されたPodではまったく異なる挙動を示すことがあります。
KubernetesでJVMはどのようにガベージコレクタを選ぶのか?
コレクタを指定しない場合、JVMは起動時に2つの数値、すなわち認識したCPU数と認識したメモリ量からコレクタを選択します。OracleのHotSpot GCチューニングガイドでは、プロセッサが2以上かつメモリが1792 MB以上のマシンをサーバークラスと定義しています。サーバークラスのマシンではJVMはG1を選択し、そうでなければSerialを選択します。
コンテナでは、JVMはこれらの数値をノードではなくcgroupから読み取ります。
- CPU数はCPU制限から得られます。JVMはクォータを期間で割って切り上げるため、1001mの制限は2 CPUとしてカウントされます。JDK 19以降、このカウントにCPUリクエスト(
cpu.shares)は使用されません。 - メモリはメモリ制限から得られます。デフォルトの最大ヒープはそのメモリの1/4、初期ヒープは1/64です。
これを表にすると次のようになります。
| CPU制限 | メモリ制限 | JVMが認識するCPU数 | JVMが選択するコレクタ |
|---|---|---|---|
| 1(または500m) | 2Gi | 1 | Serial |
| 1100m | 2Gi | 2 | G1 |
| 2 | 1Gi | 2 | Serial(メモリが1792 MB未満) |
| 2 | 2Gi | 2 | G1 |
| 制限なし | 任意 | ノード上の全CPU | 一般的なノードではG1(GCスレッド数は多くなる) |
これが、CPU制限1と1100mでは、差はごくわずかに見えても挙動が異なりうる理由です。JVMはGCワーカースレッド数もCPU数から決定するため、同じPod specでも制限値が異なればGCの挙動が変わることがあります。この影響は見落としやすいものです。イベントは発生せず、GCロギングが有効でない限りPodのログには何も記録されません。
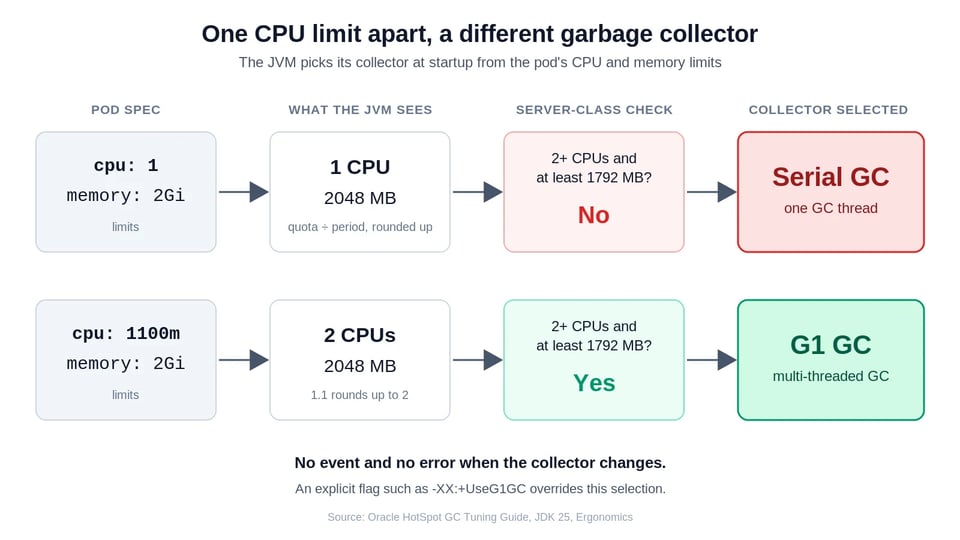
明示的なフラグは常に優先されます。-XX:+UseG1GCや-XX:+UseSerialGCを設定すれば、コンテナのサイズに関係なくJVMはそれを使用します。OpenJDKのドラフト提案(JEP draft 8359802)では、小規模なデプロイでもG1をデフォルトにすることが検討されていますが、まだドラフト段階のため、これを前提にするのは避けてください。JDKバージョンやPodサイズをまたいで同じ挙動を得たいなら、コレクタを明示的に設定しましょう。
CPU制限はコレクタの動作にも影響します。並行GCスレッドは、コンテナのCPUクォータをアプリケーションのスレッドと共有します。クォータを使い切ると、カーネルはコレクタを含むすべてのスレッドを一時停止させます。クォータの仕組みはKubernetesのCPU制限を、検出方法はKubernetes CPUスロットリングをご覧ください。
G1 vs ZGC vs Shenandoah vs Parallel vs Serial:各ガベージコレクタの比較
HotSpotには、フラグ1つで選択できる5つのコレクタが同梱されています。各コレクタは、スループット・一時停止時間・フットプリントの間でトレードオフの関係にあります。
| コレクタ | フラグ | 仕組み | 最適な用途 | 注意点 |
|---|---|---|---|---|
| Serial | -XX:+UseSerialGC |
GCスレッド1つ、ストップ・ザ・ワールド | CPU 1個・小さいヒープのPod | ヒープが大きくなると一時停止が長くなる |
| Parallel | -XX:+UseParallelGC |
複数のGCスレッド、ストップ・ザ・ワールド | バッチジョブやスループット優先のworkloads | 一時停止はヒープサイズとともに増大 |
| G1 | -XX:+UseG1GC |
リージョンベース、大部分が並行、一時停止目標に基づく | ほとんどのサービス:バランスの取れたデフォルト | 並行スレッド用に余剰CPUが必要 |
| ZGC | -XX:+UseZGC |
並行、JDK 23以降は世代別、非常に短い一時停止 | 大きめのヒープを持つレイテンシ重視のサービス | G1よりCPU・メモリのコストが高い |
| Shenandoah | -XX:+UseShenandoahGC |
並行コンパクション、短い一時停止 | Shenandoahを含むOpenJDKビルド上のレイテンシ重視のサービス | すべてのベンダービルドに含まれるわけではない。世代別モードはJDK 25からの正式機能 |
今選定するなら、3つのバージョンに関する注意点が重要です。
- ZGCはJDK 23以降、デフォルトで世代別です(JEP 474)。JDK 24で非世代別モードは削除されたため(JEP 490)、
-XX:+UseZGCは常に世代別ZGCを意味します。 - 世代別ShenandoahはJDK 25で正式機能になりました(JEP 521)。Shenandoahのデフォルトは依然として単一世代です。
- G1はサーバークラスのマシンにおけるデフォルトで、これはJDK 9から変わっていません。
一時停止の短いコレクタは、より多くの処理を並行して行うため、その分CPUとメモリを多く消費します。CPU制限が厳しいPodでは、この追加の処理がアプリケーションと競合します。これが、ZGCやShenandoahが小さいPodに不向きなことが多い主な理由であり、切り替える前に計測すべき理由でもあります。
Podにはどのガベージコレクタを使うべきか?
まずPodのサイズとworkloadから出発し、自サービスのGCログとレイテンシの数値で確認しましょう。以下はベンチマークではなく、あくまで出発点です。
| Podとworkload | まず試すべきもの | 理由 |
|---|---|---|
| 2 CPU未満または約1.75 GiB未満、小さいヒープ | Serial、または意図して選んだG1 | この範囲ではJVMが自動的にSerialを選択します。自分の意思による選択となるよう、フラグを明示的に設定しましょう。 |
| 2 CPU以上、一般的なWebまたはAPIサービス | G1 | スループットと一時停止時間のバランスが良く、このサイズではJVMのデフォルトでもあります。 |
| 一時停止が問題にならないバッチ、ETL、オフライン処理 | Parallel | 応答を待つユーザーがいない場合にスループットを最大化します。 |
| 大きめのヒープとCPU余裕のあるテールレイテンシ重視のサービス | ZGC、JDKに含まれていればShenandoahも | 並行コレクションにより一時停止を短く保てますが、CPUとメモリのコストがかかります。 |
| CPU制限がコレクタの必要量を下回る場合 | 制限を引き上げるか、より軽いコレクタを選ぶ | スロットリングされた並行コレクタは、G1より長く停止することがあります。 |
実践上は2つのルールが役立ちます。第一に、一度に変更するのは1つだけ。コレクタとヒープサイズを同時に変更すると、どちらの変更が効いたのか分からなくなります。第二に、データで判断すること。現実的な負荷の下で、変更前後のp99レイテンシ、GC時間、CPUスロットリング、メモリワーキングセットを比較しましょう。
コレクタの変更はサイジングの変更でもあります。一時停止の短いコレクタは、同じサービスでもG1よりCPUとメモリを多く必要とすることがあるため、G1向けにサイジングされたPodは、切り替え後に新しいリクエストと制限が必要になる場合があります。リクエストと制限の関係についてはKubernetesのリソース制限とリクエストの違いをご覧ください。
ガベージコレクションとOOMKilled・コンテナメモリ制限の関係は?
GCはヒープの内部で機能します。コンテナのメモリ制限はプロセス全体を対象とします。この2つの障害は似て見えますが、原因が異なります。
| 障害 | 発生源 | 意味 | 最初の対処 |
|---|---|---|---|
java.lang.OutOfMemoryError: Java heap space |
JVM | ヒープが-Xmxに達し、GCが十分に解放できなかった |
リークを特定するか、ヒープを増やす |
| OOMKilled(終了コード137) | cgroup経由のカーネル | プロセス全体のメモリがコンテナ制限を超えた | ヒープ外により多くの余裕を残すか、制限を引き上げる |
ヒープはJVMが使用するメモリの一部にすぎません。プロセスは他にも、メタスペース、スレッドスタック、JITコードキャッシュ、ダイレクトバッファ、そしてコレクタ自身のネイティブ構造体を保持しています。この最後の部分はコレクタによって異なるため、-Xmxが同じでも、コレクタを切り替えると合計メモリが変わることがあります。
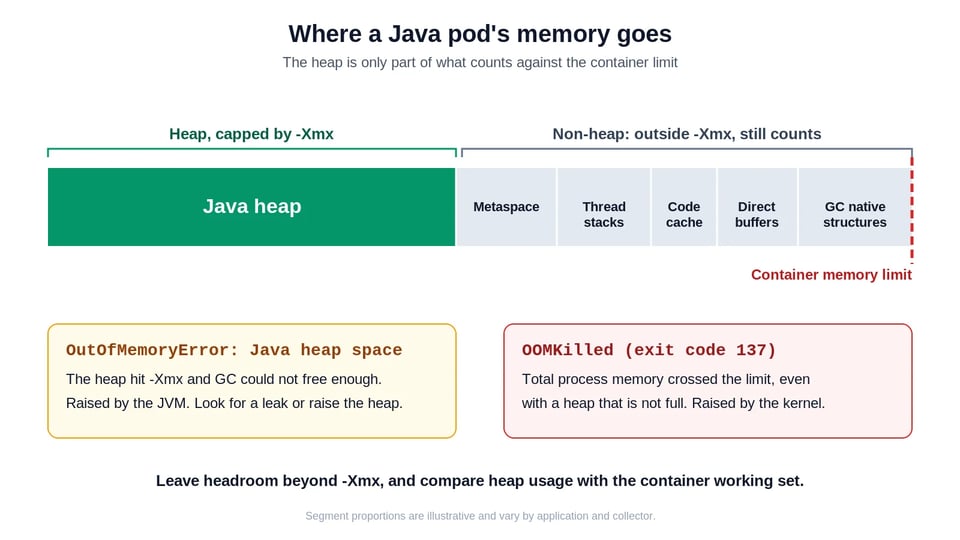
デフォルトの最大ヒープはコンテナメモリの1/4で、これはメモリを無駄にしがちです。多くのチームは-XX:MaxRAMPercentageで引き上げており、一般的には50〜70%の間から始めて、実測した非ヒープ使用量に応じて調整します。この範囲はあくまで出発点です。スレッド数が多いサービスやダイレクトバッファを多用するサービスでは、より多くの余裕が必要になります。
固定ヒープのアプローチ(-Xmsを-Xmxと同じにする)や、よりコンテナを意識したJVM設定については、2026年にJavaを最適化する5つの戦略をご覧ください。
障害の診断を容易にするフラグが2つあります。
-XX:+ExitOnOutOfMemoryError-XX:+HeapDumpOnOutOfMemoryError1つ目は、ヒープのOOM発生時にJVMを終了させるもので、中途半端な状態のプロセスを残すのではなく、KubernetesがPodをクリーンに再起動できるようにします。2つ目は、調査に使えるヒープダンプを書き出します。ダンプのパスは、再起動後も残るボリューム上に置いてください。この障害のKubernetes側の詳細はOOMKilledをご覧ください。
JVMのガベージコレクタの動作を確認するには?
確認すべきは3つです。どのコレクタが動いているか、GCのコストはどれくらいか、そしてコンテナがスロットリングされているか。
JVMが選択したコレクタとCPU数
kubectl exec <pod-name> -- jcmd 1 VM.flags -all \ | grep -E 'UseSerialGC|UseG1GC|UseZGC|UseParallelGC|ParallelGCThreads|ConcGCThreads'これには、イメージにjcmdが含まれていること、JVMがプロセス1として動作していることが必要です。JREのみのイメージにはjcmdは含まれません。
GCログ
環境変数で統合GCロギングを有効にし、一時停止の行を確認します。
env: - name: JAVA_TOOL_OPTIONS value: "-Xlog:gc*:stdout:time,uptime"Youngコレクションの頻度、一時停止の長さ、Fullコレクションの有無を確認しましょう。Fullコレクションが頻発している場合、ヒープがライブデータに対して小さすぎます。
アラートを設定すべきメトリクス
MicrometerやPrometheus JMX exporterを使っている場合、以下のメトリクスでGCコストの推移を把握できます。
| シグナル | メトリクスの例 | 悪い値の例 |
|---|---|---|
| GC一時停止時間 | jvm_gc_pause_seconds_sum |
GCに費やされる実時間の割合が上昇している |
| 使用中のヒープ | jvm_memory_used_bytes{area="heap"} |
コレクション後も最大値付近に留まっている |
| コンテナメモリ | container_memory_working_set_bytes |
メモリ制限に近づいている |
| CPUスロットリング | container_cpu_cfs_throttled_periods_total ÷ container_cpu_cfs_periods_total |
GC実行中にスロットリングされた期間の割合が高い |
ヒープとコンテナメモリの行はあわせて確認しましょう。ヒープが制限を大きく下回っているのにワーキングセットが制限に近い場合、原因はコレクタではなく非ヒープメモリです。GC中のスロットリング割合が高い場合は、選択したコレクタに対してCPU制限がきつすぎることを示しています。
GCとCPUの負荷は、多くの場合Pod起動直後の数秒間にピークを迎え、その後5分間隔のダッシュボードからは消えてしまいます。これを捕捉する方法はKubernetesの起動時スパイクを検出する方法をご覧ください。
ガベージコレクションをコンテナ対応にするJVMフラグは?
JVMはデフォルトでコンテナの制限値を読み取ります(-XX:+UseContainerSupport)。以下のフラグを使えば、その結果を明示的かつ再現可能にできます。
| フラグ | 機能 | 設定すべきタイミング |
|---|---|---|
-XX:+UseG1GC(または他のコレクタ) |
コレクタを固定する | 常に。Podサイズの変更で切り替わらないようにするため |
-XX:MaxRAMPercentage=<n> |
最大ヒープをコンテナメモリに対する割合で設定する | デフォルトの25%ではメモリが余るとき |
-XX:ActiveProcessorCount=<n> |
検出されたCPU数を上書きする | すべての環境で同じスレッド数にしたいとき |
-XX:ParallelGCThreads=<n> |
ストップ・ザ・ワールドGCのワーカースレッド数を設定する | CPU数由来のデフォルトが、スロットリングされるPodには多すぎるとき |
-XX:ConcGCThreads=<n> |
並行GCのワーカースレッド数を設定する | 並行GCがCPUをめぐってアプリケーションと競合するとき |
-XX:MaxGCPauseMillis=<n> |
G1の一時停止時間目標を設定する | 一時停止を実測した後にのみ |
-Xlog:gc* |
GCロギングを有効にする | 本番環境では常に |
2 CPU・2 GiBメモリの一般的なAPI Podの初期設定は、次のようになります。
env: - name: JAVA_TOOL_OPTIONS value: >- -XX:+UseG1GC -XX:MaxRAMPercentage=65 -XX:+ExitOnOutOfMemoryError -Xlog:gc*:stdout:time,uptime65という値は出発点であり、すべてのサービスへの推奨値ではありません。まず非ヒープのフットプリントを計測し、その後調整してください。古いブログ記事から大量のチューニングフラグをコピーするのは避けましょう。デフォルト値はJDKバージョンによって変わっており、余分なフラグはGCの挙動をかえって分かりにくくすることが多いためです。
PerfectScaleによるJava workloadsのライトサイジング
GC設定、ヒープサイズ、Podのリクエストと制限は互いに影響し合います。他を考慮せずに1つだけ変更すると、スロットリングされたPodやOOMKilledによる再起動につながります。PerfectScaleはこれらのシグナルをまとめて表示します。
Javaコンテナ向けに、PerfectScaleはヒープ、非ヒープ、ガベージコレクションのデータを収集します。GC時間、アクティブプロセッサ数、GCタイプが表示されるため、各workloadがどのコレクタを使い、どれだけのコストがかかっているかを把握できます。JVMメトリクスの収集は、PerfectScaleエージェントのインストール時に有効化できます。対応はLinuxノードのみです。
また、PerfectScaleはお客様のJVM設定を尊重します。最大または最小ヒープサイズを設定している場合、PerfectScaleはその範囲を超える推奨を適用しません。再起動なしでPodをリサイズする方法は、インプレースのライトサイジングとVertical Pod Autoscalerをご覧ください。

ワークショップ:Java on K8s: The Startup vs. Steady-State Sizing Dilemma。 DoiTのVikram Seshadriが、JVM起動時のスパイク、それがスロットリング・OOM kill・過剰なリクエスト設定にもたらすコスト、そして再起動なしのインプレースリサイズで定常状態向けにPodをサイジングする方法を解説します。2026年10月28日 午前11時(米国東部時間)開催。今すぐ席を確保。
PerfectScaleによるJava workloadsのライトサイジングを、実際に見てみませんか?無料で始めるまたはデモを予約するからどうぞ。
FAQ
Javaのデフォルトのガベージコレクタは何ですか? サーバークラスのマシン、つまりプロセッサが2以上かつメモリが1792 MB以上の場合はG1です。それ以外ではJVMはSerialを選択します。コンテナでは、JVMはCPU制限とメモリ制限を読み取って判断します。
Javaで最良のガベージコレクタはどれですか? あらゆる場面で勝るコレクタはありません。ほとんどのサービスにはG1が最良の出発点です。バッチ処理にはParallelが、CPUとメモリに余裕のあるレイテンシ重視のサービスにはZGCまたはShenandoahが適しています。
Javaは自動でガベージコレクションを行いますか? はい。JVMは開発者の呼び出しなしに、未使用のオブジェクトを見つけてメモリを解放します。コレクタの選択、ヒープサイズ、GCフラグでチューニングできます。
Javaのガベージコレクションはどのように動作しますか? コレクタは、アプリケーションから到達できなくなったオブジェクトを見つけてメモリを解放し、多くの場合、残ったものをコンパクションします。ほとんどのオブジェクトは短命であるため、大半のコレクタはヒープをYoung世代とOld世代に分けています。
ZGCはG1より優れていますか? ZGCはより短い一時停止を目指しており、その代償としてCPUとメモリを多く消費します。CPUに余裕のある大きめのヒープで最も効果を発揮する傾向があります。小さいPodでは、通常G1の方が安全な選択です。実際のトラフィックでテストしてください。
ヒープが満杯でないのに、JavaのPodがOOMKilledになるのはなぜですか?
コンテナの制限は、ヒープに加えてメタスペース、スレッドスタック、コードキャッシュ、ダイレクトバッファ、コレクタの構造体も対象とします。-Xmxの外側に余裕を確保し、ヒープ使用量とコンテナのワーキングセットを比較してください。
CPU制限はJavaのガベージコレクションに影響しますか? はい、2つの点で影響します。制限値は、JVMがGCスレッド数を決めるためのCPU数を定め、メモリと合わせてコレクタの選択にも使われます。また、GCスレッドとアプリケーションスレッドが共有するCPUの上限にもなるため、スロットリングが発生すると両者が停止します。
関連記事
- 2026年にJavaを最適化する5つの戦略:コンテナを意識したヒープ・CPU・GC設定
- JVM起動時のCPUスロットリング:JVMが起動直後の数秒間に最も多くのCPUを必要とする理由
- Kubernetesの起動時スパイクを検出する:ダッシュボードが隠すスロットリングとOOM killを見つける
- 誤ったフェーズに最適化されたKubernetesリソースポリシーを修正する:起動時と定常状態のためのクォータとLimitRange
- KubernetesのOOMKilledを解決する方法
- Kubernetes CPUスロットリング
- KubernetesのCPU制限
- Kubernetesのリソース制限とリクエストの違い
- 再起動なしでPodをリサイズできる!本当に?
- Kubernetes Vertical Pod Autoscaler(VPA)
- Kubernetes Horizontal Pod Autoscaler(HPA)