


Karpenter cambió la forma en que los equipos escalan nodos en AWS y, más tarde, en Azure. En lugar de administrar node pools fijos, puede aprovisionar máquinas del tamaño justo cuando se necesitan. Si ejecutas workloads en Google Cloud, quizás te preguntes si puedes hacer lo mismo con GKE. La respuesta honesta, en 2026, es que el soporte de Karpenter en GCP todavía está en una etapa temprana. No existe un proveedor oficial para GCP, y el proveedor de la comunidad disponible sigue en preview.
En esta guía aprenderás qué es Karpenter y por qué interesa a los equipos que usan GCP, cómo se compara con el autoscaling integrado de GKE, el estado actual del soporte de Karpenter en Google Cloud, cómo funciona el proveedor de la comunidad, cómo configurarlo para pruebas, sus limitaciones actuales y cómo mantener bajo control los costos de GKE, elijas el enfoque que elijas.
¿Qué es Karpenter y por qué lo quieren los equipos en GCP?
Karpenter es un autoscaler de nodos de código abierto. Detecta pods que no pueden programarse, encuentra la máquina más rentable capaz de ejecutarlos, aprovisiona el nodo y lo elimina cuando ya no se necesita.
En lugar de escalar grupos fijos de nodos idénticos, Karpenter aprovisiona nodos según la demanda real de los workloads. Este enfoque se conoce como autoscaling sin grupos (groupless).
Los equipos en GCP quieren Karpenter por las mismas razones por las que se volvió popular en AWS. Administrar node pools manualmente puede ser tedioso: eliges tipos de máquina por adelantado, creas pools distintos para distintos workloads y, muchas veces, sobreaprovisionas capacidad por precaución.
Karpenter reduce ese trabajo manual. Puede elegir tipos de máquina según la demanda del momento, empaquetar pods de forma eficiente, combinar capacidad Spot y on-demand, y consolidar nodos cuando baja la demanda. Esto puede traducirse en un escalado más rápido y costos más bajos.
Después de ver estos beneficios en EKS y AKS, es natural que los equipos quieran el mismo enfoque en GKE.
Karpenter vs. las opciones de autoscaling integradas de GKE
Antes de usar Karpenter, vale la pena entender lo que GKE ya ofrece. Estas funciones nativas están listas para producción y cubren muchos de los mismos casos de uso que Karpenter:
El Cluster Autoscaler de GKE es la base. En clústeres Standard, amplía o reduce tus node pools según los pods pendientes. Estos node pools están respaldados por Managed Instance Groups de Compute Engine. La principal limitación es que defines los node pools y los tipos de máquina por adelantado, así que igual tienes que decidir qué capacidad quieres usar.
El aprovisionamiento automático de nodos va un paso más allá. GKE puede crear y administrar node pools automáticamente según tus workloads pendientes, de modo que no tienes que definir cada pool tú mismo. Esto se acerca más a Karpenter, pero GKE sigue aprovisionando la capacidad a través de node pools en lugar de lanzar instancias individuales directamente.
Las custom compute classes con fallback por prioridad te dan otra opción. Puedes definir una lista priorizada de configuraciones de máquina, y GKE recorre la lista cuando la opción preferida no está disponible. Esto te permite priorizar capacidad más barata o Spot y recurrir a capacidad on-demand cuando haga falta, con parte de la flexibilidad de Karpenter usando funciones nativas de GKE.
GKE Autopilot elimina por completo la administración de nodos. Despliegas tus pods y Google aprovisiona y administra los nodos subyacentes. Se te factura según los recursos que solicitan tus pods. Para los equipos que no quieren administrar nodos, es la opción más sencilla.
La principal diferencia de Karpenter en GCP es su modelo sin grupos. Puede lanzar instancias directamente en lugar de depender de node pools predefinidos, que es el modelo que muchos equipos ya usan con Karpenter en EKS.
El trade-off es simple: las opciones de autoscaling nativas de GKE son maduras y cuentan con soporte para producción, mientras que Karpenter en GCP todavía está en una etapa temprana e impulsado por la comunidad. El resto de esta guía analiza qué significa eso en la práctica.
Estado actual del soporte de Karpenter en Google Cloud
Hoy, la única forma de ejecutar Karpenter en GCP es a través del proveedor de la comunidad, cloudpilot-ai/karpenter-provider-gcp. Fue iniciado y es desarrollado principalmente por CloudPilot AI, con contribuciones de la comunidad de código abierto, y el proyecto está bajo la licencia Apache 2.0.
Sin embargo, sigue siendo una versión en preview. Los mantenedores no lo recomiendan actualmente para uso en producción, aunque es funcional para pruebas y experimentación. Su API además sigue en v1alpha1, lo que significa que puede cambiar de formas que requieran ajustes de configuración entre versiones.
No existe un proveedor oficial de Karpenter para GCP. La organización kubernetes-sigs, que aloja los proyectos oficiales de Karpenter, no tiene un repositorio de proveedor para GCP, y Google no ha publicado uno. Por eso GKE sigue apoyándose en sus opciones de autoscaling nativas en lugar de Karpenter.
La diferencia entre las nubes es importante:
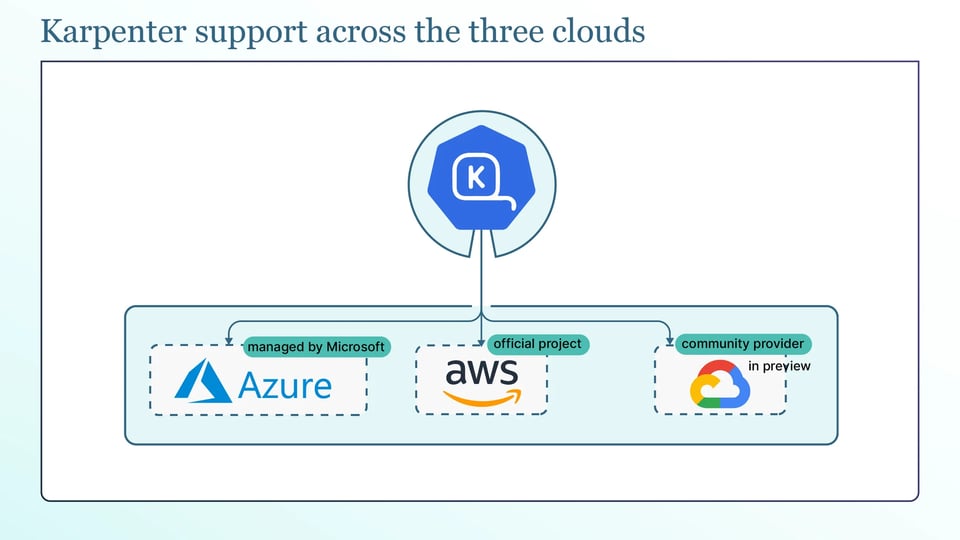
AWS: Karpenter es un proyecto oficial, con disponibilidad general, y se usa ampliamente para el aprovisionamiento de nodos en EKS.
Azure: el proveedor de Karpenter impulsa el Node Auto Provisioning de AKS, tiene disponibilidad general y lo administra Microsoft.
GCP: no hay un proveedor oficial ni administrado. La opción disponible es un proveedor de la comunidad que sigue en preview.
Así que la conclusión práctica es usar el proveedor de la comunidad para pruebas y experimentación, y usar las funciones de autoscaling nativas de GKE para los workloads de producción.
¿Cómo aprovisiona Karpenter los nodos en Compute Engine?
El proveedor de la comunidad sigue el mismo modelo básico de Karpenter que se usa en otras nubes, pero lo adapta a Compute Engine.
Empieza leyendo los pods no programables y sus restricciones de scheduling. Cuando el scheduler marca pods como no programables, Karpenter lee sus solicitudes de recursos, node selectors, afinidades, tolerations y reglas de topology spread para determinar qué tipo de nodo les permitiría ejecutarse.
A partir de ahí, selecciona un tipo de máquina del catálogo de Compute Engine. En lugar de limitarse a los tipos de máquina que elegiste por adelantado, considera el rango que permite tu configuración y elige uno que se ajuste a los pods pendientes al menor costo, empaquetando en el nodo tantos como quepan.
La parte específica de GCP es cómo se crea el nodo: Karpenter llama directamente a la API de Compute Engine para lanzar la máquina virtual, en lugar de redimensionar un Managed Instance Group. Este es el enfoque sin grupos, sin node pools que definir, solo reglas sobre lo que Karpenter puede crear, y luego une la nueva instancia a tu clúster de GKE.
Karpenter sigue trabajando después de que el nodo está en marcha. Consolida nodos subutilizados en menos máquinas cuando los workloads se reducen, detecta drift cuando un nodo ya no coincide con la configuración deseada y lo reemplaza, y puede hacer que los nodos expiren después de cierta antigüedad para que se reciclen con regularidad. En conjunto, esto mantiene el conjunto de nodos alineado con la demanda en lugar de derivar en pérdida.
Definiciones de recursos de Karpenter para GCP
El proveedor de GCP se configura con el mismo patrón de dos recursos que Karpenter usa en otras nubes, con una NodeClass específica de GCP. Veamos:
La GCENodeClass contiene la configuración de nodo específica de Google Cloud bajo el grupo de API karpenter.k8s.gcp. Aquí defines la imagen del nodo con imageSelectorTerms (por ejemplo, ContainerOptimizedOS@latest), el tamaño y tipo del disco de arranque bajo disks, la cuenta de servicio de Google que usa el nodo, y los ajustes de red y de kubelet como maxPods. Como la API sigue en v1alpha1, consulta la documentación del proveedor para conocer los campos admitidos actualmente.
apiVersion: karpenter.k8s.gcp/v1alpha1kind: GCENodeClassmetadata: name: defaultspec: serviceAccount: "karpenter-sa@my-project.iam.gserviceaccount.com" imageSelectorTerms: - alias: ContainerOptimizedOS@latest disks: - boot: true sizeGiB: 128 category: pd-balancedEl NodePool es el recurso upstream de Karpenter y define las reglas de lo que Karpenter puede aprovisionar. Sus requirements restringen las familias de máquinas, tamaños y arquitecturas que Karpenter puede elegir, sus limits ponen un tope al total de CPU y memoria que puede crear, y los taints te permiten reservar un pool para workloads específicos.
Hay dos ajustes importantes que conviene conocer: el tipo de capacidad y la configuración de disrupciones. El tipo de capacidad, definido con el requirement karpenter.sh/capacity-type, te permite habilitar VMs Spot, instancias on-demand o ambas, de modo que Karpenter pueda priorizar la capacidad Spot más barata y recurrir a on-demand como respaldo. Y la configuración de disrupciones controla el ciclo de vida: consolidationPolicy (WhenEmpty o WhenEmptyOrUnderutilized) decide qué tan agresivamente elimina o reempaqueta nodos, consolidateAfter define qué tan rápido actúa y expireAfter recicla los nodos después de cierta antigüedad.
Un NodePool se ve así:
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["on-demand", "spot"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: group: karpenter.k8s.gcp kind: GCENodeClass name: default limits: cpu: "100" disruption: consolidationPolicy: WhenEmptyOrUnderutilized consolidateAfter: 1m expireAfter: 720hConfigurar Karpenter en un clúster de GKE
Si quieres probar el proveedor, sigue estos pasos básicos. Debes usar un clúster de prueba, no producción. Manos a la obra:
Necesitas un clúster de GKE en funcionamiento y los accesos adecuados. Tienes que habilitar las APIs de Compute Engine en tu proyecto y asegurarte de contar con suficiente cuota de Compute Engine para las instancias que Karpenter creará, ya que los límites de cuota son una causa común de que el aprovisionamiento falle en silencio. Karpenter también necesita una cuenta de servicio de Google con permisos para crear instancias, discos y recursos relacionados.
Para la autenticación, prefiere Workload Identity en lugar de una clave de cuenta de servicio. Workload Identity vincula una cuenta de servicio de Kubernetes con una cuenta de servicio de Google, de modo que Karpenter se autentica sin un archivo de clave JSON de larga duración guardado en un secreto. La autenticación con clave de cuenta de servicio también funciona, pero un archivo de clave es una credencial que debes almacenar y rotar, y por eso Workload Identity es la mejor opción por defecto.
El proveedor se instala con su chart de Helm, apuntándolo a tu proyecto, ubicación y clúster, y conectando la cuenta de servicio:
helm upgrade --install karpenter charts/karpenter \ --namespace karpenter-system --create-namespace \ --set "controller.settings.projectID=${PROJECT_ID}" \ --set "controller.settings.region=${REGION}" \ --set "controller.settings.clusterName=${CLUSTER_NAME}" \ --set "serviceAccount.annotations.iam\.gke\.io/gcp-service-account=${KARPENTER_SA}" \ --waitCon el controlador en marcha, aplica una GCENodeClass y un NodePool, y luego verifica con un workload de prueba. Debes desplegar algo que no quepa en los nodos actuales para que los pods queden pendientes, y observar cómo Karpenter aprovisiona un nodo:
kubectl get nodeclaimskubectl get nodes -wDeberías ver que aparece un NodeClaim y que una nueva instancia de Compute Engine se une al clúster, lo que confirma que el proveedor funciona.
Limitaciones a considerar antes de usarlo en producción
Estas son las limitaciones importantes:
a. Carencias en GPU, TPU y reservas de Compute Engine: el soporte de GPU se ha corregido y ampliado activamente en versiones recientes, en lugar de ser algo estable desde hace tiempo; el soporte de TPU no es una prioridad; y no debes asumir que el consumo de descuentos por uso comprometido o de reservas funciona. Si tus workloads en GCP dependen de GPUs, TPUs o reservas, prueba con mucho cuidado o quédate con el autoscaling nativo de GKE.
b. Conflictos de scheduling multizona y de afinidad de PersistentVolume: la selección de zona ha sido un área activa de corrección de errores y, como con cualquier autoscaler sin grupos, un nodo aprovisionado en la zona equivocada para un disco persistente zonal deja al pod sin poder adjuntar su volumen. Deberías validar el comportamiento multizona específicamente para los workloads con estado y prestar atención a los PersistentVolumes que están anclados a una zona.
Además de esto, recuerda siempre que la API es v1alpha1, así que espera cambios incompatibles entre versiones, y que el soporte es solo de la comunidad, sin un SLA de proveedor detrás del proyecto de código abierto. Ambas son razones para mantenerlo fuera de producción por ahora.
¿Por qué el autoscaling de nodos por sí solo no reduce los costos de GKE?
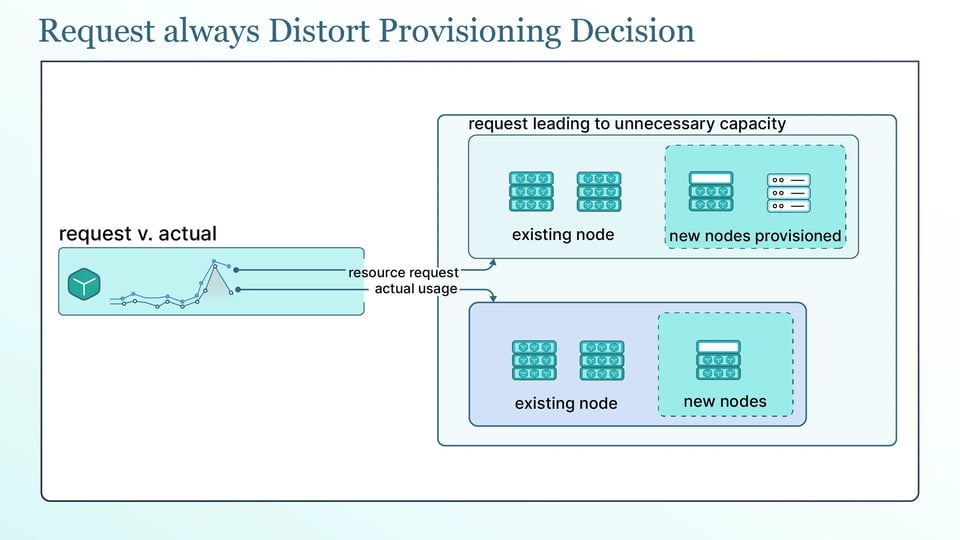
Todas las opciones mencionadas, Karpenter, el Cluster Autoscaler, el aprovisionamiento automático de nodos y Autopilot, toman decisiones de aprovisionamiento basadas en las solicitudes de recursos de los pods, no en cuánta CPU y memoria usan realmente.
Eso significa que las solicitudes excesivas pueden derivar en capacidad innecesaria. Si un pod solicita mucha más CPU y memoria de la que realmente usa, el autoscaler aprovisiona una máquina más grande para satisfacer esas solicitudes. Con Autopilot, además, se te factura directamente por los recursos solicitados. El autoscaler hace lo que le pediste; el problema es que las solicitudes son demasiado altas.
Por eso el right-sizing es un prerrequisito para un bin packing efectivo, no algo opcional. La principal ventaja de Karpenter es empaquetar pods de forma eficiente en los nodos más pequeños posibles, pero solo puede empaquetar según sus solicitudes.
Si esas solicitudes están sobredimensionadas, Karpenter reserva capacidad que los pods nunca usan. El resultado puede parecer eficiente mientras los nodos permanecen parcialmente ociosos. Primero ajusta bien las solicitudes a nivel de pod. Después, el autoscaler, uses el que uses, sí podrá entregar los ahorros que promete.
Mejores prácticas de autoscaling de nodos en GCP
Estas son las mejores prácticas que pueden ayudar a mantener el autoscaling de nodos seguro y eficiente en GKE, ya sea que uses el autoscaling de GKE o Karpenter:
a. Aplica right-sizing a las solicitudes de los pods antes de ajustar el autoscaler: como todo autoscaler trabaja a partir de las solicitudes, unas solicitudes precisas hacen más por el costo que cualquier ajuste del autoscaler. Primero corrige el dimensionamiento y luego ajusta.
b. Diversifica las familias de máquinas para sobrevivir a la interrupción de las Spot VMs: las Spot VMs son mucho más baratas, pero pueden reclamarse en cualquier momento. Deberías permitir varias familias y tamaños de máquina para que el autoscaler pueda reemplazar la capacidad interrumpida desde otro pool en lugar de quedarse esperando un solo tipo.
c. Separa los node pools por perfil de workload en lugar de por equipo: agrupa los nodos según lo que necesitan los workloads, por ejemplo de propósito general, intensivos en memoria o con GPU, en lugar de por el equipo propietario. Esto permite que el autoscaler empaquete workloads similares juntos y elija el tipo de máquina adecuado.
d. Define límites de CPU y memoria en cada node pool para poner un tope al gasto: ya sea un node pool de GKE o un NodePool de Karpenter, define límites para que un workload mal configurado o fuera de control no pueda aprovisionar capacidad y generar costos sin límite.
e. Usa PodDisruptionBudgets para proteger los servicios con estado durante la consolidación: la consolidación mueve pods para empaquetarlos en menos nodos. Un PodDisruptionBudget limita cuántos pods de un servicio pueden estar no disponibles a la vez, de modo que la consolidación no deje un workload con estado por debajo de un número seguro de réplicas.
f. Monitorea continuamente la utilización de los nodos y la latencia de aprovisionamiento: debes vigilar qué tan cargados están realmente tus nodos y cuánto tardan los nuevos nodos en estar listos. Una utilización baja apunta a solicitudes sobredimensionadas o a un empaquetado deficiente, y una latencia de aprovisionamiento creciente apunta a problemas de cuota o de capacidad.
Herramientas para optimizar el autoscaling de Kubernetes en GCP
El autoscaling te da capacidad flexible, pero las siguientes herramientas pueden ayudarte a usarla con más eficiencia:
a. PerfectScale ataca el problema del costo desde la raíz: las solicitudes de recursos de las que depende todo autoscaler. Su plataforma de gobernanza de Kubernetes analiza cómo los workloads usan realmente la CPU y la memoria y propone recomendaciones de right-sizing accionables y automatizadas que puedes aplicar de forma manual o autónoma. Con solicitudes más alineadas con el uso real, tu autoscaler de GKE puede aprovisionar la cantidad justa de capacidad y empaquetar los workloads con más eficiencia.
PerfectScale también ofrece visibilidad de costos con desgloses por clúster, namespace y workload, para que veas a dónde va tu gasto en Kubernetes. Equipos como Paramount Pictures y Creditas usan PerfectScale para mantener sus clústeres eficientes. Puedes probarlo o agendar una sesión técnica.
b. CloudPilot AI lidera el proveedor comunitario de Karpenter para GCP. Junto al proveedor de código abierto, ofrece optimización de costos administrada, automatización de confiabilidad y soporte de producción. Puede ser una opción para los equipos que quieren específicamente el modelo de Karpenter en GCP con un proveedor que respalde el despliegue.
c. Kubecost ofrece visibilidad de costos de Kubernetes desglosando el gasto por clúster, namespace, workload y etiqueta. Ayuda a los equipos a identificar la pérdida y entender a dónde va su presupuesto de Kubernetes.