


KarpenterはAWSで、その後Azureで、ノードのスケーリング方法を大きく変えました。固定のノードプールを管理する代わりに、必要なタイミングで適切なサイズのマシンをプロビジョニングできます。Google Cloud上でワークロードを運用しているなら、GKEでも同じことができるのか気になるかもしれません。率直に言えば、2026年時点でGCPにおけるKarpenterのサポートはまだ初期段階です。公式のGCPプロバイダーは存在せず、利用可能なコミュニティプロバイダーもまだプレビュー段階です。
本ガイドではこの後、Karpenterとは何か、なぜGCPのチームが注目しているのか、GKE標準のオートスケーリングとの比較、Google CloudにおけるKarpenterサポートの現状、コミュニティプロバイダーの仕組み、テスト用のセットアップ手順、現在の制限事項、そしてどちらのアプローチを選んでもGKEコストを抑える方法を解説します。
Karpenterとは何か、なぜGCPのチームが注目するのか
Karpenterはオープンソースのノードオートスケーラーです。スケジュールできないPodを監視し、それらを実行できる最もコスト効率の高いマシンを見つけてノードをプロビジョニングし、不要になったら削除します。
同一構成のノードを固定グループ単位でスケールするのではなく、Karpenterは実際のワークロード需要に基づいてノードをプロビジョニングします。このアプローチはグループレス・オートスケーリングと呼ばれます。
GCPのチームがKarpenterを求める理由は、AWSで人気を集めたのと同じです。ノードプールの手動管理は手間がかかります。マシンタイプを事前に選び、ワークロードごとに異なるプールを作成し、安全のために過剰なキャパシティを確保しがちです。
Karpenterはこうした手作業を減らします。現在の需要に応じてマシンタイプを選択し、Podを効率的に詰め込み、Spotとオンデマンドのキャパシティを組み合わせ、需要が減ればノードを統合します。その結果、スケーリングの高速化とコスト削減につながります。
EKSやAKSでこうしたメリットを実感したチームが、GKEでも同じアプローチを望むのは自然な流れです。
KarpenterとGKE標準のオートスケーリング機能の比較
Karpenterを使う前に、GKEが標準で提供している機能を理解しておく価値があります。これらのネイティブ機能は本番利用に対応しており、Karpenterと同様のユースケースの多くをカバーしています。
GKE Cluster Autoscalerは基本となる機能です。Standardクラスタでは、保留中のPodに応じてノードプールをスケールアップ/ダウンします。これらのノードプールはCompute Engineのマネージドインスタンスグループによって支えられています。主な制約は、ノードプールとマシンタイプを事前に定義する必要があるため、使用するキャパシティを自分で決めなければならない点です。
ノード自動プロビジョニングはさらに一歩進んだ機能です。GKEが保留中のワークロードに基づいてノードプールを自動的に作成・管理するため、すべてのプールを自分で定義する必要はありません。Karpenterに近いアプローチですが、GKEはインスタンスを直接起動するのではなく、あくまでノードプールを介してキャパシティをプロビジョニングします。
優先度ベースのフォールバックを備えたカスタムコンピューティングクラスも選択肢の一つです。マシン構成の優先順位付きリストを定義しておくと、優先する構成が利用できない場合にGKEがリストの下位へと順に切り替えます。これにより、安価なキャパシティやSpotを優先しつつ、必要に応じてオンデマンドにフォールバックでき、GKEネイティブ機能でKarpenterの柔軟性の一部を実現できます。
GKE Autopilotはノード管理を完全に不要にします。Podをデプロイすれば、Googleが基盤となるノードをプロビジョニングして管理します。課金はPodがリクエストしたリソースに基づきます。ノードを管理したくないチームにとっては、これが最も簡単な選択肢です。
GCPにおけるKarpenterの最大の違いは、グループレスモデルにあります。事前定義されたノードプールに頼らず、インスタンスを直接起動できます。これは多くのチームがEKS上のKarpenterですでに使っているモデルです。
トレードオフはシンプルです。GKEネイティブのオートスケーリングは成熟しており本番サポートがある一方、GCPのKarpenterはまだ初期段階でコミュニティ主導です。この後は、それが実際に何を意味するのかを見ていきます。
Google CloudにおけるKarpenterサポートの現状
現在、GCPでKarpenterを動かす唯一の方法は、コミュニティプロバイダーのcloudpilot-ai/karpenter-provider-gcpを使うことです。CloudPilot AIが立ち上げ、主体となって開発しており、オープンソースコミュニティからの貢献も受けています。プロジェクトはApache 2.0ライセンスで公開されています。
ただし、これはまだプレビューリリースです。テストや検証には利用できるものの、メンテナーは現時点で本番利用を推奨していません。APIもまだv1alpha1であり、バージョン間で設定変更が必要になるようなAPI変更が入る可能性があります。
GCP向けの公式Karpenterプロバイダーは存在しません。公式のKarpenterプロジェクトをホストするkubernetes-sigsオーガニゼーションにはGCPプロバイダーのリポジトリがなく、Googleもリリースしていません。GKEが今もKarpenterではなくネイティブのオートスケーリング機能を採用し続けているのはこのためです。
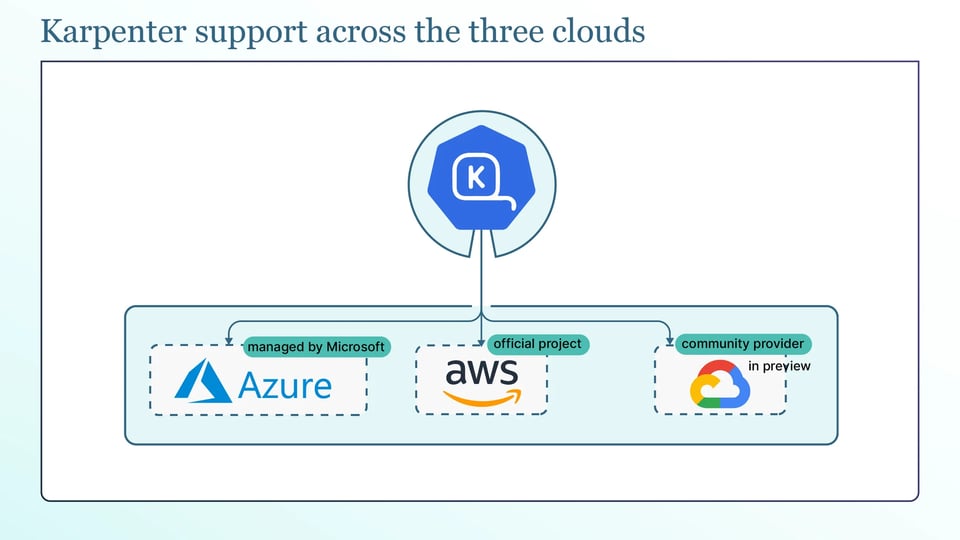
各クラウド間の違いは重要です:
AWS: Karpenterは公式プロジェクトとして一般提供されており、EKSでのノードプロビジョニングに広く使われています。
Azure: KarpenterプロバイダーはAKSのNode Auto Provisioningを支えており、一般提供されMicrosoftが管理しています。
GCP: 公式またはマネージドのプロバイダーは存在しません。利用可能なのは、まだプレビュー段階のコミュニティプロバイダーだけです。
つまり実務上の結論は、コミュニティプロバイダーはテストや検証に使い、本番ワークロードにはGKEネイティブのオートスケーリング機能を使う、ということです。
KarpenterはCompute Engine上でどのようにノードをプロビジョニングするのか
コミュニティプロバイダーは、他のクラウドで使われているKarpenterの基本モデルを踏襲しつつ、Compute Engineに適合させています。
まず、スケジュール不能なPodとそのスケジューリング制約を読み取ります。スケジューラーがPodをスケジュール不能とマークすると、Karpenterはそのリソースリクエスト、ノードセレクター、アフィニティ、toleration、トポロジー分散ルールを読み取り、どのようなノードであれば実行できるかを判断します。
次に、Compute Engineのカタログからマシンタイプを選択します。事前に選んだマシンタイプに限定されるのではなく、設定で許可された範囲を検討し、保留中のPodを最も低コストで収容できるものを選び、収まる限り多くのPodをそのノードに詰め込みます。
GCP固有なのはノードの作成方法です。Karpenterはマネージドインスタンスグループのサイズを変更するのではなく、Compute Engine APIを直接呼び出して仮想マシンを起動します。これがグループレスアプローチで、定義すべきノードプールはなく、Karpenterが作成してよいもののルールだけを定義します。その後、新しいインスタンスをGKEクラスタに参加させます。
ノードの起動後もKarpenterは働き続けます。ワークロードが縮小すると使用率の低いノードをより少ないマシンに統合し、ノードが望ましい構成と一致しなくなるとドリフトを検知して置き換え、設定した経過時間でノードを失効させて定期的に入れ替えることもできます。これらの機能により、ノード群は無駄に膨らむことなく需要に合った状態に保たれます。
KarpenterのGCPリソース定義
GCPプロバイダーの設定には、Karpenterが他のクラウドで使うのと同じ2つのリソースによるパターンを使い、GCP固有のNodeClassを組み合わせます。順に見ていきましょう。
GCENodeClassには、karpenter.k8s.gcp APIグループ配下のGoogle Cloud固有のノード設定が含まれます。imageSelectorTermsによるノードイメージの定義(例:ContainerOptimizedOS@latest)、disks配下のブートディスクのサイズとタイプ、ノードが使用するGoogleサービスアカウント、maxPodsなどのネットワークおよびkubelet設定をここで指定します。APIはまだv1alpha1のため、現在サポートされているフィールドはプロバイダーのドキュメントを確認してください。
apiVersion: karpenter.k8s.gcp/v1alpha1kind: GCENodeClassmetadata: name: defaultspec: serviceAccount: "karpenter-sa@my-project.iam.gserviceaccount.com" imageSelectorTerms: - alias: ContainerOptimizedOS@latest disks: - boot: true sizeGiB: 128 category: pd-balanced**NodePool**はアップストリームのKarpenterリソースで、Karpenterがプロビジョニングしてよいもののルールを定めます。requirementsはKarpenterが選択できるマシンファミリー、サイズ、アーキテクチャを制限し、limitsは作成できるCPUとメモリの合計に上限を設け、taintsによって特定のワークロード専用のプールを確保できます。
知っておくべき重要な設定が2つあります。キャパシティタイプと中断(disruption)設定です。キャパシティタイプはkarpenter.sh/capacity-typeのrequirementで設定し、Spot VM、オンデマンドインスタンス、またはその両方を許可できるため、Karpenterは安価なSpotキャパシティを優先しつつオンデマンドにフォールバックできます。中断設定はライフサイクルを制御します。consolidationPolicy(WhenEmptyまたはWhenEmptyOrUnderutilized)はノードの削除や再パッキングの積極性を決め、consolidateAfterは実行までの速さを設定し、expireAfterは一定の経過時間でノードを入れ替えます。
NodePoolは次のようになります:
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["on-demand", "spot"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: group: karpenter.k8s.gcp kind: GCENodeClass name: default limits: cpu: "100" disruption: consolidationPolicy: WhenEmptyOrUnderutilized consolidateAfter: 1m expireAfter: 720hGKEクラスタへのKarpenterのセットアップ
プロバイダーを試したい場合は、以下の基本手順に従ってください。本番環境ではなく、必ずテスト用クラスタを使用してください。それでは試してみましょう。
稼働中のGKEクラスタと適切なアクセス権が必要です。プロジェクトでCompute Engine APIを有効化し、Karpenterが作成するインスタンスに対して十分なCompute Engineクォータがあることを確認してください。クォータ制限は、気づかないうちにプロビジョニングが失敗するよくある原因です。また、Karpenterにはインスタンス、ディスク、関連リソースを作成できる権限を持つGoogleサービスアカウントが必要です。
認証には、サービスアカウントキーよりWorkload Identityを推奨します。Workload IdentityはKubernetesサービスアカウントをGoogleサービスアカウントに紐付けるため、長期間有効なJSONキーファイルをシークレットに置くことなくKarpenterを認証できます。サービスアカウントキーによる認証も動作しますが、キーファイルは保管とローテーションが必要な認証情報であり、Workload Identityがより望ましいデフォルトである理由はここにあります。
プロバイダーはHelmチャートでインストールし、プロジェクト、ロケーション、クラスタを指定してサービスアカウントを設定します:
helm upgrade --install karpenter charts/karpenter \ --namespace karpenter-system --create-namespace \ --set "controller.settings.projectID=${PROJECT_ID}" \ --set "controller.settings.region=${REGION}" \ --set "controller.settings.clusterName=${CLUSTER_NAME}" \ --set "serviceAccount.annotations.iam\.gke\.io/gcp-service-account=${KARPENTER_SA}" \ --waitコントローラーの起動後、GCENodeClassとNodePoolを適用し、テスト用ワークロードで動作を確認します。現在のノードに収まらないものをデプロイしてPodをPending状態にし、Karpenterがノードをプロビジョニングする様子を観察してください:
kubectl get nodeclaimskubectl get nodes -wNodeClaimが作成され、新しいCompute Engineインスタンスがクラスタに参加すれば、プロバイダーが正常に動作していることを確認できます。
本番利用の前に考慮すべき制限事項
重要な制限事項は以下のとおりです:
a. GPU、TPU、Compute Engine予約まわりの対応不足:GPUサポートは長らく安定しているというより、最近のリリースで活発に修正・拡張が続いている状況で、TPUサポートは注力対象ではなく、確約利用割引や予約を利用できると想定すべきでもありません。GCPのワークロードがGPU、TPU、予約に依存しているなら、慎重にテストするか、GKEネイティブのオートスケーリングを使い続けてください。
b. マルチゾーンスケジューリングとPersistentVolumeアフィニティの競合:ゾーン選択は活発にバグ修正が行われている領域であり、あらゆるグループレスオートスケーラーと同様、ゾーン永続ディスクに対して誤ったゾーンにノードがプロビジョニングされると、Podはボリュームをアタッチできなくなります。ステートフルなワークロードについては特にマルチゾーンの挙動を検証し、PersistentVolumeがどのゾーンに固定されているかに注意してください。
これらに加えて、APIがv1alpha1である以上、バージョン間の破壊的変更を想定すべきであり、サポートはコミュニティのみで、オープンソースプロバイダーの背後にベンダーSLAはありません。いずれも、現時点で本番投入を避けるべき理由です。
ノードオートスケーリングだけではGKEコストが下がらない理由
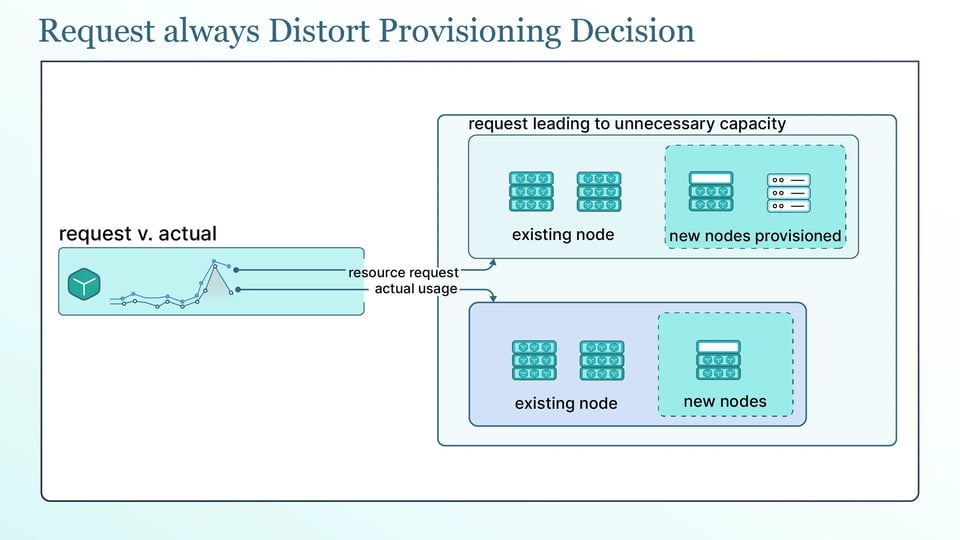
ここで挙げたすべての選択肢――Karpenter、Cluster Autoscaler、ノード自動プロビジョニング、Autopilot――は、Podが実際に使用しているCPUやメモリの量ではなく、Podのリソースリクエストに基づいてプロビジョニングを判断します。
つまり、過大なリクエストは不要なキャパシティにつながります。Podが実際の使用量よりはるかに多くのCPUとメモリをリクエストすると、オートスケーラーはそのリクエストを満たすために大きめのマシンをプロビジョニングします。Autopilotでは、リクエストしたリソースに対して直接課金もされます。オートスケーラーは指示どおりに動いているだけで、問題はリクエストが大きすぎることにあります。
だからこそ、ライトサイジングは効果的なビンパッキングの前提条件であり、省略できるものではありません。Karpenterの最大の強みは、Podを適切な最小サイズのノードに効率よく詰め込むことですが、詰め込みの基準にできるのはリクエストだけです。
リクエストが過大であれば、KarpenterはPodが決して使わないキャパシティを確保してしまいます。見かけ上は効率的でも、ノードの一部はアイドル状態のままです。まずPodレベルのリクエストを適正化しましょう。そうすれば、どのオートスケーラーを使っても、本来期待できる削減効果を実際に得られます。
GCPにおけるノードオートスケーリングのベストプラクティス
GKEのオートスケーリングを使う場合でもKarpenterを使う場合でも、GKEでのノードオートスケーリングを安全かつ効率的に保つためのベストプラクティスは以下のとおりです:
a. オートスケーラーをチューニングする前にPodリクエストをライトサイジングする:どのオートスケーラーもリクエストを基準に動くため、正確なリクエストはどんなオートスケーラー設定よりもコスト削減に効きます。まずサイジングを直し、それからチューニングしてください。
b. Spot VMのプリエンプションに備えてマシンファミリーを分散する:Spot VMは大幅に安価ですが、いつでも回収される可能性があります。複数のマシンファミリーとサイズを許可し、プリエンプトされたキャパシティを別のプールから補充できるようにして、特定のタイプを待ち続けて動けなくなる事態を防ぎましょう。
c. チーム別ではなくワークロードプロファイル別にノードプールを分ける:所有するチーム単位ではなく、汎用、メモリ集約型、GPUなど、ワークロードが必要とするもの単位でノードをグループ化してください。これにより、オートスケーラーは類似のワークロードをまとめて配置し、適切なマシン構成を選べます。
d. すべてのノードプールにCPUとメモリのlimitsを設定して支出に上限を設ける:GKEノードプールでもKarpenterのNodePoolでも、limitsを設定して、設定ミスや暴走したワークロードが無制限にキャパシティとコストを生み出せないようにしてください。
e. 統合(コンソリデーション)時のステートフルサービスをPodDisruptionBudgetで保護する:統合では、より少ないノードに詰め込むためにPodが移動されます。PodDisruptionBudgetはサービスのPodが同時に利用不能になる数に上限を設けるため、統合によってステートフルワークロードが安全なレプリカ数を下回ることを防げます。
f. ノード使用率とプロビジョニングのレイテンシを継続的に追跡する:ノードが実際にどれだけ使われて稼働しているか、新しいノードが準備完了になるまでどれだけ時間がかかるかを監視してください。使用率が低ければリクエストの過大設定やパッキングの不備が疑われ、プロビジョニングのレイテンシ増加はクォータやキャパシティの問題を示唆します。
GCPでKubernetesオートスケーリングを最適化するツール
オートスケーリングは柔軟なキャパシティをもたらしますが、以下のツールを使えばさらに効率的に活用できます。
a. PerfectScaleは、コスト問題の根本、つまりすべてのオートスケーラーが依存するリソースリクエストにアプローチします。そのKubernetesガバナンスプラットフォームは、ワークロードが実際にどのようにCPUとメモリを使っているかを分析し、手動でも自律的にも適用できる、実用的で自動化されたライトサイジングの推奨事項を提示します。リクエストが実際の使用量に近づくことで、GKEのオートスケーラーは適切な量のキャパシティをプロビジョニングし、ワークロードをより効率的に詰め込めるようになります。
PerfectScaleはまた、クラスタ、Namespace、ワークロード別の内訳によるコスト可視化も提供し、Kubernetesのコストがどこで発生しているかを把握するのに役立ちます。Paramount PicturesやCreditasといったチームがPerfectScaleを使ってクラスタの効率を維持しています。実際に試すことも、技術セッションを予約することもできます。
b. CloudPilot AIは、コミュニティ版GCP Karpenterプロバイダーを主導しています。オープンソースプロバイダーに加えて、マネージドのコスト最適化、信頼性の自動化、本番サポートを提供しています。ベンダーによるデプロイメント支援を受けながらGCPでKarpenterモデルを使いたいチームにとって、選択肢の一つとなり得ます。
c. Kubecostは、クラスタ、Namespace、ワークロード、ラベル別に支出を分解してKubernetesのコストを可視化します。無駄を特定し、Kubernetes予算がどこに使われているかを把握するのに役立ちます。