


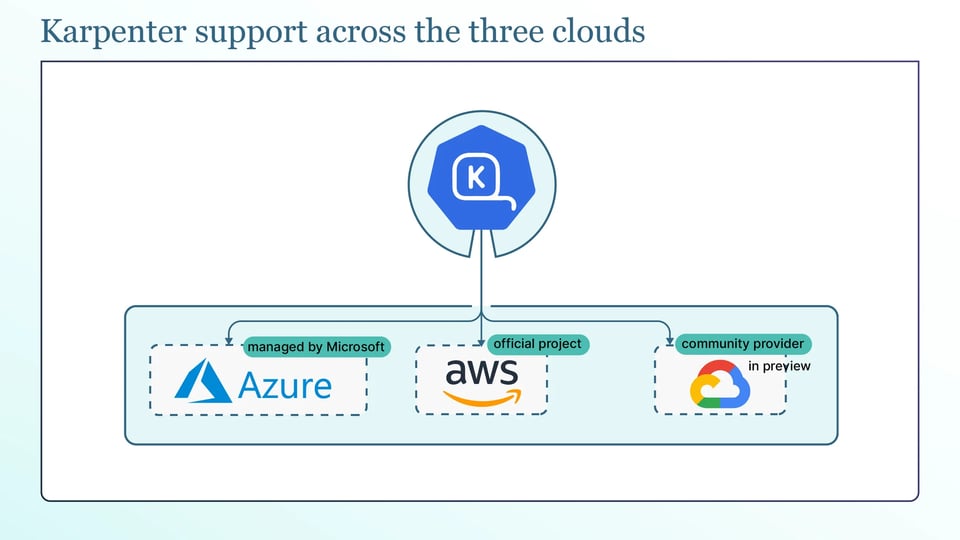
O Karpenter mudou a forma como as equipes escalam nós na AWS e, depois, no Azure. Em vez de gerenciar node pools fixos, ele consegue provisionar máquinas do tamanho certo no momento em que são necessárias. Se você roda workloads no Google Cloud, pode estar se perguntando se dá para fazer o mesmo com o GKE. A resposta honesta, em 2026, é que o suporte ao Karpenter no GCP ainda está no início. Não existe um provider oficial para GCP, e o provider da comunidade disponível ainda está em preview.
Neste guia, você vai entender o que é o Karpenter e por que equipes no GCP se interessam por ele, como ele se compara ao autoscaling nativo do GKE, o estado atual do suporte ao Karpenter no Google Cloud, como funciona o provider da comunidade, como configurá-lo para testes, suas limitações atuais e como manter os custos do GKE sob controle, seja qual for a abordagem escolhida.
O que é o Karpenter e por que equipes no GCP querem usá-lo?
O Karpenter é um autoscaler de nós open source. Ele monitora pods que não podem ser agendados, encontra a máquina mais econômica capaz de executá-los, provisiona o nó e o remove quando ele deixa de ser necessário.
Em vez de escalar grupos fixos de nós idênticos, o Karpenter provisiona nós com base na demanda real dos workloads. Essa abordagem é chamada de autoscaling groupless (sem grupos).
Equipes no GCP querem o Karpenter pelos mesmos motivos que o tornaram popular na AWS. Gerenciar node pools manualmente pode ser tedioso. Você escolhe tipos de máquina com antecedência, cria pools diferentes para workloads diferentes e, muitas vezes, superprovisiona capacidade por segurança.
O Karpenter reduz esse trabalho manual. Ele pode escolher tipos de máquina com base na demanda atual, empacotar pods de forma eficiente, misturar capacidade Spot e sob demanda e consolidar nós conforme a demanda cai. Isso pode resultar em escalonamento mais rápido e custos menores.
Depois de ver esses benefícios no EKS e no AKS, é natural que as equipes queiram a mesma abordagem no GKE.
Karpenter vs. as opções de autoscaling nativas do GKE
Antes de usar o Karpenter, vale entender o que o GKE já oferece. Esses recursos nativos estão prontos para produção e cobrem muitos dos mesmos casos de uso do Karpenter:
O GKE Cluster Autoscaler é a base. Em clusters Standard, ele escala seus node pools para cima ou para baixo com base nos pods pendentes. Esses node pools são baseados em Managed Instance Groups do Compute Engine. A principal limitação é que você define os node pools e os tipos de máquina com antecedência, então ainda precisa decidir qual capacidade quer usar.
O node auto-provisioning vai um passo além. O GKE pode criar e gerenciar node pools automaticamente com base nos seus workloads pendentes, assim você não precisa definir cada pool por conta própria. Isso se aproxima do Karpenter, mas o GKE ainda provisiona capacidade por meio de node pools, em vez de criar instâncias individuais diretamente.
As custom compute classes com fallback baseado em prioridade oferecem outra opção. Você pode definir uma lista priorizada de configurações de máquina, e o GKE passa para a próxima opção da lista quando a preferida não está disponível. Isso permite priorizar capacidade mais barata ou Spot e recorrer à capacidade sob demanda quando necessário, oferecendo parte da flexibilidade do Karpenter com recursos nativos do GKE.
O GKE Autopilot elimina completamente o gerenciamento de nós. Você faz o deploy dos seus pods, e o Google provisiona e gerencia os nós subjacentes. A cobrança é baseada nos recursos que seus pods solicitam. Para equipes que não querem gerenciar nós, essa é a opção mais fácil.
A principal diferença do Karpenter no GCP é seu modelo groupless. Ele pode criar instâncias diretamente, em vez de depender de node pools predefinidos, que é o modelo que muitas equipes já usam com o Karpenter no EKS.
O trade-off é simples: as opções de autoscaling nativas do GKE são maduras e têm suporte para produção, enquanto o Karpenter no GCP ainda está no início e é mantido pela comunidade. O restante deste guia analisa o que isso significa na prática.
Estado atual do suporte ao Karpenter no Google Cloud
A única forma de rodar o Karpenter no GCP hoje é pelo provider da comunidade, cloudpilot-ai/karpenter-provider-gcp. Ele foi iniciado e é desenvolvido principalmente pela CloudPilot AI, com contribuições da comunidade open source, e o projeto está sob a licença Apache 2.0.
No entanto, ainda é uma versão preview. Os mantenedores não recomendam seu uso em produção no momento, embora ele seja funcional para testes e experimentação. Sua API também ainda está em v1alpha1, o que significa que ela pode mudar de formas que exijam alterações de configuração entre versões.
Não existe um provider oficial do Karpenter para o GCP. A organização kubernetes-sigs, que hospeda os projetos oficiais do Karpenter, não tem um repositório de provider para GCP, e o Google não lançou nenhum. É por isso que o GKE continua contando com suas opções de autoscaling nativas em vez do Karpenter.
A diferença entre as nuvens é importante:
AWS: o Karpenter é um projeto oficial, em disponibilidade geral e amplamente usado para provisionamento de nós no EKS.
Azure: o provider do Karpenter é a base do Node Auto Provisioning do AKS, está em disponibilidade geral e é gerenciado pela Microsoft.
GCP: não há provider oficial nem gerenciado. A opção disponível é um provider da comunidade que ainda está em preview.
Portanto, a conclusão prática é usar o provider da comunidade para testes e experimentação e usar os recursos de autoscaling nativos do GKE para workloads de produção.
Como o Karpenter provisiona nós no Compute Engine?
O provider da comunidade segue o mesmo modelo básico do Karpenter usado em outras nuvens, mas o adapta ao Compute Engine.
Ele começa lendo os pods não agendáveis e suas restrições de agendamento. Quando o scheduler marca pods como não agendáveis, o Karpenter lê suas solicitações de recursos, node selectors, afinidades, tolerations e regras de topology spread para determinar que tipo de nó permitiria que eles rodassem.
A partir daí, ele seleciona um tipo de máquina do catálogo do Compute Engine. Em vez de ficar limitado a tipos de máquina escolhidos com antecedência, ele considera o intervalo permitido pela sua configuração e escolhe um que atenda aos pods pendentes pelo menor custo, empacotando no nó o máximo de pods que couberem.
A parte específica do GCP é a forma como o nó é criado: o Karpenter chama a API do Compute Engine diretamente para iniciar a máquina virtual, em vez de redimensionar um Managed Instance Group. Essa é a abordagem groupless, sem node pools para definir, apenas regras sobre o que o Karpenter pode criar; em seguida, ele adiciona a nova instância ao seu cluster GKE.
O Karpenter continua trabalhando depois que o nó está no ar. Ele consolida nós subutilizados em menos máquinas quando os workloads diminuem, detecta drift quando um nó deixa de corresponder à configuração desejada e o substitui, e pode expirar nós após uma idade definida para que sejam reciclados regularmente. Juntas, essas ações mantêm o conjunto de nós alinhado à demanda, em vez de acumular desperdício.
Definições de recursos do Karpenter no GCP
Você configura o provider do GCP usando o mesmo padrão de dois recursos que o Karpenter usa em outras nuvens, com um NodeClass específico do GCP. Vamos ver:
O GCENodeClass contém as configurações de nó específicas do Google Cloud sob o grupo de API karpenter.k8s.gcp. É aqui que você define a imagem do nó com imageSelectorTerms (por exemplo, ContainerOptimizedOS@latest), o tamanho e o tipo do disco de boot em disks, a service account do Google usada pelo nó e as configurações de rede e do kubelet, como maxPods. Como a API ainda está em v1alpha1, consulte a documentação do provider para ver os campos suportados atualmente.
apiVersion: karpenter.k8s.gcp/v1alpha1kind: GCENodeClassmetadata: name: defaultspec: serviceAccount: "karpenter-sa@my-project.iam.gserviceaccount.com" imageSelectorTerms: - alias: ContainerOptimizedOS@latest disks: - boot: true sizeGiB: 128 category: pd-balancedO NodePool é o recurso upstream do Karpenter e define as regras do que o Karpenter pode provisionar. Seus requirements restringem as famílias de máquinas, os tamanhos e as arquiteturas que o Karpenter pode escolher, seus limits limitam o total de CPU e memória que ele pode criar, e os taints permitem reservar um pool para workloads específicos.
Há duas configurações importantes a conhecer: o tipo de capacidade e as configurações de disruption. O tipo de capacidade, definido pelo requirement karpenter.sh/capacity-type, permite habilitar VMs spot, instâncias sob demanda ou ambas, para que o Karpenter possa priorizar capacidade spot mais barata e recorrer à sob demanda. E as configurações de disruption controlam o ciclo de vida: consolidationPolicy (WhenEmpty ou WhenEmptyOrUnderutilized) decide o quão agressivamente ele remove ou reempacota nós, consolidateAfter define a rapidez com que ele age, e expireAfter recicla nós após uma idade definida.
Um NodePool fica assim:
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["on-demand", "spot"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: group: karpenter.k8s.gcp kind: GCENodeClass name: default limits: cpu: "100" disruption: consolidationPolicy: WhenEmptyOrUnderutilized consolidateAfter: 1m expireAfter: 720hConfigurando o Karpenter em um cluster GKE
Se você quiser experimentar o provider, siga estes passos básicos. Use um cluster de teste, não o de produção. Vamos lá:
Você precisa de um cluster GKE em execução e dos acessos corretos. É necessário habilitar as APIs do Compute Engine no seu projeto e garantir que você tem cota suficiente no Compute Engine para as instâncias que o Karpenter vai criar, já que limites de cota são um motivo comum para o provisionamento falhar silenciosamente. O Karpenter também precisa de uma service account do Google com permissão para criar instâncias, discos e recursos relacionados.
Para autenticação, prefira o Workload Identity a uma chave de service account. O Workload Identity vincula uma service account do Kubernetes a uma service account do Google, então o Karpenter se autentica sem um arquivo de chave JSON de longa duração guardado em um secret. A autenticação com chave de service account também funciona, mas um arquivo de chave é uma credencial que você precisa armazenar e rotacionar, e é por isso que o Workload Identity é o melhor padrão.
O provider é instalado com seu Helm chart, apontando para o seu projeto, localização e cluster, e vinculando a service account:
helm upgrade --install karpenter charts/karpenter \ --namespace karpenter-system --create-namespace \ --set "controller.settings.projectID=${PROJECT_ID}" \ --set "controller.settings.region=${REGION}" \ --set "controller.settings.clusterName=${CLUSTER_NAME}" \ --set "serviceAccount.annotations.iam\.gke\.io/gcp-service-account=${KARPENTER_SA}" \ --waitCom o controller em execução, aplique um GCENodeClass e um NodePool e valide com um workload de teste. Faça o deploy de algo que não caiba nos nós atuais para que os pods fiquem pendentes e observe o Karpenter provisionar um nó:
kubectl get nodeclaimskubectl get nodes -wVocê deve ver um NodeClaim aparecer e uma nova instância do Compute Engine entrar no cluster, o que confirma que o provider está funcionando.
Limitações a considerar antes de usar em produção
Estas são as limitações mais importantes:
a. Lacunas em GPU, TPU e reservas do Compute Engine: o suporte a GPU vem sendo corrigido e ampliado ativamente nas versões recentes, em vez de ser algo consolidado há tempos, o suporte a TPU não é foco, e não dá para presumir que o consumo de descontos por compromisso de uso ou de reservas funcione. Se seus workloads no GCP dependem de GPUs, TPUs ou reservas, teste com muito cuidado ou permaneça no autoscaling nativo do GKE.
b. Conflitos entre agendamento multizona e afinidade de PersistentVolume: a seleção de zona tem sido uma área de correções ativas de bugs e, como acontece com qualquer autoscaler groupless, um nó provisionado na zona errada para um disco persistente zonal impede que o pod anexe seu volume. Você deve validar o comportamento multizona especificamente para workloads com estado e tomar cuidado com os PersistentVolumes fixados em uma zona.
Além disso, lembre-se sempre de que a API é v1alpha1, então espere mudanças incompatíveis entre versões, e o suporte é exclusivamente da comunidade, sem SLA de fornecedor por trás do provider open source. Ambos são motivos para mantê-lo fora da produção por enquanto.
Por que o autoscaling de nós, sozinho, não reduz os custos do GKE?
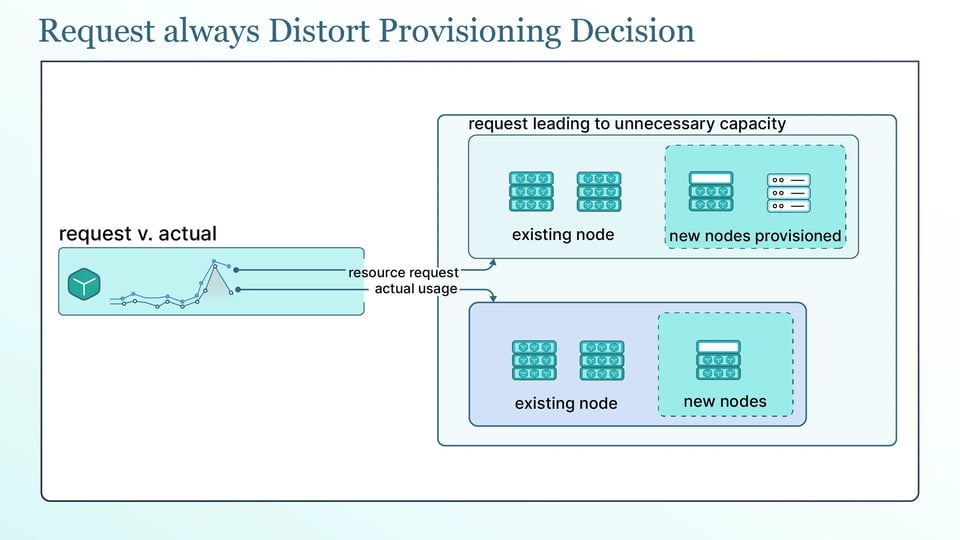
Todas as opções aqui, Karpenter, Cluster Autoscaler, node auto-provisioning e Autopilot, tomam decisões de provisionamento com base nas solicitações de recursos dos pods, e não em quanta CPU e memória os pods realmente usam.
Isso significa que solicitações excessivas podem gerar capacidade desnecessária. Se um pod solicita muito mais CPU e memória do que realmente usa, o autoscaler provisiona uma máquina maior para atender a essas solicitações. Com o Autopilot, você também é cobrado diretamente pelos recursos solicitados. O autoscaler está fazendo o que você pediu; o problema é que as solicitações estão altas demais.
É por isso que o right-sizing é um pré-requisito para um bin packing eficaz, e não algo opcional. A principal vantagem do Karpenter é empacotar pods de forma eficiente nos menores nós adequados, mas ele só consegue empacotar com base nas solicitações.
Se essas solicitações estiverem superdimensionadas, o Karpenter reserva capacidade que os pods nunca usam. O resultado pode parecer eficiente enquanto os nós permanecem parcialmente ociosos. Acerte primeiro as solicitações no nível dos pods. Assim, o autoscaler, seja qual for, pode de fato entregar a economia que promete.
Melhores práticas para autoscaling de nós no GCP
A seguir estão as melhores práticas que podem ajudar a manter o autoscaling de nós seguro e eficiente no GKE, seja usando o autoscaling do GKE ou o Karpenter:
a. Faça o right-sizing das solicitações dos pods antes de ajustar o autoscaler: como todo autoscaler trabalha a partir das solicitações, solicitações precisas fazem mais pelo custo do que qualquer configuração de autoscaler. Corrija o dimensionamento primeiro, depois ajuste.
b. Diversifique as famílias de máquinas para sobreviver à preempção de VMs Spot: as VMs Spot são muito mais baratas, mas podem ser interrompidas a qualquer momento. Permita várias famílias e tamanhos de máquina para que o autoscaler possa substituir a capacidade preemptada usando um pool diferente, em vez de ficar travado esperando por um único tipo.
c. Separe os node pools por perfil de workload, não por equipe: agrupe os nós pelo que os workloads precisam, como uso geral, uso intensivo de memória ou GPU, em vez de por qual equipe é dona deles. Isso permite que o autoscaler empacote workloads semelhantes juntos e escolha o formato de máquina certo.
d. Defina limites de CPU e memória em cada node pool para conter os gastos: seja um node pool do GKE ou um NodePool do Karpenter, defina limites para que um workload mal configurado ou fora de controle não possa provisionar capacidade e custos ilimitados.
e. Use PodDisruptionBudgets para proteger serviços com estado durante a consolidação: a consolidação move pods para empacotá-los em menos nós. Um PodDisruptionBudget limita quantos pods de um serviço podem ficar indisponíveis ao mesmo tempo, para que a consolidação não reduza um workload com estado abaixo de um número seguro de réplicas.
f. Acompanhe continuamente a utilização dos nós e a latência de provisionamento: observe qual é a utilização real dos seus nós e quanto tempo os novos nós levam para ficar prontos. Utilização baixa aponta para solicitações superdimensionadas ou empacotamento ruim, e latência de provisionamento crescente aponta para problemas de cota ou de capacidade.
Ferramentas para otimizar o autoscaling do Kubernetes no GCP
O autoscaling oferece capacidade flexível, mas as ferramentas a seguir podem ajudar você a usá-la com mais eficiência:
a. O PerfectScale ataca o problema de custo pela raiz: as solicitações de recursos das quais todo autoscaler depende. Sua plataforma de governança de Kubernetes analisa como os workloads realmente usam CPU e memória e fornece recomendações de right-sizing acionáveis e automatizadas, que você pode aplicar manualmente ou de forma autônoma. Com solicitações mais alinhadas ao uso real, seu autoscaler do GKE pode provisionar a quantidade certa de capacidade e empacotar os workloads com mais eficiência.
O PerfectScale também oferece visibilidade de custos com detalhamentos por cluster, namespace e workload, ajudando você a ver para onde vai o seu gasto com Kubernetes. Equipes como Paramount Pictures e Creditas usam o PerfectScale para manter seus clusters eficientes. Você pode experimentar ou agendar uma sessão técnica.
b. A CloudPilot AI lidera o provider Karpenter da comunidade para o GCP. Além do provider open source, ela oferece otimização de custos gerenciada, automação de confiabilidade e suporte para produção. Pode ser uma opção para equipes que querem especificamente o modelo do Karpenter no GCP com um fornecedor dando suporte ao deployment.
c. O Kubecost oferece visibilidade de custos do Kubernetes, detalhando os gastos por cluster, namespace, workload e label. Ele ajuda as equipes a identificar desperdícios e entender para onde vai o orçamento de Kubernetes.