


Karpenter hat verändert, wie Teams Nodes auf AWS und später auf Azure skalieren. Statt feste Node-Pools zu verwalten, kann es passend dimensionierte Maschinen genau dann bereitstellen, wenn sie gebraucht werden. Wenn Sie Workloads auf Google Cloud betreiben, fragen Sie sich vielleicht, ob dasselbe auch mit GKE möglich ist. Die ehrliche Antwort, Stand 2026: Der Karpenter-Support auf GCP steckt noch in den Anfängen. Es gibt keinen offiziellen GCP-Provider, und der verfügbare Community-Provider befindet sich noch im Preview-Stadium.
In diesem Guide erfahren Sie, was Karpenter ist und warum GCP-Teams sich dafür interessieren, wie es sich vom integrierten GKE-Autoscaling unterscheidet, wie es aktuell um den Karpenter-Support auf Google Cloud steht, wie der Community-Provider funktioniert, wie Sie ihn zum Testen einrichten, wo seine aktuellen Grenzen liegen – und wie Sie Ihre GKE-Kosten im Griff behalten, egal für welchen Ansatz Sie sich entscheiden.
Was ist Karpenter und warum wollen GCP-Teams es nutzen?
Karpenter ist ein Open-Source-Node-Autoscaler. Er beobachtet Pods, die nicht eingeplant werden können, findet die kosteneffizienteste Maschine, auf der sie laufen können, stellt den Node bereit und entfernt ihn wieder, sobald er nicht mehr benötigt wird.
Statt feste Gruppen identischer Nodes zu skalieren, stellt Karpenter Nodes auf Basis des tatsächlichen Workload-Bedarfs bereit. Dieser Ansatz wird als Groupless Autoscaling bezeichnet.
GCP-Teams wollen Karpenter aus denselben Gründen, aus denen es auf AWS populär wurde. Node-Pools manuell zu verwalten kann mühsam sein. Sie wählen Maschinentypen im Voraus aus, erstellen unterschiedliche Pools für unterschiedliche Workloads und provisionieren oft mehr Kapazität als nötig, um auf der sicheren Seite zu sein.
Karpenter reduziert diesen manuellen Aufwand. Es kann Maschinentypen basierend auf dem aktuellen Bedarf auswählen, Pods effizient packen, Spot- und On-Demand-Kapazität kombinieren und Nodes konsolidieren, wenn der Bedarf sinkt. Das kann zu schnellerer Skalierung und niedrigeren Kosten führen.
Nachdem Teams diese Vorteile auf EKS und AKS erlebt haben, wünschen sie sich denselben Ansatz naturgemäß auch auf GKE.
Karpenter vs. die integrierten Autoscaling-Optionen von GKE
Bevor Sie Karpenter einsetzen, lohnt sich ein Blick darauf, was GKE bereits mitbringt. Diese nativen Funktionen sind produktionsreif und decken viele der gleichen Anwendungsfälle ab wie Karpenter:
Der GKE Cluster Autoscaler ist die Basis. In Standard-Clustern skaliert er Ihre Node-Pools abhängig von Pending Pods hoch oder herunter. Diese Node-Pools basieren auf Compute Engine Managed Instance Groups. Die zentrale Einschränkung: Sie definieren Node-Pools und Maschinentypen im Voraus und müssen daher weiterhin selbst entscheiden, welche Kapazität Sie nutzen wollen.
Node Auto-Provisioning geht einen Schritt weiter. GKE kann Node-Pools automatisch auf Basis Ihrer wartenden Workloads erstellen und verwalten, sodass Sie nicht jeden Pool selbst definieren müssen. Das kommt Karpenter näher, aber GKE stellt Kapazität weiterhin über Node-Pools bereit, statt einzelne Instanzen direkt zu starten.
Custom Compute Classes mit prioritätsbasiertem Fallback bieten eine weitere Möglichkeit. Sie definieren eine priorisierte Liste von Maschinenkonfigurationen, und GKE arbeitet die Liste ab, wenn die bevorzugte Option nicht verfügbar ist. So können Sie günstigere oder Spot-Kapazität bevorzugen und bei Bedarf auf On-Demand-Kapazität ausweichen – ein Teil der Flexibilität von Karpenter, umgesetzt mit nativen GKE-Funktionen.
GKE Autopilot nimmt Ihnen das Node-Management komplett ab. Sie deployen Ihre Pods, und Google stellt die zugrunde liegenden Nodes bereit und verwaltet sie. Abgerechnet wird nach den Ressourcen, die Ihre Pods anfordern. Für Teams, die keine Nodes verwalten wollen, ist das die einfachste Option.
Der wesentliche Unterschied von Karpenter auf GCP ist sein Groupless-Modell. Es kann Instanzen direkt starten, statt auf vordefinierte Node-Pools angewiesen zu sein – genau das Modell, das viele Teams bereits mit Karpenter auf EKS nutzen.
Der Trade-off ist einfach: Die nativen Autoscaling-Optionen von GKE sind ausgereift und für den Produktionsbetrieb unterstützt, während Karpenter auf GCP noch jung und Community-getrieben ist. Der Rest dieses Guides zeigt, was das in der Praxis bedeutet.
Aktueller Stand des Karpenter-Supports auf Google Cloud
Die einzige Möglichkeit, Karpenter heute auf GCP zu betreiben, ist der Community-Provider cloudpilot-ai/karpenter-provider-gcp. Er wurde von CloudPilot AI ins Leben gerufen und wird hauptsächlich dort entwickelt, mit Beiträgen aus der Open-Source-Community; das Projekt steht unter der Apache-2.0-Lizenz.
Allerdings handelt es sich weiterhin um ein Preview-Release. Die Maintainer empfehlen es derzeit nicht für den Produktionseinsatz, auch wenn es für Tests und Experimente funktionsfähig ist. Die API befindet sich zudem noch auf v1alpha1 – sie kann sich also so ändern, dass zwischen Versionen Konfigurationsanpassungen nötig werden.
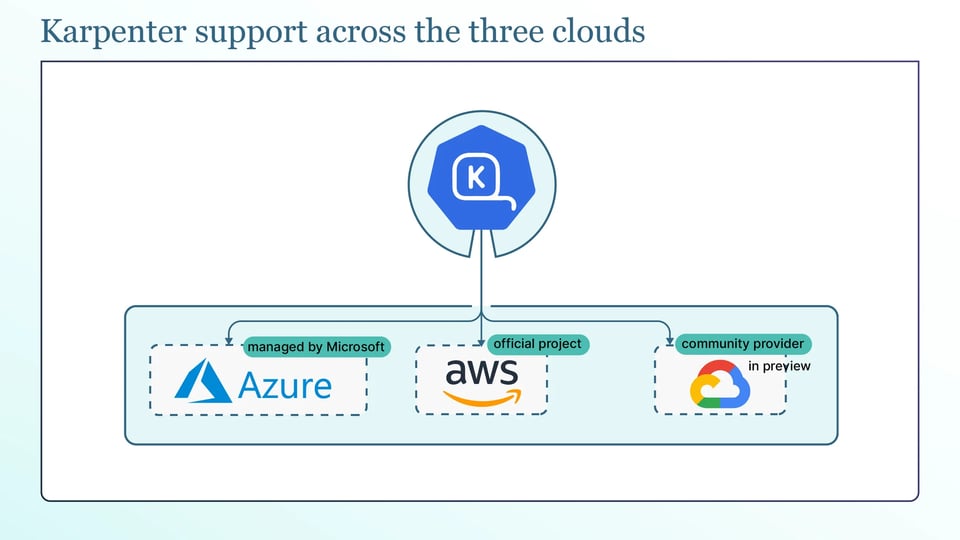
Einen offiziellen Karpenter-Provider für GCP gibt es nicht. Die kubernetes-sigs-Organisation, in der die offiziellen Karpenter-Projekte gehostet werden, hat kein GCP-Provider-Repository, und Google hat keinen veröffentlicht. Deshalb setzt GKE weiterhin auf seine nativen Autoscaling-Optionen statt auf Karpenter.
Der Unterschied zwischen den Clouds ist wichtig:
AWS: Karpenter ist ein offizielles Projekt, allgemein verfügbar und für das Node-Provisioning auf EKS weit verbreitet.
Azure: Der Karpenter-Provider bildet die Grundlage von AKS Node Auto Provisioning, ist allgemein verfügbar und wird von Microsoft verwaltet.
GCP: Es gibt keinen offiziellen oder verwalteten Provider. Die verfügbare Option ist ein Community-Provider, der sich noch im Preview befindet.
Für die Praxis bedeutet das: Nutzen Sie den Community-Provider für Tests und Experimente und setzen Sie für produktive Workloads auf die nativen Autoscaling-Funktionen von GKE.
Wie stellt Karpenter Nodes auf Compute Engine bereit?
Der Community-Provider folgt demselben grundlegenden Karpenter-Modell wie auf anderen Clouds, passt es aber an Compute Engine an.
Zunächst liest er nicht einplanbare Pods und deren Scheduling-Constraints aus. Wenn der Scheduler Pods als unschedulable markiert, wertet Karpenter deren Resource Requests, Node Selectors, Affinities, Tolerations und Topology-Spread-Regeln aus, um zu ermitteln, welche Art von Node ihre Ausführung ermöglichen würde.
Anschließend wählt er einen Maschinentyp aus dem Compute-Engine-Katalog. Statt auf vorab gewählte Maschinentypen beschränkt zu sein, betrachtet er die gesamte Bandbreite, die Ihre Konfiguration zulässt, und wählt den Typ, der die wartenden Pods zu den geringsten Kosten aufnehmen kann – und packt so viele Pods auf den Node, wie hineinpassen.
Der GCP-spezifische Teil ist die Art, wie der Node erstellt wird: Karpenter ruft die Compute-Engine-API direkt auf, um die virtuelle Maschine zu starten, statt eine Managed Instance Group zu vergrößern. Das ist der Groupless-Ansatz – keine Node-Pools, die definiert werden müssen, nur Regeln dafür, was Karpenter erstellen darf. Anschließend nimmt es die neue Instanz in Ihren GKE-Cluster auf.
Karpenter arbeitet auch nach dem Start des Nodes weiter. Es konsolidiert schwach ausgelastete Nodes auf weniger Maschinen, wenn Workloads schrumpfen, erkennt Drift, wenn ein Node nicht mehr Ihrer gewünschten Konfiguration entspricht, und ersetzt ihn – und es kann Nodes nach einem festgelegten Alter auslaufen lassen, sodass sie regelmäßig erneuert werden. Zusammen sorgt das dafür, dass der Node-Bestand am Bedarf ausgerichtet bleibt, statt unnötige Kapazität anzuhäufen.
Karpenter-Ressourcendefinitionen für GCP
Sie konfigurieren den GCP-Provider mit demselben Zwei-Ressourcen-Muster, das Karpenter auch auf anderen Clouds nutzt – mit einer GCP-spezifischen NodeClass. Schauen wir uns das an:
Die GCENodeClass enthält die Google-Cloud-spezifischen Node-Einstellungen unter der API-Gruppe karpenter.k8s.gcp. Hier definieren Sie das Node-Image mit imageSelectorTerms (zum Beispiel ContainerOptimizedOS@latest), Größe und Typ der Boot-Disk unter disks, das vom Node verwendete Google-Servicekonto sowie Netzwerk- und Kubelet-Einstellungen wie maxPods. Da die API noch auf v1alpha1 liegt, prüfen Sie in der Dokumentation des Providers, welche Felder aktuell unterstützt werden.
apiVersion: karpenter.k8s.gcp/v1alpha1kind: GCENodeClassmetadata: name: defaultspec: serviceAccount: "karpenter-sa@my-project.iam.gserviceaccount.com" imageSelectorTerms: - alias: ContainerOptimizedOS@latest disks: - boot: true sizeGiB: 128 category: pd-balancedDer NodePool ist die Upstream-Karpenter-Ressource und legt die Regeln fest, was Karpenter bereitstellen darf. Über requirements schränken Sie die Maschinenfamilien, -größen und Architekturen ein, die Karpenter wählen kann, limits deckeln die insgesamt erstellbare CPU- und Speicherkapazität, und mit taints reservieren Sie einen Pool für bestimmte Workloads.
Zwei Einstellungen sollten Sie kennen: Capacity Type und Disruption-Einstellungen. Der Capacity Type, gesetzt über das Requirement karpenter.sh/capacity-type, erlaubt Spot-VMs, On-Demand-Instanzen oder beides, sodass Karpenter günstige Spot-Kapazität bevorzugen und auf On-Demand ausweichen kann. Die Disruption-Einstellungen steuern den Lebenszyklus: consolidationPolicy (WhenEmpty oder WhenEmptyOrUnderutilized) bestimmt, wie aggressiv Nodes entfernt oder neu gepackt werden, consolidateAfter legt fest, wie schnell reagiert wird, und expireAfter erneuert Nodes nach einem festgelegten Alter.
Ein NodePool sieht so aus:
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["on-demand", "spot"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: group: karpenter.k8s.gcp kind: GCENodeClass name: default limits: cpu: "100" disruption: consolidationPolicy: WhenEmptyOrUnderutilized consolidateAfter: 1m expireAfter: 720hKarpenter auf einem GKE-Cluster einrichten
Wenn Sie den Provider ausprobieren möchten, folgen Sie diesen grundlegenden Schritten. Verwenden Sie dafür unbedingt einen Test-Cluster, nicht die Produktion. Los geht's:
Sie brauchen einen laufenden GKE-Cluster und die passenden Zugriffsrechte. Aktivieren Sie die Compute-Engine-APIs in Ihrem Projekt und stellen Sie sicher, dass Ihr Compute-Engine-Kontingent für die Instanzen ausreicht, die Karpenter erstellen wird – Kontingentgrenzen sind ein häufiger Grund, warum das Provisioning stillschweigend fehlschlägt. Karpenter benötigt außerdem ein Google-Servicekonto mit Berechtigungen zum Erstellen von Instanzen, Disks und zugehörigen Ressourcen.
Für die Authentifizierung sollten Sie Workload Identity einem Service-Account-Key vorziehen. Workload Identity verknüpft ein Kubernetes-Servicekonto mit einem Google-Servicekonto, sodass sich Karpenter authentifiziert, ohne dass eine langlebige JSON-Key-Datei in einem Secret liegt. Die Authentifizierung per Service-Account-Key funktioniert ebenfalls, aber eine Key-Datei ist ein Credential, das Sie speichern und rotieren müssen – deshalb ist Workload Identity der bessere Standard.
Der Provider wird über sein Helm-Chart installiert, konfiguriert mit Ihrem Projekt, Ihrer Region und Ihrem Cluster sowie dem eingebundenen Servicekonto:
helm upgrade --install karpenter charts/karpenter \ --namespace karpenter-system --create-namespace \ --set "controller.settings.projectID=${PROJECT_ID}" \ --set "controller.settings.region=${REGION}" \ --set "controller.settings.clusterName=${CLUSTER_NAME}" \ --set "serviceAccount.annotations.iam\.gke\.io/gcp-service-account=${KARPENTER_SA}" \ --waitSobald der Controller läuft, wenden Sie eine GCENodeClass und einen NodePool an und verifizieren das Ganze mit einem Test-Workload. Deployen Sie etwas, das nicht auf die vorhandenen Nodes passt, sodass Pods in den Pending-Status gehen, und beobachten Sie, wie Karpenter einen Node bereitstellt:
kubectl get nodeclaimskubectl get nodes -wSie sollten sehen, wie ein NodeClaim erscheint und eine neue Compute-Engine-Instanz dem Cluster beitritt – das bestätigt, dass der Provider funktioniert.
Einschränkungen, die Sie vor dem Produktionseinsatz kennen sollten
Das sind die wichtigsten Einschränkungen:
a. Lücken bei GPU, TPU und Compute-Engine-Reservierungen: Der GPU-Support wurde in den letzten Releases aktiv gefixt und erweitert, statt seit Langem stabil zu sein, TPU-Support steht nicht im Fokus, und dass Committed-Use-Rabatte oder Reservierungen greifen, sollten Sie nicht voraussetzen. Wenn Ihre GCP-Workloads von GPUs, TPUs oder Reservierungen abhängen, testen Sie sehr sorgfältig oder bleiben Sie beim nativen GKE-Autoscaling.
b. Multi-Zone-Scheduling und Affinitätskonflikte bei PersistentVolumes: Die Zonenauswahl war ein Bereich aktiver Bugfixes, und wie bei jedem Groupless-Autoscaler führt ein Node in der falschen Zone für eine zonale Persistent Disk dazu, dass der Pod sein Volume nicht anhängen kann. Validieren Sie das Multi-Zone-Verhalten gezielt für Stateful Workloads und achten Sie darauf, wo PersistentVolumes an eine Zone gebunden sind.
Denken Sie darüber hinaus immer daran: Die API ist v1alpha1, rechnen Sie also mit Breaking Changes zwischen Versionen, und der Support ist rein Community-basiert – hinter dem Open-Source-Provider steht kein Anbieter mit SLA. Beides sind Gründe, ihn vorerst aus der Produktion herauszuhalten.
Warum Node-Autoscaling allein die GKE-Kosten nicht senkt
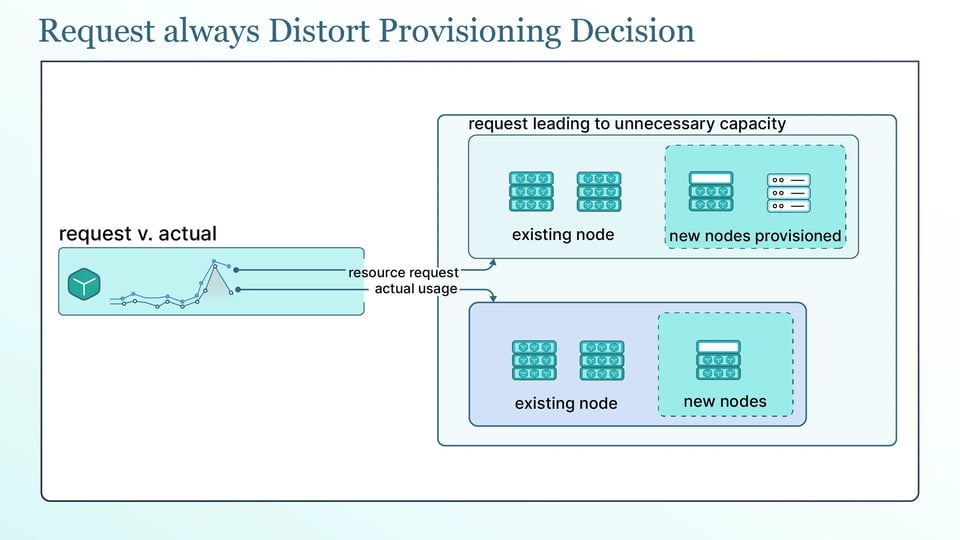
Jede der hier genannten Optionen – Karpenter, Cluster Autoscaler, Node Auto-Provisioning und Autopilot – trifft Provisioning-Entscheidungen auf Basis der Resource Requests der Pods, nicht auf Basis der tatsächlich genutzten CPU- und Speicherressourcen.
Das heißt: Überzogene Requests können zu unnötiger Kapazität führen. Fordert ein Pod deutlich mehr CPU und Speicher an, als er tatsächlich nutzt, stellt der Autoscaler eine größere Maschine bereit, um diese Requests zu erfüllen. Bei Autopilot werden die angeforderten Ressourcen zudem direkt abgerechnet. Der Autoscaler tut genau das, was Sie verlangt haben; das Problem ist, dass die Requests zu hoch sind.
Deshalb ist Right-Sizing eine Voraussetzung für effektives Bin Packing, keine Option. Karpenters größter Vorteil ist das effiziente Packen von Pods auf die kleinsten passenden Nodes – aber packen kann es nur anhand der Requests.
Sind diese Requests überdimensioniert, reserviert Karpenter Kapazität, die die Pods nie nutzen. Das Ergebnis kann effizient aussehen, während die Nodes teilweise brachliegen. Bringen Sie zuerst die Requests auf Pod-Ebene in Ordnung. Dann kann der Autoscaler – egal welcher – die versprochenen Einsparungen auch tatsächlich liefern.
Best Practices für Node-Autoscaling auf GCP
Die folgenden Best Practices helfen dabei, Node-Autoscaling auf GKE sicher und effizient zu halten – egal ob Sie GKE-Autoscaling oder Karpenter nutzen:
a. Pod-Requests per Right-Sizing anpassen, bevor Sie den Autoscaler tunen: Da jeder Autoscaler mit Requests arbeitet, bringen präzise Requests mehr für die Kosten als jede Autoscaler-Einstellung. Korrigieren Sie zuerst die Dimensionierung, dann das Tuning.
b. Maschinenfamilien diversifizieren, um Spot-VM-Preemptions abzufedern: Spot-VMs sind deutlich günstiger, können aber jederzeit zurückgefordert werden. Erlauben Sie mehrere Maschinenfamilien und -größen, damit der Autoscaler unterbrochene Kapazität aus einem anderen Pool ersetzen kann, statt auf einen einzigen Typ warten zu müssen.
c. Node-Pools nach Workload-Profil statt nach Team trennen: Gruppieren Sie Nodes danach, was die Workloads brauchen – etwa General-Purpose, speicherintensiv oder GPU – statt danach, welchem Team sie gehören. So kann der Autoscaler ähnliche Workloads zusammen packen und den passenden Maschinentyp wählen.
d. CPU- und Speicher-Limits für jeden Node-Pool setzen, um die Ausgaben zu deckeln: Ob GKE-Node-Pool oder Karpenter-NodePool – setzen Sie Limits, damit ein fehlkonfigurierter oder außer Kontrolle geratener Workload nicht unbegrenzt Kapazität und Kosten erzeugen kann.
e. PodDisruptionBudgets nutzen, um Stateful Services während der Konsolidierung zu schützen: Bei der Konsolidierung werden Pods verschoben, um sie auf weniger Nodes zu packen. Ein PodDisruptionBudget begrenzt, wie viele Pods eines Service gleichzeitig nicht verfügbar sein dürfen, sodass die Konsolidierung einen Stateful Workload nicht unter eine sichere Replica-Anzahl drückt.
f. Node-Auslastung und Provisioning-Latenz kontinuierlich beobachten: Behalten Sie im Blick, wie stark Ihre Nodes tatsächlich ausgelastet sind und wie lange neue Nodes bis zur Einsatzbereitschaft brauchen. Niedrige Auslastung deutet auf überdimensionierte Requests oder schlechtes Packing hin, steigende Provisioning-Latenz auf Kontingent- oder Kapazitätsprobleme.
Tools zur Optimierung des Kubernetes-Autoscalings auf GCP
Autoscaling verschafft Ihnen flexible Kapazität – die folgenden Tools helfen Ihnen, sie effizienter zu nutzen:
a. PerfectScale packt das Kostenproblem an der Wurzel: bei den Resource Requests, auf die jeder Autoscaler angewiesen ist. Die Kubernetes-Governance-Plattform analysiert, wie Workloads CPU und Speicher tatsächlich nutzen, und liefert umsetzbare, automatisierte Right-Sizing-Empfehlungen, die Sie manuell oder autonom anwenden können. Mit Requests, die der tatsächlichen Nutzung besser entsprechen, kann Ihr GKE-Autoscaler die richtige Menge an Kapazität bereitstellen und Workloads effizienter packen.
PerfectScale bietet zudem Kostentransparenz mit Aufschlüsselungen nach Cluster, Namespace und Workload und zeigt Ihnen, wohin Ihre Kubernetes-Ausgaben fließen. Teams wie Paramount Pictures und Creditas nutzen PerfectScale, um ihre Cluster effizient zu halten. Probieren Sie es aus oder buchen Sie eine technische Session.
b. CloudPilot AI leitet die Entwicklung des Community-Karpenter-Providers für GCP. Neben dem Open-Source-Provider bietet das Unternehmen Managed Cost Optimization, Reliability-Automatisierung und Produktionssupport. Das kann eine Option für Teams sein, die gezielt das Karpenter-Modell auf GCP wollen – mit einem Anbieter, der das Deployment unterstützt.
c. Kubecost sorgt für Kubernetes-Kostentransparenz, indem es Ausgaben nach Cluster, Namespace, Workload und Label aufschlüsselt. Es hilft Teams, Verschwendung zu identifizieren und zu verstehen, wohin ihr Kubernetes-Budget fließt.