


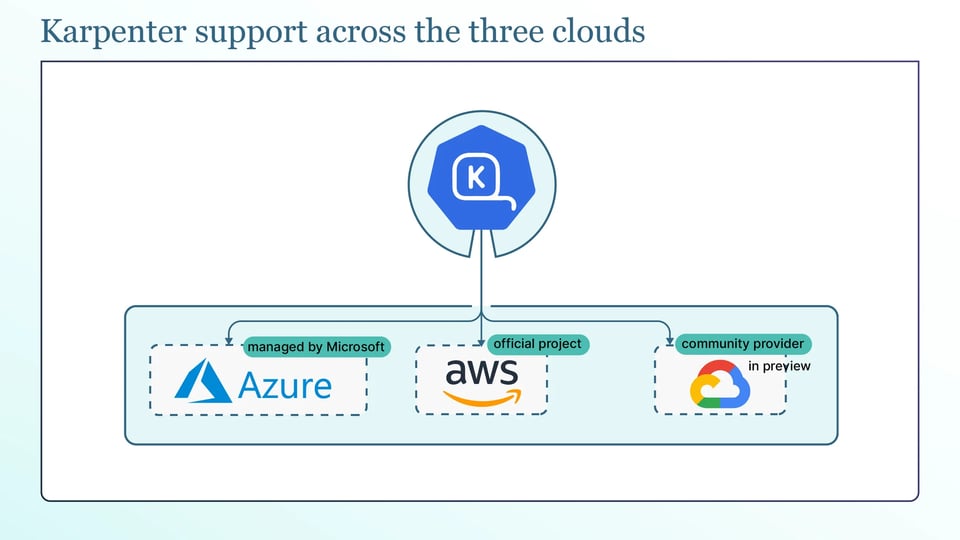
Karpenter ha cambiato il modo in cui i team scalano i nodi su AWS e, successivamente, su Azure. Invece di gestire node pool fissi, è in grado di effettuare il provisioning di macchine correttamente dimensionate nel momento in cui servono. Chi esegue workloads su Google Cloud potrebbe chiedersi se sia possibile fare lo stesso con GKE. La risposta onesta, nel 2026, è che il supporto di Karpenter su GCP è ancora agli inizi. Non esiste un provider GCP ufficiale e il provider community disponibile è ancora in preview.
In questa guida vedremo che cos'è Karpenter e perché interessa ai team GCP, come si confronta con l'autoscaling integrato di GKE, lo stato attuale del supporto di Karpenter su Google Cloud, come funziona il provider community, come configurarlo per i test, le sue limitazioni attuali e come tenere sotto controllo i costi di GKE con qualunque approccio si scelga.
Che cos'è Karpenter e perché interessa ai team GCP?
Karpenter è un autoscaler di nodi open source. Monitora i pod che non possono essere schedulati, individua la macchina più conveniente in grado di eseguirli, effettua il provisioning del nodo e lo rimuove quando non è più necessario.
Invece di scalare gruppi fissi di nodi identici, Karpenter effettua il provisioning dei nodi in base alla domanda effettiva dei workloads. Questo approccio è chiamato groupless autoscaling.
I team GCP vogliono Karpenter per le stesse ragioni che lo hanno reso popolare su AWS. Gestire i node pool manualmente può essere macchinoso: si scelgono i tipi di macchina in anticipo, si creano pool diversi per workloads diversi e spesso si sovradimensiona la capacità per stare tranquilli.
Karpenter riduce questo lavoro manuale. Può scegliere i tipi di macchina in base alla domanda corrente, impacchettare i pod in modo efficiente, combinare capacità Spot e on-demand e consolidare i nodi quando la domanda cala. Il risultato può essere uno scaling più rapido e costi inferiori.
Dopo aver visto questi vantaggi su EKS e AKS, è naturale che i team vogliano lo stesso approccio su GKE.
Karpenter vs autoscaling integrato di GKE
Prima di usare Karpenter, vale la pena capire cosa offre già GKE. Queste funzionalità native sono production-ready e coprono molti degli stessi casi d'uso di Karpenter:
Il Cluster Autoscaler di GKE è la base. Nei cluster Standard, aumenta o riduce i node pool in base ai pod in attesa. Questi node pool si appoggiano ai Managed Instance Group di Compute Engine. Il limite principale è che node pool e tipi di macchina vanno definiti in anticipo, quindi resta comunque da decidere quale capacità utilizzare.
Il node auto-provisioning fa un passo in più. GKE può creare e gestire automaticamente i node pool in base ai workloads in attesa, senza che sia necessario definire ogni pool manualmente. È un modello più vicino a Karpenter, ma GKE effettua comunque il provisioning della capacità tramite node pool anziché avviare direttamente singole istanze.
Le custom compute class con fallback basato su priorità offrono un'altra possibilità. Si può definire un elenco di configurazioni macchina in ordine di priorità e GKE scorre l'elenco se l'opzione preferita non è disponibile. In questo modo è possibile privilegiare capacità più economica o Spot e ripiegare sull'on-demand quando serve, ottenendo parte della flessibilità di Karpenter con funzionalità native di GKE.
GKE Autopilot elimina completamente la gestione dei nodi. Si effettua il deployment dei pod e Google esegue il provisioning e la gestione dei nodi sottostanti. La fatturazione si basa sulle risorse richieste dai pod. Per i team che non vogliono gestire i nodi, è l'opzione più semplice.
La differenza principale di Karpenter su GCP è il suo modello groupless: può avviare le istanze direttamente invece di affidarsi a node pool predefiniti, ovvero il modello che molti team usano già con Karpenter su EKS.
Il compromesso è semplice: le opzioni di autoscaling native di GKE sono mature e supportate in produzione, mentre Karpenter su GCP è ancora agli inizi e guidato dalla community. Il resto di questa guida analizza cosa significa in pratica.
Stato attuale del supporto di Karpenter su Google Cloud
Oggi l'unico modo per eseguire Karpenter su GCP è tramite il provider community, cloudpilot-ai/karpenter-provider-gcp. È stato avviato ed è sviluppato principalmente da CloudPilot AI, con contributi della community open source, e il progetto è distribuito con licenza Apache 2.0.
Si tratta però ancora di una release in preview. I maintainer attualmente non ne consigliano l'uso in produzione, anche se è funzionante per test e sperimentazione. L'API, inoltre, è ancora alla versione v1alpha1: questo significa che può cambiare in modi che potrebbero richiedere modifiche di configurazione tra una versione e l'altra.
Non esiste un provider Karpenter ufficiale per GCP. L'organizzazione kubernetes-sigs, che ospita i progetti Karpenter ufficiali, non ha un repository per un provider GCP e Google non ne ha rilasciato uno. Per questo GKE continua ad affidarsi alle sue opzioni di autoscaling native invece che a Karpenter.
La differenza tra i cloud è importante:
AWS: Karpenter è un progetto ufficiale, in disponibilità generale e ampiamente usato per il provisioning dei nodi su EKS.
Azure: il provider Karpenter è alla base del Node Auto Provisioning di AKS, è in disponibilità generale ed è gestito da Microsoft.
GCP: non esiste un provider ufficiale o gestito. L'opzione disponibile è un provider community ancora in preview.
La conclusione pratica: usare il provider community per test e sperimentazione e affidarsi alle funzionalità di autoscaling native di GKE per i workloads di produzione.
Come effettua Karpenter il provisioning dei nodi su Compute Engine?
Il provider community segue lo stesso modello di base che Karpenter usa sugli altri cloud, adattandolo a Compute Engine.
Parte dalla lettura dei pod non schedulabili e dei loro vincoli di scheduling. Quando lo scheduler contrassegna i pod come non schedulabili, Karpenter legge le loro richieste di risorse, i node selector, le affinity, le tolerations e le regole di topology spread per capire quale tipo di nodo permetterebbe loro di essere eseguiti.
Da lì seleziona un tipo di macchina dal catalogo di Compute Engine. Invece di limitarsi ai tipi di macchina scelti in anticipo, considera la gamma consentita dalla configurazione e ne sceglie uno adatto ai pod in attesa al costo più basso, impacchettando sul nodo tutti i pod che ci stanno.
La parte specifica di GCP è il modo in cui il nodo viene creato: Karpenter chiama direttamente l'API di Compute Engine per avviare la macchina virtuale, invece di ridimensionare un Managed Instance Group. È l'approccio groupless: nessun node pool da definire, solo regole su ciò che Karpenter può creare; la nuova istanza viene poi aggiunta al cluster GKE.
Karpenter continua a lavorare anche dopo l'avvio del nodo. Consolida i nodi sottoutilizzati su meno macchine quando i workloads si riducono, rileva il drift quando un nodo non corrisponde più alla configurazione desiderata e lo sostituisce, e può far scadere i nodi dopo un periodo prestabilito, in modo che vengano riciclati regolarmente. Nel complesso, tutto questo mantiene il parco nodi allineato alla domanda, evitando che degeneri in spreco.
Le definizioni delle risorse Karpenter per GCP
Il provider GCP si configura con lo stesso schema a due risorse che Karpenter usa sugli altri cloud, con una NodeClass specifica per GCP. Vediamole:
La GCENodeClass contiene le impostazioni dei nodi specifiche di Google Cloud sotto il gruppo API karpenter.k8s.gcp. È qui che si definiscono l'immagine del nodo con imageSelectorTerms (ad esempio ContainerOptimizedOS@latest), dimensione e tipo del disco di avvio sotto disks, il service account Google usato dal nodo e le impostazioni di rete e kubelet come maxPods. Poiché l'API è ancora alla v1alpha1, è consigliabile verificare nella documentazione del provider i campi attualmente supportati.
apiVersion: karpenter.k8s.gcp/v1alpha1kind: GCENodeClassmetadata: name: defaultspec: serviceAccount: "karpenter-sa@my-project.iam.gserviceaccount.com" imageSelectorTerms: - alias: ContainerOptimizedOS@latest disks: - boot: true sizeGiB: 128 category: pd-balancedIl NodePool è la risorsa Karpenter upstream e stabilisce le regole su ciò di cui Karpenter può effettuare il provisioning. I suoi requirements limitano le famiglie di macchine, le dimensioni e le architetture che Karpenter può scegliere, i suoi limits pongono un tetto al totale di CPU e memoria che può creare, e i taints permettono di riservare un pool a workloads specifici.
Due impostazioni importanti da conoscere: il capacity type e le impostazioni di disruption. Il capacity type, definito tramite il requirement karpenter.sh/capacity-type, consente di ammettere VM Spot, istanze on-demand o entrambe, così Karpenter può privilegiare la capacità Spot più economica e ripiegare sull'on-demand. Le impostazioni di disruption controllano invece il ciclo di vita: consolidationPolicy (WhenEmpty o WhenEmptyOrUnderutilized) decide con quanta aggressività i nodi vengono rimossi o riorganizzati, consolidateAfter stabilisce la rapidità d'intervento ed expireAfter ricicla i nodi dopo un periodo prestabilito.
Un NodePool si presenta così:
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["on-demand", "spot"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: group: karpenter.k8s.gcp kind: GCENodeClass name: default limits: cpu: "100" disruption: consolidationPolicy: WhenEmptyOrUnderutilized consolidateAfter: 1m expireAfter: 720hConfigurare Karpenter su un cluster GKE
Per provare il provider, seguire questi passaggi di base, usando un cluster di test e non di produzione. Vediamo come:
Servono un cluster GKE in esecuzione e gli accessi giusti. È necessario abilitare le API di Compute Engine sul progetto e assicurarsi di avere una quota Compute Engine sufficiente per le istanze che Karpenter creerà, poiché i limiti di quota sono una causa comune di fallimenti silenziosi del provisioning. Karpenter richiede inoltre un service account Google con i permessi per creare istanze, dischi e risorse correlate.
Per l'autenticazione, è preferibile Workload Identity rispetto a una chiave del service account. Workload Identity associa un service account Kubernetes a un service account Google, così Karpenter si autentica senza un file di chiave JSON di lunga durata conservato in un secret. Anche l'autenticazione con chiave del service account funziona, ma un file di chiave è una credenziale da conservare e ruotare: ecco perché Workload Identity è l'opzione predefinita migliore.
Il provider si installa con il suo chart Helm, indicando progetto, località e cluster e collegando il service account:
helm upgrade --install karpenter charts/karpenter \ --namespace karpenter-system --create-namespace \ --set "controller.settings.projectID=${PROJECT_ID}" \ --set "controller.settings.region=${REGION}" \ --set "controller.settings.clusterName=${CLUSTER_NAME}" \ --set "serviceAccount.annotations.iam\.gke\.io/gcp-service-account=${KARPENTER_SA}" \ --waitCon il controller in esecuzione, applicare una GCENodeClass e un NodePool, quindi verificare con un workload di test. Occorre effettuare il deployment di qualcosa che non entra nei nodi attuali, in modo che i pod restino in stato pending, e osservare Karpenter effettuare il provisioning di un nodo:
kubectl get nodeclaimskubectl get nodes -wDovrebbe comparire un NodeClaim e una nuova istanza Compute Engine dovrebbe aggiungersi al cluster, a conferma che il provider funziona.
Limitazioni da considerare prima dell'uso in produzione
Queste sono le limitazioni più importanti:
a. Lacune su GPU, TPU e prenotazioni Compute Engine: il supporto GPU è stato attivamente corretto ed esteso nelle release recenti, più che essere consolidato da tempo, il supporto TPU non è una priorità e non si può dare per scontato che il consumo di sconti per impegno di utilizzo o di prenotazioni funzioni. Se i workloads su GCP dipendono da GPU, TPU o prenotazioni, occorre testare con grande attenzione o restare sull'autoscaling nativo di GKE.
b. Scheduling multi-zona e conflitti di affinità dei PersistentVolume: la selezione della zona è stata oggetto di correzioni di bug attive e, come per qualsiasi autoscaler groupless, un nodo creato nella zona sbagliata rispetto a un disco persistente zonale lascia il pod nell'impossibilità di collegare il proprio volume. È opportuno validare il comportamento multi-zona specificamente per i workloads stateful e prestare attenzione a dove i PersistentVolume sono vincolati a una zona.
A tutto questo si aggiunge che l'API è v1alpha1, quindi sono da mettere in conto breaking change tra le versioni, e che il supporto è solo della community, senza lo SLA di un vendor dietro il provider open source. Due buone ragioni per tenerlo fuori dalla produzione, per ora.
Perché l'autoscaling dei nodi da solo non riduce i costi di GKE?
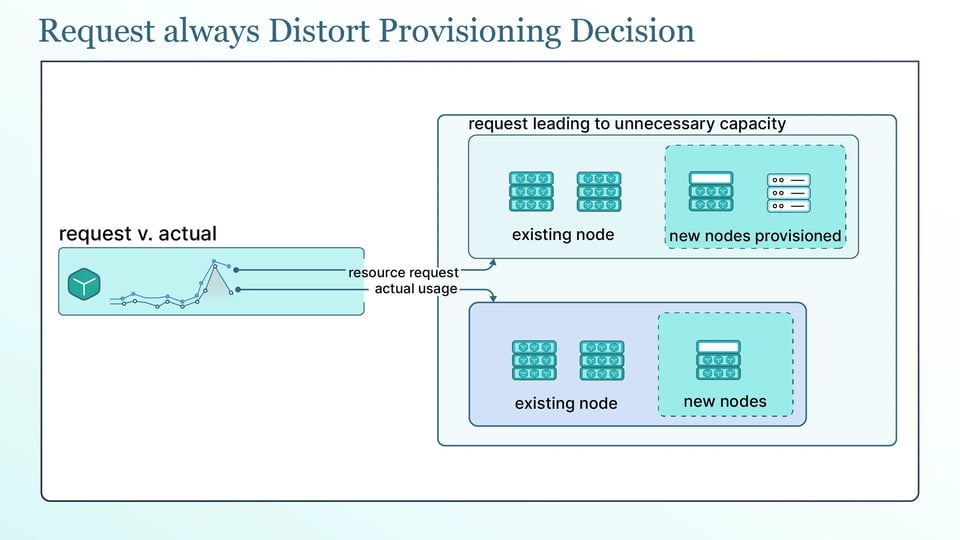
Ogni opzione vista qui — Karpenter, Cluster Autoscaler, node auto-provisioning e Autopilot — prende le decisioni di provisioning in base alle richieste di risorse dei pod, non a quanta CPU e memoria i pod usano davvero.
Ciò significa che richieste eccessive possono tradursi in capacità inutile. Se un pod richiede molta più CPU e memoria di quanta ne usi effettivamente, l'autoscaler effettua il provisioning di una macchina più grande per soddisfare quelle richieste. Con Autopilot, inoltre, la fatturazione avviene direttamente sulle risorse richieste. L'autoscaler sta facendo ciò che gli è stato chiesto; il problema è che le richieste sono troppo alte.
Ecco perché il right-sizing è un prerequisito per un bin packing efficace, non un optional. Il vantaggio principale di Karpenter è impacchettare i pod in modo efficiente sui nodi più piccoli adatti, ma può farlo solo in base alle loro richieste.
Se le richieste sono sovradimensionate, Karpenter riserva capacità che i pod non useranno mai. Il risultato può sembrare efficiente mentre i nodi restano parzialmente inattivi. Prima vanno sistemate le richieste a livello di pod; poi l'autoscaler, qualunque esso sia, potrà davvero garantire i risparmi promessi.
Best practice per l'autoscaling dei nodi su GCP
Queste best practice aiutano a mantenere l'autoscaling dei nodi sicuro ed efficiente su GKE, sia con l'autoscaling di GKE sia con Karpenter:
a. Fare right-sizing delle richieste dei pod prima di ottimizzare l'autoscaler: poiché ogni autoscaler lavora sulle richieste, richieste accurate incidono sui costi più di qualsiasi impostazione dell'autoscaler. Prima si sistema il dimensionamento, poi si ottimizza.
b. Diversificare le famiglie di macchine per resistere alla preemption delle VM Spot: le VM Spot costano molto meno, ma possono essere recuperate in qualsiasi momento. Conviene ammettere diverse famiglie e dimensioni di macchine, così l'autoscaler può sostituire la capacità soggetta a preemption attingendo a un pool diverso invece di restare bloccato in attesa di un unico tipo.
c. Separare i node pool per profilo di workload invece che per team: conviene raggruppare i nodi in base a ciò di cui i workloads hanno bisogno, ad esempio general-purpose, con molta memoria o GPU, anziché in base al team proprietario. Così l'autoscaler può impacchettare insieme workloads simili e scegliere il tipo di macchina più adatto.
d. Impostare limiti di CPU e memoria su ogni node pool per contenere la spesa: che si tratti di un node pool GKE o di un NodePool Karpenter, i limiti impediscono che un workload mal configurato o fuori controllo effettui il provisioning di capacità e costi illimitati.
e. Usare i PodDisruptionBudget per proteggere i servizi stateful durante il consolidamento: il consolidamento sposta i pod per impacchettarli su meno nodi. Un PodDisruptionBudget limita quanti pod di un servizio possono essere indisponibili contemporaneamente, così il consolidamento non porta un workload stateful sotto un numero sicuro di repliche.
f. Monitorare continuamente l'utilizzo dei nodi e la latenza di provisioning: occorre osservare quanto sono effettivamente pieni i nodi e quanto tempo impiegano i nuovi nodi a diventare pronti. Un utilizzo basso indica richieste sovradimensionate o packing inefficiente, mentre una latenza di provisioning in aumento segnala problemi di quota o di capacità.
Strumenti per ottimizzare l'autoscaling di Kubernetes su GCP
L'autoscaling offre capacità flessibile, ma gli strumenti seguenti aiutano a usarla in modo più efficiente:
a. PerfectScale affronta il problema dei costi alla radice: le richieste di risorse da cui dipende ogni autoscaler. La sua piattaforma di governance per Kubernetes analizza come i workloads usano effettivamente CPU e memoria e fornisce raccomandazioni di right-sizing concrete e automatizzate, applicabili manualmente o in modo autonomo. Con richieste più allineate all'uso reale, l'autoscaler di GKE può effettuare il provisioning della giusta quantità di capacità e impacchettare i workloads in modo più efficiente.
PerfectScale offre anche visibilità sui costi con suddivisioni per cluster, namespace e workload, aiutando a capire dove va la spesa Kubernetes. Team come Paramount Pictures e Creditas usano PerfectScale per mantenere efficienti i loro cluster. È possibile provarlo o prenotare una sessione tecnica.
b. CloudPilot AI guida il provider Karpenter community per GCP. Oltre al provider open source, offre ottimizzazione dei costi gestita, automazione dell'affidabilità e supporto in produzione. Può essere un'opzione per i team che vogliono specificamente il modello Karpenter su GCP con un vendor a supporto del deployment.
c. Kubecost fornisce visibilità sui costi Kubernetes suddividendo la spesa per cluster, namespace, workload e label. Aiuta i team a individuare gli sprechi e a capire dove va il budget Kubernetes.