


Karpenter a changé la façon dont les équipes font évoluer leurs nœuds sur AWS, puis sur Azure. Au lieu de gérer des node pools fixes, il peut provisionner des machines correctement dimensionnées au moment où elles sont nécessaires. Si vous exécutez des workloads sur Google Cloud, vous vous demandez peut-être si vous pouvez faire de même avec GKE. La réponse honnête, en 2026, est que le support de Karpenter sur GCP en est encore à ses débuts. Il n'existe pas de provider GCP officiel, et le provider communautaire disponible est encore en preview.
Dans ce guide, vous découvrirez ce qu'est Karpenter et pourquoi les équipes GCP s'y intéressent, comment il se compare à l'autoscaling intégré de GKE, l'état actuel du support de Karpenter sur Google Cloud, le fonctionnement du provider communautaire, sa mise en place pour des tests, ses limites actuelles, et comment garder les coûts GKE sous contrôle quelle que soit l'approche choisie.
Qu'est-ce que Karpenter et pourquoi les équipes GCP s'y intéressent-elles ?
Karpenter est un autoscaler de nœuds open source. Il surveille les pods qui ne peuvent pas être planifiés, identifie la machine la plus rentable capable de les exécuter, provisionne le nœud et le supprime lorsqu'il n'est plus nécessaire.
Au lieu de faire évoluer des groupes fixes de nœuds identiques, Karpenter provisionne les nœuds en fonction de la demande réelle des workloads. Cette approche est appelée autoscaling sans groupes (groupless).
Les équipes GCP s'intéressent à Karpenter pour les mêmes raisons qui ont fait son succès sur AWS. Gérer des node pools manuellement peut être fastidieux. Vous choisissez les types de machines à l'avance, créez différents pools pour différents workloads et surprovisionnez souvent la capacité par sécurité.
Karpenter réduit ce travail manuel. Il peut choisir les types de machines selon la demande du moment, regrouper les pods efficacement, combiner capacité Spot et à la demande, et consolider les nœuds quand la demande diminue. Cela peut se traduire par un scaling plus rapide et des coûts réduits.
Après avoir constaté ces bénéfices sur EKS et AKS, les équipes veulent naturellement la même approche sur GKE.
Karpenter face aux options d'autoscaling natives de GKE
Avant d'utiliser Karpenter, il est utile de comprendre ce que GKE propose déjà. Ces fonctionnalités natives sont prêtes pour la production et couvrent bon nombre des mêmes cas d'usage que Karpenter :
Le Cluster Autoscaler de GKE constitue la base. Dans les clusters Standard, il fait évoluer vos node pools à la hausse ou à la baisse en fonction des pods en attente. Ces node pools s'appuient sur des Managed Instance Groups de Compute Engine. La principale limite : vous définissez les node pools et les types de machines à l'avance, vous devez donc encore décider quelle capacité utiliser.
Le node auto-provisioning va un cran plus loin. GKE peut créer et gérer automatiquement des node pools en fonction de vos workloads en attente, sans que vous ayez à définir chaque pool vous-même. On se rapproche de Karpenter, mais GKE provisionne toujours la capacité via des node pools plutôt qu'en lançant directement des instances individuelles.
Les custom compute classes avec repli par priorité offrent une autre option. Vous définissez une liste hiérarchisée de configurations de machines, et GKE descend dans la liste si l'option préférée n'est pas disponible. Vous pouvez ainsi privilégier la capacité la moins chère ou Spot et basculer vers la capacité à la demande si nécessaire, ce qui apporte une partie de la flexibilité de Karpenter avec des fonctionnalités natives de GKE.
GKE Autopilot supprime complètement la gestion des nœuds. Vous déployez vos pods, et Google provisionne et gère les nœuds sous-jacents. Vous êtes facturé sur la base des ressources demandées par vos pods. Pour les équipes qui ne veulent pas gérer de nœuds, c'est l'option la plus simple.
La principale différence de Karpenter sur GCP tient à son modèle sans groupes. Il peut lancer des instances directement au lieu de s'appuyer sur des node pools prédéfinis, le modèle que beaucoup d'équipes utilisent déjà avec Karpenter sur EKS.
Le compromis est simple : les options d'autoscaling natives de GKE sont matures et prises en charge en production, tandis que Karpenter sur GCP reste jeune et porté par la communauté. La suite de ce guide examine ce que cela signifie en pratique.
État actuel du support de Karpenter sur Google Cloud
Le seul moyen d'exécuter Karpenter sur GCP aujourd'hui est le provider communautaire, cloudpilot-ai/karpenter-provider-gcp. Il a été lancé et est principalement développé par CloudPilot AI, avec des contributions de la communauté open source, et le projet est sous licence Apache 2.0.
Il s'agit toutefois encore d'une version preview. Les mainteneurs ne le recommandent pas pour la production à ce stade, même s'il est fonctionnel pour les tests et l'expérimentation. Son API en est également toujours à v1alpha1, ce qui signifie qu'elle peut évoluer d'une version à l'autre et imposer des changements de configuration.
Il n'existe pas de provider Karpenter officiel pour GCP. L'organisation kubernetes-sigs, qui héberge les projets Karpenter officiels, ne dispose pas de dépôt de provider GCP, et Google n'en a pas publié. C'est pourquoi GKE continue de s'appuyer sur ses options d'autoscaling natives plutôt que sur Karpenter.
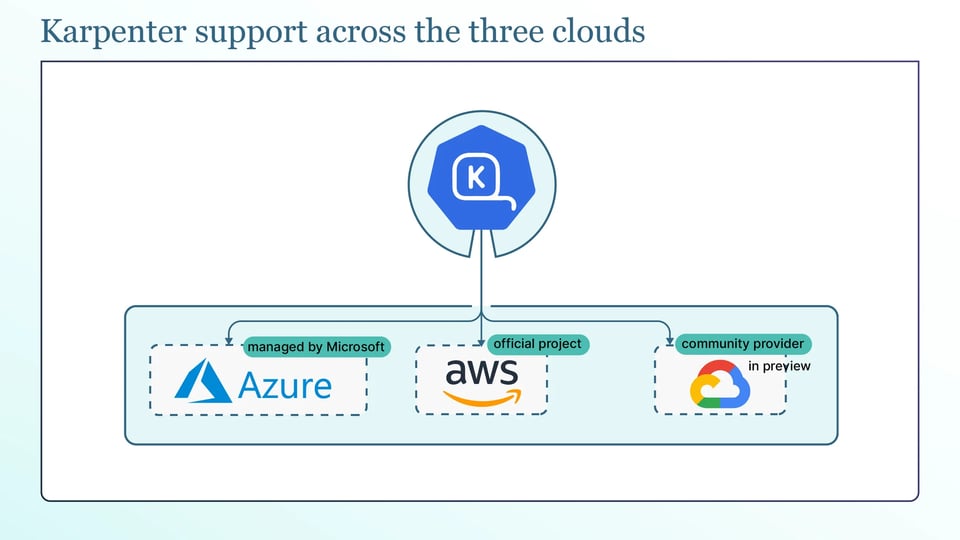
La différence entre les clouds est importante :
AWS : Karpenter est un projet officiel, en disponibilité générale et largement utilisé pour le provisionnement de nœuds sur EKS.
Azure : le provider Karpenter alimente le Node Auto Provisioning d'AKS ; il est en disponibilité générale et géré par Microsoft.
GCP : il n'existe pas de provider officiel ni managé. L'option disponible est un provider communautaire encore en preview.
En pratique, retenez ceci : utilisez le provider communautaire pour les tests et l'expérimentation, et les fonctionnalités d'autoscaling natives de GKE pour les workloads de production.
Comment Karpenter provisionne-t-il les nœuds sur Compute Engine ?
Le provider communautaire suit le même modèle Karpenter de base que sur les autres clouds, en l'adaptant à Compute Engine.
Il commence par lire les pods non planifiables et leurs contraintes de scheduling. Lorsque le scheduler marque des pods comme non planifiables, Karpenter lit leurs requêtes de ressources, leurs node selectors, leurs affinités, leurs tolerations et leurs règles de répartition topologique pour déterminer quel type de nœud leur permettrait de s'exécuter.
Il sélectionne ensuite un type de machine dans le catalogue Compute Engine. Plutôt que de se limiter aux types de machines choisis à l'avance, il considère l'éventail autorisé par votre configuration et retient celui qui convient aux pods en attente au coût le plus bas, en plaçant sur le nœud autant de pods que possible.
La partie propre à GCP concerne la création du nœud : Karpenter appelle directement l'API Compute Engine pour lancer la machine virtuelle, au lieu de redimensionner un Managed Instance Group. C'est l'approche sans groupes : pas de node pools à définir, seulement des règles sur ce que Karpenter peut créer ; il rattache ensuite la nouvelle instance à votre cluster GKE.
Karpenter continue de travailler une fois le nœud en service. Il consolide les nœuds sous-utilisés sur moins de machines quand les workloads diminuent, détecte la dérive lorsqu'un nœud ne correspond plus à la configuration souhaitée et le remplace, et peut faire expirer les nœuds après une durée définie afin de les recycler régulièrement. Ensemble, ces mécanismes maintiennent le parc de nœuds aligné sur la demande au lieu de dériver vers le gaspillage.
Définitions de ressources Karpenter pour GCP
Vous configurez le provider GCP selon le même schéma à deux ressources que Karpenter utilise sur les autres clouds, avec une NodeClass propre à GCP. Voyons cela :
La GCENodeClass contient les paramètres de nœud spécifiques à Google Cloud, sous le groupe d'API karpenter.k8s.gcp. C'est là que vous définissez l'image du nœud avec imageSelectorTerms (par exemple ContainerOptimizedOS@latest), la taille et le type du disque de démarrage sous disks, le compte de service Google utilisé par le nœud, ainsi que les paramètres réseau et kubelet comme maxPods. L'API étant encore en v1alpha1, consultez la documentation du provider pour connaître les champs actuellement pris en charge.
apiVersion: karpenter.k8s.gcp/v1alpha1kind: GCENodeClassmetadata: name: defaultspec: serviceAccount: "karpenter-sa@my-project.iam.gserviceaccount.com" imageSelectorTerms: - alias: ContainerOptimizedOS@latest disks: - boot: true sizeGiB: 128 category: pd-balancedLe NodePool est la ressource Karpenter upstream ; elle fixe les règles de ce que Karpenter peut provisionner. Ses requirements restreignent les familles, tailles et architectures de machines que Karpenter peut choisir, ses limits plafonnent le total de CPU et de mémoire qu'il peut créer, et les taints vous permettent de réserver un pool à des workloads spécifiques.
Deux réglages importants sont à connaître : le type de capacité et les paramètres de disruption. Le type de capacité, défini via l'exigence karpenter.sh/capacity-type, vous permet d'autoriser les VM Spot, les instances à la demande ou les deux, afin que Karpenter privilégie la capacité Spot bon marché et bascule vers la capacité à la demande si besoin. Les paramètres de disruption contrôlent quant à eux le cycle de vie : consolidationPolicy (WhenEmpty ou WhenEmptyOrUnderutilized) détermine avec quelle agressivité il supprime ou regroupe les nœuds, consolidateAfter définit sous quel délai il agit, et expireAfter recycle les nœuds après une durée donnée.
Un NodePool ressemble à ceci :
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["on-demand", "spot"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: group: karpenter.k8s.gcp kind: GCENodeClass name: default limits: cpu: "100" disruption: consolidationPolicy: WhenEmptyOrUnderutilized consolidateAfter: 1m expireAfter: 720hInstaller Karpenter sur un cluster GKE
Si vous souhaitez essayer le provider, suivez ces étapes de base. Utilisez impérativement un cluster de test, pas la production. Essayons :
Il vous faut un cluster GKE en fonctionnement et les bons accès. Vous devez activer les API Compute Engine sur votre projet et vérifier que vous disposez d'un quota Compute Engine suffisant pour les instances que Karpenter créera, car les limites de quota sont une cause fréquente d'échecs silencieux de provisionnement. Karpenter a aussi besoin d'un compte de service Google autorisé à créer des instances, des disques et les ressources associées.
Pour l'authentification, privilégiez Workload Identity plutôt qu'une clé de compte de service. Workload Identity lie un compte de service Kubernetes à un compte de service Google : Karpenter s'authentifie ainsi sans fichier de clé JSON à longue durée de vie stocké dans un secret. L'authentification par clé de compte de service fonctionne aussi, mais un fichier de clé est un identifiant à stocker et à renouveler régulièrement, raison pour laquelle Workload Identity est le meilleur choix par défaut.
Le provider s'installe avec son chart Helm, en le pointant vers votre projet, votre région et votre cluster, et en y raccordant le compte de service :
helm upgrade --install karpenter charts/karpenter \ --namespace karpenter-system --create-namespace \ --set "controller.settings.projectID=${PROJECT_ID}" \ --set "controller.settings.region=${REGION}" \ --set "controller.settings.clusterName=${CLUSTER_NAME}" \ --set "serviceAccount.annotations.iam\.gke\.io/gcp-service-account=${KARPENTER_SA}" \ --waitUne fois le contrôleur opérationnel, appliquez une GCENodeClass et un NodePool, puis vérifiez avec un workload de test. Déployez quelque chose qui ne tient pas sur les nœuds actuels afin que les pods passent en attente, et observez Karpenter provisionner un nœud :
kubectl get nodeclaimskubectl get nodes -wVous devriez voir apparaître un NodeClaim et une nouvelle instance Compute Engine rejoindre le cluster, ce qui confirme que le provider fonctionne.
Limites à prendre en compte avant un passage en production
Voici les limites importantes :
a. Lacunes côté GPU, TPU et réservations Compute Engine : le support des GPU a été activement corrigé et étendu dans les versions récentes plutôt que d'être stabilisé de longue date, le support des TPU n'est pas une priorité, et la consommation des remises sur engagement d'utilisation ou des réservations n'est pas quelque chose à considérer comme acquis. Si vos workloads GCP dépendent de GPU, de TPU ou de réservations, testez très soigneusement ou restez sur l'autoscaling natif de GKE.
b. Scheduling multi-zone et conflits d'affinité des PersistentVolumes : la sélection de zone a fait l'objet de corrections de bugs actives et, comme avec tout autoscaler sans groupes, un nœud provisionné dans la mauvaise zone pour un disque persistant zonal empêche le pod d'attacher son volume. Validez spécifiquement le comportement multi-zone pour les workloads stateful et soyez attentif aux PersistentVolumes rattachés à une zone.
En plus de cela, gardez toujours en tête que l'API est en v1alpha1 : attendez-vous à des changements incompatibles entre versions, et le support est uniquement communautaire, sans SLA d'éditeur derrière le provider open source. Deux raisons de le tenir à l'écart de la production pour le moment.
Pourquoi l'autoscaling des nœuds ne suffit-il pas à réduire les coûts GKE ?
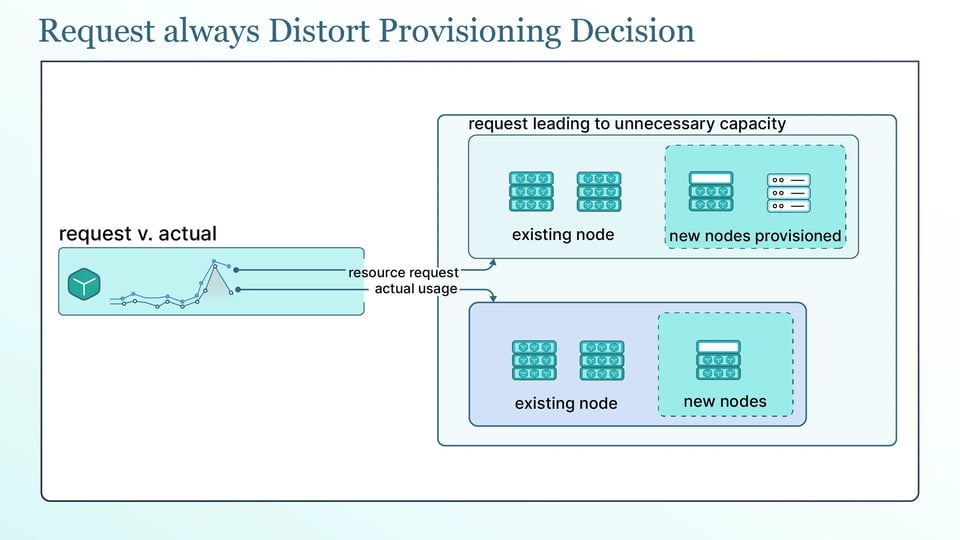
Toutes les options évoquées ici — Karpenter, Cluster Autoscaler, node auto-provisioning et Autopilot — prennent leurs décisions de provisionnement à partir des requêtes de ressources des pods, et non de la consommation réelle de CPU et de mémoire.
Des requêtes excessives peuvent donc entraîner de la capacité inutile. Si un pod demande beaucoup plus de CPU et de mémoire qu'il n'en utilise réellement, l'autoscaler provisionne une machine plus grande pour satisfaire ces requêtes. Avec Autopilot, vous êtes de plus facturé directement sur les ressources demandées. L'autoscaler fait ce que vous lui avez demandé ; le problème, c'est que les requêtes sont trop élevées.
C'est pourquoi le right-sizing est un prérequis pour un bin packing efficace, et non une option. Le principal atout de Karpenter est de regrouper efficacement les pods sur les plus petits nœuds adaptés, mais il ne peut le faire que sur la base de leurs requêtes.
Si ces requêtes sont surdimensionnées, Karpenter réserve de la capacité que les pods n'utiliseront jamais. Le résultat peut sembler efficace alors que les nœuds restent en partie inactifs. Commencez par ajuster les requêtes au niveau des pods. Ensuite seulement, l'autoscaler, quel qu'il soit, pourra réellement tenir ses promesses en matière d'économies.
Bonnes pratiques pour l'autoscaling des nœuds sur GCP
Voici les bonnes pratiques qui permettent de garder un autoscaling des nœuds sûr et efficace sur GKE, que vous utilisiez l'autoscaling de GKE ou Karpenter :
a. Ajustez les requêtes des pods avant de régler l'autoscaler : comme chaque autoscaler travaille à partir des requêtes, des requêtes précises font davantage pour les coûts que n'importe quel réglage de l'autoscaler. Corrigez d'abord le dimensionnement, puis affinez.
b. Diversifiez les familles de machines pour résister à la préemption des VM Spot : les VM Spot sont bien moins chères mais peuvent être récupérées à tout moment. Autorisez plusieurs familles et tailles de machines afin que l'autoscaler puisse remplacer la capacité préemptée depuis un autre pool au lieu de rester bloqué à attendre un seul type.
c. Séparez les node pools par profil de workload plutôt que par équipe : regroupez les nœuds selon les besoins des workloads (usage général, forte consommation mémoire, GPU) plutôt que selon l'équipe propriétaire. L'autoscaler peut ainsi regrouper des workloads similaires et choisir le bon gabarit de machine.
d. Définissez des limites de CPU et de mémoire sur chaque node pool pour plafonner les dépenses : qu'il s'agisse d'un node pool GKE ou d'un NodePool Karpenter, fixez des limites pour qu'un workload mal configuré ou incontrôlé ne puisse pas provisionner une capacité — et des coûts — sans limite.
e. Utilisez des PodDisruptionBudgets pour protéger les services stateful pendant la consolidation : la consolidation déplace les pods pour les regrouper sur moins de nœuds. Un PodDisruptionBudget plafonne le nombre de pods d'un service pouvant être indisponibles en même temps, afin que la consolidation ne fasse pas passer un workload stateful sous un nombre de réplicas sûr.
f. Suivez en continu l'utilisation des nœuds et la latence de provisionnement : surveillez le taux de remplissage réel de vos nœuds et le temps nécessaire aux nouveaux nœuds pour devenir prêts. Une faible utilisation révèle des requêtes surdimensionnées ou un mauvais packing, et une latence de provisionnement croissante signale des problèmes de quota ou de capacité.
Outils pour optimiser l'autoscaling Kubernetes sur GCP
L'autoscaling vous apporte une capacité flexible, mais les outils suivants peuvent vous aider à l'exploiter plus efficacement :
a. PerfectScale s'attaque au problème des coûts à la racine : les requêtes de ressources dont dépend chaque autoscaler. Sa plateforme de gouvernance Kubernetes analyse la consommation réelle de CPU et de mémoire des workloads et fournit des recommandations de right-sizing concrètes et automatisées, à appliquer manuellement ou de manière autonome. Avec des requêtes mieux alignées sur l'usage réel, votre autoscaler GKE peut provisionner la juste capacité et regrouper les workloads plus efficacement.
PerfectScale offre également une visibilité sur les coûts avec des ventilations par cluster, namespace et workload, pour voir où part votre budget Kubernetes. Des équipes comme Paramount Pictures et Creditas utilisent PerfectScale pour maintenir l'efficacité de leurs clusters. Vous pouvez l'essayer ou réserver une session technique.
b. CloudPilot AI pilote le provider Karpenter communautaire pour GCP. En plus du provider open source, l'entreprise propose une optimisation des coûts managée, de l'automatisation de la fiabilité et un support de production. Une option pour les équipes qui veulent spécifiquement le modèle Karpenter sur GCP avec un éditeur derrière le déploiement.
c. Kubecost fournit une visibilité sur les coûts Kubernetes en ventilant les dépenses par cluster, namespace, workload et label. Il aide les équipes à identifier le gaspillage et à comprendre où passe leur budget Kubernetes.