
PerfectScale
CPU Throttling y OOM Kills en Kubernetes: detecta los picos de arranque
El CPU throttling y los OOM kills que solo aparecen al arrancar un pod se esconden tras los promedios. Las métricas, PromQL y vistas que los revelan.
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Un pico de arranque es la ráfaga de CPU y memoria que necesita un contenedor durante la inicialización (carga de clases, compilación JIT, carga de dependencias, calentamiento de cachés, pools de conexiones) y que desaparece cuando el proceso alcanza el estado estable.
- Los promedios, e incluso el p99 de una semana, lo ocultan. Una ráfaga de 45 segundos dentro de una ventana de 7 días representa menos del 0.01% de las muestras, así que cualquier recomendación basada en el uso combinado dimensiona el pod para la fase equivocada.
- El pico se manifiesta como CPU throttling, OOM kills con código de salida 137, readiness probes fallidas y rollouts lentos que se concentran en el primer minuto de vida del contenedor y luego desaparecen.
- Detéctalo graficando el uso contra la edad del contenedor en lugar del tiempo de reloj, y filtrando las métricas de throttling y OOM a contenedores jóvenes.
- Cuando se pueden ver las dos fases por separado, puedes dimensionar cada una en lugar de elegir qué incidente prefieres.
Tu servicio funciona bien. La CPU está al 15% de su límite, la memoria al 60%, sin alertas. Entonces un rollout reemplaza 40 pods, la mitad sufre throttling durante 50 segundos, tres reciben un OOM kill en el primer arranque, las readiness probes fallan y el rollout se estanca. Diez minutos después todo vuelve a verse saludable y los dashboards no muestran nada fuera de lo común.
Eso es un pico de arranque, y se esconde porque todas las métricas que usas para dimensionar workloads lo promedian hasta hacerlo desaparecer.
¿Qué es un pico de arranque en Kubernetes?
Un pico de arranque es la ventana posterior al inicio de un contenedor en la que este usa mucha más CPU y memoria de las que usará en estado estable. El proceso carga código, lo compila o interpreta, construye su grafo de dependencias, abre pools de conexiones, calienta cachés y corre migraciones. Todo eso consume CPU de forma intensiva y, con frecuencia, también mucha memoria. Cuando termina, el uso cae a una fracción del pico y se mantiene ahí hasta que el pod muere.
La brecha entre las dos fases varía según el runtime. Un servicio de Spring Boot puede quemar entre tres y diez veces su CPU de estado estable durante 10 a 60 segundos mientras trabaja el compilador JIT. Un servicio de Node.js hace lo mismo a menor escala durante la resolución síncrona de require() y el calentamiento de V8. Las apps de Rails y Django gastan su arranque en eager loading y autoloaders. La forma es siempre la misma: un pico corto y pronunciado seguido de una meseta larga y baja.
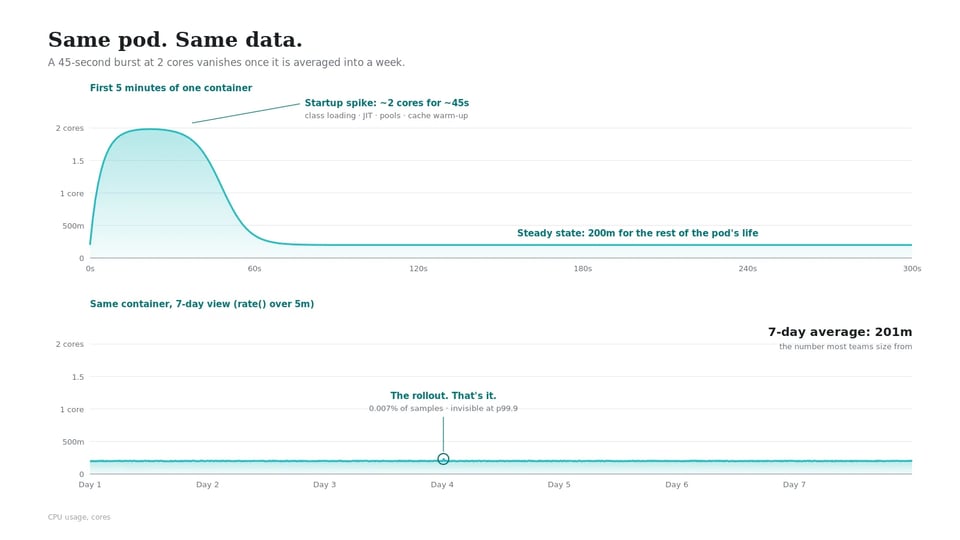
Para Kubernetes no hay diferencia. Los requests y los límites son un solo número por contenedor, aplicado desde el primer milisegundo hasta el último. Así que o dimensionas para el pico y lo pagas en cada réplica para siempre, o dimensionas para la meseta y dejas que el pico se estrelle contra el límite.
Por qué tus dashboards no lo muestran
Los números juegan en tu contra. Toma un pod con una ráfaga de arranque de 45 segundos a 2 núcleos y un estado estable de 200m. A lo largo de un día de 24 horas, su uso promedio de CPU ronda los 201m. El pico agrega menos de un millicore al número que la mayoría de los equipos usa para dimensionar.
Los percentiles tampoco te salvan. Un pico de 45 segundos dentro de una ventana de 7 días cubre alrededor del 0.007% de las muestras. No se registra en p95, p99 ni p99.9. Un VPA que corre con su recomendador predeterminado basado en histogramas recomendará la meseta, y el siguiente rollout sufrirá throttling en la subida.
El intervalo de scrape lo empeora. Un Prometheus que hace scraping cada 30 o 60 segundos puede perderse por completo una ráfaga de 20 segundos, o capturar una sola muestra que rate() suaviza en una ventana de 5 minutos. Tu dashboard muestra una subida suave justo donde el contenedor se estrelló contra un muro.
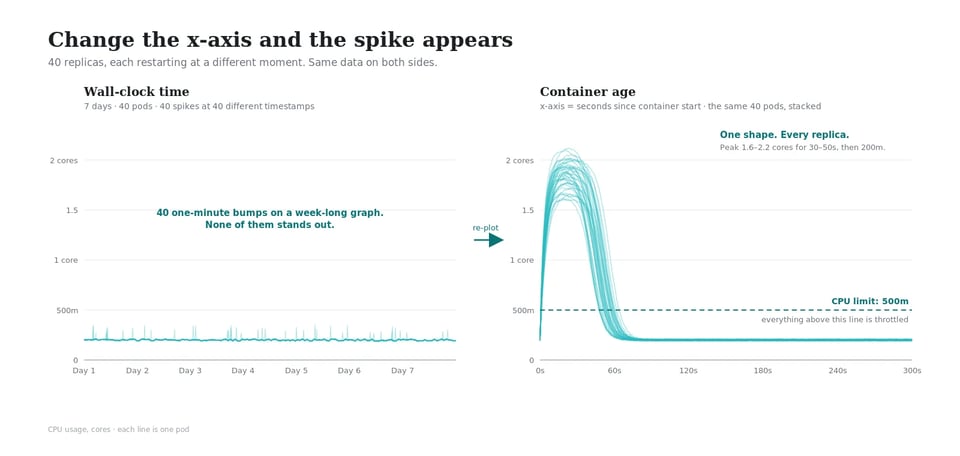
El tiempo de reloj también dispersa la evidencia. Con 40 réplicas que se reinician en momentos distintos, 40 picos caen en 40 marcas de tiempo diferentes, cada uno de apenas un minuto en una gráfica que cubre una semana. Ninguno sobresale.
Dónde aparece el pico: los síntomas que la gente realmente busca
Nadie busca "pico de arranque". La gente busca el incidente que provocó. Cada uno de estos síntomas tiene una explicación de estado estable y una de arranque, y la solución difiere según cuál tengas.
| Síntoma | Lo que ves | Causa en estado estable | Causa en el arranque |
|---|---|---|---|
| CPU throttling | Latencia, arranque lento, nr_throttled subiendo en cpu.stat |
Límite fijado por debajo de la carga sostenida real | Límite dimensionado para el estado estable; el JIT o la carga de módulos agota la cuota CFS en el primer minuto |
| OOMKilled (exit 137) | Last State: Terminated, Reason: OOMKilled, contador de reinicios en 1 |
Fuga de memoria o crecimiento impulsado por la carga | La inicialización asigna más que la meseta; dimensionamiento del heap de la JVM, migraciones, precarga de caché |
| Fallas en readiness probes | Eventos Unhealthy, pod atascado en 0/1 Ready |
La app realmente está caída o sobrecargada | El arranque con throttling empuja el boot más allá de initialDelaySeconds y failureThreshold |
| CrashLoopBackOff | Contador de reinicios subiendo, backoff creciendo | Falla de configuración o de dependencias | OOM de arranque o falla de probe en cada intento, sin llegar nunca al estado estable |
| Rollouts lentos o estancados | kubectl rollout status se cuelga, maxUnavailable agotado |
Capacidad insuficiente del clúster | Los pods nuevos tardan minutos en pasar el readiness porque el arranque corre con throttling |
| HPA inestable | Las réplicas aumentan y enseguida vuelven a reducirse | Ráfagas reales de tráfico | La CPU de arranque de las réplicas nuevas dispara la utilización objetivo, el HPA agrega más réplicas, que también tienen picos |
Lo que separa las dos columnas es el momento en que ocurre. Si el throttling, los OOM kills o las fallas de probes se concentran en los primeros 60 a 120 segundos de vida del contenedor y nunca se repiten, tienes un problema de arranque. Si aparecen en puntos aleatorios de la vida del pod, tienes un problema de dimensionamiento en estado estable. El CPU throttling y el OOMKilled merecen cada uno su propia ruta de diagnóstico, pero la primera pregunta para ambos es la misma: ¿qué edad tenía el contenedor cuando ocurrió?
Las métricas que delatan un pico de arranque
Ya recolectas todo lo que necesitas. El truco está en filtrar por edad del contenedor.
1. CPU throttling en contenedores jóvenes
cAdvisor expone dos contadores por contenedor: container_cpu_cfs_periods_total (cuántos períodos CFS de 100ms transcurrieron) y container_cpu_cfs_throttled_periods_total (en cuántos de esos períodos el contenedor sufrió throttling). La proporción es tu porcentaje de throttling.
Para aislar el arranque, haz un join contra container_start_time_seconds y conserva solo los contenedores con menos de dos minutos de vida:
( rate(container_cpu_cfs_throttled_periods_total{container!=""}[1m]) / rate(container_cpu_cfs_periods_total{container!=""}[1m]))and on (pod, container) (time() - container_start_time_seconds{container!=""}) < 120Compáralo contra la misma proporción para contenedores con más de diez minutos de vida. Un workload que sufre throttling en el 60% de los períodos durante sus primeros dos minutos y en el 2% después tiene un pico de arranque, y subir el request lo soluciona. Un workload con un throttling del 30% todo el día tiene un problema distinto.
También puedes leerlo directamente del nodo. Dentro de un contenedor en ejecución, cat /sys/fs/cgroup/cpu.stat imprime nr_periods, nr_throttled y throttled_usec. Si nr_throttled salta en el primer minuto y luego se congela, el pico está confirmado.
2. OOM kills en el primer arranque
kube-state-metrics te da el motivo de terminación y el código de salida de la instancia anterior del contenedor:
kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} * on (pod, container) group_leftkube_pod_container_status_restarts_totalUn restarts_total de 1 junto a un motivo OOMKilled, repetido en muchos pods justo después de un deploy, apunta a la asignación durante el arranque y no a una fuga, ya que una fuga tarda horas en matar un pod y un OOM de arranque tarda segundos.
Luego mira el working set máximo de los primeros minutos frente al de después:
max_over_time(container_memory_working_set_bytes{container="app"}[5m])Ejecútalo sobre una ventana que incluya un rollout. Si el pico de los primeros cinco minutos queda muy por encima del pico de la hora siguiente, tu límite de memoria tiene que cubrir el número del arranque, no el del estado estable. En workloads con JVM, esto suele deberse a la configuración del heap. Un contenedor con -Xmx fijado en el 75% del límite puede recibir un OOM durante el arranque de todas formas, porque el metaspace, la caché de código y los stacks de hilos quedan fuera del heap.
3. Tiempo hasta ready
La señal más simple es cuánto tarda cada pod en pasar su readiness probe:
kube_pod_status_ready_time - kube_pod_start_timeGrafícalo como histograma entre los pods del mismo Deployment. Un grupo compacto alrededor de los 15 segundos con una cola en los 90 segundos significa que algunos pods cayeron en nodos más ocupados o sufrieron más throttling. Si la cola crece después de ajustar los límites de CPU a la baja, acabas de medir el pico directamente.
Del lado de kubectl, kubectl get events --field-selector reason=Unhealthy -n <namespace> lista las fallas de probes con sus marcas de tiempo. Crúzalas con las horas de inicio de los pods y el patrón salta a la vista.
La vista que lo hace evidente: uso por edad del contenedor
Las gráficas de tiempo de reloj ocultan los picos de arranque porque cada réplica tiene su pico en un momento distinto. Vuelve a graficar los mismos datos con la edad del contenedor en el eje x y los picos se apilan unos sobre otros.
En Grafana, la versión más rápida es un panel filtrado a un solo pod, con el rango de tiempo iniciando en la creación de ese pod. El uso de CPU frente al límite durante los primeros cinco minutos de vida de un pod te lo dice todo: un pico que toca la línea del límite y se aplana significa throttling, y el ancho de esa parte plana es cuánto esperaron tus usuarios.
La mejor versión alinea todas las réplicas en "segundos desde el inicio". Eso requiere una recording rule que etiquete las muestras con buckets de edad, o una herramienta a nivel de workload que perfile el ciclo de vida de cada contenedor por separado. En cualquier caso, el resultado que buscas son dos números por contenedor: el uso máximo en la ventana de arranque y el uso típico después. Con ambos en mano, la decisión de dimensionamiento deja de ser una adivinanza.
Una checklist de detección que puedes correr esta semana
- Elige los workloads que más se reinician. Consulta
increase(kube_pod_container_status_restarts_total[7d])y ordena de forma descendente. Los picos de arranque golpean más fuerte donde más arranques hay. - Verifica si el throttling depende de la edad. Ejecuta la consulta de throttling en contenedores jóvenes de arriba contra los mismos workloads con más de diez minutos de vida. Una brecha grande confirma el pico.
- Revisa el patrón de OOM. Para cualquier workload con
OOMKilledenlast_terminated_reason, mirarestarts_total. Conteos bajos agrupados después de los deploys significan OOM de arranque. - Mide el tiempo hasta ready a lo largo de un rollout. Lanza un rollout en staging, registra el histograma de readiness, luego reduce el límite de CPU a la mitad y repite. El delta es el costo de tu pico en segundos.
- Mira los primeros 300 segundos de un pod. Un panel de Grafana, un pod, uso contra límite. Si la línea se aplana contra el límite, anota cuánto dura.
- Separa los dos números. Para cada workload con picos, registra el máximo de arranque y el p95 en estado estable. La proporción entre ambos te dice cuánto pagas de más si dimensionas para el pico, y cuánto throttling sufres si dimensionas para la meseta.
Las soluciones que lo empeoran sin que lo notes
Algunas respuestas comunes esconden el síntoma en lugar de resolverlo.
Agregar un startupProbe con un failureThreshold generoso detiene el bucle de reinicios, lo cual es la decisión correcta en términos de confiabilidad, pero también apaga la alerta. El pod sigue arrancando con throttling durante 90 segundos y los usuarios siguen esperándolo; solo que dejas de verlo.
Subir el request de CPU para cubrir el pico arregla el throttling y fija esa pérdida en cada réplica por el resto de su vida. En un servicio de 40 réplicas con un pico de 2 núcleos y una meseta de 200m, esa decisión reserva 72 núcleos que permanecen inactivos el 99.9% del tiempo. También perjudica el bin-packing, ya que el scheduler ubica los pods según el request, y los requests inflados significan menos pods por nodo y más nodos de los que necesitas.
Eliminar los límites de CPU por completo, lo que PerfectScale recomienda para la mayoría de los workloads en la guía de límites de CPU, sí permite que el arranque aproveche la capacidad inactiva del nodo. Ayuda, y suele ser el default correcto. Pero solo funciona cuando el nodo tiene CPU inactiva en el momento en que el pod arranca. Durante un rollout, cuando 20 pods nuevos caen en el mismo nodo recién creado y todos empiezan a compilar a la vez, no hay CPU inactiva que aprovechar. El pico regresa en forma de contención en lugar de throttling.
Cada una de estas es una jugada razonable por sí sola. El problema es que las tres siguen tratando al contenedor como un solo número cuando su uso tiene dos formas distintas.
Dimensionar para dos fases en lugar de una
Kubernetes ya tiene la primitiva que hace posible un enfoque de dos fases. El resize de pods in-place, que permite cambiar los requests y límites de un contenedor en ejecución sin reiniciarlo, se volvió estable en 1.35 y viene activado por defecto en 1.36 (PerfectScale probó la alpha allá por 2024, con bugs incluidos). GKE ya lo usa para su función de startup CPU boost. El patrón es simple: dale al pod lo que necesita para arrancar y quítaselo cuando alcance el estado estable.
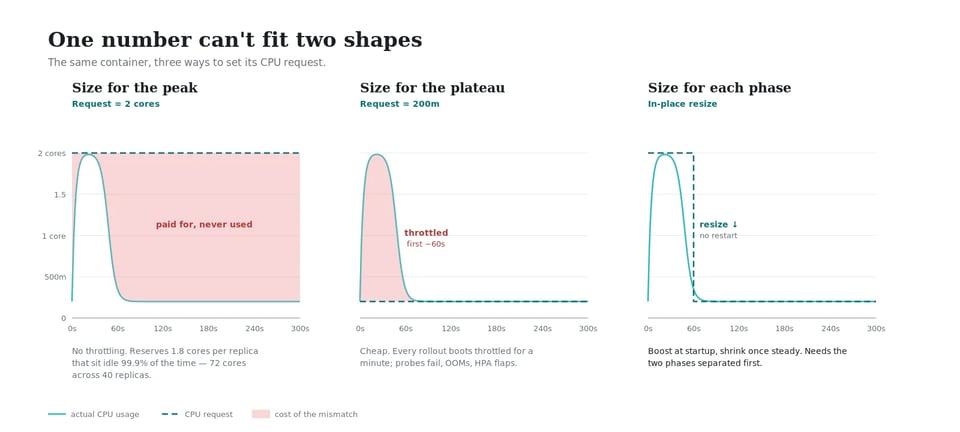
Eso solo funciona si puedes distinguir las dos fases desde el principio, que es justo para lo que sirve todo lo anterior.
Preguntas frecuentes
¿Qué es el CPU throttling en Kubernetes? El CPU throttling ocurre cuando un contenedor intenta usar más tiempo de CPU del que su límite permite dentro de un período de scheduling de CFS (100ms por defecto). El kernel pausa el contenedor hasta que empieza el siguiente período. Un límite de 500m deja que un contenedor corra 50ms de cada 100ms; si lo agota temprano, el contenedor espera. El throttling ralentiza la aplicación sin tumbarla, y puede ocurrir incluso cuando el nodo tiene CPU inactiva.
¿Por qué mi pod recibe un OOM kill solo durante el arranque? La inicialización suele asignar más memoria que la operación en estado estable: cargar clases, construir cachés, correr migraciones o dimensionar un heap de JVM antes de que la aplicación conozca su working set real. Si el límite de memoria cubre el número del estado estable pero no el pico de arranque, el kernel mata el contenedor durante el boot con código de salida 137. Una vez que sobrevive al arranque, el uso cae por debajo del límite y el pod funciona con normalidad; por eso el contador de reinicios suele detenerse en uno o dos.
¿Cómo distingo un pico de arranque de un problema de dimensionamiento en estado estable? Filtra tus métricas de throttling y OOM por edad del contenedor. Si los problemas se concentran en los primeros uno o dos minutos de vida del contenedor y desaparecen después, es un pico de arranque. Si ocurren en puntos aleatorios a lo largo de la vida del pod, el request o el límite de estado estable está mal.
¿Eliminar los límites de CPU soluciona el throttling de arranque? Elimina la cuota de CFS, así que el contenedor puede aprovechar la CPU inactiva que tenga el nodo. Eso ayuda cuando los nodos tienen margen. No ayuda durante un rollout en el que muchos pods arrancan en el mismo nodo al mismo tiempo, porque no hay CPU inactiva que aprovechar. El request sigue determinando el scheduling, así que un request subdimensionado puede seguir colocando demasiados pods con picos en un mismo nodo.
Ver las dos fases de cada workload
Todo lo anterior lo puedes construir a mano con Prometheus, kube-state-metrics y unos cuantos paneles de Grafana. Lo difícil es hacerlo para 400 workloads y mantenerlo al día mientras los cambios de código mueven el pico de lugar.
PerfectScale by DoiT perfila cada contenedor a nivel de workload, de modo que el comportamiento de arranque y el de estado estable aparecen como patrones separados en lugar de un promedio mezclado. Para los workloads de Java profundiza una capa más: con el agente de Coroot habilitado, detecta automáticamente los contenedores con JVM y rastrea el heap, el non-heap y el tiempo de GC a lo largo del tiempo, marca los contenedores que corren sin configuración explícita del heap, y respeta -Xms y -Xmx cuando propone una recomendación o aplica un cambio. En clústeres con Kubernetes 1.33 o posterior, su automatización aplica el right-sizing in-place, sin reiniciar el pod, y recurre a un rolling restart solo cuando un resize no es viable en el nodo actual.
¿Quieres ver en vivo cómo se aplana el pico de arranque? Únete al workshop sobre el pico de arranque de la JVM, donde recorremos lo que pasa dentro de la JVM durante el boot y redimensionamos un pod en ejecución hasta su estado estable sin reinicios. O agenda una sesión técnica y revisamos tus clústeres juntos.