
PerfectScale
CPU throttling et OOM kills : débusquez les pics de démarrage Kubernetes
Le CPU throttling et les OOM kills qui ne frappent qu'au démarrage des pods se cachent derrière les moyennes. Voici les métriques, requêtes PromQL et vues qui les révèlent.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Un pic de démarrage est la rafale de CPU et de mémoire dont un conteneur a besoin pendant son initialisation (chargement des classes, compilation JIT, chargement des dépendances, préchauffage des caches, pools de connexions) et qui retombe une fois le processus en régime stable.
- Les moyennes, et même un p99 sur une semaine, le masquent. Une rafale de 45 secondes dans une fenêtre de 7 jours représente moins de 0,01 % des échantillons : toute recommandation fondée sur un usage moyenné dimensionne le pod pour la mauvaise phase.
- Le pic se manifeste par du CPU throttling, des OOM kills avec le code de sortie 137, des readiness probes en échec et des rollouts lents, tous concentrés dans la première minute de vie du conteneur, avant de disparaître.
- Détectez-le en traçant l'utilisation en fonction de l'âge du conteneur plutôt que du temps horloge, et en filtrant les métriques de throttling et d'OOM sur les conteneurs récents.
- Une fois les deux phases visibles séparément, vous pouvez dimensionner chacune d'elles au lieu de choisir l'incident que vous préférez subir.
Votre service tourne sans accroc. Le CPU est à 15 % de sa limite, la mémoire à 60 %, aucune alerte. Puis un rollout remplace 40 pods : la moitié subit du throttling pendant 50 secondes, trois sont tués par OOM dès le premier boot, les readiness probes échouent et le rollout se bloque. Dix minutes plus tard, tout semble à nouveau sain et les dashboards n'affichent rien d'anormal.
C'est un pic de démarrage, et il passe inaperçu parce que chaque métrique utilisée pour dimensionner les workloads le dilue dans la moyenne.
Qu'est-ce qu'un pic de démarrage Kubernetes ?
Un pic de démarrage est la fenêtre qui suit le lancement d'un conteneur, pendant laquelle il consomme bien plus de CPU et de mémoire qu'en régime stable. Le processus charge le code, le compile ou l'interprète, construit son graphe de dépendances, ouvre des pools de connexions, préchauffe les caches et exécute des migrations. Tout cela est gourmand en CPU, et souvent en mémoire. Une fois terminé, l'utilisation retombe à une fraction du pic et y reste jusqu'à la mort du pod.
L'écart entre les deux phases varie selon le runtime. Un service Spring Boot peut consommer trois à dix fois son CPU de régime stable pendant 10 à 60 secondes, le temps que le compilateur JIT fasse son travail. Un service Node.js fait de même à plus petite échelle pendant la résolution synchrone des require() et le warmup de V8. Les applications Rails et Django passent leur démarrage en eager loading et autoloaders. Le profil est toujours le même : un pic court et brutal suivi d'un long plateau bas.
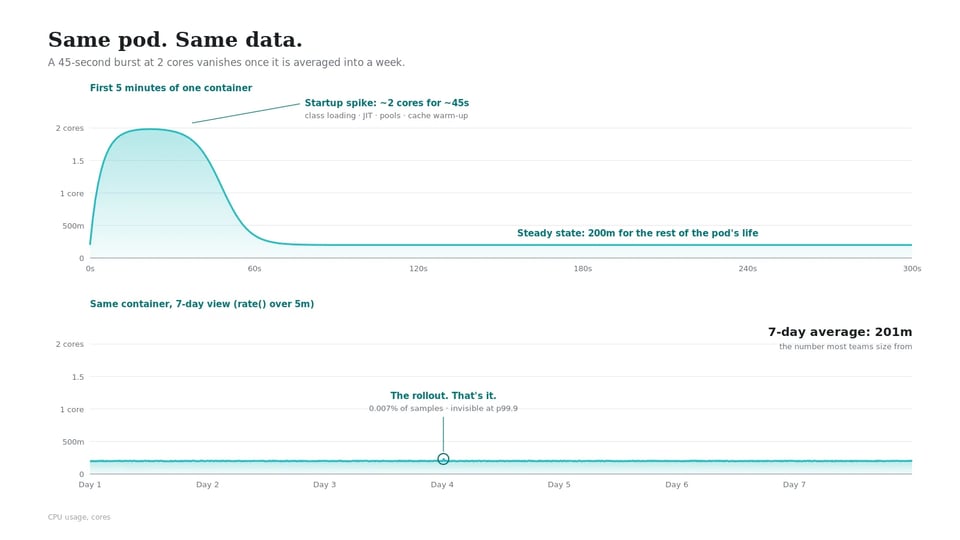
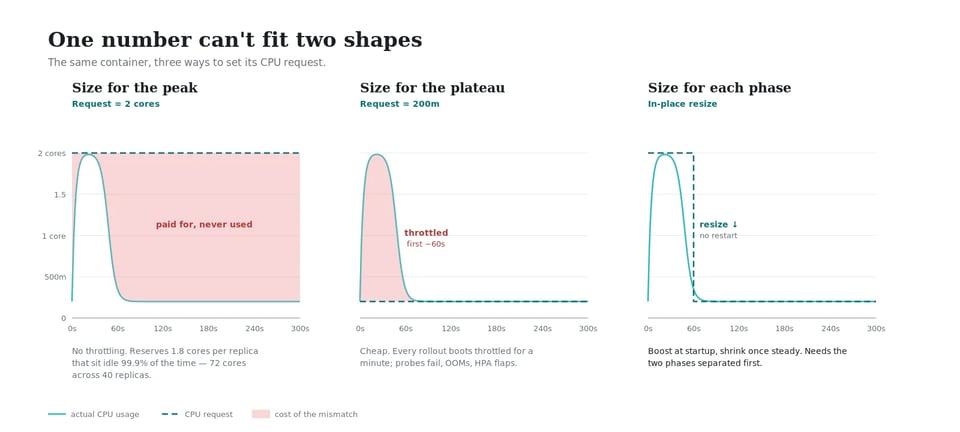
Kubernetes ne fait pas la différence. Les requests et limits sont un seul chiffre par conteneur, appliqué de la première milliseconde à la dernière. Vous dimensionnez donc soit pour le pic, et vous le payez sur chaque réplica indéfiniment, soit pour le plateau, et vous laissez le pic buter contre la limite.
Pourquoi vos dashboards ne le montrent pas
Les chiffres jouent contre vous. Prenez un pod avec une rafale de démarrage de 45 secondes à 2 cœurs et un régime stable de 200m. Sur une journée de 24 heures, sa moyenne d'utilisation CPU s'établit à environ 201m. Le pic ajoute moins d'un millicœur au chiffre à partir duquel la plupart des équipes dimensionnent.
Les percentiles ne vous sauvent pas davantage. Un pic de 45 secondes dans une fenêtre de 7 jours couvre environ 0,007 % des échantillons. Il n'apparaît ni au p95, ni au p99, ni au p99,9. Un VPA avec son recommender par défaut, fondé sur des histogrammes, recommandera le plateau, et le prochain rollout subira du throttling au démarrage.
L'intervalle de scrape aggrave les choses. Un Prometheus qui scrape toutes les 30 ou 60 secondes peut manquer entièrement une rafale de 20 secondes, ou n'en capter qu'un seul échantillon, lissé ensuite par rate() sur une fenêtre de 5 minutes. Votre dashboard affiche une bosse discrète là où le conteneur a heurté un mur.
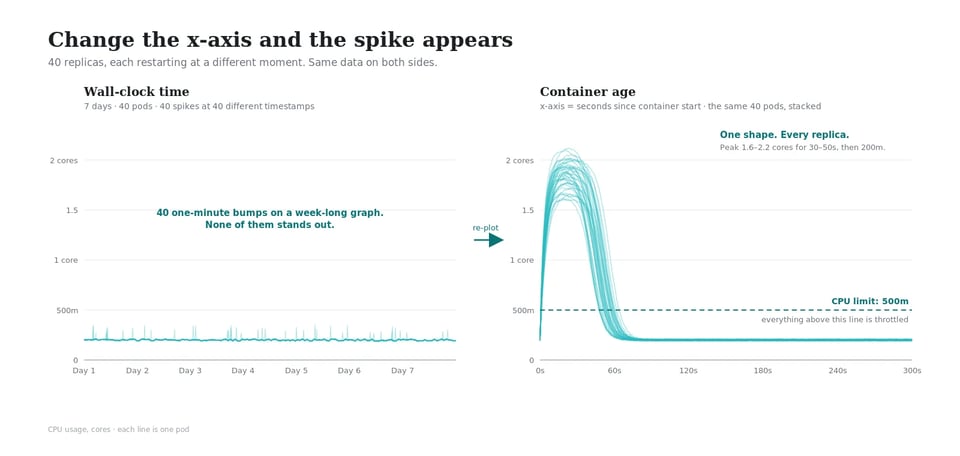
Le temps horloge disperse aussi les preuves. Avec 40 réplicas qui redémarrent à des moments différents, 40 pics atterrissent à 40 horodatages différents, chacun durant environ une minute sur un graphe couvrant une semaine. Aucun ne ressort.
Où le pic fait surface : les symptômes que l'on recherche vraiment
Personne ne cherche pic de démarrage. On cherche l'incident qu'il a causé. Chacun de ces symptômes a une explication en régime stable et une explication au démarrage, et le correctif diffère selon le cas.
| Symptôme | Ce que vous voyez | Cause en régime stable | Cause au démarrage |
|---|---|---|---|
| CPU throttling | Latence, boot lent, nr_throttled qui grimpe dans cpu.stat |
Limite fixée sous la charge soutenue réelle | Limite dimensionnée pour le régime stable ; le JIT ou le chargement des modules sature le quota CFS dans la première minute |
| OOMKilled (exit 137) | Last State: Terminated, Reason: OOMKilled, compteur de redémarrages à 1 |
Fuite mémoire ou croissance liée à la charge | L'initialisation alloue plus que le plateau ; dimensionnement du heap JVM, migration, préchargement de cache |
| Échecs de readiness probe | Événements Unhealthy, pod bloqué en 0/1 Ready |
L'application est réellement down ou surchargée | Le démarrage sous throttling pousse le boot au-delà de initialDelaySeconds et failureThreshold |
| CrashLoopBackOff | Compteur de redémarrages en hausse, backoff croissant | Échec de configuration ou de dépendance | OOM au démarrage ou échec de probe à chaque tentative, sans jamais atteindre le régime stable |
| Rollouts lents ou bloqués | kubectl rollout status ne rend pas la main, maxUnavailable épuisé |
Capacité de cluster insuffisante | Les nouveaux pods mettent des minutes à passer la readiness parce que le démarrage tourne sous throttling |
| HPA instable | Les réplicas montent en nombre, puis redescendent aussitôt | Vraies rafales de trafic | Le CPU de démarrage des nouveaux réplicas fait dépasser l'utilisation cible, le HPA en ajoute d'autres, dont le démarrage provoque à son tour un pic |
C'est le timing qui départage les deux colonnes. Si le throttling, les OOM kills ou les échecs de probe se concentrent dans les 60 à 120 premières secondes de vie du conteneur et ne reviennent jamais, vous avez un problème de démarrage. S'ils surviennent à des moments aléatoires de la vie du pod, vous avez un problème de dimensionnement en régime stable. Le CPU throttling et l'OOMKilled méritent chacun leur propre démarche de troubleshooting, mais la première question est la même pour les deux : quel âge avait le conteneur au moment des faits ?
Les métriques qui révèlent un pic de démarrage
Vous collectez déjà tout ce qu'il faut. L'astuce consiste à filtrer par âge de conteneur.
1. CPU throttling dans les conteneurs récents
cAdvisor expose deux compteurs par conteneur : container_cpu_cfs_periods_total (combien de périodes CFS de 100 ms se sont écoulées) et container_cpu_cfs_throttled_periods_total (combien de ces périodes ont été throttlées). Le ratio donne votre pourcentage de throttling.
Pour isoler le démarrage, effectuez une jointure sur container_start_time_seconds et ne gardez que les conteneurs de moins de deux minutes :
( rate(container_cpu_cfs_throttled_periods_total{container!=""}[1m]) / rate(container_cpu_cfs_periods_total{container!=""}[1m]))and on (pod, container) (time() - container_start_time_seconds{container!=""}) < 120Comparez ce ratio à celui des conteneurs de plus de dix minutes. Un workload throttlé sur 60 % des périodes pendant ses deux premières minutes et sur 2 % ensuite a un pic de démarrage, et augmenter la request le corrigera. Un workload throttlé 30 % du temps toute la journée a un autre problème.
Vous pouvez aussi le lire directement sur le nœud. Dans un conteneur en cours d'exécution, cat /sys/fs/cgroup/cpu.stat affiche nr_periods, nr_throttled et throttled_usec. Si nr_throttled bondit dans la première minute puis se fige, le pic est confirmé.
2. OOM kills au premier boot
kube-state-metrics vous donne la raison de terminaison et le code de sortie de l'instance précédente du conteneur :
kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} * on (pod, container) group_leftkube_pod_container_status_restarts_totalUn restarts_total à 1 à côté d'une raison OOMKilled, répété sur de nombreux pods juste après un déploiement, pointe vers une allocation au démarrage plutôt qu'une fuite : une fuite met des heures à tuer un pod, un OOM de démarrage prend quelques secondes.
Regardez ensuite le pic de working set sur les premières minutes, comparé à la suite :
max_over_time(container_memory_working_set_bytes{container="app"}[5m])Exécutez cette requête sur une fenêtre incluant un rollout. Si le pic des cinq premières minutes se situe bien au-dessus du pic de l'heure suivante, votre limite mémoire doit couvrir le chiffre du démarrage, pas celui du régime stable. Pour les workloads JVM, cela remonte souvent aux réglages de heap. Un conteneur avec -Xmx fixé à 75 % de la limite peut quand même partir en OOM au démarrage, parce que la metaspace, le code cache et les piles de threads vivent hors du heap.
3. Délai avant readiness
Le signal le plus simple est le temps que met chaque pod à passer sa readiness probe :
kube_pod_status_ready_time - kube_pod_start_timeTracez-le en histogramme sur les pods d'un même Deployment. Un groupe serré autour de 15 secondes avec une traîne à 90 secondes signifie que certains pods ont atterri sur des nœuds plus chargés ou ont subi un throttling plus sévère. Si la traîne s'allonge après que vous avez resserré les limites CPU, vous venez de mesurer le pic directement.
Côté kubectl, kubectl get events --field-selector reason=Unhealthy -n <namespace> liste les échecs de probe avec leurs horodatages. Croisez-les avec les heures de démarrage des pods et le schéma saute aux yeux.
La vue qui rend tout évident : l'utilisation par âge de conteneur
Les graphes en temps horloge masquent les pics de démarrage parce que chaque réplica atteint son pic à un moment différent. Retracez les mêmes données avec l'âge du conteneur en abscisse et les pics s'empilent les uns sur les autres.
Dans Grafana, la version la plus rapide est un panel filtré sur un seul pod, avec une plage temporelle qui démarre à la création de ce pod. L'utilisation CPU rapportée à la limite pendant les cinq premières minutes de vie d'un pod dit tout : un pic qui touche la ligne de limite et s'aplatit signifie throttling, et la largeur de ce plateau correspond au temps que vos utilisateurs ont attendu.
La meilleure version aligne tous les réplicas sur les secondes depuis le démarrage. Cela demande soit une recording rule qui étiquette les échantillons par tranche d'âge, soit un outil au niveau workload qui profile séparément le cycle de vie de chaque conteneur. Dans les deux cas, le résultat recherché tient en deux chiffres par conteneur : le pic d'utilisation dans la fenêtre de démarrage, et l'utilisation typique ensuite. Avec les deux en main, la décision de dimensionnement cesse d'être un pari.
Une checklist de détection à dérouler dès cette semaine
- Choisissez les workloads qui redémarrent le plus. Interrogez
increase(kube_pod_container_status_restarts_total[7d])et triez par ordre décroissant. Les pics de démarrage font le plus mal là où les démarrages sont les plus fréquents. - Vérifiez si le throttling dépend de l'âge. Exécutez la requête de throttling des conteneurs récents ci-dessus sur les mêmes workloads âgés de plus de dix minutes. Un écart important confirme le pic.
- Vérifiez le schéma des OOM. Pour tout workload avec
OOMKilleddanslast_terminated_reason, regardezrestarts_total. Des comptes faibles, groupés après les déploiements, signalent un OOM de démarrage. - Mesurez le délai avant readiness sur un rollout. Déclenchez un rollout en staging, enregistrez l'histogramme de readiness, puis divisez la limite CPU par deux et recommencez. Le delta est le coût de votre pic, en secondes.
- Regardez les 300 premières secondes d'un seul pod. Un panel Grafana, un pod, l'utilisation rapportée à la limite. Si la ligne s'aplatit contre la limite, notez pendant combien de temps.
- Séparez les deux chiffres. Pour chaque workload sujet aux pics, notez le pic de démarrage et le p95 du régime stable. Le ratio entre les deux vous dit combien vous surpayez si vous dimensionnez pour le pic, et l'ampleur du throttling si vous dimensionnez pour le plateau.
Les correctifs qui aggravent discrètement le problème
Quelques réponses courantes masquent le symptôme au lieu de le résoudre.
Ajouter une startupProbe avec un failureThreshold généreux arrête la boucle de redémarrage, ce qui est le bon choix pour la fiabilité, mais arrête aussi l'alerte. Le pod boote toujours sous throttling pendant 90 secondes et les utilisateurs l'attendent toujours ; simplement, vous ne le voyez plus.
Augmenter la request CPU pour couvrir le pic corrige le throttling et fige le gaspillage sur chaque réplica pour le reste de sa vie. Sur un service de 40 réplicas avec un pic à 2 cœurs et un plateau à 200m, cette décision réserve 72 cœurs qui restent inutilisés 99,9 % du temps. Elle pénalise aussi le bin-packing : le scheduler place les pods selon la request, et des requests gonflées signifient moins de pods par nœud et plus de nœuds que nécessaire.
Supprimer entièrement les limites CPU, ce que PerfectScale recommande pour la plupart des workloads dans le guide des limites CPU, permet effectivement au démarrage de puiser dans la capacité inutilisée du nœud. Cela aide, et c'est généralement le bon réglage par défaut. Mais cela ne fonctionne que si le nœud dispose de CPU inoccupé au moment où le pod démarre. Pendant un rollout, quand 20 nouveaux pods atterrissent sur le même nœud fraîchement créé et se mettent tous à compiler en même temps, il n'y a aucun CPU inoccupé disponible. Le pic revient sous forme de contention plutôt que de throttling.
Chacune de ces mesures est raisonnable prise isolément. Le problème : toutes trois continuent de traiter le conteneur comme un seul chiffre, alors que son utilisation suit deux profils distincts.
Dimensionner pour deux phases plutôt qu'une
Kubernetes dispose désormais de la primitive qui rend possible une approche en deux phases. Le redimensionnement de pod à chaud (in-place pod resize), qui permet de modifier les requests et limits d'un conteneur en cours d'exécution sans le redémarrer, est passé en stable avec la version 1.35 et est activé par défaut en 1.36 (PerfectScale avait testé l'alpha dès 2024, bugs compris). GKE l'utilise déjà pour sa fonctionnalité de startup CPU boost. Le principe est simple : donner au pod ce dont il a besoin pour booter, puis récupérer ces ressources une fois le régime stable atteint.
Encore faut-il pouvoir distinguer les deux phases, et c'est précisément à cela que sert tout ce qui précède.
FAQ
Qu'est-ce que le CPU throttling dans Kubernetes ? Le CPU throttling survient quand un conteneur tente d'utiliser plus de temps CPU que sa limite ne l'autorise au sein d'une période d'ordonnancement CFS (100 ms par défaut). Le noyau met le conteneur en pause jusqu'au début de la période suivante. Une limite de 500m autorise un conteneur à tourner 50 ms sur chaque tranche de 100 ms ; épuisez ce crédit trop tôt et le conteneur attend. Le throttling ralentit l'application sans la faire planter, et il peut se produire même quand le nœud dispose de CPU inoccupé.
Pourquoi mon pod est-il tué par OOM uniquement au démarrage ? L'initialisation alloue souvent plus de mémoire que le fonctionnement en régime stable : chargement des classes, construction des caches, exécution des migrations ou dimensionnement d'un heap JVM avant que l'application ne connaisse son véritable working set. Si la limite mémoire couvre le chiffre du régime stable mais pas le pic de démarrage, le noyau tue le conteneur pendant le boot avec le code de sortie 137. Une fois le démarrage passé, l'utilisation retombe sous la limite et le pod tourne normalement, raison pour laquelle le compteur de redémarrages s'arrête généralement à un ou deux.
Comment distinguer un pic de démarrage d'un problème de dimensionnement en régime stable ? Filtrez vos métriques de throttling et d'OOM par âge de conteneur. Si les problèmes se concentrent dans la première ou les deux premières minutes de vie du conteneur et disparaissent ensuite, c'est un pic de démarrage. S'ils surviennent à des moments aléatoires de la vie du pod, c'est la request ou la limit de régime stable qui est mal réglée.
Supprimer les limites CPU corrige-t-il le throttling au démarrage ? Cela supprime le quota CFS : le conteneur peut alors puiser dans le CPU inoccupé du nœud. Cela aide quand les nœuds ont de la marge. Cela n'aide pas pendant un rollout, quand de nombreux pods démarrent simultanément sur le même nœud, car il n'y a alors aucun CPU inoccupé disponible. La request détermine toujours le scheduling : une request sous-dimensionnée peut donc encore faire atterrir trop de pods sujets aux pics sur un même nœud.
Voir les deux phases de chaque workload
Tout ce qui précède peut se construire à la main avec Prometheus, kube-state-metrics et quelques panels Grafana. Le plus dur est de le faire pour 400 workloads et de le maintenir à jour quand les évolutions du code déplacent le pic.
PerfectScale by DoiT profile chaque conteneur au niveau du workload : le comportement au démarrage et le comportement en régime stable apparaissent comme deux profils distincts plutôt que comme une moyenne diluée. Pour les workloads Java, l'analyse va un cran plus loin : une fois l'agent Coroot activé, PerfectScale détecte automatiquement les conteneurs JVM et suit dans la durée le heap, le non-heap et le temps de GC, signale les conteneurs qui tournent sans réglages de heap explicites, et respecte -Xms et -Xmx lorsqu'il émet une recommandation ou applique un changement. Sur les clusters en Kubernetes 1.33 ou ultérieur, son automatisation applique le right-sizing à chaud, sans redémarrer le pod, et ne recourt à un rolling restart que lorsqu'un redimensionnement n'est pas possible sur le nœud courant.
Envie de voir le pic de démarrage aplati en direct ? Rejoignez le workshop sur le pic de démarrage JVM, où nous détaillons ce qui se passe dans la JVM au boot et redimensionnons un pod en cours d'exécution vers son régime stable, sans redémarrage. Ou réservez une session technique et nous examinerons vos clusters ensemble.