
PerfectScale
Throttling de CPU e OOM Kills no Kubernetes: encontre os picos de startup
Throttling de CPU e OOM kills que só aparecem no startup dos pods se escondem nas médias. As métricas, o PromQL e as visualizações que os revelam.
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Um pico de startup é o burst de CPU e memória de que um container precisa durante a inicialização (carregamento de classes, compilação JIT, carregamento de dependências, aquecimento de caches, pools de conexão) e que desaparece quando o processo atinge o estado estável.
- Médias e até o p99 de uma semana escondem o pico. Um burst de 45 segundos dentro de uma janela de 7 dias representa menos de 0,01% das amostras, então qualquer recomendação baseada no uso misturado dimensiona o pod para a fase errada.
- O pico se manifesta como throttling de CPU, OOM kills com exit code 137, falhas de readiness probe e rollouts lentos, todos concentrados no primeiro minuto de vida do container — e depois desaparecem.
- Para detectá-lo, plote o uso em função da idade do container em vez do tempo de relógio, e filtre as métricas de throttling e OOM para containers jovens.
- Quando você consegue ver as duas fases separadamente, pode dimensionar para cada uma delas em vez de escolher qual incidente prefere.
Seu serviço roda bem. A CPU fica em 15% do limite, a memória em 60%, nenhum alerta. Aí um rollout substitui 40 pods, metade deles sofre throttling por 50 segundos, três levam OOM kill logo no primeiro boot, as readiness probes falham e o rollout trava. Dez minutos depois tudo parece saudável de novo e os dashboards não mostram nada fora do normal.
Isso é um pico de startup, e ele se esconde porque toda métrica que você usa para dimensionar workloads o dilui na média.
O que é um pico de startup no Kubernetes?
Um pico de startup é a janela logo após a inicialização de um container em que ele usa muito mais CPU e memória do que usará em estado estável. O processo carrega código, compila ou interpreta, monta seu grafo de dependências, abre pools de conexão, aquece caches e executa migrações. Tudo isso é intensivo em CPU e, muitas vezes, consome bastante memória. Quando termina, o uso cai para uma fração do pico e permanece assim até o pod morrer.
A diferença entre as duas fases varia conforme o runtime. Um serviço Spring Boot pode consumir de três a dez vezes a CPU do estado estável por 10 a 60 segundos enquanto o compilador JIT trabalha. Um serviço Node.js faz o mesmo em menor escala durante a resolução síncrona de require() e o aquecimento do V8. Aplicações Rails e Django gastam o startup com eager loading e autoloaders. O formato é sempre o mesmo: um pico curto e acentuado, seguido de um platô longo e baixo.
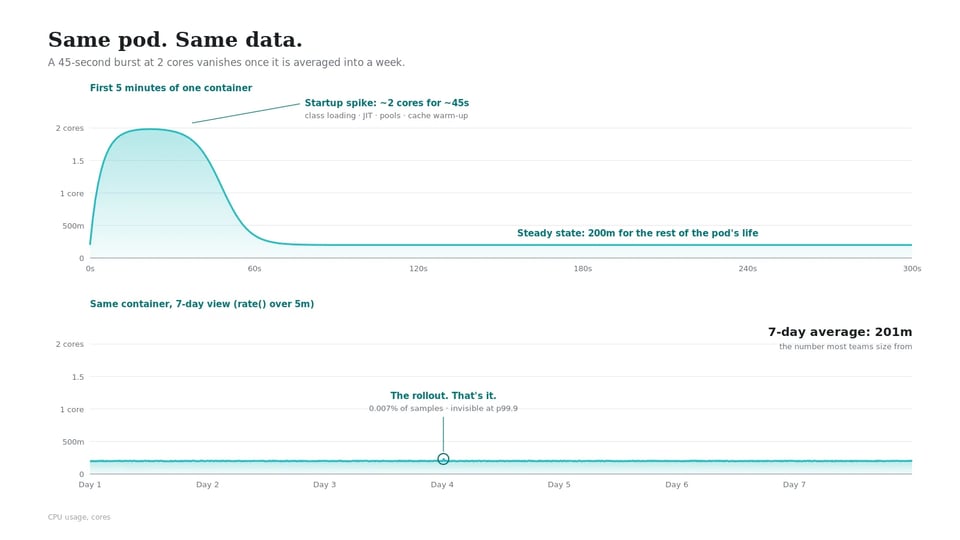
O Kubernetes não enxerga essa diferença. Requests e limits são um único número por container, aplicado do primeiro ao último milissegundo. Então, ou você dimensiona para o pico e paga por ele em cada réplica para sempre, ou dimensiona para o platô e deixa o pico bater no limite.
Por que seus dashboards não mostram o pico
A matemática joga contra você. Pegue um pod com um burst de startup de 45 segundos a 2 cores e um estado estável de 200m. Ao longo de um dia de 24 horas, o uso médio de CPU fica em aproximadamente 201m. O pico adiciona menos de um milicore ao número que a maioria das equipes usa para dimensionar.
Percentis também não salvam. Um pico de 45 segundos dentro de uma janela de 7 dias cobre cerca de 0,007% das amostras. Ele não aparece no p95, no p99 nem no p99,9. Um VPA rodando com seu recommender padrão baseado em histogramas vai recomendar o platô, e o próximo rollout vai sofrer throttling na subida.
O intervalo de scrape piora as coisas. Um Prometheus coletando a cada 30 ou 60 segundos pode perder completamente um burst de 20 segundos, ou capturar uma única amostra que é suavizada pelo rate() em uma janela de 5 minutos. Seu dashboard mostra uma elevação suave onde, na verdade, o container bateu no teto.
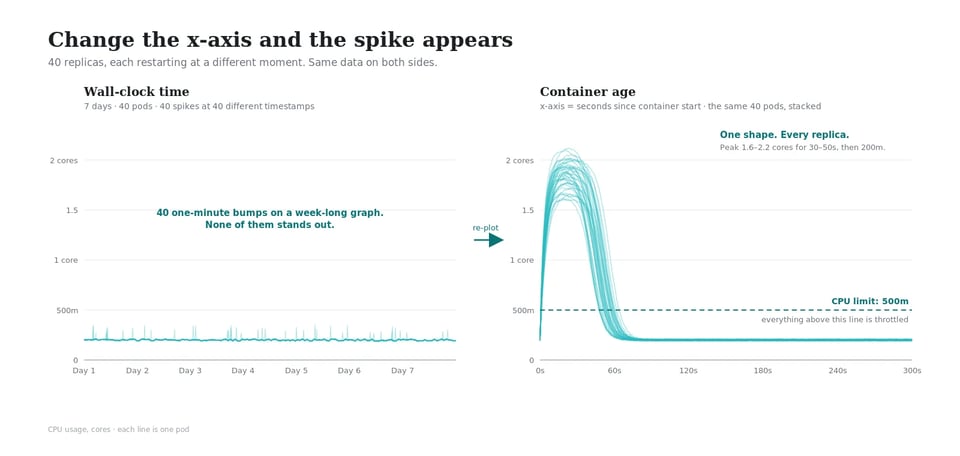
O tempo de relógio também espalha as evidências. Com 40 réplicas que reiniciam em momentos diferentes, 40 picos caem em 40 timestamps distintos, cada um durando cerca de um minuto em um gráfico que cobre uma semana. Nenhum deles se destaca.
Onde o pico aparece: os sintomas que as pessoas realmente pesquisam
Ninguém pesquisa por "pico de startup". As pessoas pesquisam pelo incidente que ele causou. Cada um destes sintomas tem uma explicação de estado estável e uma explicação de startup, e a correção muda dependendo de qual deles você tem.
| Sintoma | O que você vê | Causa em estado estável | Causa no startup |
|---|---|---|---|
| Throttling de CPU | Latência, boot lento, nr_throttled subindo em cpu.stat |
Limite abaixo da carga real sustentada | Limite dimensionado para o estado estável; JIT ou carregamento de módulos estoura a quota do CFS no primeiro minuto |
| OOMKilled (exit 137) | Last State: Terminated, Reason: OOMKilled, contador de restarts em 1 |
Vazamento de memória ou crescimento por carga | A inicialização aloca mais que o platô; dimensionamento de heap da JVM, migração, pré-carregamento de cache |
| Falhas de readiness probe | Eventos Unhealthy, pod preso em 0/1 Ready |
A aplicação está realmente fora do ar ou sobrecarregada | O startup sob throttling empurra o boot para além de initialDelaySeconds e failureThreshold |
| CrashLoopBackOff | Contador de restarts subindo, backoff crescendo | Falha de configuração ou de dependência | OOM no startup ou falha de probe em toda tentativa, sem nunca atingir o estado estável |
| Rollouts lentos ou travados | kubectl rollout status trava, maxUnavailable esgotado |
Capacidade insuficiente no cluster | Pods novos levam minutos para passar no readiness porque o startup roda sob throttling |
| HPA oscilando | As réplicas sobem e logo voltam a cair | Picos reais de tráfego | A CPU de startup das novas réplicas ultrapassa a utilização-alvo, o HPA adiciona mais réplicas, que também têm picos |
O timing separa as duas colunas. Se throttling, OOM kills ou falhas de probe se concentram nos primeiros 60 a 120 segundos de vida do container e nunca mais se repetem, você tem um problema de startup. Se aparecem em momentos aleatórios da vida do pod, você tem um problema de dimensionamento em estado estável. Throttling de CPU e OOMKilled merecem, cada um, seu próprio caminho de troubleshooting, mas a primeira pergunta para ambos é a mesma: qual era a idade do container quando aconteceu?
As métricas que revelam um pico de startup
Você já coleta tudo o que precisa. O truque é filtrar pela idade do container.
1. Throttling de CPU em containers jovens
O cAdvisor expõe dois contadores por container: container_cpu_cfs_periods_total (quantos períodos de CFS de 100ms transcorreram) e container_cpu_cfs_throttled_periods_total (em quantos desses períodos o container sofreu throttling). A razão entre eles é seu percentual de throttling.
Para isolar o startup, faça um join com container_start_time_seconds e mantenha apenas containers com menos de dois minutos de vida:
( rate(container_cpu_cfs_throttled_periods_total{container!=""}[1m]) / rate(container_cpu_cfs_periods_total{container!=""}[1m]))and on (pod, container) (time() - container_start_time_seconds{container!=""}) < 120Compare com a mesma razão para containers com mais de dez minutos. Um workload que sofre throttling em 60% dos períodos nos primeiros dois minutos e em 2% depois disso tem um pico de startup, e aumentar o request resolve. Um workload que sofre throttling em 30% o dia inteiro tem um problema diferente.
Você também pode ler isso direto no node. Dentro de um container em execução, cat /sys/fs/cgroup/cpu.stat imprime nr_periods, nr_throttled e throttled_usec. Se nr_throttled salta no primeiro minuto e depois congela, o pico está confirmado.
2. OOM kills no primeiro boot
O kube-state-metrics fornece o motivo da terminação e o exit code da instância anterior do container:
kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} * on (pod, container) group_leftkube_pod_container_status_restarts_totalUm restarts_total igual a 1 ao lado de um motivo OOMKilled, repetido em muitos pods logo após um deploy, aponta para alocação no startup e não para um vazamento, já que um vazamento leva horas para matar um pod e um OOM de startup leva segundos.
Em seguida, compare o pico do working set nos primeiros minutos com o período posterior:
max_over_time(container_memory_working_set_bytes{container="app"}[5m])Execute a consulta em uma janela que inclua um rollout. Se o pico dos primeiros cinco minutos fica bem acima do pico da hora seguinte, seu limite de memória precisa cobrir o número do startup, não o do estado estável. Em workloads JVM, isso costuma remeter às configurações de heap. Um container com -Xmx em 75% do limite ainda pode sofrer OOM durante o startup, porque metaspace, code cache e stacks de threads ficam fora do heap.
3. Tempo até o ready
O sinal mais simples é quanto tempo cada pod leva para passar na readiness probe:
kube_pod_status_ready_time - kube_pod_start_timePlote isso como um histograma entre os pods do mesmo Deployment. Um agrupamento concentrado em torno de 15 segundos com uma cauda em 90 segundos significa que alguns pods caíram em nodes mais ocupados ou sofreram throttling mais forte. Se a cauda cresce depois que você aperta os limites de CPU, você acabou de medir o pico diretamente.
No lado do kubectl, kubectl get events --field-selector reason=Unhealthy -n <namespace> lista as falhas de probe com timestamps. Cruze com os horários de início dos pods e o padrão salta aos olhos.
A visualização que torna tudo óbvio: uso por idade do container
Gráficos em tempo de relógio escondem picos de startup porque cada réplica tem seu pico em um momento diferente. Plote os mesmos dados de novo com a idade do container no eixo x e eles se empilham uns sobre os outros.
No Grafana, a versão mais rápida é um painel filtrado para um único pod, com o intervalo de tempo começando na criação daquele pod. Uso de CPU versus limite nos primeiros cinco minutos de vida de um pod diz tudo: um pico que encosta na linha do limite e se achata significa throttling, e a largura desse topo achatado é quanto tempo seus usuários esperaram.
Uma versão melhor alinha todas as réplicas em "segundos desde o início". Isso exige uma recording rule que marque as amostras com buckets de idade, ou uma ferramenta em nível de workload que faça o profiling do ciclo de vida de cada container separadamente. De qualquer forma, o resultado que você quer são dois números por container: pico de uso na janela de startup e uso típico depois dela. Com os dois em mãos, a decisão de dimensionamento deixa de ser um chute.
Um checklist de detecção para rodar esta semana
- Escolha os workloads que mais reiniciam. Consulte
increase(kube_pod_container_status_restarts_total[7d])e ordene de forma decrescente. Picos de startup doem mais onde o startup acontece mais. - Verifique se o throttling depende da idade. Rode a consulta de throttling em containers jovens acima contra os mesmos workloads com mais de dez minutos. Uma diferença grande confirma o pico.
- Verifique o padrão de OOM. Para qualquer workload com
OOMKilledemlast_terminated_reason, olhe orestarts_total. Contagens baixas concentradas logo após deploys significam OOM de startup. - Meça o tempo até o ready durante um rollout. Dispare um rollout em staging, registre o histograma de readiness, depois reduza o limite de CPU pela metade e rode de novo. O delta é o custo do seu pico em segundos.
- Olhe os primeiros 300 segundos de um pod. Um painel do Grafana, um pod, uso versus limite. Se a linha se achata contra o limite, anote por quanto tempo.
- Separe os dois números. Para cada workload com picos, registre o pico de startup e o p95 do estado estável. A razão entre eles mostra quanto você paga a mais ao dimensionar para o pico — e quanto throttling sofre ao dimensionar para o platô.
As correções que silenciosamente pioram tudo
Algumas respostas comuns escondem o sintoma em vez de resolvê-lo.
Adicionar um startupProbe com um failureThreshold generoso interrompe o loop de restarts, o que é a decisão certa para a confiabilidade, mas também interrompe o alerta. O pod continua inicializando sob throttling por 90 segundos e os usuários continuam esperando por ele; você só deixa de ver.
Aumentar o request de CPU para cobrir o pico corrige o throttling e perpetua o desperdício em cada réplica pelo resto da vida dela. Em um serviço com 40 réplicas, um pico de 2 cores e um platô de 200m, essa decisão reserva 72 cores que ficam ociosos 99,9% do tempo. Também prejudica o bin-packing, já que o scheduler aloca pods pelo request, e requests inflados significam menos pods por node e mais nodes do que você precisa.
Remover completamente os limites de CPU, o que o PerfectScale recomenda para a maioria dos workloads no guia de limites de CPU, permite que o startup use a capacidade ociosa do node em burst. Ajuda, e geralmente é o padrão certo. Mas só funciona quando o node tem CPU ociosa no momento em que o pod inicia. Durante um rollout, quando 20 pods novos caem no mesmo node recém-criado e todos começam a compilar ao mesmo tempo, não há CPU ociosa para absorver o burst. O pico volta como contenção em vez de throttling.
Cada uma dessas medidas é razoável por si só. O problema é que as três continuam tratando o container como um único número quando o uso dele tem dois formatos distintos.
Dimensionando para duas fases em vez de uma
O Kubernetes agora tem a primitiva que torna possível uma abordagem em duas fases. O resize in-place de pods, que permite alterar os requests e limits de um container em execução sem reiniciá-lo, ficou estável na versão 1.35 e vem habilitado por padrão na 1.36 (o PerfectScale testou a versão alpha lá em 2024, bugs e tudo mais). O GKE já o utiliza no recurso de startup CPU boost. O padrão é simples: dê ao pod o que ele precisa para inicializar e retire quando ele atingir o estado estável.
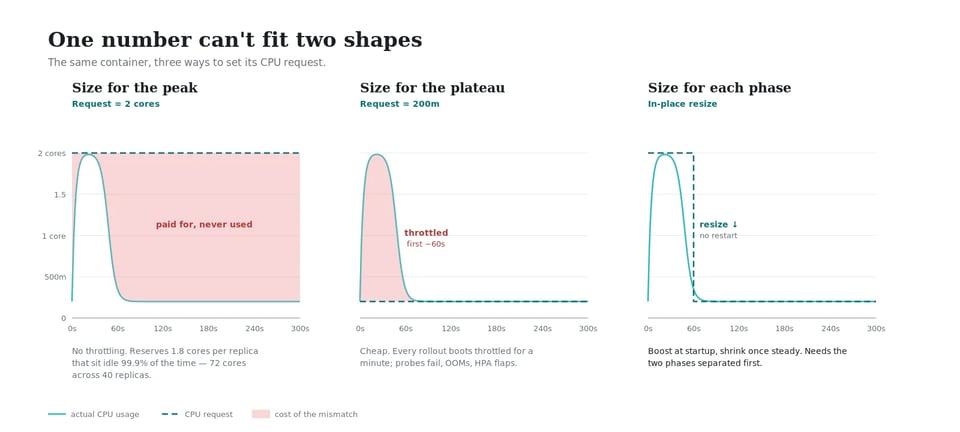
Isso só funciona se você conseguir distinguir as duas fases em primeiro lugar — e é para isso que serve tudo o que foi descrito acima.
FAQ
O que é throttling de CPU no Kubernetes? O throttling de CPU acontece quando um container tenta usar mais tempo de CPU do que seu limite permite dentro de um período de escalonamento do CFS (100ms por padrão). O kernel pausa o container até o início do próximo período. Um limite de 500m permite que um container rode por 50ms a cada 100ms; se gastar isso cedo demais, o container espera. O throttling desacelera a aplicação sem derrubá-la, e pode ocorrer mesmo quando o node tem CPU ociosa.
Por que meu pod leva OOM kill só no startup? A inicialização costuma alocar mais memória do que a operação em estado estável: carregamento de classes, construção de caches, execução de migrações ou dimensionamento do heap da JVM antes de a aplicação conhecer seu working set real. Se o limite de memória cobre o número do estado estável, mas não o pico de startup, o kernel mata o container durante o boot com exit code 137. Depois que sobrevive ao startup, o uso cai abaixo do limite e o pod roda normalmente — por isso o contador de restarts geralmente para em um ou dois.
Como diferencio um pico de startup de um problema de dimensionamento em estado estável? Filtre suas métricas de throttling e OOM pela idade do container. Se os problemas se concentram nos primeiros um ou dois minutos de vida do container e desaparecem depois, é um pico de startup. Se ocorrem em momentos aleatórios ao longo da vida do pod, o request ou o limite de estado estável está errado.
Remover limites de CPU corrige o throttling no startup? Remove a quota do CFS, então o container pode usar em burst qualquer CPU ociosa que o node tiver. Isso ajuda quando os nodes têm folga. Não ajuda durante um rollout, quando muitos pods iniciam no mesmo node simultaneamente, porque não há CPU ociosa para absorver o burst. O request continua determinando o escalonamento, então um request subdimensionado ainda pode concentrar pods demais com picos em um mesmo node.
Enxergando as duas fases de cada workload
Tudo o que foi descrito acima você pode construir à mão com Prometheus, kube-state-metrics e alguns painéis do Grafana. A parte difícil é fazer isso para 400 workloads e manter tudo atualizado conforme mudanças no código deslocam onde o pico acontece.
O PerfectScale by DoiT faz o profiling de cada container no nível do workload, de modo que o comportamento de startup e o de estado estável aparecem como padrões separados, e não como uma média misturada. Para workloads Java, ele vai uma camada mais fundo: com o agente Coroot habilitado, detecta containers JVM automaticamente e acompanha heap, non-heap e tempo de GC ao longo do tempo, sinaliza containers rodando sem configurações explícitas de heap e respeita -Xms e -Xmx ao fazer uma recomendação ou aplicar uma mudança. Em clusters rodando Kubernetes 1.33 ou superior, sua automação aplica right-sizing in-place, sem reiniciar o pod, e recorre a um rolling restart apenas quando um resize não é viável no node atual.
Quer ver o pico de startup sendo achatado ao vivo? Participe do workshop sobre o pico de startup da JVM, onde mostramos o que acontece dentro da JVM no boot e redimensionamos um pod em execução para o estado estável sem restart. Ou agende uma sessão técnica e a gente dá uma olhada nos seus clusters.