
PerfectScale
CPU throttling e OOM kill su Kubernetes: come scovare gli spike di avvio
Il CPU throttling e gli OOM kill di Kubernetes che colpiscono solo all'avvio dei pod si nascondono dietro le medie. Le metriche, le query PromQL e le viste per smascherarli.
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Uno spike di avvio è il picco di CPU e memoria di cui un container ha bisogno durante l'inizializzazione (caricamento delle classi, compilazione JIT, caricamento delle dipendenze, warm-up delle cache, connection pool) e che si esaurisce quando il processo va a regime.
- Le medie, e persino il p99 su una settimana, lo nascondono. Un burst di 45 secondi in una finestra di 7 giorni rappresenta meno dello 0,01% dei campioni, quindi qualsiasi raccomandazione basata sull'utilizzo medio dimensiona il pod per la fase sbagliata.
- Lo spike si manifesta come CPU throttling, OOM kill con exit code 137, readiness probe fallite e rollout lenti, tutti concentrati nel primo minuto di vita del container, per poi sparire.
- Lo si rileva tracciando l'utilizzo in funzione dell'età del container anziché del tempo assoluto (wall-clock), e filtrando le metriche di throttling e OOM sui container giovani.
- Una volta visibili le due fasi separatamente, è possibile dimensionare per ciascuna invece di dover scegliere quale incidente preferire.
Il suo servizio funziona senza problemi. La CPU è al 15% del limite, la memoria al 60%, nessun alert. Poi un rollout sostituisce 40 pod: la metà subisce throttling per 50 secondi, tre vanno in OOM kill al primo avvio, le readiness probe falliscono e il rollout si blocca. Dieci minuti dopo tutto torna a sembrare in salute e le dashboard non mostrano nulla di anomalo.
Quello è uno spike di avvio, e si nasconde perché ogni metrica usata per dimensionare i workloads lo appiattisce nella media.
Che cos'è uno spike di avvio in Kubernetes?
Uno spike di avvio è la finestra successiva all'avvio di un container in cui questo utilizza molta più CPU e memoria di quanta ne userà a regime. Il processo carica il codice, lo compila o lo interpreta, costruisce il grafo delle dipendenze, apre i connection pool, scalda le cache ed esegue le migrazioni. Tutte operazioni CPU-bound e spesso avide di memoria. Al termine, l'utilizzo scende a una frazione del picco e vi rimane finché il pod non viene terminato.
Il divario tra le due fasi varia a seconda del runtime. Un servizio Spring Boot può bruciare da tre a dieci volte la CPU di regime per 10-60 secondi mentre il compilatore JIT lavora. Un servizio Node.js fa lo stesso su scala minore durante la risoluzione sincrona delle require() e il warm-up di V8. Le app Rails e Django passano l'avvio tra eager loading e autoloader. La forma è sempre la stessa: un picco breve e ripido seguito da un lungo plateau basso.
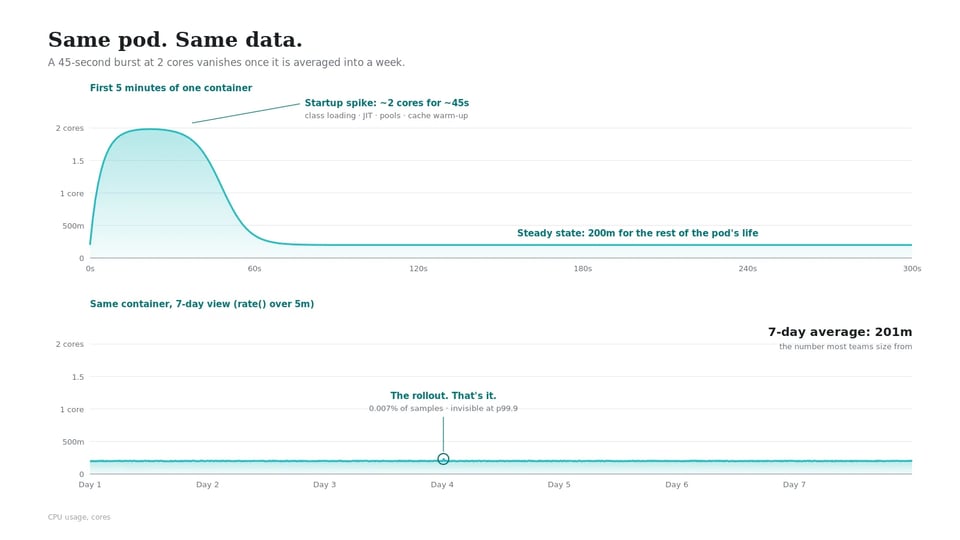
Kubernetes non conosce la differenza. Request e limit sono un unico numero per container, applicato dal primo millisecondo all'ultimo. Quindi o si dimensiona per il picco, pagandolo su ogni replica per sempre, o si dimensiona per il plateau lasciando che il picco sbatta contro il limite.
Perché le dashboard non lo mostrano
La matematica gioca contro di lei. Prenda un pod con un burst di avvio di 45 secondi a 2 core e un regime di 200m. Su una giornata di 24 ore l'utilizzo medio di CPU arriva a circa 201m. Lo spike aggiunge meno di un millicore al numero su cui la maggior parte dei team basa il dimensionamento.
Nemmeno i percentili la salvano. Uno spike di 45 secondi in un lookback di 7 giorni copre circa lo 0,007% dei campioni. Non lascia traccia né al p95, né al p99, né al p99,9. Un VPA che gira con il recommender basato su istogrammi di default raccomanderà il plateau, e il rollout successivo andrà in throttling in fase di salita.
L'intervallo di scrape peggiora le cose. Un Prometheus che esegue lo scrape ogni 30 o 60 secondi può perdersi del tutto un burst di 20 secondi, oppure catturarne un solo campione, che poi viene smussato da rate() su una finestra di 5 minuti. La dashboard mostra una lieve gobba dove il container ha sbattuto contro un muro.
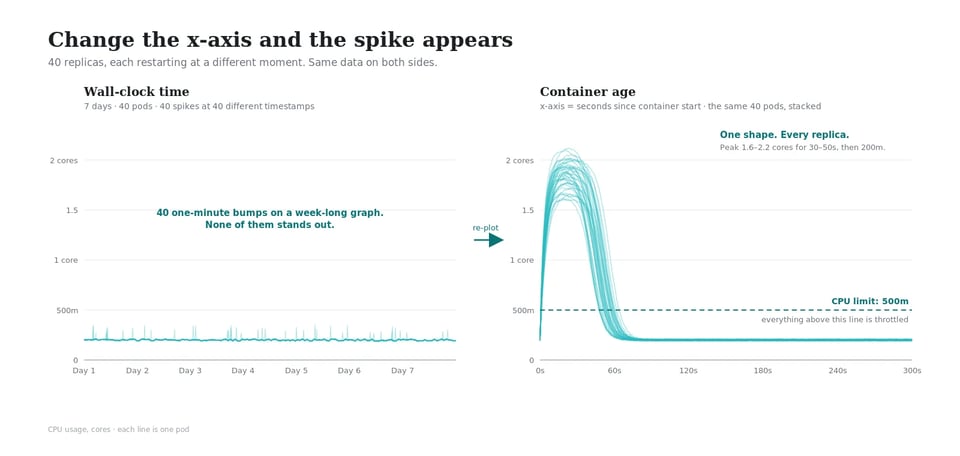
Anche la scala temporale assoluta disperde gli indizi. Con 40 repliche che si riavviano in momenti diversi, 40 spike cadono su 40 timestamp differenti, ciascuno della durata di circa un minuto su un grafico che copre una settimana. Nessuno risalta.
Dove emerge lo spike: i sintomi che le persone cercano davvero
Nessuno cerca "spike di avvio". Si cerca l'incidente che ha causato. Ognuno di questi sintomi ha una spiegazione a regime e una spiegazione all'avvio, e la soluzione cambia a seconda del caso.
| Sintomo | Cosa si osserva | Causa a regime | Causa all'avvio |
|---|---|---|---|
| CPU throttling | Latenza, boot lento, nr_throttled in crescita in cpu.stat |
Limite impostato sotto il carico reale sostenuto | Limite dimensionato per il regime; la compilazione JIT o il caricamento dei moduli esauriscono la quota CFS nel primo minuto |
| OOMKilled (exit 137) | Last State: Terminated, Reason: OOMKilled, contatore di riavvii a 1 |
Memory leak o crescita legata al carico | L'inizializzazione alloca più del plateau; dimensionamento dell'heap JVM, migrazioni, preload delle cache |
| Readiness probe fallite | Eventi Unhealthy, pod bloccato su 0/1 Ready |
L'app è davvero down o sovraccarica | L'avvio in throttling spinge il boot oltre initialDelaySeconds e failureThreshold |
| CrashLoopBackOff | Contatore di riavvii in crescita, backoff che si allunga | Errore di configurazione o di dipendenza | OOM all'avvio o probe fallita a ogni tentativo, senza mai raggiungere il regime |
| Rollout lenti o bloccati | kubectl rollout status rimane bloccato, maxUnavailable esaurito |
Capacità del cluster insufficiente | I nuovi pod impiegano minuti a superare la readiness perché l'avvio gira in throttling |
| HPA instabile (flapping) | Le repliche aumentano e subito dopo rientrano | Picchi di traffico reali | La CPU di avvio delle nuove repliche fa scattare la target utilization, l'HPA ne aggiunge altre, che a loro volta fanno spike |
A separare le due colonne è il timing. Se throttling, OOM kill o probe fallite si concentrano nei primi 60-120 secondi di vita del container e non si ripetono più, il problema è l'avvio. Se compaiono in punti casuali della vita di un pod, il problema è il dimensionamento a regime. CPU throttling e OOMKilled meritano ciascuno un proprio percorso di troubleshooting, ma la prima domanda è la stessa per entrambi: che età aveva il container quando è successo?
Le metriche che smascherano uno spike di avvio
Tutto ciò che serve viene già raccolto. Il trucco sta nel filtrare per età del container.
1. CPU throttling nei container giovani
cAdvisor espone due contatori per container: container_cpu_cfs_periods_total (quanti periodi CFS da 100ms sono trascorsi) e container_cpu_cfs_throttled_periods_total (in quanti di questi periodi il container ha subito throttling). Il rapporto tra i due è la percentuale di throttling.
Per isolare l'avvio, faccia un join con container_start_time_seconds e tenga solo i container con meno di due minuti di vita:
( rate(container_cpu_cfs_throttled_periods_total{container!=""}[1m]) / rate(container_cpu_cfs_periods_total{container!=""}[1m]))and on (pod, container) (time() - container_start_time_seconds{container!=""}) < 120Lo confronti con lo stesso rapporto per i container più vecchi di dieci minuti. Un workload che subisce throttling nel 60% dei periodi nei primi due minuti e nel 2% in seguito ha uno spike di avvio, e aumentare la request lo risolverà. Un workload in throttling al 30% per tutto il giorno ha un problema diverso.
Può anche leggerlo direttamente dal nodo. All'interno di un container in esecuzione, cat /sys/fs/cgroup/cpu.stat stampa nr_periods, nr_throttled e throttled_usec. Se nr_throttled schizza in alto nel primo minuto e poi si blocca, lo spike è confermato.
2. OOM kill al primo boot
kube-state-metrics fornisce il motivo di terminazione e l'exit code dell'istanza precedente del container:
kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} * on (pod, container) group_leftkube_pod_container_status_restarts_totalUn restarts_total pari a 1 accanto a un reason OOMKilled, ripetuto su molti pod subito dopo un deploy, indica allocazione all'avvio e non un leak: un leak impiega ore per terminare un pod, un OOM all'avvio ci mette secondi.
Guardi poi il picco del working set nei primi minuti rispetto a quello successivo:
max_over_time(container_memory_working_set_bytes{container="app"}[5m])Lo esegua su una finestra che includa un rollout. Se il picco dei primi cinque minuti sta ben al di sopra del picco dell'ora successiva, il limite di memoria deve coprire il valore di avvio, non quello di regime. Per i workloads JVM la causa risale spesso alle impostazioni dell'heap. Un container con -Xmx impostato al 75% del limite può comunque andare in OOM durante l'avvio, perché metaspace, code cache e stack dei thread stanno fuori dall'heap.
3. Tempo per diventare ready
Il segnale più semplice è quanto impiega ciascun pod a superare la readiness probe:
kube_pod_status_ready_time - kube_pod_start_timeLo tracci come istogramma sui pod dello stesso Deployment. Un gruppo compatto intorno ai 15 secondi con una coda a 90 secondi significa che alcuni pod sono finiti su nodi più trafficati o hanno subito un throttling più pesante. Se la coda si allunga dopo aver ridotto i limiti CPU, avrà misurato lo spike direttamente.
Sul fronte kubectl, kubectl get events --field-selector reason=Unhealthy -n <namespace> elenca i fallimenti delle probe con i relativi timestamp. Li incroci con gli orari di avvio dei pod e il pattern salta all'occhio.
La vista che lo rende evidente: utilizzo per età del container
I grafici su tempo wall-clock nascondono gli spike di avvio perché ogni replica fa spike in un momento diverso. Ritracci gli stessi dati con l'età del container sull'asse x e gli spike si impileranno uno sopra l'altro.
In Grafana, la versione più rapida è un pannello filtrato su un singolo pod, con l'intervallo temporale che parte dalla creazione di quel pod. L'utilizzo CPU rispetto al limite nei primi cinque minuti di vita di un pod dice tutto: un picco che tocca la linea del limite e si appiattisce significa throttling, e la larghezza di quel tratto piatto è quanto i suoi utenti hanno aspettato.
La versione migliore allinea tutte le repliche sui "secondi dall'avvio". Richiede una recording rule che etichetti i campioni con bucket di età, oppure uno strumento a livello di workload che profili separatamente il ciclo di vita di ciascun container. In ogni caso, l'output desiderato è costituito da due numeri per container: il picco di utilizzo nella finestra di avvio e l'utilizzo tipico successivo. Con entrambi a disposizione, la decisione di dimensionamento smette di essere una scommessa.
Una checklist di rilevamento da eseguire questa settimana
- Scelga i workloads che si riavviano più spesso. Esegua la query
increase(kube_pod_container_status_restarts_total[7d])e ordini in modo decrescente. Gli spike di avvio fanno più danni dove l'avvio è più frequente. - Verifichi se il throttling dipende dall'età. Esegua la query di throttling sui container giovani vista sopra contro gli stessi workloads più vecchi di dieci minuti. Un divario ampio conferma lo spike.
- Controlli il pattern degli OOM. Per ogni workload con
OOMKilledinlast_terminated_reason, guardirestarts_total. Conteggi bassi concentrati dopo i deploy indicano OOM all'avvio. - Misuri il tempo per diventare ready durante un rollout. Avvii un rollout in staging, registri l'istogramma di readiness, poi dimezzi il limite CPU e ripeta. Il delta è il costo del suo spike in secondi.
- Osservi i primi 300 secondi di un singolo pod. Un pannello Grafana, un pod, utilizzo contro limite. Se la linea si appiattisce contro il limite, annoti per quanto tempo.
- Separi i due numeri. Per ogni workload soggetto a spike, registri il picco di avvio e il p95 a regime. Il rapporto tra i due dice quanto si paga in eccesso dimensionando per il picco e quanto throttling si subisce dimensionando per il plateau.
Le soluzioni che peggiorano la situazione in silenzio
Alcune risposte comuni nascondono il sintomo invece di risolverlo.
Aggiungere una startupProbe con un failureThreshold generoso ferma il loop di riavvii, ed è la scelta giusta per l'affidabilità, ma ferma anche l'alert. Il pod continua ad avviarsi in throttling per 90 secondi e gli utenti continuano ad aspettarlo; semplicemente, si smette di vederlo.
Alzare la request di CPU per coprire il picco risolve il throttling, ma fissa lo spreco su ogni replica per il resto della sua vita. Su un servizio da 40 repliche con uno spike da 2 core e un plateau da 200m, quella decisione riserva 72 core che restano inattivi per il 99,9% del tempo. Danneggia anche il bin-packing: lo scheduler piazza i pod in base alle request, e request gonfiate significano meno pod per nodo e più nodi del necessario.
Rimuovere del tutto i limiti CPU, come PerfectScale raccomanda per la maggior parte dei workloads nella guida ai limiti CPU, permette effettivamente all'avvio di fare burst nella capacità inattiva del nodo. Aiuta, ed è di solito il default giusto. Ma funziona solo quando il nodo ha CPU inattiva nel momento in cui il pod parte. Durante un rollout, quando 20 nuovi pod finiscono sullo stesso nodo appena creato e iniziano tutti a compilare in contemporanea, non c'è CPU inattiva su cui fare burst. Lo spike torna sotto forma di contesa invece che di throttling.
Ognuna di queste mosse è ragionevole di per sé. Il problema è che tutte e tre continuano a trattare il container come un numero solo, quando il suo utilizzo ha due forme distinte.
Dimensionare per due fasi invece che per una
Kubernetes ha ormai la primitiva che rende possibile un approccio a due fasi. L'in-place pod resize, che consente di modificare request e limit di un container in esecuzione senza riavviarlo, è diventato stabile nella 1.35 ed è attivo di default nella 1.36 (PerfectScale aveva testato l'alpha già nel 2024, bug compresi). GKE lo usa già per la sua funzionalità di startup CPU boost. Il pattern è semplice: dare al pod ciò che gli serve per il boot, poi riprenderselo quando va a regime.
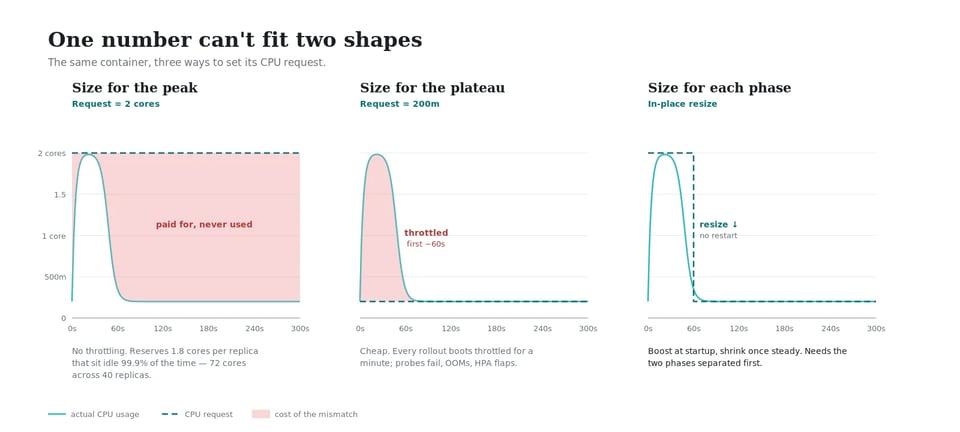
Questo funziona solo se si riesce innanzitutto a distinguere le due fasi, ed è a questo che serve tutto quanto descritto sopra.
FAQ
Che cos'è il CPU throttling in Kubernetes? Il CPU throttling si verifica quando un container tenta di usare più tempo CPU di quanto il suo limite consenta all'interno di un periodo di scheduling CFS (100ms di default). Il kernel mette in pausa il container fino all'inizio del periodo successivo. Un limite di 500m consente a un container di girare per 50ms ogni 100ms; se li esaurisce presto, il container aspetta. Il throttling rallenta l'applicazione senza farla crashare, e può verificarsi anche quando il nodo ha CPU inattiva.
Perché il mio pod viene terminato con OOM kill solo all'avvio? L'inizializzazione spesso alloca più memoria del funzionamento a regime: caricamento delle classi, costruzione delle cache, esecuzione delle migrazioni o dimensionamento dell'heap JVM prima che l'applicazione conosca il suo vero working set. Se il limite di memoria copre il valore di regime ma non il picco di avvio, il kernel termina il container durante il boot con exit code 137. Una volta superato l'avvio, l'utilizzo scende sotto il limite e il pod funziona normalmente: ecco perché il contatore di riavvii di solito si ferma a uno o due.
Come distinguo uno spike di avvio da un problema di dimensionamento a regime? Filtri le metriche di throttling e OOM per età del container. Se i problemi si concentrano nei primi uno o due minuti di vita del container e poi spariscono, si tratta di uno spike di avvio. Se compaiono in punti casuali lungo tutta la vita del pod, sono la request o il limite a regime a essere sbagliati.
Rimuovere i limiti CPU risolve il throttling all'avvio? Rimuove la quota CFS, quindi il container può fare burst in qualunque CPU inattiva disponibile sul nodo. Questo aiuta quando i nodi hanno margine. Non aiuta durante un rollout, quando molti pod partono contemporaneamente sullo stesso nodo, perché non c'è CPU inattiva su cui fare burst. La request determina comunque lo scheduling, quindi una request sottodimensionata può comunque portare troppi pod soggetti a spike sullo stesso nodo.
Vedere entrambe le fasi di ogni workload
Tutto quanto descritto sopra si può costruire a mano con Prometheus, kube-state-metrics e qualche pannello Grafana. La parte difficile è farlo per 400 workloads e tenerlo aggiornato man mano che le modifiche al codice spostano il punto in cui lo spike si manifesta.
PerfectScale by DoiT profila ogni container a livello di workload, così il comportamento all'avvio e quello a regime emergono come pattern separati anziché come un'unica media appiattita. Per i workloads Java scende di un livello in più: una volta abilitato l'agente Coroot, rileva automaticamente i container JVM e traccia nel tempo heap, non-heap e tempo di GC, segnala i container in esecuzione senza impostazioni esplicite dell'heap e rispetta -Xms e -Xmx quando formula una raccomandazione o applica una modifica. Sui cluster con Kubernetes 1.33 o successivo, la sua automazione applica il right-sizing in place, senza riavviare il pod, e ricorre a un rolling restart solo quando il resize non è fattibile sul nodo corrente.
Vuole vedere lo spike di avvio appiattito in diretta? Partecipi al workshop sullo spike di avvio della JVM, in cui analizziamo cosa succede dentro la JVM al boot e ridimensioniamo un pod in esecuzione fino al regime senza alcun riavvio. Oppure prenoti una sessione tecnica e daremo un'occhiata ai suoi cluster.