
PerfectScale
起動スパイクを見逃さない:KubernetesのCPUスロットリングとOOM Kill
Pod起動時にのみ発生するKubernetesのCPUスロットリングやOOM Killは、平均値に埋もれて見えません。あぶり出すためのメトリクス、PromQL、ビューを解説します。
このページはEnglish、Deutsch、Español、Français、Italiano、Portuguêsでもご覧いただけます。


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- 起動スパイクとは、コンテナが初期化中(クラスのロード、JITコンパイル、依存関係のロード、キャッシュのウォームアップ、コネクションプール)に必要とするCPUとメモリのバーストのことで、プロセスが定常状態に達すると収まります。
- 平均値はもちろん、1週間のp99でさえこれを隠します。7日間のウィンドウ内の45秒間のバーストはサンプルの0.01%未満にすぎず、平均化された使用量に基づく推奨値は、誤ったフェーズに合わせてPodをサイジングしてしまいます。
- このスパイクは、CPUスロットリング、exit code 137のOOM Kill、Readiness Probeの失敗、遅いロールアウトとして現れ、いずれもコンテナ起動後の最初の1分間に集中し、その後消えます。
- 検出するには、実時間ではなくコンテナの経過時間に対して使用量をプロットし、スロットリングとOOMのメトリクスを起動直後のコンテナに絞り込みます。
- 2つのフェーズを別々に見られるようになれば、どちらの障害を受け入れるか選ぶのではなく、それぞれのフェーズに合わせてサイジングできるようになります。
サービスは問題なく動いています。CPUはリミットの15%、メモリは60%、アラートもありません。ところがロールアウトで40個のPodが置き換えられると、その半数が50秒間スロットリングされ、3つは初回起動時にOOM Killされ、Readiness Probeが失敗し、ロールアウトが停滞します。10分後にはすべてが再び正常に見え、ダッシュボードには何の異常も表示されません。
これが起動スパイクです。ワークロードのサイジングに使うあらゆるメトリクスが、平均化によってそれを消し去ってしまうため、目に見えないのです。
Kubernetesの起動スパイクとは?
起動スパイクとは、コンテナが起動した後、定常状態をはるかに上回るCPUとメモリを使用する時間帯のことです。プロセスはコードをロードし、コンパイルや解釈を行い、依存関係グラフを構築し、コネクションプールを開き、キャッシュをウォームアップし、マイグレーションを実行します。これらはすべてCPUバウンドで、メモリも大量に消費しがちです。処理が完了すると使用量はピークの数分の一に落ち、Podが終了するまでその水準にとどまります。
2つのフェーズの差はランタイムによって異なります。Spring Bootのサービスは、JITコンパイラが動作する10〜60秒の間、定常状態の3〜10倍のCPUを消費することがあります。Node.jsのサービスも、同期的なrequire()の解決とV8のウォームアップ中に、より小さい規模で同じことをします。RailsやDjangoのアプリは、起動時間をeager loadingやオートローダーに費やします。形はいつも同じです。短く鋭いピークの後に、長く低いプラトーが続きます。
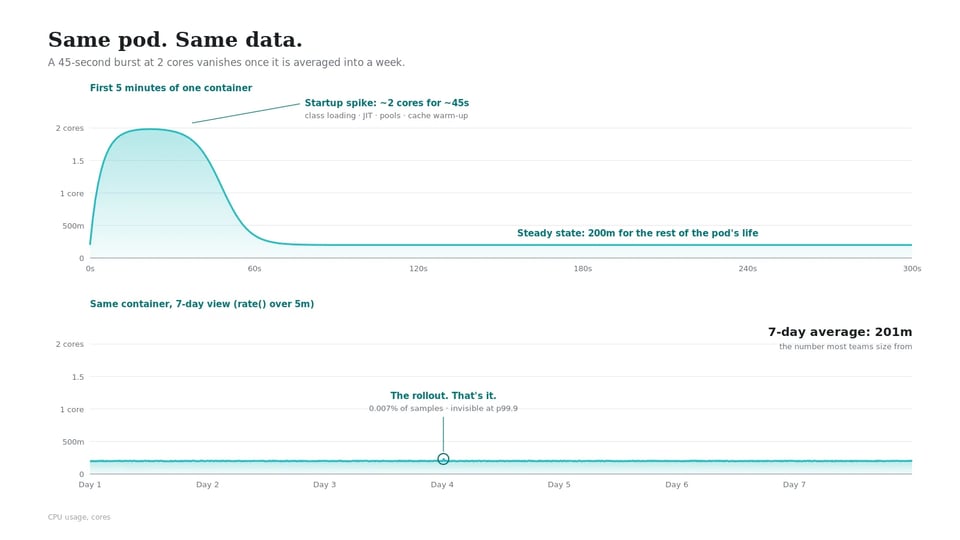
Kubernetesはこの違いを認識しません。requestsとlimitsはコンテナごとに1つの数値であり、最初のミリ秒から最後まで適用されます。そのため、ピークに合わせてサイジングしてすべてのレプリカで永久にそのコストを払い続けるか、プラトーに合わせてサイジングしてピークがリミットにぶつかるのを許容するか、どちらかになります。
ダッシュボードに表示されない理由
計算の仕組みが不利に働きます。2コアで45秒の起動バーストがあり、定常状態が200mのPodを考えてみましょう。24時間の平均CPU使用量は約201mになります。多くのチームがサイジングの基準にする数値に、スパイクは1ミリコア未満しか加算されないのです。
パーセンタイルも助けにはなりません。7日間のルックバック内の45秒のスパイクは、サンプルの約0.007%にすぎません。p95でもp99でもp99.9でも現れません。デフォルトのヒストグラムベースのレコメンダーで動作するVPAはプラトーを推奨し、次のロールアウトは立ち上がりでスロットリングされます。
スクレイプ間隔が事態をさらに悪化させます。30秒または60秒間隔でスクレイプするPrometheusは、20秒のバーストを完全に見逃すか、1サンプルだけ捕捉して5分ウィンドウのrate()で平滑化してしまいます。コンテナが壁にぶつかった場面が、ダッシュボードではなだらかな盛り上がりとして表示されるのです。
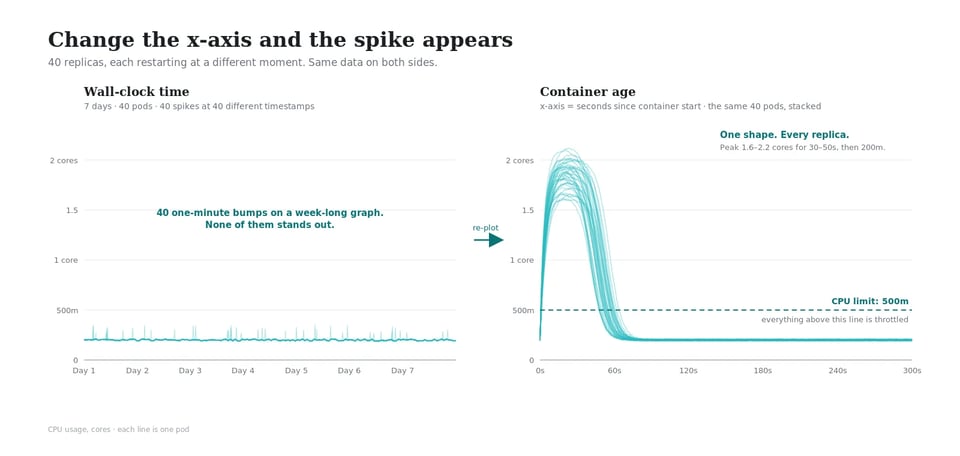
実時間も証拠を散らばらせます。異なるタイミングで再起動する40個のレプリカでは、40個のスパイクが40通りの異なる時刻に現れ、1週間をカバーするグラフ上でそれぞれ約1分しか続きません。どれひとつとして目立ちません。
スパイクが表面化する場面:実際に検索される症状
「起動スパイク」で検索する人はいません。検索されるのは、それが引き起こしたインシデントです。以下の各症状には定常状態由来の原因と起動由来の原因があり、どちらに該当するかで対処法が変わります。
| 症状 | 観測される事象 | 定常状態の原因 | 起動時の原因 |
|---|---|---|---|
| CPUスロットリング | レイテンシ、起動の遅延、cpu.statのnr_throttledが増加 |
リミットが実際の持続負荷を下回る設定 | リミットが定常状態に合わせてサイジングされ、JITやモジュールロードが最初の1分でCFSクォータに到達 |
| OOMKilled(exit 137) | Last State: Terminated, Reason: OOMKilled、restartsカウンターが1 |
メモリリークまたは負荷起因の増加 | 初期化時の割り当てがプラトーを上回る。JVMヒープのサイジング、マイグレーション、キャッシュのプリロード |
| Readiness Probeの失敗 | Unhealthyイベント、Podが0/1 Readyのまま |
アプリが実際にダウンまたは過負荷 | スロットリングされた起動がinitialDelaySecondsとfailureThresholdを超過 |
| CrashLoopBackOff | 再起動カウンターが増加、バックオフが拡大 | 設定または依存関係の障害 | 毎回の試行で起動時のOOMまたはプローブ失敗が発生し、定常状態に到達しない |
| ロールアウトの遅延・停滞 | kubectl rollout statusがハング、maxUnavailableを使い果たす |
クラスタ容量の不足 | 起動がスロットリングされたまま進むため、新しいPodがReadinessを通過するまでに数分かかる |
| HPAのフラッピング | レプリカがスケールアウトし、すぐにスケールイン | 実際のトラフィックバースト | 新しいレプリカの起動時CPUが目標使用率を超え、HPAがさらにレプリカを追加し、それらもスパイクする |
2つの列を分けるのはタイミングです。スロットリング、OOM Kill、プローブ失敗がコンテナ起動後の60〜120秒に集中し、その後再発しないなら、起動の問題です。Podのライフタイム中のランダムな時点で発生するなら、定常状態のサイジングの問題です。CPUスロットリングとOOMKilledにはそれぞれ専用のトラブルシューティング手順がありますが、どちらの場合も最初の問いは同じです。「発生した時点で、コンテナは起動からどれだけ経過していたか?」です。
起動スパイクをあぶり出すメトリクス
必要なものはすでにすべて収集されています。コツは、コンテナの経過時間でフィルタリングすることです。
1. 起動直後のコンテナにおけるCPUスロットリング
cAdvisorはコンテナごとに2つのカウンターを公開しています。container_cpu_cfs_periods_total(経過した100msのCFSピリオド数)とcontainer_cpu_cfs_throttled_periods_total(そのうちスロットリングされたピリオド数)です。この比率がスロットリング率になります。
起動時を切り出すには、container_start_time_secondsと結合し、起動から2分未満のコンテナだけを残します。
( rate(container_cpu_cfs_throttled_periods_total{container!=""}[1m]) / rate(container_cpu_cfs_periods_total{container!=""}[1m]))and on (pod, container) (time() - container_start_time_seconds{container!=""}) < 120これを、起動から10分以上経過したコンテナの同じ比率と比較します。最初の2分間はピリオドの60%がスロットリングされ、その後は2%というワークロードには起動スパイクがあり、リクエストを引き上げれば解決します。1日中30%スロットリングされているワークロードは、別の問題を抱えています。
ノードから直接読み取ることもできます。実行中のコンテナ内でcat /sys/fs/cgroup/cpu.statを実行すると、nr_periods、nr_throttled、throttled_usecが出力されます。nr_throttledが最初の1分で跳ね上がり、その後止まるなら、スパイクは確定です。
2. 初回起動時のOOM Kill
kube-state-metricsは、直前のコンテナインスタンスの終了理由と終了コードを提供します。
kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} * on (pod, container) group_leftkube_pod_container_status_restarts_totalOOMKilledという理由の横にrestarts_totalが1という状態が、デプロイ直後に多数のPodで繰り返されるなら、リークではなく起動時の割り当てが原因です。リークがPodを落とすまでには数時間かかりますが、起動時のOOMは数秒で発生するからです。
次に、最初の数分間のピークワーキングセットと、それ以降を比較します。
max_over_time(container_memory_working_set_bytes{container="app"}[5m])ロールアウトを含むウィンドウで実行してください。最初の5分間のピークがその後1時間のピークを大きく上回るなら、メモリリミットは定常状態の数値ではなく、起動時の数値をクリアする必要があります。JVMワークロードでは、これはヒープ設定に行き着くことがよくあります。-Xmxをリミットの75%に設定したコンテナでも、メタスペース、コードキャッシュ、スレッドスタックがヒープの外にあるため、起動中にOOMになることがあります。
3. Readyまでの時間
最もシンプルなシグナルは、各PodがReadiness Probeを通過するまでにかかる時間です。
kube_pod_status_ready_time - kube_pod_start_time同じDeployment内のPod全体でヒストグラムとしてプロットします。15秒前後に密集し、90秒にテールがあるなら、一部のPodが混雑したノードに配置されたか、より強くスロットリングされたことを意味します。CPUリミットを厳しくした後にテールが伸びるなら、スパイクを直接測定できたことになります。
kubectl側では、kubectl get events --field-selector reason=Unhealthy -n <namespace>でタイムスタンプ付きのプローブ失敗を一覧表示できます。Podの起動時刻と突き合わせれば、パターンが浮かび上がります。
一目瞭然にするビュー:コンテナ経過時間別の使用量
実時間のグラフが起動スパイクを隠すのは、各レプリカが異なるタイミングでスパイクするからです。同じデータをx軸にコンテナの経過時間を取って再プロットすれば、スパイクは互いに重なり合います。
Grafanaで最も手早いのは、単一のPodに絞り込み、時間範囲をそのPodの作成時点から始まるように設定したパネルです。1つのPodの起動後最初の5分間のCPU使用量とリミットの比較が、すべてを物語ります。リミットの線に触れて平坦になるピークはスロットリングを意味し、その平坦な頂点の幅が、ユーザーが待たされた時間です。
より良い方法は、すべてのレプリカを「起動からの秒数」で揃えることです。これには、サンプルに経過時間バケットのタグを付けるレコーディングルールか、各コンテナのライフサイクルを個別にプロファイリングするワークロードレベルのツールが必要です。いずれにせよ、欲しいアウトプットはコンテナごとに2つの数値です。起動ウィンドウでのピーク使用量と、その後の典型的な使用量です。両方が揃えば、サイジングの判断はもはや推測ではなくなります。
今週から実行できる検出チェックリスト
- 最も再起動の多いワークロードを選ぶ。
increase(kube_pod_container_status_restarts_total[7d])をクエリし、降順にソートします。起動スパイクは、起動が最も頻繁に起きる場所で最も大きな痛手になります。 - スロットリングが経過時間に依存するかを確認する。 上記の起動直後コンテナのスロットリングクエリを、同じワークロードの起動から10分以上経過したものに対しても実行します。大きな差があればスパイクが確認できます。
- OOMのパターンを確認する。
last_terminated_reasonにOOMKilledがあるワークロードについて、restarts_totalを確認します。デプロイ直後に集中する低いカウントは、起動時のOOMを意味します。 - ロールアウト全体でReadyまでの時間を測定する。 ステージングでロールアウトを実行してReadinessのヒストグラムを記録し、CPUリミットを半分にしてもう一度実行します。その差分が、スパイクのコストを秒単位で示します。
- 1つのPodの最初の300秒を見る。 Grafanaパネル1枚、Pod1つ、使用量とリミットの比較です。線がリミットに張り付いて平坦になるなら、その長さを記録してください。
- 2つの数値を分離する。 スパイクのある各ワークロードについて、起動時ピークと定常状態のp95を記録します。その比率が、ピークに合わせてサイジングした場合の過剰コストと、プラトーに合わせた場合のスロットリング量を教えてくれます。
かえって事態を悪化させる「修正」
よくある対応のいくつかは、問題を解決する代わりに症状を隠してしまいます。
余裕のあるfailureThresholdを持つstartupProbeを追加すれば、再起動ループは止まります。信頼性の観点では正しい判断ですが、アラートも止まります。Podは依然として90秒間スロットリングされた状態で起動し、ユーザーは依然として待たされます。あなたがそれを見なくなるだけです。
ピークをカバーするようにCPUリクエストを引き上げればスロットリングは解消しますが、すべてのレプリカにその生涯にわたる無駄が固定されます。2コアのスパイクと200mのプラトーを持つ40レプリカのサービスでは、この判断だけで、時間の99.9%はアイドルのままの72コアを確保することになります。ビンパッキングにも悪影響があります。スケジューラはリクエストに基づいてPodを配置するため、水増しされたリクエストはノードあたりのPod数を減らし、必要以上のノードを招きます。
CPUリミットを完全に削除する方法(PerfectScaleがCPUリミットガイドでほとんどのワークロードに推奨している方法)なら、起動時にノードのアイドルCPUへバーストできるようになります。これは効果があり、通常は正しいデフォルトです。しかし、Podが起動する瞬間にノードにアイドルCPUがある場合にしか機能しません。ロールアウト中、20個の新しいPodが同じ新規ノードに配置されて一斉にコンパイルを始めると、バーストできるアイドルCPUはありません。スパイクはスロットリングではなく競合として戻ってきます。
これらはどれも、単独では妥当な一手です。問題は、使用量に2つの明確な形があるにもかかわらず、3つともコンテナを1つの数値として扱い続けることにあります。
1つではなく、2つのフェーズに合わせたサイジング
Kubernetesには、2フェーズアプローチを可能にするプリミティブが備わりました。実行中のコンテナのrequestsとlimitsを再起動なしで変更できるインプレースPodリサイズは、1.35で安定版となり、1.36ではデフォルトで有効になっています(PerfectScaleは2024年にアルファ版をバグも含めてテスト済みです)。GKEはすでに起動時CPUブースト機能にこれを利用しています。パターンはシンプルです。起動に必要なリソースをPodに与え、定常状態に達したら回収する。それだけです。
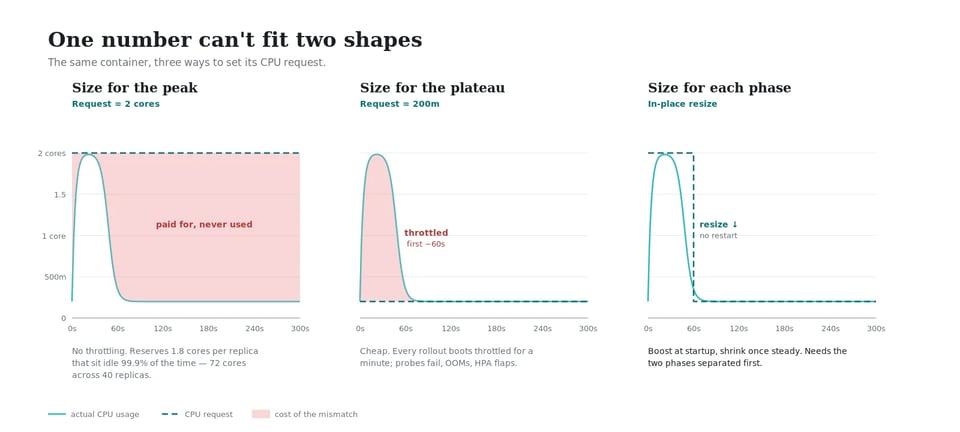
ただしこれが機能するのは、そもそも2つのフェーズを見分けられる場合に限ります。ここまで述べてきたすべては、そのためにあります。
FAQ
KubernetesのCPUスロットリングとは何ですか? CPUスロットリングは、コンテナがCFSスケジューリングピリオド(デフォルト100ms)内で、リミットが許す以上のCPU時間を使おうとしたときに発生します。カーネルは次のピリオドが始まるまでコンテナを一時停止します。500mのリミットでは、コンテナは100msごとに50ms実行できます。それを早く使い切れば、コンテナは待たされます。スロットリングはアプリケーションをクラッシュさせずに遅くするもので、ノードにアイドルCPUがあっても発生することがあります。
なぜPodは起動時にだけOOM Killされるのですか? 初期化は定常状態の動作よりも多くのメモリを割り当てることがよくあります。クラスのロード、キャッシュの構築、マイグレーションの実行、あるいはアプリケーションが実際のワーキングセットを把握する前のJVMヒープのサイジングなどです。メモリリミットが定常状態の数値はクリアしても起動時のピークをクリアしていない場合、カーネルは起動中にexit code 137でコンテナを強制終了します。起動を乗り切れば使用量はリミットを下回り、Podは正常に動作します。再起動カウントが通常1か2で止まるのはこのためです。
起動スパイクと定常状態のサイジング問題はどう見分けますか? スロットリングとOOMのメトリクスをコンテナの経過時間でフィルタリングしてください。問題がコンテナ起動後の1〜2分に集中し、その後消えるなら起動スパイクです。Podのライフタイム全体のランダムな時点で発生するなら、定常状態のリクエストまたはリミットが誤っています。
CPUリミットを削除すれば起動時のスロットリングは解消しますか? CFSクォータが取り除かれるため、コンテナはノードにあるアイドルCPUへバーストできるようになります。ノードに余裕がある場合には有効です。しかし、多くのPodが同じノードで同時に起動するロールアウト中は、バーストできるアイドルCPUがないため役立ちません。スケジューリングは依然としてリクエストで決まるため、過小なリクエストのままでは、スパイクするPodが1つのノードに過剰に詰め込まれる可能性が残ります。
すべてのワークロードの両フェーズを可視化する
ここまでの内容はすべて、Prometheus、kube-state-metrics、いくつかのGrafanaパネルを使って手作業で構築できます。難しいのは、それを400のワークロードに対して行い、コードの変更でスパイクの発生箇所が移り変わっても最新の状態に保ち続けることです。
PerfectScale by DoiTは、すべてのコンテナをワークロードレベルでプロファイリングするため、起動時の挙動と定常状態の挙動が、混ざり合った1つの平均ではなく、別々のパターンとして見えてきます。Javaワークロードについては、さらに一段深く掘り下げます。Corootエージェントを有効にすると、JVMコンテナを自動検出し、ヒープ、非ヒープ、GC時間を経時的に追跡し、明示的なヒープ設定なしで動作しているコンテナにフラグを立て、推奨値の提示や変更の適用時に-Xmsと-Xmxを尊重します。Kubernetes 1.33以降のクラスタでは、自動化によってPodを再起動せずにインプレースでライトサイジングを適用し、現在のノードでリサイズが不可能な場合にのみローリング再起動にフォールバックします。
起動スパイクが平坦化される様子をライブで見てみませんか?JVM起動スパイクワークショップでは、起動時にJVM内部で何が起きているかを解説し、実行中のPodを再起動なしで定常状態までリサイズします。あるいはテクニカルセッションを予約いただければ、お客様のクラスタを一緒に確認します。