
PerfectScale
Kubernetes-Startup-Spikes finden, bevor sie zum Incident werden
CPU-Throttling und OOM Kills, die nur beim Pod-Start zuschlagen, verstecken sich hinter Durchschnittswerten. Diese Metriken, PromQL-Queries und Ansichten machen sie sichtbar.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.


About Josh Palmer
Head of Content
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR
- Ein Startup-Spike ist der kurzzeitige CPU- und Speicherbedarf eines Containers während der Initialisierung (Class Loading, JIT-Kompilierung, Laden von Abhängigkeiten, Cache-Warming, Connection Pools), der abfällt, sobald der Prozess seinen Steady State erreicht.
- Durchschnittswerte und selbst das p99 über eine Woche verbergen ihn. Ein 45-Sekunden-Burst in einem 7-Tage-Fenster macht weniger als 0,01 % der Samples aus – jede Empfehlung auf Basis gemittelter Nutzung dimensioniert den Pod also für die falsche Phase.
- Der Spike zeigt sich als CPU-Throttling, OOM Kills mit Exit-Code 137, fehlgeschlagene Readiness Probes und zähe Rollouts, die sich alle in der ersten Minute eines Container-Lebens häufen und dann verschwinden.
- Erkennen lässt er sich, indem Sie die Nutzung über das Container-Alter statt über die Uhrzeit auftragen und Throttling- sowie OOM-Metriken auf junge Container filtern.
- Sobald Sie beide Phasen getrennt sehen, können Sie für jede einzeln dimensionieren, statt sich auszusuchen, welchen Incident Sie lieber hätten.
Ihr Service läuft einwandfrei. Die CPU liegt bei 15 % des Limits, der Speicher bei 60 %, keine Alerts. Dann ersetzt ein Rollout 40 Pods, die Hälfte davon wird 50 Sekunden lang gedrosselt, drei werden beim ersten Start per OOM Kill beendet, Readiness Probes schlagen fehl und der Rollout bleibt hängen. Zehn Minuten später sieht alles wieder gesund aus, und die Dashboards zeigen nichts Auffälliges.
Das ist ein Startup-Spike – und er bleibt unsichtbar, weil jede Metrik, mit der Sie Workloads dimensionieren, ihn wegmittelt.
Was ist ein Kubernetes-Startup-Spike?
Ein Startup-Spike ist das Zeitfenster nach dem Start eines Containers, in dem er deutlich mehr CPU und Speicher nutzt als später im Steady State. Der Prozess lädt Code, kompiliert oder interpretiert ihn, baut seinen Abhängigkeitsgraphen auf, öffnet Connection Pools, wärmt Caches vor und führt Migrationen aus. All das ist CPU-lastig und oft speicherhungrig. Sobald es abgeschlossen ist, fällt die Nutzung auf einen Bruchteil des Peaks und bleibt dort, bis der Pod beendet wird.
Wie groß die Lücke zwischen den beiden Phasen ist, hängt von der Runtime ab. Ein Spring-Boot-Service kann 10 bis 60 Sekunden lang das Drei- bis Zehnfache seiner Steady-State-CPU verbrennen, während der JIT-Compiler arbeitet. Ein Node.js-Service tut dasselbe in kleinerem Maßstab während der synchronen require()-Auflösung und des V8-Warmups. Rails- und Django-Apps verbringen ihren Start mit Eager Loading und Autoloadern. Die Form ist jedes Mal dieselbe: ein kurzer, scharfer Peak, gefolgt von einem langen, niedrigen Plateau.
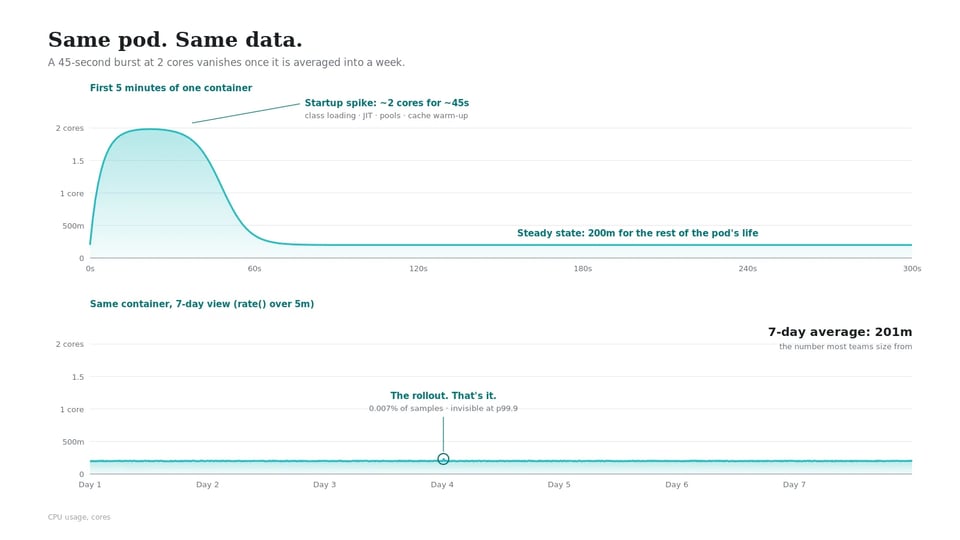
Kubernetes kennt den Unterschied nicht. Requests und Limits sind eine Zahl pro Container, gültig von der ersten Millisekunde bis zur letzten. Sie dimensionieren also entweder für den Peak und bezahlen dafür auf jeder Replica für immer – oder für das Plateau und lassen den Peak gegen das Limit laufen.
Warum Ihre Dashboards nichts davon zeigen
Die Mathematik arbeitet gegen Sie. Nehmen Sie einen Pod mit einem 45-sekündigen Startup-Burst bei 2 Cores und einem Steady State von 200m. Über einen 24-Stunden-Tag kommt die durchschnittliche CPU-Nutzung auf rund 201m. Der Spike addiert weniger als einen Millicore zu der Zahl, nach der die meisten Teams dimensionieren.
Auch Perzentile helfen Ihnen hier nicht weiter. Ein 45-Sekunden-Spike in einem 7-Tage-Lookback deckt etwa 0,007 % der Samples ab. Er taucht weder bei p95 noch bei p99 oder p99,9 auf. Ein VPA mit seinem standardmäßigen histogrammbasierten Recommender empfiehlt das Plateau, und der nächste Rollout läuft beim Hochfahren ins Throttling.
Das Scrape-Intervall macht es noch schlimmer. Prometheus mit einem Scrape alle 30 oder 60 Sekunden kann einen 20-Sekunden-Burst komplett verpassen oder genau ein Sample davon erwischen, das rate() über ein 5-Minuten-Fenster glattbügelt. Ihr Dashboard zeigt eine sanfte Erhebung, wo der Container gegen eine Wand gelaufen ist.
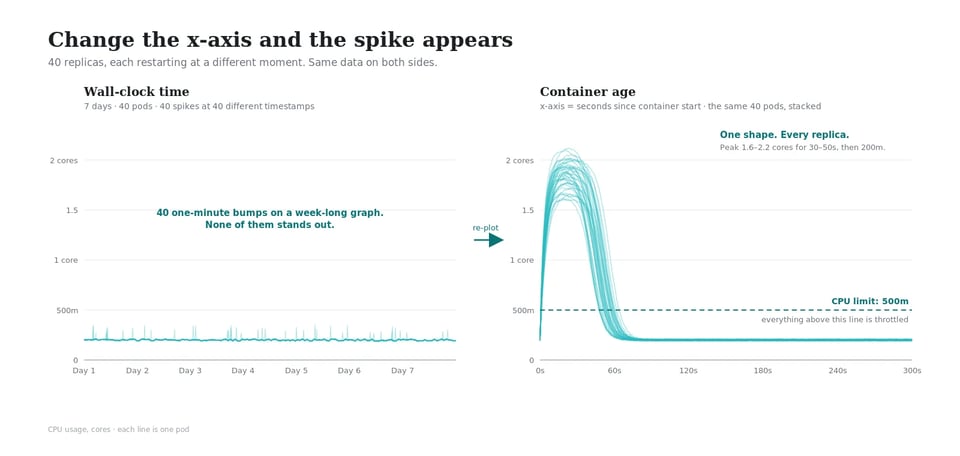
Auch die Uhrzeit verwischt die Spuren. Bei 40 Replicas, die zu unterschiedlichen Zeitpunkten neu starten, landen 40 Spikes auf 40 verschiedenen Zeitstempeln – jeder etwa eine Minute lang auf einem Graphen, der eine Woche abdeckt. Keiner fällt auf.
Wo der Spike auftaucht: die Symptome, nach denen tatsächlich gesucht wird
Niemand sucht nach "Startup-Spike". Gesucht wird nach dem Incident, den er verursacht hat. Jedes dieser Symptome hat eine Steady-State-Erklärung und eine Startup-Erklärung – und die Lösung hängt davon ab, welche von beiden zutrifft.
| Symptom | Was Sie sehen | Steady-State-Ursache | Startup-Ursache |
|---|---|---|---|
| CPU-Throttling | Latenz, langsamer Boot, steigendes nr_throttled in cpu.stat |
Limit unterhalb der realen Dauerlast gesetzt | Limit auf den Steady State dimensioniert; JIT oder Modul-Loading stößt in der ersten Minute an die CFS-Quota |
| OOMKilled (Exit 137) | Last State: Terminated, Reason: OOMKilled, Restart-Zähler bei 1 |
Memory Leak oder lastgetriebenes Wachstum | Initialisierung allokiert mehr als das Plateau; JVM-Heap-Sizing, Migration, Cache-Preload |
| Fehlgeschlagene Readiness Probes | Unhealthy-Events, Pod hängt bei 0/1 Ready |
App ist tatsächlich down oder überlastet | Gedrosselter Start schiebt den Boot über initialDelaySeconds und failureThreshold hinaus |
| CrashLoopBackOff | Restart-Zähler steigt, Backoff wächst | Konfigurations- oder Abhängigkeitsfehler | Startup-OOM oder Probe-Fehler bei jedem Versuch, der Steady State wird nie erreicht |
| Langsame oder hängende Rollouts | kubectl rollout status hängt, maxUnavailable ausgeschöpft |
Unzureichende Cluster-Kapazität | Neue Pods brauchen Minuten bis zur Readiness, weil der Start gedrosselt läuft |
| HPA-Flapping | Replicas skalieren hoch und direkt wieder runter | Echte Traffic-Bursts | Die Startup-CPU neuer Replicas treibt die Auslastung über den Zielwert, der HPA legt weitere Replicas nach, die ebenfalls Spikes erzeugen |
Das Timing trennt die beiden Spalten. Wenn sich Throttling, OOM Kills oder Probe-Fehler in den ersten 60 bis 120 Sekunden des Container-Lebens häufen und danach nie wieder auftreten, haben Sie ein Startup-Problem. Treten sie an zufälligen Punkten im Lebenszyklus eines Pods auf, haben Sie ein Steady-State-Sizing-Problem. CPU-Throttling und OOMKilled verdienen jeweils ihren eigenen Troubleshooting-Pfad, aber die erste Frage ist bei beiden dieselbe: Wie alt war der Container, als es passiert ist?
Die Metriken, die einen Startup-Spike sichtbar machen
Sie sammeln bereits alles, was Sie brauchen. Der Trick ist das Filtern nach Container-Alter.
1. CPU-Throttling in jungen Containern
cAdvisor stellt zwei Counter pro Container bereit: container_cpu_cfs_periods_total (wie viele 100-ms-CFS-Perioden vergangen sind) und container_cpu_cfs_throttled_periods_total (in wie vielen dieser Perioden der Container gedrosselt wurde). Das Verhältnis ist Ihr Throttling-Prozentsatz.
Um den Start zu isolieren, joinen Sie gegen container_start_time_seconds und behalten nur Container, die jünger als zwei Minuten sind:
( rate(container_cpu_cfs_throttled_periods_total{container!=""}[1m]) / rate(container_cpu_cfs_periods_total{container!=""}[1m]))and on (pod, container) (time() - container_start_time_seconds{container!=""}) < 120Vergleichen Sie das mit demselben Verhältnis für Container, die älter als zehn Minuten sind. Ein Workload, der in den ersten zwei Minuten in 60 % der Perioden gedrosselt wird und danach in 2 %, hat einen Startup-Spike – ein höherer Request behebt das. Ein Workload, der den ganzen Tag über zu 30 % gedrosselt wird, hat ein anderes Problem.
Sie können es auch direkt auf dem Node ablesen. In einem laufenden Container gibt cat /sys/fs/cgroup/cpu.stat die Werte nr_periods, nr_throttled und throttled_usec aus. Wenn nr_throttled in der ersten Minute sprunghaft steigt und danach einfriert, ist der Spike bestätigt.
2. OOM Kills beim ersten Start
kube-state-metrics liefert Ihnen den Terminierungsgrund und den Exit-Code der vorherigen Container-Instanz:
kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} * on (pod, container) group_leftkube_pod_container_status_restarts_totalEin restarts_total von 1 neben einem OOMKilled-Grund, wiederholt über viele Pods direkt nach einem Deploy, deutet auf Startup-Allokation statt auf ein Leak hin – ein Leak braucht Stunden, um einen Pod zu killen, ein Startup-OOM Sekunden.
Schauen Sie dann auf das Peak Working Set in den ersten Minuten im Vergleich zu später:
max_over_time(container_memory_working_set_bytes{container="app"}[5m])Führen Sie die Query über ein Fenster aus, das einen Rollout enthält. Liegt der Peak der ersten fünf Minuten deutlich über dem Peak der folgenden Stunde, muss Ihr Memory-Limit den Startup-Wert abdecken, nicht den Steady-State-Wert. Bei JVM-Workloads führt die Spur oft zu den Heap-Einstellungen. Ein Container mit -Xmx auf 75 % des Limits kann beim Start trotzdem einen OOM auslösen, weil Metaspace, Code Cache und Thread Stacks außerhalb des Heaps liegen.
3. Time to Ready
Das einfachste Signal ist, wie lange jeder Pod braucht, um seine Readiness Probe zu bestehen:
kube_pod_status_ready_time - kube_pod_start_timeTragen Sie das als Histogramm über die Pods desselben Deployments auf. Ein enger Cluster um 15 Sekunden mit einem Ausläufer bei 90 Sekunden bedeutet, dass manche Pods auf stärker ausgelasteten Nodes gelandet sind oder härter gedrosselt wurden. Wächst der Ausläufer, nachdem Sie die CPU-Limits verschärft haben, haben Sie den Spike direkt gemessen.
Auf kubectl-Seite listet kubectl get events --field-selector reason=Unhealthy -n <namespace> Probe-Fehler mit Zeitstempeln. Gleichen Sie sie mit den Pod-Startzeiten ab, und das Muster springt ins Auge.
Die Ansicht, die es offensichtlich macht: Nutzung nach Container-Alter
Graphen über die Uhrzeit verbergen Startup-Spikes, weil jede Replica ihren Spike zu einem anderen Zeitpunkt hat. Tragen Sie dieselben Daten mit dem Container-Alter auf der x-Achse auf, und sie stapeln sich übereinander.
In Grafana ist die schnellste Variante ein Panel, das auf einen einzelnen Pod filtert und den Zeitbereich beim Erstellungszeitpunkt dieses Pods beginnen lässt. CPU-Nutzung versus Limit für die ersten fünf Minuten eines Pod-Lebens sagt Ihnen alles: Ein Peak, der die Limit-Linie berührt und abflacht, bedeutet Throttling – und die Breite dieses Plateaus ist die Zeit, die Ihre Nutzer gewartet haben.
Die bessere Variante richtet alle Replicas auf "Sekunden seit dem Start" aus. Das erfordert entweder eine Recording Rule, die Samples mit Alters-Buckets taggt, oder ein Tool auf Workload-Ebene, das den Lebenszyklus jedes Containers separat profiliert. So oder so: Das Ergebnis, das Sie brauchen, sind zwei Zahlen pro Container – Peak-Nutzung im Startup-Fenster und typische Nutzung danach. Sobald Sie beide haben, ist die Sizing-Entscheidung kein Raten mehr.
Eine Erkennungs-Checkliste, die Sie noch diese Woche durchgehen können
- Suchen Sie die Workloads mit den meisten Restarts. Fragen Sie
increase(kube_pod_container_status_restarts_total[7d])ab und sortieren Sie absteigend. Startup-Spikes tun dort am meisten weh, wo am häufigsten gestartet wird. - Prüfen Sie, ob das Throttling altersabhängig ist. Vergleichen Sie die obige Throttling-Query für junge Container mit denselben Workloads, sobald sie älter als zehn Minuten sind. Eine große Differenz bestätigt den Spike.
- Prüfen Sie das OOM-Muster. Schauen Sie bei jedem Workload mit
OOMKilledinlast_terminated_reasonaufrestarts_total. Niedrige Zählerstände, gehäuft nach Deploys, bedeuten Startup-OOM. - Messen Sie die Time to Ready über einen Rollout. Stoßen Sie einen Rollout in Staging an, zeichnen Sie das Readiness-Histogramm auf, halbieren Sie dann das CPU-Limit und wiederholen Sie das Ganze. Das Delta ist der Preis Ihres Spikes in Sekunden.
- Schauen Sie sich die ersten 300 Sekunden eines Pods an. Ein Grafana-Panel, ein Pod, Nutzung gegen Limit. Flacht die Linie am Limit ab, notieren Sie, wie lange.
- Trennen Sie die beiden Zahlen. Notieren Sie für jeden Workload mit Spike den Startup-Peak und das Steady-State-p95. Das Verhältnis der beiden sagt Ihnen, wie viel Sie zu viel bezahlen, wenn Sie für den Peak dimensionieren – und wie stark Sie drosseln, wenn Sie für das Plateau dimensionieren.
Die Fixes, die das Problem unbemerkt verschlimmern
Einige verbreitete Reaktionen verstecken das Symptom, statt es zu lösen.
Eine startupProbe mit großzügigem failureThreshold stoppt die Restart-Schleife – aus Zuverlässigkeitssicht die richtige Entscheidung –, aber sie stoppt auch den Alert. Der Pod bootet weiterhin 90 Sekunden lang gedrosselt, und die Nutzer warten weiterhin darauf; Sie sehen es nur nicht mehr.
Den CPU-Request auf den Peak anzuheben behebt das Throttling und zementiert die Verschwendung über jede Replica für den Rest ihres Lebens. Bei einem Service mit 40 Replicas, einem 2-Core-Spike und einem 200m-Plateau reserviert diese Entscheidung 72 Cores, die zu 99,9 % der Zeit im Leerlauf sind. Sie schadet außerdem dem Bin-Packing: Der Scheduler platziert Pods nach Request, und aufgeblähte Requests bedeuten weniger Pods pro Node und mehr Nodes, als Sie brauchen.
CPU-Limits komplett zu entfernen – was PerfectScale für die meisten Workloads im Guide zu CPU-Limits empfiehlt – lässt den Start tatsächlich in die freie Node-Kapazität bursten. Das hilft, und es ist meistens der richtige Default. Aber es funktioniert nur, wenn der Node in dem Moment freie CPU hat, in dem der Pod startet. Während eines Rollouts, wenn 20 neue Pods auf demselben frischen Node landen und alle gleichzeitig zu kompilieren beginnen, gibt es keine freie CPU zum Bursten. Der Spike kommt zurück – als Contention statt als Throttling.
Jede dieser Maßnahmen ist für sich genommen vernünftig. Das Problem: Alle drei behandeln den Container weiterhin als eine einzige Zahl, obwohl seine Nutzung zwei klar unterschiedliche Formen hat.
Für zwei Phasen dimensionieren statt für eine
Kubernetes bringt inzwischen die Grundfunktion mit, die einen Zwei-Phasen-Ansatz möglich macht. In-Place Pod Resize – die Möglichkeit, Requests und Limits eines laufenden Containers ohne Neustart zu ändern – wurde in 1.35 stable und ist in 1.36 standardmäßig aktiviert (PerfectScale hat die Alpha-Version schon 2024 getestet, inklusive aller Bugs). GKE nutzt das Feature bereits für seinen Startup-CPU-Boost. Das Muster ist simpel: Geben Sie dem Pod, was er zum Booten braucht, und nehmen Sie es zurück, sobald er den Steady State erreicht.
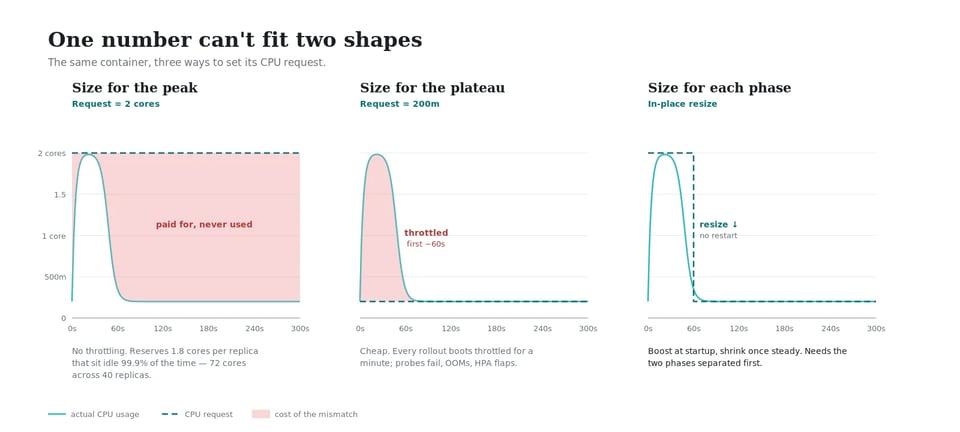
Das funktioniert nur, wenn Sie die beiden Phasen überhaupt unterscheiden können – und genau dafür ist alles oben Beschriebene da.
FAQ
Was ist CPU-Throttling in Kubernetes? CPU-Throttling tritt auf, wenn ein Container innerhalb einer CFS-Scheduling-Periode (standardmäßig 100 ms) mehr CPU-Zeit nutzen will, als sein Limit erlaubt. Der Kernel pausiert den Container bis zum Beginn der nächsten Periode. Ein Limit von 500m lässt einen Container 50 ms von jeweils 100 ms laufen; ist das früh aufgebraucht, wartet der Container. Throttling verlangsamt die Anwendung, ohne sie zum Absturz zu bringen, und kann sogar auftreten, wenn der Node freie CPU hat.
Warum wird mein Pod nur beim Start per OOM Kill beendet? Die Initialisierung allokiert oft mehr Speicher als der Steady-State-Betrieb: Klassen laden, Caches aufbauen, Migrationen ausführen oder einen JVM-Heap dimensionieren, bevor die Anwendung ihr tatsächliches Working Set kennt. Wenn das Memory-Limit den Steady-State-Wert abdeckt, aber nicht den Startup-Peak, killt der Kernel den Container während des Boots mit Exit-Code 137. Übersteht der Container den Start, fällt die Nutzung unter das Limit und der Pod läuft normal – deshalb bleibt der Restart-Zähler meist bei eins oder zwei stehen.
Wie unterscheide ich einen Startup-Spike von einem Steady-State-Sizing-Problem? Filtern Sie Ihre Throttling- und OOM-Metriken nach Container-Alter. Konzentrieren sich die Probleme auf die ersten ein bis zwei Minuten eines Container-Lebens und verschwinden danach, ist es ein Startup-Spike. Treten sie an zufälligen Punkten im Lebenszyklus des Pods auf, ist der Steady-State-Request oder das Limit falsch.
Behebt das Entfernen von CPU-Limits das Startup-Throttling? Es entfernt die CFS-Quota, der Container kann also in die freie CPU des Nodes bursten. Das hilft, wenn Nodes Spielraum haben. Es hilft nicht während eines Rollouts, wenn viele Pods gleichzeitig auf demselben Node starten, weil dann keine freie CPU zum Bursten da ist. Der Request bestimmt weiterhin das Scheduling – ein zu klein gewählter Request kann also immer noch zu viele Pods mit Spikes auf einem Node landen lassen.
Beide Phasen jedes Workloads im Blick
Alles oben Beschriebene können Sie mit Prometheus, kube-state-metrics und ein paar Grafana-Panels selbst bauen. Der schwierige Teil ist, das für 400 Workloads zu tun und aktuell zu halten, während Code-Änderungen verschieben, wo der Spike landet.
PerfectScale by DoiT profiliert jeden Container auf Workload-Ebene, sodass Startup-Verhalten und Steady-State-Verhalten als getrennte Muster sichtbar werden statt als ein vermischter Durchschnitt. Bei Java-Workloads geht es eine Ebene tiefer: Sobald der Coroot-Agent aktiviert ist, erkennt es JVM-Container automatisch, verfolgt Heap, Non-Heap und GC-Zeit im Zeitverlauf, markiert Container, die ohne explizite Heap-Einstellungen laufen, und respektiert -Xms und -Xmx, wenn es eine Empfehlung ausspricht oder eine Änderung anwendet. Auf Clustern mit Kubernetes 1.33 oder neuer wendet die Automatisierung Right-Sizing direkt im laufenden Betrieb an, ohne den Pod neu zu starten, und greift nur dann auf einen Rolling Restart zurück, wenn ein Resize auf dem aktuellen Node nicht machbar ist.
Sie möchten live sehen, wie der Startup-Spike geglättet wird? Kommen Sie zum Workshop zum JVM-Startup-Spike, in dem wir durchgehen, was beim Boot in der JVM passiert, und einen laufenden Pod ohne Neustart auf Steady-State-Werte verkleinern. Oder buchen Sie eine technische Session, und wir schauen uns gemeinsam Ihre Cluster an.