
Cada afirmación sobre Cast AI que aparece abajo enlaza a su propia documentación pública, verificada el 2 de septiembre de 2026. Ambos productos lanzan actualizaciones con frecuencia, así que sigue los enlaces y compruébalo por ti mismo.
TL;DR
Cast AI y PerfectScale optimizan workloads de Kubernetes, pero se diferencian en tres aspectos que importan cuando operas clústeres de producción a escala.
Esto es lo que necesitas saber:
- Los deploys rompen el dimensionamiento de Cast AI: Su autoescalador no recalcula la línea base cuando lanzas un nuevo release. Las recomendaciones construidas con la versión anterior se aplican a tu código nuevo, y sus mecanismos de seguridad solo reaccionan cuando algo ya falló (un OOMKill, un estancamiento de CPU)
- La configuración vive en el lugar equivocado: Cast AI exige definir los overrides por workload como anotaciones directamente en los manifiestos de tu aplicación. Esto significa que los ajustes de optimización viven en el mismo YAML que editan tus equipos de producto, y un redeploy desde Git puede borrarlos sin que nadie lo note
- Cast AI se detiene en el límite del clúster: Sin reportes históricos de costos, sin ingesta del AWS Cost and Usage Report y con precios basados en la lista pública en lugar de tu factura real
- PerfectScale resuelve los tres puntos: Dimensionamiento por revisión que se adapta al código que realmente está en ejecución, configuración de automatización en sus propios recursos personalizados fuera de tus manifiestos e integración con DoiT Cloud Intelligence para commitments, atribución de costos y facturación multinube
- Puedes ejecutar ambos a la vez: Deja que Cast AI siga aprovisionando nodos, desactiva su autoescalador de workloads y deja que PerfectScale se encargue del right-sizing de workloads en los mismos clústeres - sin necesidad de migrar para comparar
1. Su autoescalador no recalcula la línea base con cada nuevo release
El Workload Autoscaler de Cast AI dimensiona los workloads a partir de una ventana retrospectiva, configurable de 3 horas a 7 días y con un valor predeterminado de 24 horas, condicionada por un puntaje de confianza que mide "la proporción entre los puntos de datos de métricas recolectados y el número esperado de puntos de datos dentro de la ventana retrospectiva configurada".
Observa qué es lo que realmente hace que esa recomendación cambie. Su documentación enumera los detonantes: un ciclo de regeneración de 30 minutos y uso anómalo, eventos de OOM, desalojos por presión de memoria, picos de uso, estancamiento de CPU y fallas en las probes de arranque.
Lanzar una nueva versión de tu aplicación no está en esa lista.
Sigue la secuencia. A las 14:00 despliegas un release que cambia el perfil de memoria de una aplicación. La recomendación en curso se calculó con una ventana dominada por la versión anterior. En su modo diferido predeterminado, "el webhook de admisión mutante de Cast AI aplica la recomendación cuando los pods se recrean de forma natural, por ejemplo, durante los despliegues de la aplicación". Tu deploy es el evento que estampa el dimensionamiento de ayer sobre el código de hoy.
Sus mecanismos de seguridad existen, y todos son reactivos. La detección de estancamiento eleva la recomendación cuando PSI muestra contención de CPU, aunque solo aplica a CPU y requiere Kubernetes 1.34 o superior. Tras un OOMKill, el ajuste de sobrecarga de memoria agrega "un 20% o 100Mi, lo que sea mayor", y luego lo reduce linealmente hasta cero a lo largo de 24 horas. Es un buen mecanismo de recuperación. Pero recuperación significa que el pod ya murió.
PerfectScale aborda el mismo momento desde el otro extremo. La detección de revisiones acota las recomendaciones a la revisión que realmente está en ejecución en lugar de mezclar datos de versiones anteriores, y cuando tú mismo cambias los recursos, la automatización te cede el paso: "PerfectScale no contradice tus cambios de desarrollo y, aunque la automatización esté activada, PerfectScale acepta de inmediato los cambios de cualquier usuario en lugar de las recomendaciones vigentes. El sistema aumentará o reducirá recursos según sea necesario solo cuando tengamos una comprensión clara de cómo se comparan los cambios con los patrones de uso".
Esa es la diferencia en una sola línea. Al momento del deploy, un sistema aplica lo que aprendió antes de tu cambio. El otro se hace a un lado hasta haber aprendido tu cambio.
Para rollouts por fases, PerfectScale detecta automáticamente tu estrategia de Argo Rollouts, ya sea blue-green, canary o A/B, sin etiquetas ni configuración manual. Tú eliges el comportamiento: pausa, el valor predeterminado, no aplica nada mientras existan ReplicaSets concurrentes; agregación combina la utilización entre ellos y aplica una sola recomendación.
El punto no es tener una gráfica más limpia. Es que la automatización se mantenga encendida. Los equipos que se queman una vez excluyen en silencio sus servicios más grandes, y los ahorros se van con ellos.
Aprende cómo reducir los costos de Kubernetes sin romper tus SLOs →
2. Tu configuración de optimización no debería vivir en los manifiestos de tu aplicación
Haz una pregunta más precisa que la habitual: no dónde están mis datos, sino quién es dueño de la configuración y en qué archivo está.
En Cast AI, los ajustes por workload son anotaciones en el controlador del workload, y su documentación es explícita en que no hay alternativa: "Las anotaciones son la única forma de sobrescribir los ajustes de escalado vertical para workloads individuales. La consola de Cast AI no admite overrides de ajustes por workload". La referencia de configuración dice lo mismo: "Aún puedes activar o desactivar la optimización para workloads individuales desde la consola, pero todos los demás overrides a nivel de workload deben configurarse mediante anotaciones".
Eso significa que la política de optimización queda desperdigada por tus manifiestos de aplicación, en el mismo YAML que editan tus equipos de producto, y son los dueños de las apps quienes terminan cargando con ella. Cast AI también documenta el drift que esto genera: "estas optimizaciones existen solo en el estado vivo del clúster. Cuando vuelves a desplegar un workload desde Git, los valores originales del manifiesto sobrescriben los ajustes optimizados y tus recursos regresan a valores obsoletos y sin optimizar".
PerfectScale mantiene la optimización completamente fuera de tus manifiestos de aplicación. La configuración de la automatización es su propio conjunto de recursos personalizados, ClusterAutomationConfig, NamespaceAutomationConfig y WorkloadAutomationConfig, donde los ajustes de workload prevalecen sobre los de namespace y los de namespace sobre los del clúster. Un solo grafo de objetos, propiedad del equipo de plataforma, revisado en su propio pull request.
La automatización no toca la especificación de recursos de tus Deployments. De la documentación de integración con Argo CD: "La automatización cambia los recursos a nivel de pod sin afectar la especificación de recursos del objeto padre (Deployment, StatefulSet, etc.), por lo que ArgoCD no detecta ningún cambio y no intentará revertirlo". Tanto Argo CD como Flux son compatibles.
Y los controles que te importan a las 2 de la mañana son operaciones de kubectl contra un recurso en tu propio clúster, no un ticket de soporte. stopAllAutomation detiene todo a nivel de clúster, "anulando cualquier configuración de automatización existente para namespaces o workloads específicos". cleanupAllAutomation va más lejos y "no solo detendrá la automatización, sino que también revertirá cualquier modificación realizada por los procesos de automatización, restaurando las especificaciones y ajustes originales de los recursos".
Con un clúster, esto es una preferencia. Con cincuenta, es la diferencia entre un equipo de plataforma que es dueño de la optimización y uno que la hereda.
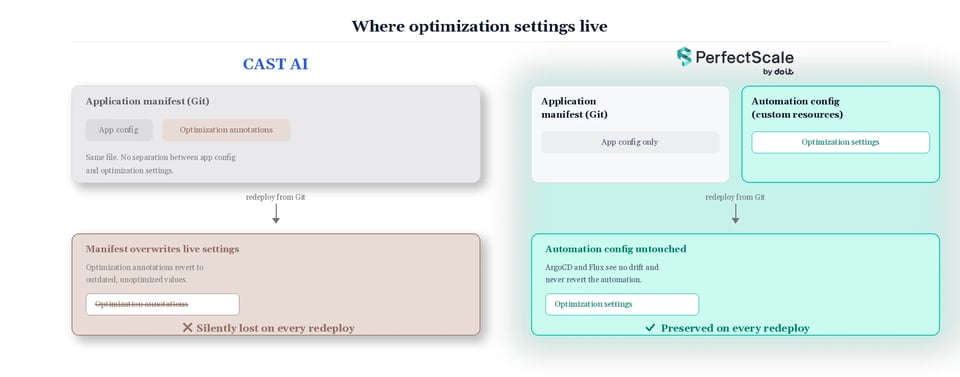 Cast AI mezcla los ajustes de optimización dentro de los manifiestos de tu aplicación, así que un redeploy desde Git los sobrescribe en silencio. PerfectScale mantiene la configuración de automatización separada, de modo que sobrevive intacta a cada redeploy.
3. La optimización no se detiene en el límite del clúster
La tercera razón tiene que ver con el alcance, no con una funcionalidad en particular.
Cast AI sí da seguimiento a los commitments. Lo que no hace es darte el historial ni los datos reales de tu factura. Su propia documentación: "Actualmente, los reportes solo ofrecen una instantánea de la situación presente, sin la posibilidad de revisar datos históricos". La utilización "no se actualiza con frecuencia" y se recalcula con cambios en nodos y clústeres. Y el modelo de costos subyacente es el precio de lista, no tu factura. De su página de gestión de costos: "No se requiere acceso a facturación. CAST AI usa precios públicos, así que no tienes que compartir detalles de facturación". Eso es una comodidad genuina al empezar y un techo real más adelante. No encontramos ingesta del AWS Cost and Usage Report en ningún lugar de su documentación.
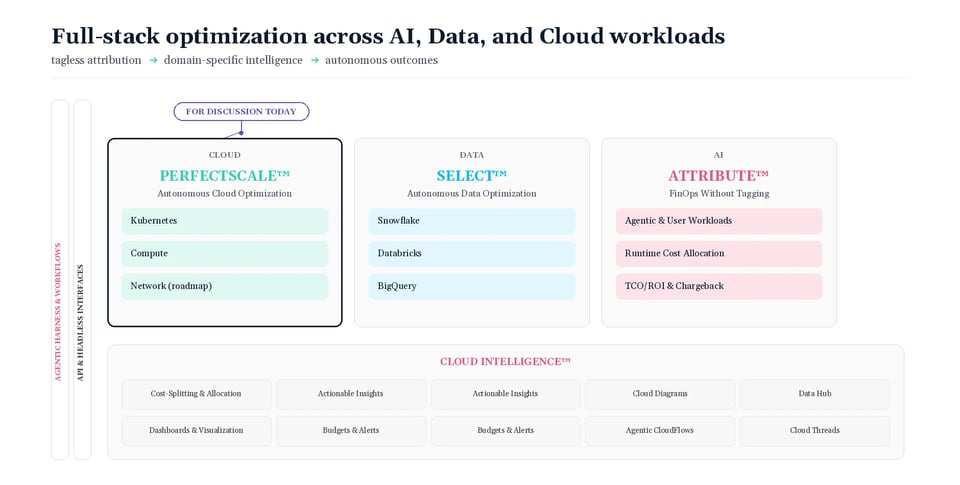
PerfectScale forma parte de DoiT, así que la misma relación cubre el trabajo que empieza donde termina el clúster.
Commitments. PerfectScale for Commitments optimiza de forma continua los AWS Savings Plans para EC2, Fargate y Lambda, además de los Savings Plans de bases de datos para Aurora y RDS, Aurora Serverless v2, Aurora DSQL, DynamoDB, ElastiCache for Valkey, DocumentDB, Neptune, Keyspaces, Timestream, DMS y OpenSearch, siguiendo las reglas de elegibilidad de AWS. El soporte para CUDs de Google Cloud ya está en disponibilidad general y cubre Compute Engine, Cloud SQL, BigQuery Editions, AlloyDB, Spanner, Firestore, Dataflow, Memorystore, Bigtable y Managed Service for Apache Kafka. El escalonamiento de commitments distribuye varios planes más pequeños con fechas superpuestas, de modo que "si el uso baja, solo una pequeña fracción de tus commitments se ve afectada".
Atribución. Attribute responde la pregunta que las etiquetas no pueden: qué cliente o funcionalidad generó este gasto. Un sensor eBPF ligero se despliega vía Helm en unos 15 minutos sin cambios de código ni de configuración, y los clústeres multi-tenant, las bases de datos compartidas y las colas de mensajes se reparten según el consumo observado en tiempo de ejecución, no según claves de asignación.
La factura misma, y las personas. DoiT Cloud Intelligence cubre los costos de AWS, Google Cloud y Azure, con Forward Deployed Engineers que, como decimos nosotros, vienen con la plataforma y no con la factura.
No tienes que desmontar nada para comprobarlo
Vale la pena ser directos sobre la ruta de evaluación. Las dos plataformas operan en capas distintas, así que puedes ejecutarlas en paralelo: deja que Cast AI siga aprovisionando nodos, desactiva su autoescalador de workloads para evitar cambios en conflicto y deja que PerfectScale se encargue del right-sizing de workloads en los mismos clústeres. Sin migración, sin riesgo de cambio y con una comparación sobre tus workloads de producción en lugar de una hoja de cálculo.
La cereza del pastel
Si hoy eres cliente de Cast AI, tomaremos el promedio de tus últimas tres facturas mensuales de Cast AI, lo reduciremos a la mitad y ese será tu precio mensual fijo de PerfectScale durante 24 meses.
El mismo trabajo esencial. Aproximadamente la mitad del costo de plataforma. Una automatización que se hace a un lado cuando despliegas, una configuración que vive donde tu equipo de plataforma puede gestionarla y una plataforma que sigue trabajando más allá del límite del clúster.
Si hoy usas Cast AI, la forma más rápida de ver la diferencia no cuesta nada. Ejecuta PerfectScale en paralelo en los mismos clústeres, sin migración y sin desmontar nada, y compara los resultados en tus propios workloads de producción. Si los números se sostienen, reduciremos a la mitad tu gasto mensual promedio en Cast AI y lo dejaremos fijo por 24 meses.
Agenda una llamada y trae tus últimas tres facturas
Oferta disponible para clientes actuales de Cast AI. Los términos se confirman en la llamada.
Preguntas frecuentes
¿Por qué el autoescalador de Cast AI no se adapta a los nuevos releases de la aplicación?
El Workload Autoscaler de Cast AI construye sus recomendaciones de dimensionamiento a partir de una ventana retrospectiva de métricas recolectadas, con un valor predeterminado típico de 24 horas. Según su propia documentación, los detonantes que hacen que una recomendación se actualice incluyen un ciclo de regeneración de 30 minutos, eventos de OOM, desalojos por presión de memoria, picos de uso, estancamientos de CPU y fallas en las probes de arranque.
Un nuevo despliegue de la aplicación no está en esa lista. Así que cuando lanzas un release que cambia el perfil de memoria o CPU de tu app, la recomendación aún en curso se construyó con el comportamiento de la versión anterior. En el modo diferido predeterminado de Cast AI, esa recomendación desactualizada se aplica en el momento en que tus pods se recrean durante el propio deploy.
Sus mecanismos de seguridad, como la detección de estancamiento y el ajuste de sobrecarga de memoria tras un OOMKill, solo responden después de que un problema ya ocurrió, no antes.
¿Cómo maneja PerfectScale el dimensionamiento durante los despliegues?
PerfectScale utiliza detección de revisiones, que acota las recomendaciones de recursos a la revisión específica que realmente está en ejecución, en lugar de mezclar datos de versiones antiguas y nuevas. Cuando haces cambios manuales de recursos, la automatización de PerfectScale respeta tus cambios de inmediato en lugar de sobrescribirlos, y solo vuelve a ajustar una vez que ha observado cómo se compara tu cambio con los patrones de uso reales.
Para los equipos que usan estrategias de rollout por fases, PerfectScale detecta automáticamente las estrategias de Argo Rollouts (blue-green, canary o A/B) sin etiquetado manual, y te permite elegir entre pausar las recomendaciones durante un rollout o agregar la utilización entre ReplicaSets concurrentes.
¿Dónde guarda Cast AI los ajustes de optimización por workload y por qué importa?
Cast AI exige que los overrides de configuración por workload se definan como anotaciones directamente en los controladores de tus workloads, dentro de los mismos manifiestos de aplicación que editan tus equipos de producto. La propia documentación de Cast AI confirma que no hay alternativa: las anotaciones son la única forma de sobrescribir los ajustes de escalado vertical para workloads individuales.
Esto crea un problema operativo real. Como estas optimizaciones existen solo en el estado vivo del clúster, volver a desplegar un workload desde Git sobrescribe el manifiesto con sus valores originales sin optimizar, revirtiendo en silencio cualquier ajuste que se hubiera aplicado.
PerfectScale evita esto manteniendo la configuración de automatización en su propio conjunto de recursos personalizados (ClusterAutomationConfig, NamespaceAutomationConfig y WorkloadAutomationConfig), completamente separados de tus manifiestos de aplicación. Esto significa que el equipo de plataforma es dueño de los ajustes de optimización y los revisa de forma independiente, y un redeploy de GitOps mediante Argo CD o Flux no detectará ni revertirá los ajustes a nivel de pod de PerfectScale.
¿Qué significa que "la optimización no se detiene en el límite del clúster"?
Se refiere a la diferencia de alcance entre las dos plataformas una vez que miras más allá del propio clúster de Kubernetes. Los reportes de costos de Cast AI solo ofrecen una instantánea de tu situación actual, sin posibilidad de revisar datos históricos de costos, y las cifras de utilización no se actualizan con frecuencia. Su modelo de costos también se basa en los precios de lista públicos y no en tu factura real de la nube, ya que Cast AI no requiere acceso a facturación.
PerfectScale forma parte de DoiT, que extiende la optimización más allá del clúster para incluir la gestión continua de AWS Savings Plans y de los Committed Use Discounts de Google Cloud en una amplia gama de servicios, la atribución de costos a nivel de cliente o funcionalidad mediante un sensor eBPF, y una visibilidad de facturación unificada de AWS, Google Cloud y Azure a través de DoiT Cloud Intelligence.
¿Puedo probar PerfectScale sin migrar primero desde Cast AI?
Sí. Como las dos plataformas operan en capas distintas, puedes ejecutarlas en paralelo en los mismos clústeres. Deja que Cast AI siga encargándose del aprovisionamiento de nodos, desactiva su autoescalador de workloads para evitar cambios en conflicto y deja que PerfectScale asuma el right-sizing de workloads.
Esto significa que puedes comparar las dos plataformas directamente en tus workloads de producción en lugar de depender de una estimación en una hoja de cálculo, sin migración ni riesgo de cambio en la evaluación misma.
¿Cuál es la oferta para los clientes actuales de Cast AI que cambian a PerfectScale?
PerfectScale tomará el promedio de tus últimas tres facturas mensuales de Cast AI, reducirá esa cifra a la mitad y la fijará como tu precio mensual de PerfectScale durante 24 meses. La oferta está disponible para clientes actuales de Cast AI y los términos se confirman en una llamada.