
Todas as afirmações sobre o Cast AI abaixo levam à documentação pública deles, verificada em 02/09/2026. Os dois produtos lançam atualizações com frequência, então siga os links em vez de simplesmente acreditar na nossa palavra.
TL;DR
O Cast AI e o PerfectScale otimizam workloads de Kubernetes, mas eles se diferenciam em três pontos que fazem diferença quando você opera clusters de produção em escala.
Veja o que você precisa saber:
- Deploys quebram o dimensionamento do Cast AI: O autoscaler deles não recalcula a linha de base quando você lança um novo release. Recomendações construídas a partir da versão antiga são aplicadas ao seu código novo, e as redes de segurança só reagem depois que algo já falhou (um OOMKill, um stall de CPU)
- A configuração fica no lugar errado: O Cast AI exige overrides por workload como annotations diretamente nos manifests da sua aplicação. Isso significa que as configurações de otimização vivem no mesmo YAML que seus times de produto editam, e um redeploy via Git pode apagá-las silenciosamente
- O Cast AI para na borda do cluster: Sem relatórios históricos de custo, sem ingestão do AWS Cost and Usage Report e com preços baseados na tabela pública, não na sua fatura real
- O PerfectScale resolve os três pontos: Dimensionamento sensível a revisões que se adapta ao código que está de fato rodando, configuração de automação mantida em custom resources próprios, fora dos seus manifests, e integração com o DoiT Cloud Intelligence para commitments, atribuição de custos e billing multi-cloud
- Você pode rodar os dois ao mesmo tempo: Mantenha o Cast AI provisionando nós, desative o workload autoscaler dele e deixe o PerfectScale cuidar do rightsizing de workloads nos mesmos clusters - nenhuma migração necessária para comparar
1. O autoscaler deles não recalcula a linha de base em novos releases
O Workload Autoscaler do Cast AI dimensiona workloads a partir de uma janela retroativa, configurável de 3 horas a 7 dias, com padrão de 24 horas, condicionada a um score de confiança que mede "a proporção entre os pontos de dados de métricas coletados e o número esperado de pontos de dados dentro da janela retroativa configurada".
Veja o que de fato faz essa recomendação mudar. A documentação deles lista os gatilhos: um ciclo de regeneração de 30 minutos e uso anômalo, eventos de OOM, evictions por pressão de memória, picos de uso, stall de CPU e falhas no startup probe.
Lançar uma nova versão da sua aplicação não está nessa lista.
Então acompanhe a sequência. Às 14h você faz o deploy de um release que muda o perfil de memória de uma aplicação. A recomendação em andamento foi calculada a partir de uma janela dominada pela versão anterior. No modo deferred, o padrão deles, "o mutating admission webhook do Cast AI aplica a recomendação quando os pods são recriados naturalmente, por exemplo, durante deploys da aplicação". Seu deploy é o evento que carimba o dimensionamento de ontem no código de hoje.
As redes de segurança deles existem, e são todas reativas. A detecção de stall aumenta a recomendação quando o PSI mostra contenção de CPU, mas cobre apenas CPU e exige Kubernetes 1.34 ou superior. Depois de um OOMKill, o ajuste de overhead de memória adiciona "20% ou 100Mi, o que for maior", e depois reduz esse valor linearmente até zero ao longo de 24 horas. É um bom mecanismo de recuperação. Mas recuperação significa que o pod já morreu.
O PerfectScale aborda o mesmo momento pelo outro lado. A sensibilidade a revisões restringe as recomendações à revisão que está de fato rodando, em vez de misturar dados de versões antigas, e quando você mesmo altera os recursos, a automação cede a vez para você: "O PerfectScale não contradiz suas mudanças de desenvolvimento e, mesmo com a automação ligada, o PerfectScale aceita imediatamente as alterações específicas do usuário no lugar das recomendações atuais. O sistema só vai aumentar ou reduzir recursos conforme necessário depois que tivermos um entendimento claro de como as mudanças se comparam aos padrões de uso."
Essa é a diferença em uma linha. Na hora do deploy, um sistema aplica o que aprendeu antes da sua mudança. O outro sai do caminho até ter aprendido a sua mudança.
Para rollouts em fases, o PerfectScale detecta sua estratégia de Argo Rollouts automaticamente, seja blue-green, canary ou A/B, sem tags nem configuração manual. Você escolhe o comportamento: pause, o padrão, não aplica nada enquanto existirem ReplicaSets concorrentes, e aggregate consolida a utilização entre eles e aplica uma única recomendação.
A questão não é ter um gráfico mais bonito. É a automação continuar ligada. Times que se queimam uma vez excluem discretamente seus maiores serviços, e a economia vai embora junto.
Aprenda a reduzir custos de Kubernetes sem quebrar seus SLOs →
2. Sua configuração de otimização não deveria viver nos manifests da aplicação
Faça uma pergunta mais específica do que a de sempre: não onde estão meus dados, mas quem é o dono da configuração e em qual arquivo ela está.
No Cast AI, as configurações por workload são annotations no controller do workload, e a documentação deles é explícita ao dizer que não existe alternativa: "Annotations são a única forma de sobrescrever configurações de escalonamento vertical para workloads individuais. O console do Cast AI não suporta overrides de configuração por workload." A referência de configurações diz o mesmo: "Você ainda pode ligar ou desligar a otimização de workloads individuais pelo console, mas todos os outros overrides no nível do workload precisam ser configurados via annotations."
Isso significa que a política de otimização fica espalhada pelos manifests da sua aplicação, no mesmo YAML que seus times de produto editam, e são os donos das aplicações que acabam carregando esse peso. O Cast AI também documenta o desvio que isso gera: "essas otimizações existem apenas no estado ativo do cluster. Quando você faz o redeploy de um workload a partir do Git, os valores originais do manifest sobrescrevem as configurações otimizadas, revertendo seus recursos para valores desatualizados e não otimizados."
O PerfectScale mantém a otimização totalmente fora dos manifests da sua aplicação. A configuração de automação é um conjunto próprio de custom resources, ClusterAutomationConfig, NamespaceAutomationConfig e WorkloadAutomationConfig, em que as configurações de workload sobrescrevem as de namespace, e as de namespace sobrescrevem as de cluster. Um único grafo de objetos, sob responsabilidade do time de plataforma, revisado em seu próprio pull request.
A automação não toca no spec de resources dos seus Deployments. Da documentação de integração com o Argo CD: "A automação altera recursos no nível do pod sem afetar o spec de resources dos recursos pai (Deployment, StatefulSet etc.), então o ArgoCD não detecta nenhuma mudança e não vai tentar revertê-la." Tanto o Argo CD quanto o Flux são suportados.
E os controles que importam às 2h da manhã são operações de kubectl em um recurso do seu próprio cluster, não um ticket de suporte. stopAllAutomation interrompe tudo no cluster inteiro, "sobrescrevendo quaisquer configurações de automação existentes para namespaces ou workloads específicos". cleanupAllAutomation vai além e "não só interrompe a automação como também reverte quaisquer modificações feitas pelos processos de automação, restaurando as especificações e configurações originais dos recursos".
Em um cluster, isso é questão de preferência. Em cinquenta, é a diferença entre um time de plataforma que é dono da otimização e um que apenas a herda.
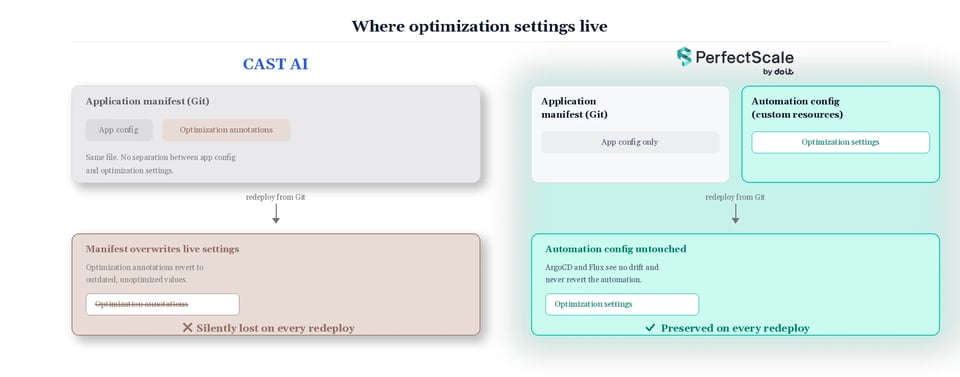 O Cast AI mistura as configurações de otimização nos manifests da sua aplicação, então um redeploy via Git as sobrescreve silenciosamente. O PerfectScale mantém a configuração de automação separada, então ela sobrevive intacta a cada redeploy.
3. A otimização não para na borda do cluster
O terceiro motivo é uma questão de escopo, não de funcionalidade.
O Cast AI acompanha commitments, sim. O que ele não faz é entregar o histórico nem os dados reais da sua fatura. A própria documentação deles: "Atualmente, os relatórios fornecem apenas um retrato da situação presente, sem a possibilidade de revisar dados históricos." A utilização "não é atualizada com frequência", sendo recalculada em mudanças de nós e clusters. E o modelo de custo por trás usa preço de tabela, não a sua fatura. Da página de gestão de custos deles: "Acesso ao billing não é necessário. O CAST AI usa preços públicos, então você não precisa compartilhar detalhes de faturamento." Isso é uma conveniência real no onboarding e um teto real mais adiante. Não encontramos ingestão do AWS Cost and Usage Report em nenhum lugar da documentação deles.
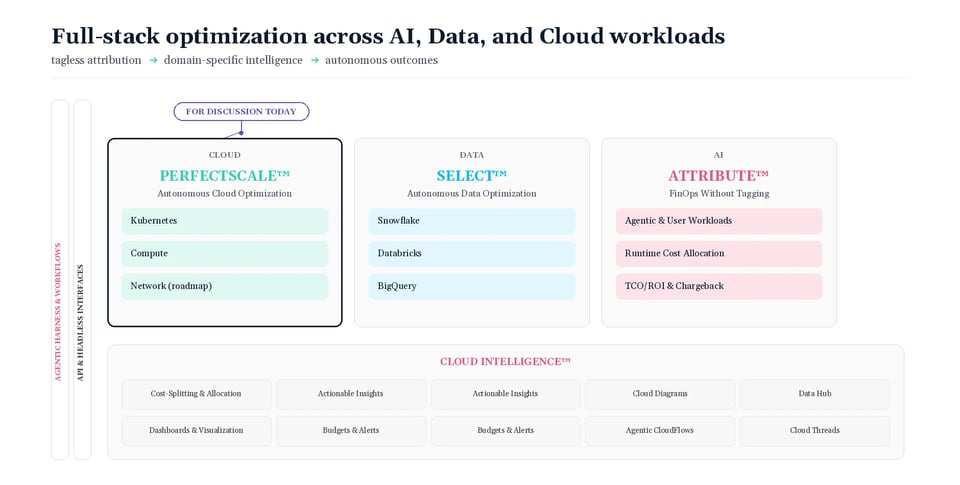
O PerfectScale faz parte da DoiT, então a mesma parceria cobre o trabalho que começa onde o cluster termina.
Commitments. O PerfectScale for Commitments otimiza continuamente os AWS Savings Plans em EC2, Fargate e Lambda, além de Savings Plans de banco de dados em Aurora e RDS, Aurora Serverless v2, Aurora DSQL, DynamoDB, ElastiCache for Valkey, DocumentDB, Neptune, Keyspaces, Timestream, DMS e OpenSearch, seguindo as regras de elegibilidade da AWS. O suporte a CUDs do Google Cloud agora também está em GA, cobrindo Compute Engine, Cloud SQL, BigQuery Editions, AlloyDB, Spanner, Firestore, Dataflow, Memorystore, Bigtable e Managed Service for Apache Kafka. O laddering de commitments escalona vários planos menores com datas sobrepostas, então "se o uso cair, apenas uma pequena fração dos seus commitments é impactada".
Atribuição. O Attribute responde à pergunta que as tags não conseguem responder: qual cliente ou funcionalidade gerou esse gasto. Um sensor eBPF leve é implantado via Helm em cerca de 15 minutos, sem mudanças de código ou configuração, e clusters multi-tenant, bancos de dados compartilhados e filas de mensagens são divididos pelo consumo observado em runtime, não por chaves de alocação.
A fatura em si, e as pessoas. O DoiT Cloud Intelligence cobre custos em AWS, Google Cloud e Azure, com Forward Deployed Engineers que, como gostamos de dizer, vêm com a plataforma, não com a fatura.
Você não precisa arrancar nada para descobrir
Vale ser direto sobre o caminho de avaliação. As duas plataformas operam em camadas diferentes, então você pode rodá-las lado a lado: mantenha o Cast AI provisionando nós, desative o workload autoscaler deles para evitar mudanças conflitantes e deixe o PerfectScale assumir o rightsizing de workloads nos mesmos clusters. Sem migração, sem risco de troca e com uma comparação nos seus workloads de produção, não em uma planilha.
A cereja do bolo
Se você é cliente do Cast AI hoje, vamos pegar a média das suas últimas três faturas mensais do Cast AI, cortar pela metade e transformar isso no seu preço mensal fixo do PerfectScale por 24 meses.
A mesma função principal. Cerca de metade do custo da plataforma. Automação que sai do caminho quando você faz deploy, configuração que vive onde seu time de plataforma pode ser dono dela e uma plataforma que continua além da borda do cluster.
Se você roda Cast AI hoje, a forma mais rápida de ver a diferença não custa nada. Rode o PerfectScale junto com ele nos mesmos clusters, sem migração, sem arrancar e substituir nada, e compare os resultados nos seus próprios workloads de produção. Se os números se confirmarem, cortamos pela metade seu gasto mensal médio com o Cast AI e travamos esse valor por 24 meses.
Agende uma conversa e traga suas últimas três faturas
Oferta disponível para clientes atuais do Cast AI. Condições confirmadas na conversa.
Perguntas frequentes
Por que o autoscaler do Cast AI não se adapta a novos releases da aplicação?
O Workload Autoscaler do Cast AI constrói suas recomendações de dimensionamento a partir de uma janela retroativa de métricas coletadas, normalmente com padrão de 24 horas. Segundo a própria documentação, os gatilhos que fazem uma recomendação ser atualizada incluem um ciclo de regeneração de 30 minutos, eventos de OOM, evictions por pressão de memória, picos de uso, stalls de CPU e falhas no startup probe.
Um novo deploy da aplicação não está nessa lista. Então, quando você lança um release que muda o perfil de memória ou CPU do seu app, a recomendação ainda em andamento foi construída a partir do comportamento da versão anterior. No modo deferred, o padrão do Cast AI, essa recomendação desatualizada é aplicada no momento em que seus pods são recriados durante o próprio deploy.
As redes de segurança deles, como a detecção de stall e o ajuste de overhead de memória pós-OOMKill, só respondem depois que um problema já ocorreu, não antes.
Como o PerfectScale trata o dimensionamento de forma diferente durante deploys?
O PerfectScale usa sensibilidade a revisões, que restringe as recomendações de recursos à revisão específica que está de fato rodando, em vez de misturar dados de versões antigas e novas. Quando você faz alterações manuais de recursos, a automação do PerfectScale acata suas mudanças imediatamente em vez de sobrescrevê-las, e só volta a ajustar depois de observar como sua mudança se compara aos padrões reais de uso.
Para times que usam estratégias de rollout em fases, o PerfectScale detecta automaticamente estratégias de Argo Rollouts (blue-green, canary ou A/B) sem necessidade de tags manuais, e permite escolher entre pausar as recomendações durante um rollout ou agregar a utilização entre ReplicaSets concorrentes.
Onde o Cast AI armazena as configurações de otimização por workload, e por que isso importa?
O Cast AI exige que os overrides de configuração por workload sejam definidos como annotations diretamente nos seus workload controllers, dentro dos mesmos manifests de aplicação que seus times de produto editam. A própria documentação do Cast AI confirma que não há alternativa: annotations são a única forma de sobrescrever configurações de escalonamento vertical para workloads individuais.
Isso cria um problema operacional real. Como essas otimizações existem apenas no estado ativo do cluster, o redeploy de um workload a partir do Git sobrescreve o manifest com seus valores originais, não otimizados, revertendo silenciosamente qualquer ajuste que tenha sido aplicado.
O PerfectScale evita isso mantendo a configuração de automação em seu próprio conjunto de custom resources (ClusterAutomationConfig, NamespaceAutomationConfig e WorkloadAutomationConfig), totalmente separado dos manifests da sua aplicação. Isso significa que o time de plataforma é dono das configurações de otimização e as revisa de forma independente, e um redeploy via GitOps com Argo CD ou Flux não detecta nem reverte os ajustes do PerfectScale no nível do pod.
O que significa "a otimização não para na borda do cluster"?
Refere-se à diferença de escopo entre as duas plataformas quando você olha além do cluster Kubernetes em si. Os relatórios de custo do Cast AI fornecem apenas um retrato da sua situação atual, sem a possibilidade de revisar dados históricos de custo, e os números de utilização não são atualizados com frequência. O modelo de custo também se baseia em preços públicos de tabela, e não na sua fatura real de nuvem, já que o Cast AI não exige acesso ao billing.
O PerfectScale faz parte da DoiT, o que estende a otimização para além do cluster e inclui a gestão contínua de AWS Savings Plans e Committed Use Discounts do Google Cloud em uma ampla gama de serviços, atribuição de custos até o nível de cliente ou funcionalidade usando um sensor eBPF, e visibilidade unificada de billing em AWS, Google Cloud e Azure por meio do DoiT Cloud Intelligence.
Posso testar o PerfectScale sem antes migrar do Cast AI?
Sim. Como as duas plataformas operam em camadas diferentes, você pode rodá-las lado a lado nos mesmos clusters. Mantenha o Cast AI cuidando do provisionamento de nós, desative o workload autoscaler dele para evitar mudanças conflitantes e deixe o PerfectScale assumir o rightsizing de workloads.
Isso significa que você pode comparar as duas plataformas diretamente nos seus workloads de produção, em vez de depender de uma estimativa em planilha, sem nenhum risco de migração ou troca envolvido na própria avaliação.
Qual é a oferta para clientes atuais do Cast AI que migrarem para o PerfectScale?
O PerfectScale vai pegar a média das suas últimas três faturas mensais do Cast AI, cortar esse valor pela metade e travá-lo como seu preço mensal fixo do PerfectScale por 24 meses. A oferta está disponível para clientes atuais do Cast AI, com condições confirmadas em uma conversa.