
以下のCast AIに関する記述はすべて、同社の公開ドキュメント(2026年9月2日時点で確認)にリンクしています。両製品とも頻繁にアップデートされるため、本記事を鵜呑みにせず、リンク先をご確認ください。
TL;DR
Cast AIとPerfectScaleはどちらもKubernetesワークロードを最適化しますが、本番クラスターを大規模に運用する段階になると効いてくる違いが3つあります。
押さえておくべきポイントは次のとおりです。
- デプロイがCast AIのサイジングを狂わせる: 同社のオートスケーラーは、新しいリリースをデプロイしてもベースラインを取り直しません。旧バージョンのデータから算出された推奨値が新しいコードに適用され、セーフティネットが反応するのは、OOMKillやCPUストールなど、実際に障害が起きた後です
- 設定の置き場所が不適切: Cast AIでは、ワークロード単位のオーバーライドをアプリケーションマニフェスト内のアノテーションとして直接記述する必要があります。つまり最適化設定はプロダクトチームが編集するのと同じYAMLの中にあり、Gitからの再デプロイで気づかないうちに消えてしまうおそれがあります
- Cast AIはクラスターの境界で止まる: 過去のコストレポートはなく、AWS Cost and Usage Reportの取り込みもなく、価格は実際の請求額ではなく公開定価に基づいています
- PerfectScaleはこの3点をすべて解決: 実際に稼働しているコードに適応するリビジョン認識のサイジング、マニフェストの外の専用カスタムリソースで管理される自動化設定、そしてcommitments・コスト帰属・マルチクラウド請求に対応するDoiT Cloud Intelligenceとの統合
- 両方を同時に稼働できる: Cast AIにノードのプロビジョニングを任せたまま、そのワークロードオートスケーラーを無効化し、同じクラスター上でPerfectScaleにワークロードのライトサイジングを任せることができます。比較のための移行は不要です
1. 新リリースでもベースラインを取り直さないオートスケーラー
Cast AIのWorkload Autoscalerは、3時間から7日まで設定可能でデフォルトは24時間のルックバックウィンドウからワークロードのサイズを算出し、「設定されたルックバック期間内で収集されたメトリクスデータポイント数と期待されるデータポイント数の比率」を測る信頼度スコアによって制御されます。
その推奨値が実際に何によって更新されるのかを見てみましょう。ドキュメントに挙げられているトリガーは、30分ごとの再生成サイクルと異常な使用状況、OOMイベント、メモリプレッシャーによるエビクション、使用量の急増、CPUストール、そして起動プローブの失敗です。
アプリケーションの新バージョンのリリースは、このリストに含まれていません。
実際の流れを追ってみましょう。14:00に、アプリケーションのメモリプロファイルを変える新リリースをデプロイしたとします。その時点で有効な推奨値は、旧バージョンが支配的だったウィンドウから計算されたものです。デフォルトのdeferredモードでは、「Cast AIのmutating admission webhookは、アプリケーションのデプロイ時など、Podが自然に再作成されるタイミングで推奨値を適用します」。つまり、あなたのデプロイこそが、昨日のサイジングを今日のコードに刻み込むイベントなのです。
Cast AIのセーフティネットは実在しますが、そのすべてが事後対応型です。ストール検知はPSIがCPU競合を示した際に推奨値を引き上げますが、対象はCPUのみで、Kubernetes 1.34以上が必要です。OOMKillの発生後には、メモリオーバーヘッド調整が「20%または100Miのいずれか大きい方」を加算し、その後24時間かけて線形にゼロまで減衰させます。優れた復旧メカニズムではありますが、復旧が必要ということは、Podはすでに死んでいるということです。
PerfectScaleは、同じ瞬間に反対側からアプローチします。リビジョン認識により、推奨値は古いリビジョンとの混合ではなく、実際に稼働中のリビジョンに絞り込まれます。そして、あなた自身がリソースを変更した場合、自動化はあなたの判断を優先します。「PerfectScaleは開発上の変更に逆らうことはなく、自動化が有効な状態であっても、現在の推奨値ではなくユーザーによる具体的な変更を即座に受け入れます。システムがリソースを増減させるのは、その変更が使用パターンとどう比較されるかを明確に把握した後だけです。」
違いを一行で言えばこうなります。デプロイの瞬間、一方のシステムは変更前に学習した内容を適用する。もう一方は、あなたの変更を学習し終えるまで身を引く。
段階的なロールアウトについては、PerfectScaleがArgo Rolloutsの戦略を自動的に検出します。ブルーグリーン、カナリア、A/Bのいずれも、タグ付けや手動設定は不要です。動作は選択可能で、デフォルトのpauseは複数のReplicaSetが並行して存在する間は何も適用せず、aggregateはそれら全体の使用率をマージして1つの推奨値を適用します。
重要なのはグラフが綺麗になることではありません。自動化がオンのまま維持されることです。一度痛い目を見たチームは、最大規模のサービスをひっそりと対象から外し、削減効果もそれとともに失われていきます。
SLOを損なわずにKubernetesコストを削減する方法を見る →
2. 最適化の設定はアプリケーションマニフェストに置くべきではない
よくある問いから一歩踏み込んでみましょう。「データはどこにあるか」ではなく、「その設定は誰が所有し、どのファイルに書かれているのか」です。
Cast AIでは、ワークロード単位の設定はワークロードコントローラーへのアノテーションであり、代替手段がないことをドキュメントが明言しています。「アノテーションは、個々のワークロードの垂直スケーリング設定をオーバーライドする唯一の方法です。Cast AIコンソールはワークロード単位の設定オーバーライドをサポートしていません。」設定リファレンスにも同じ記述があります。「コンソールから個々のワークロードの最適化のオン/オフを切り替えることは可能ですが、それ以外のワークロードレベルのオーバーライドはすべてアノテーションで設定する必要があります。」
つまり、最適化ポリシーはアプリケーションマニフェスト全体に散らばり、プロダクトチームが編集するのと同じYAMLの中に存在し、最終的にそれを背負うのはアプリのオーナーたちです。Cast AIは、これが生むドリフトについても文書化しています。「これらの最適化はライブクラスターの状態にのみ存在します。Gitからワークロードを再デプロイすると、元のマニフェストの値が最適化された設定を上書きし、リソースは古い未最適化の値に戻ってしまいます。」
PerfectScaleは、最適化をアプリケーションマニフェストから完全に切り離しています。自動化の設定は独立したカスタムリソース群であるClusterAutomationConfig、NamespaceAutomationConfig、WorkloadAutomationConfigで管理され、ワークロード設定がネームスペース設定を、ネームスペース設定がクラスター設定を上書きします。1つのオブジェクトグラフをプラットフォームチームが所有し、専用のプルリクエストでレビューできます。
自動化はDeploymentのリソース仕様には触れません。Argo CD統合のドキュメントにはこうあります。「自動化は、親リソースの仕様(Deployment、StatefulSetなど)に影響を与えることなくPodレベルでリソースを変更するため、ArgoCDは変更を検出せず、元に戻そうとすることもありません。」Argo CDとFluxの両方がサポートされています。
そして、深夜2時に必要になる制御手段は、サポートチケットではなく、自分のクラスター内のリソースに対するkubectl操作です。stopAllAutomationはクラスター全体のすべてを停止し、「特定のネームスペースやワークロードに対する既存の自動化設定を上書きします」。cleanupAllAutomationはさらに踏み込み、「自動化を停止するだけでなく、自動化プロセスによって行われたすべての変更をロールバックし、元のリソース仕様と設定を復元します」。
クラスターが1つなら、これは好みの問題です。50クラスターともなれば、最適化を「所有する」プラットフォームチームか、「押し付けられる」チームかの分かれ目になります。
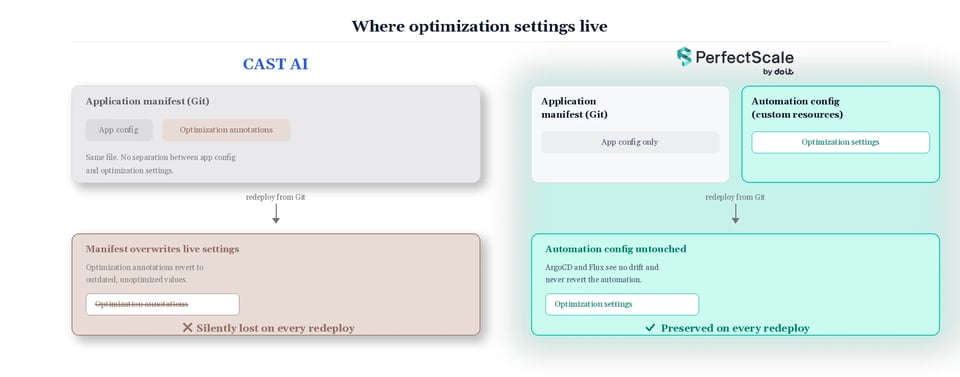 Cast AIは最適化設定をアプリケーションマニフェストに混在させるため、Gitからの再デプロイで気づかないうちに上書きされます。PerfectScaleは自動化設定を分離して保持するため、何度再デプロイしても影響を受けません。
3. 最適化はクラスターの境界で止まらない
3つ目の理由は、個別の機能ではなくスコープの問題です。
Cast AIもcommitmentsを追跡します。しかし提供されないのは、履歴と請求の実データです。同社のドキュメントにはこうあります。「現在、レポートは現時点の状況のスナップショットのみを提供し、過去のデータを確認する機能はありません。」使用率は「頻繁には更新されず」、ノードとクラスターの変更時に再計算されます。そして、その基盤となるコストモデルは、あなたの請求書ではなく定価です。コスト管理のページにはこうあります。「請求情報へのアクセスは不要です。CAST AIは公開価格を使用するため、請求の詳細を共有する必要はありません。」導入時には確かに便利ですが、後になると明確な限界になります。同社のドキュメントのどこにも、AWS Cost and Usage Reportの取り込みに関する記述は見つかりませんでした。
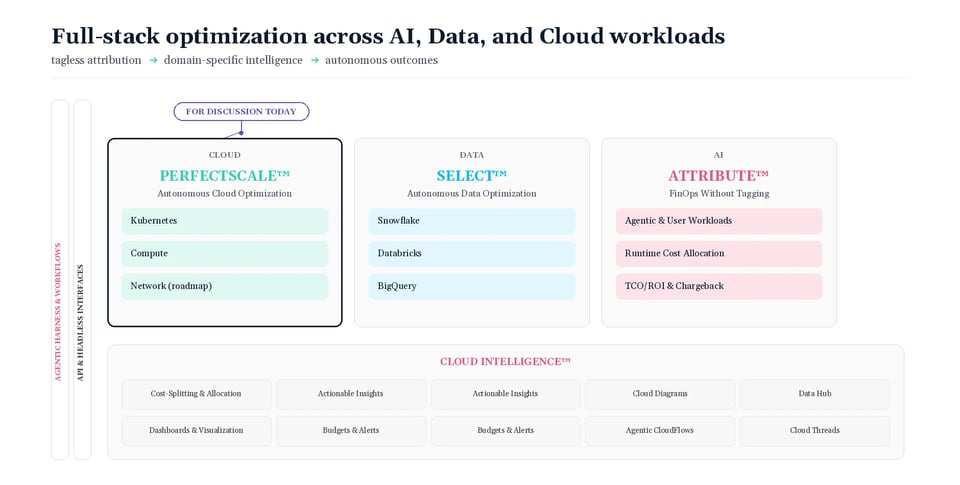
PerfectScaleはDoiTの一部であるため、クラスターの先から始まる業務も、同じ関係の中でカバーできます。
Commitments。PerfectScale for Commitmentsは、EC2、Fargate、Lambdaを横断するAWS Savings Plansに加え、Aurora、RDS、Aurora Serverless v2、Aurora DSQL、DynamoDB、ElastiCache for Valkey、DocumentDB、Neptune、Keyspaces、Timestream、DMS、OpenSearchを対象とするデータベースSavings Plansを、AWSの適用条件に従って継続的に最適化します。Google CloudのCUDへの対応もGAとなり、Compute Engine、Cloud SQL、BigQuery Editions、AlloyDB、Spanner、Firestore、Dataflow、Memorystore、Bigtable、Managed Service for Apache Kafkaをカバーします。コミットメントラダリングは、期日が重なり合う複数の小規模なプランを段階的に組むため、「使用量が減少しても、影響を受けるのはcommitmentsのごく一部だけです」。
コスト帰属。Attributeは、タグでは答えられない問い、つまり「この支出を生み出したのはどの顧客・どの機能か」に答えます。軽量なeBPFセンサーはHelm経由で約15分でデプロイでき、コードや設定の変更は不要です。マルチテナントクラスター、共有データベース、メッセージキューは、割り当てキーではなく、実際に観測されたランタイム消費量に基づいて按分されます。
そして請求書そのもの、さらには人。DoiT Cloud IntelligenceはAWS、Google Cloud、Azureにまたがるコストをカバーし、私たちの言葉を借りれば「請求書ではなくプラットフォームに付いてくる」Forward Deployed Engineersが伴走します。
何も取り外さずに検証できる
評価の進め方について率直にお伝えします。両プラットフォームは異なるレイヤーで動作するため、並行稼働が可能です。Cast AIにノードのプロビジョニングを任せたまま、変更の競合を避けるためにワークロードオートスケーラーを無効化し、同じクラスター上でPerfectScaleにワークロードのライトサイジングを任せます。移行なし、切り替えリスクなしで、スプレッドシートではなく本番ワークロード上での比較ができます。
とっておきの特典
現在Cast AIをご利用中のお客様には、直近3か月分のCast AI請求額の平均を半分にし、その金額を24か月間のPerfectScaleの固定月額料金といたします。
果たす役割は同じ。プラットフォームコストはおよそ半分。デプロイ時には邪魔をしない自動化、プラットフォームチームが所有できる場所にある設定、そしてクラスターの境界を超えても止まらないプラットフォームが手に入ります。
**現在Cast AIを運用中なら、違いを確認する最速の方法にコストは一切かかりません。**同じクラスター上でPerfectScaleを並行稼働させ(移行も入れ替えも不要)、ご自身の本番ワークロードで結果を比較してください。数字で確認できたら、Cast AIの平均月額支出を半額にし、24か月間その価格で固定します。
本オファーは現在Cast AIをご利用中のお客様が対象です。条件はミーティングにてご確認いただきます。
よくある質問
なぜCast AIのオートスケーラーは新しいアプリケーションリリースに適応しないのですか?
Cast AIのWorkload Autoscalerは、収集したメトリクスのルックバックウィンドウ(デフォルトは通常24時間)からサイジングの推奨値を算出します。同社のドキュメントによれば、推奨値の更新をトリガーするのは、30分ごとの再生成サイクル、OOMイベント、メモリプレッシャーによるエビクション、使用量の急増、CPUストール、起動プローブの失敗です。
新しいアプリケーションのデプロイはこのリストに含まれていません。そのため、アプリのメモリやCPUのプロファイルを変えるリリースを出しても、その時点で有効な推奨値は旧バージョンの挙動から作られたものです。Cast AIのデフォルトであるdeferredモードでは、その古い推奨値が、まさにデプロイ中にPodが再作成された瞬間に適用されます。
ストール検知やOOMKill後のメモリオーバーヘッド調整といったセーフティネットは、問題が発生した後にしか反応せず、事前には機能しません。
PerfectScaleはデプロイ時のサイジングをどのように扱うのですか?
PerfectScaleはリビジョン認識を採用しており、リソースの推奨値を、新旧バージョンのデータを混ぜ合わせるのではなく、実際に稼働している特定のリビジョンに絞り込みます。ユーザーが手動でリソースを変更した場合、PerfectScaleの自動化はそれを上書きせず即座に受け入れ、その変更が実際の使用パターンとどう比較されるかを観測してから、再び調整を行います。
段階的なロールアウト戦略を使うチーム向けには、PerfectScaleがArgo Rolloutsの戦略(ブルーグリーン、カナリア、A/B)を手動タグ付けなしで自動検出し、ロールアウト中は推奨値を一時停止するか、並行するReplicaSet全体の使用率を集約するかを選択できます。
Cast AIはワークロード単位の最適化設定をどこに保存し、なぜそれが問題なのですか?
Cast AIでは、ワークロード単位の設定オーバーライドを、プロダクトチームが編集するのと同じアプリケーションマニフェスト内で、ワークロードコントローラーへのアノテーションとして直接設定する必要があります。Cast AI自身のドキュメントが、代替手段がないことを明言しています。アノテーションは、個々のワークロードの垂直スケーリング設定をオーバーライドする唯一の方法です。
これは現実的な運用上の問題を生みます。これらの最適化はライブクラスターの状態にしか存在しないため、Gitからワークロードを再デプロイすると、マニフェストが元の未最適化の値で上書きされ、適用されていた調整が気づかないうちに元に戻ってしまいます。
PerfectScaleはこれを回避するため、自動化の設定を独立したカスタムリソース群(ClusterAutomationConfig、NamespaceAutomationConfig、WorkloadAutomationConfig)として、アプリケーションマニフェストとは完全に分離して保持します。これにより、プラットフォームチームが最適化設定を独立して所有・レビューでき、Argo CDやFluxを通じたGitOpsの再デプロイが、PerfectScaleによるPodレベルの調整を検出したり元に戻したりすることはありません。
「最適化はクラスターの境界で止まらない」とはどういう意味ですか?
Kubernetesクラスターそのものの先に目を向けたときの、両プラットフォームのスコープの違いを指しています。Cast AIのコストレポートは現在の状況のスナップショットしか提供せず、過去のコストデータを確認する機能はなく、使用率の数値も頻繁には更新されません。また、Cast AIは請求情報へのアクセスを必要としないため、コストモデルは実際のクラウド請求額ではなく公開定価に基づいています。
PerfectScaleはDoiTの一部であり、最適化をクラスターの外まで拡張します。幅広いサービスを対象とするAWS Savings PlansとGoogle Cloud確約利用割引(CUD)の継続的な管理、eBPFセンサーを使った顧客・機能レベルまでのコスト帰属、そしてDoiT Cloud Intelligenceを通じたAWS、Google Cloud、Azureにまたがる統合的な請求の可視化が含まれます。
まずCast AIから移行しなくてもPerfectScaleを試せますか?
はい。両プラットフォームは異なるレイヤーで動作するため、同じクラスター上で並行稼働できます。Cast AIにノードのプロビジョニングを任せたまま、変更の競合を避けるためにワークロードオートスケーラーを無効化し、PerfectScaleにワークロードのライトサイジングを引き継がせてください。
これにより、スプレッドシートの見積もりに頼るのではなく、本番ワークロード上で両プラットフォームを直接比較でき、評価そのものに移行や切り替えのリスクは一切伴いません。
PerfectScaleに乗り換えるCast AIの既存顧客向けのオファーとはどのようなものですか?
PerfectScaleは、直近3か月分のCast AIの月次請求額の平均を半分にし、その金額を24か月間のPerfectScaleの固定月額料金として確定します。本オファーは現在Cast AIをご利用中のお客様が対象で、条件はミーティングにてご確認いただきます。