
Ogni affermazione su Cast AI riportata qui sotto rimanda alla loro documentazione pubblica, verificata il 2 settembre 2026. Entrambi i prodotti rilasciano aggiornamenti di frequente: seguite i link anziché crederci sulla parola.
TL;DR
Cast AI e PerfectScale ottimizzano entrambi i workloads Kubernetes, ma si differenziano in tre aspetti che contano davvero quando si gestiscono cluster di produzione su larga scala.
Ecco cosa c'è da sapere:
- I deploy compromettono il dimensionamento di Cast AI: il loro autoscaler non ricalcola la baseline quando rilasciate una nuova versione. Le raccomandazioni costruite sulla versione precedente vengono applicate al nuovo codice, e le loro reti di sicurezza reagiscono solo dopo che qualcosa è già andato storto (un OOMKill, uno stallo della CPU)
- La configurazione vive nel posto sbagliato: Cast AI richiede gli override per workload sotto forma di annotation direttamente nei manifest applicativi. Le impostazioni di ottimizzazione finiscono così nello stesso YAML modificato dai vostri team di prodotto, e un redeploy da Git può cancellarle in silenzio
- Cast AI si ferma al confine del cluster: nessun report storico dei costi, nessuna ingestion dell'AWS Cost and Usage Report e prezzi basati sul listino pubblico anziché sulla vostra fattura reale
- PerfectScale risolve tutti e tre i problemi: dimensionamento revision-aware che si adatta al codice effettivamente in esecuzione, configurazione dell'automazione in custom resource dedicate fuori dai vostri manifest e integrazione con DoiT Cloud Intelligence per commitments, attribuzione dei costi e billing multi-cloud
- Potete eseguirli entrambi contemporaneamente: lasciate a Cast AI il provisioning dei nodi, disattivate il suo workload autoscaler e affidate a PerfectScale il right-sizing dei workloads sugli stessi cluster - nessuna migrazione necessaria per fare il confronto
1. Il loro autoscaler non ricalcola la baseline alle nuove release
Il Workload Autoscaler di Cast AI dimensiona i workloads a partire da una finestra di osservazione retrospettiva, configurabile da 3 ore a 7 giorni e con default di 24 ore, regolata da un punteggio di confidenza che misura "il rapporto tra i data point delle metriche raccolti e il numero atteso di data point nella finestra di look-back configurata".
Guardate cosa fa effettivamente cambiare quella raccomandazione. La loro documentazione elenca i trigger: un ciclo di rigenerazione di 30 minuti e utilizzi anomali, eventi OOM, eviction per pressione sulla memoria, picchi di utilizzo, stallo della CPU e fallimenti delle startup probe.
Il rilascio di una nuova versione della vostra applicazione non compare in quell'elenco.
Vediamo la sequenza. Alle 14:00 effettuate il deploy di una release che modifica il profilo di memoria di un'applicazione. La raccomandazione in corso era stata calcolata su una finestra dominata dalla versione precedente. Nella loro modalità deferred predefinita, "il mutating admission webhook di Cast AI applica la raccomandazione quando i pod vengono ricreati naturalmente, ad esempio durante i deployment delle applicazioni". Il vostro deploy è l'evento che imprime il dimensionamento di ieri sul codice di oggi.
Le loro reti di sicurezza esistono davvero, e sono tutte reattive. La stall detection alza la raccomandazione quando il PSI segnala contesa sulla CPU, ma copre solo la CPU e richiede Kubernetes 1.34 o superiore. Dopo un OOMKill, il memory overhead adjustment aggiunge "il 20% oppure 100Mi, a seconda di quale sia il valore maggiore", per poi ridurlo linearmente fino a zero nell'arco di 24 ore. È un buon meccanismo di recupero. Ma recupero significa che il pod è già morto.
PerfectScale affronta lo stesso momento dal lato opposto. La revision awareness circoscrive le raccomandazioni alla revisione effettivamente in esecuzione invece di mescolare i dati di quelle vecchie, e quando modificate le risorse in autonomia, l'automazione vi lascia la precedenza: "PerfectScale non contraddice le vostre modifiche di sviluppo e, anche con l'automazione attiva, accetta immediatamente le modifiche specifiche dell'utente al posto delle raccomandazioni correnti. Il sistema aumenterà o ridurrà le risorse secondo necessità solo dopo aver compreso chiaramente come le modifiche si confrontano con i pattern di utilizzo."
Questa è la differenza in una riga. Al momento del deploy, un sistema applica ciò che ha imparato prima della vostra modifica. L'altro si fa da parte finché non ha imparato la vostra modifica.
Per i rollout graduali, PerfectScale rileva automaticamente la vostra strategia Argo Rollouts, blue-green, canary o A/B, senza tagging né configurazione manuale. Scegliete voi il comportamento: pause, il default, non applica nulla finché esistono ReplicaSet concorrenti; aggregate unisce l'utilizzo tra di essi e applica un'unica raccomandazione.
Il punto non è avere un grafico più pulito. È che l'automazione resta accesa. I team che si scottano una volta escludono in silenzio i loro servizi più grandi, e i risparmi se ne vanno con loro.
Scoprite come ridurre i costi di Kubernetes senza compromettere i vostri SLO →
2. La configurazione dell'ottimizzazione non deve vivere nei manifest applicativi
Ponetevi una domanda più mirata del solito: non dove sono i miei dati, ma di chi è la configurazione e in quale file si trova.
In Cast AI, le impostazioni per workload sono annotation sul controller del workload, e la loro documentazione è esplicita nel dire che non esistono alternative: "Le annotation sono l'unico modo per fare l'override delle impostazioni di vertical scaling per i singoli workloads. La console di Cast AI non supporta override delle impostazioni per singolo workload." Il riferimento delle impostazioni dice la stessa cosa: "Potete comunque attivare o disattivare l'ottimizzazione per i singoli workloads dalla console, ma tutti gli altri override a livello di workload devono essere configurati tramite annotation."
Questo significa che la policy di ottimizzazione è disseminata nei vostri manifest applicativi, nello stesso YAML modificato dai team di prodotto, e a farsene carico finiscono per essere i proprietari delle applicazioni. Cast AI documenta anche il drift che ne deriva: "queste ottimizzazioni esistono solo nello stato live del cluster. Quando fate il redeploy di un workload da Git, i valori originali del manifest sovrascrivono le impostazioni ottimizzate, riportando le risorse a valori obsoleti e non ottimizzati."
PerfectScale tiene l'ottimizzazione completamente fuori dai vostri manifest applicativi. La configurazione dell'automazione è un insieme dedicato di custom resource, ClusterAutomationConfig, NamespaceAutomationConfig e WorkloadAutomationConfig, con le impostazioni di workload che prevalgono sul namespace e quelle di namespace che prevalgono sul cluster. Un unico grafo di oggetti, di proprietà del team di piattaforma, revisionato nella sua pull request dedicata.
L'automazione non tocca la spec delle risorse dei vostri Deployment. Dalla documentazione dell'integrazione con Argo CD: "L'automazione modifica le risorse a livello di pod senza toccare la spec delle risorse dei parent (Deployment, StatefulSet, ecc.), quindi ArgoCD non rileva alcuna modifica e non tenterà di annullarla." Sono supportati sia Argo CD che Flux.
E i controlli che vi interessano alle 2 di notte sono operazioni kubectl su una risorsa nel vostro cluster, non un ticket di supporto. stopAllAutomation ferma tutto a livello di cluster, "sovrascrivendo qualsiasi impostazione di automazione esistente per namespace o workloads specifici". cleanupAllAutomation va oltre e "non solo fermerà l'automazione, ma annullerà anche tutte le modifiche apportate dai processi di automazione, ripristinando le specifiche e le impostazioni originali delle risorse".
Con un solo cluster è una questione di preferenze. Con cinquanta è la differenza tra un team di piattaforma che ha la ownership dell'ottimizzazione e uno che la eredita.
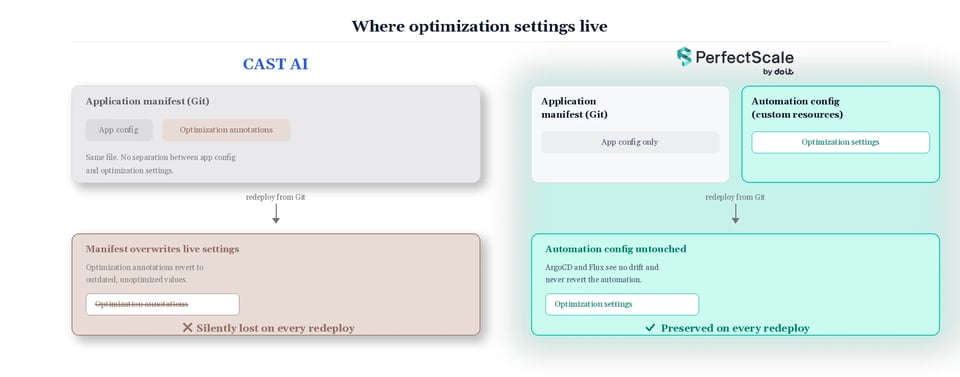 Cast AI mescola le impostazioni di ottimizzazione nei vostri manifest applicativi, quindi un redeploy da Git le sovrascrive in silenzio. PerfectScale tiene la configurazione dell'automazione separata, così sopravvive intatta a ogni redeploy.
3. L'ottimizzazione non si ferma al confine del cluster
Il terzo motivo riguarda l'ambito, non una singola funzionalità.
Cast AI traccia effettivamente i commitments. Quello che non fa è darvi lo storico o i dati reali del billing. Dalla loro stessa documentazione: "Attualmente il reporting fornisce solo un'istantanea della situazione presente, senza la possibilità di consultare i dati storici." L'utilizzo "non viene aggiornato di frequente" e viene ricalcolato quando cambiano nodi e cluster. E il modello di costo sottostante è il prezzo di listino, non la vostra fattura. Dalla loro pagina sul cost management: "Accesso al billing non richiesto. CAST AI usa i prezzi pubblici, quindi non dovete condividere i dettagli di fatturazione." È una comodità autentica in fase di onboarding e un limite concreto in seguito. Non abbiamo trovato alcuna ingestion dell'AWS Cost and Usage Report in nessun punto della loro documentazione.
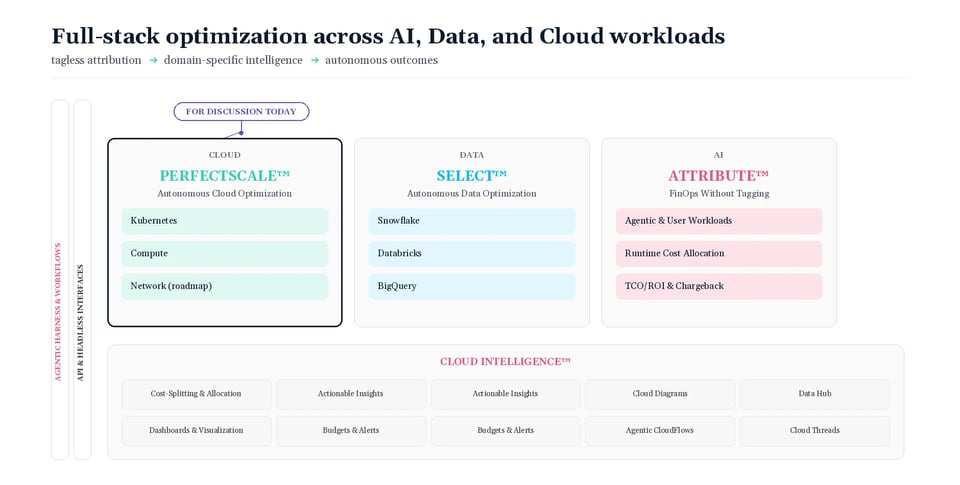
PerfectScale fa parte di DoiT, quindi lo stesso rapporto copre il lavoro che inizia dove finisce il cluster.
Commitments. PerfectScale for Commitments ottimizza in modo continuo gli AWS Savings Plans su EC2, Fargate e Lambda, oltre ai Savings Plans per database su Aurora e RDS, Aurora Serverless v2, Aurora DSQL, DynamoDB, ElastiCache for Valkey, DocumentDB, Neptune, Keyspaces, Timestream, DMS e OpenSearch, secondo le regole di idoneità di AWS. Anche il supporto per le CUD di Google Cloud è ora in GA e copre Compute Engine, Cloud SQL, BigQuery Editions, AlloyDB, Spanner, Firestore, Dataflow, Memorystore, Bigtable e Managed Service for Apache Kafka. Il commitment laddering scagliona più piani di dimensioni ridotte con date sovrapposte, così "se l'utilizzo cala, ne risente solo una piccola frazione dei vostri commitments".
Attribuzione. Attribute risponde alla domanda a cui i tag non possono rispondere: quale cliente o funzionalità ha generato questa spesa. Un sensore eBPF leggero si installa via Helm in circa 15 minuti senza modifiche al codice o alla configurazione, e cluster multi-tenant, database condivisi e code di messaggi vengono ripartiti in base al consumo runtime osservato anziché a chiavi di allocazione.
La fattura in sé, e le persone. DoiT Cloud Intelligence copre i costi su AWS, Google Cloud e Azure, con Forward Deployed Engineers che, come diciamo noi, arrivano con la piattaforma e non con la fattura.
Non dovete smantellare nulla per scoprirlo
Vale la pena essere chiari sul percorso di valutazione. Le due piattaforme operano a livelli diversi, quindi potete eseguirle fianco a fianco: lasciate a Cast AI il provisioning dei nodi, disattivate il suo workload autoscaler per evitare modifiche in conflitto e affidate a PerfectScale il right-sizing dei workloads sugli stessi cluster. Nessuna migrazione, nessun rischio di passaggio e un confronto sui vostri workloads di produzione anziché su un foglio di calcolo.
La ciliegina sulla torta
Se oggi siete clienti Cast AI, prenderemo la media delle vostre ultime tre fatture mensili di Cast AI, la dimezzeremo e ne faremo il vostro prezzo mensile fisso di PerfectScale per 24 mesi.
Stesso lavoro di fondo. Circa la metà del costo della piattaforma. Un'automazione che si fa da parte quando fate deploy, una configurazione che vive dove il vostro team di piattaforma può averne la ownership e una piattaforma che continua oltre il confine del cluster.
Se oggi usate Cast AI, il modo più rapido per vedere la differenza non costa nulla. Eseguite PerfectScale in parallelo sugli stessi cluster, senza migrazione né rip and replace, e confrontate i risultati sui vostri workloads di produzione. Se i numeri reggono, dimezzeremo la vostra spesa mensile media per Cast AI e la bloccheremo per 24 mesi.
Prenotate una call e portate le vostre ultime tre fatture
Offerta riservata agli attuali clienti Cast AI. Termini confermati durante la call.
Domande frequenti
Perché l'autoscaler di Cast AI non si adatta alle nuove release delle applicazioni?
Il Workload Autoscaler di Cast AI costruisce le sue raccomandazioni di dimensionamento a partire da una finestra retrospettiva di metriche raccolte, con default tipico di 24 ore. Secondo la loro stessa documentazione, i trigger che causano l'aggiornamento di una raccomandazione includono un ciclo di rigenerazione di 30 minuti, eventi OOM, eviction per pressione sulla memoria, picchi di utilizzo, stalli della CPU e fallimenti delle startup probe.
Il deployment di una nuova applicazione non compare in quell'elenco. Quindi, quando rilasciate una release che modifica il profilo di memoria o CPU della vostra app, la raccomandazione ancora in corso era stata costruita sul comportamento della versione precedente. Nella modalità deferred predefinita di Cast AI, quella raccomandazione obsoleta viene applicata nel momento in cui i pod vengono ricreati durante il deploy stesso.
Le loro reti di sicurezza, come la stall detection e il memory overhead adjustment post-OOMKill, intervengono solo dopo che un problema si è già verificato, non prima.
In che modo PerfectScale gestisce diversamente il dimensionamento durante i deployment?
PerfectScale utilizza la revision awareness, che circoscrive le raccomandazioni sulle risorse alla specifica revisione effettivamente in esecuzione, invece di mescolare i dati tra versioni vecchie e nuove. Quando effettuate modifiche manuali alle risorse, l'automazione di PerfectScale dà immediatamente la precedenza alle vostre modifiche invece di sovrascriverle, e interviene di nuovo solo dopo aver osservato come la vostra modifica si confronta con i pattern di utilizzo reali.
Per i team che usano strategie di rollout graduale, PerfectScale rileva automaticamente le strategie Argo Rollouts (blue-green, canary o A/B) senza alcun tagging manuale, e vi permette di scegliere se mettere in pausa le raccomandazioni durante un rollout o aggregare l'utilizzo tra ReplicaSet concorrenti.
Dove salva Cast AI le impostazioni di ottimizzazione per workload, e perché è importante?
Cast AI richiede che gli override di configurazione per workload siano impostati come annotation direttamente sui controller dei workloads, all'interno degli stessi manifest applicativi modificati dai vostri team di prodotto. La documentazione di Cast AI conferma che non esistono alternative: le annotation sono l'unico modo per fare l'override delle impostazioni di vertical scaling per i singoli workloads.
Questo crea un problema operativo concreto. Poiché queste ottimizzazioni esistono solo nello stato live del cluster, il redeploy di un workload da Git sovrascrive il manifest con i valori originali non ottimizzati, annullando in silenzio qualsiasi tuning applicato.
PerfectScale evita tutto questo mantenendo la configurazione dell'automazione in un insieme dedicato di custom resource (ClusterAutomationConfig, NamespaceAutomationConfig e WorkloadAutomationConfig), completamente separato dai manifest applicativi. Il team di piattaforma gestisce e revisiona così le impostazioni di ottimizzazione in autonomia, e un redeploy GitOps tramite Argo CD o Flux non rileverà né annullerà le modifiche a livello di pod effettuate da PerfectScale.
Cosa significa che "l'ottimizzazione non si ferma al confine del cluster"?
Si riferisce alla differenza di ambito tra le due piattaforme quando si guarda oltre il cluster Kubernetes in sé. Il reporting dei costi di Cast AI fornisce solo un'istantanea della situazione attuale, senza la possibilità di consultare i dati storici di costo, e le cifre di utilizzo non vengono aggiornate di frequente. Il suo modello di costo, inoltre, si basa sul listino pubblico anziché sulla vostra fattura cloud reale, dato che Cast AI non richiede l'accesso al billing.
PerfectScale fa parte di DoiT, che estende l'ottimizzazione oltre il cluster con la gestione continua degli AWS Savings Plans e delle Committed Use Discounts di Google Cloud su un'ampia gamma di servizi, l'attribuzione dei costi fino al livello di cliente o funzionalità tramite un sensore eBPF e una visibilità unificata del billing su AWS, Google Cloud e Azure attraverso DoiT Cloud Intelligence.
Posso provare PerfectScale senza prima abbandonare Cast AI?
Sì. Poiché le due piattaforme operano a livelli diversi, potete eseguirle fianco a fianco sugli stessi cluster. Lasciate a Cast AI la gestione del provisioning dei nodi, disattivate il suo workload autoscaler per evitare modifiche in conflitto e affidate a PerfectScale il right-sizing dei workloads.
Potete così confrontare le due piattaforme direttamente sui vostri workloads di produzione anziché affidarvi a una stima su foglio di calcolo, senza alcuna migrazione né rischio di passaggio nella valutazione stessa.
Qual è l'offerta per gli attuali clienti Cast AI che passano a PerfectScale?
PerfectScale prenderà la media delle vostre ultime tre fatture mensili di Cast AI, la dimezzerà e la bloccherà come vostro prezzo mensile fisso di PerfectScale per 24 mesi. L'offerta è riservata agli attuali clienti Cast AI, con termini confermati durante una call.