
Chaque affirmation concernant Cast AI ci-dessous renvoie à leur propre documentation publique, vérifiée le 2 septembre 2026. Les deux produits évoluent rapidement : suivez les liens plutôt que de nous croire sur parole.
TL;DR
Cast AI et PerfectScale optimisent tous deux les workloads Kubernetes, mais ils diffèrent sur trois points qui comptent dès que vous exploitez des clusters de production à grande échelle.
Voici l'essentiel à retenir :
- Les déploiements cassent le dimensionnement de Cast AI : leur autoscaler ne recalcule pas sa base de référence lorsque vous publiez une nouvelle version. Les recommandations issues de l'ancienne version sont appliquées à votre nouveau code, et leurs garde-fous ne réagissent qu'après un incident (un OOMKill, un blocage CPU)
- La configuration est stockée au mauvais endroit : Cast AI impose de définir les overrides par workload sous forme d'annotations directement dans vos manifestes applicatifs. Les paramètres d'optimisation cohabitent donc avec le YAML que vos équipes produit modifient, et un redéploiement depuis Git peut les effacer silencieusement
- Cast AI s'arrête aux limites du cluster : pas d'historique des coûts, pas d'ingestion des AWS Cost and Usage Reports, et une tarification basée sur les prix catalogue publics plutôt que sur votre facture réelle
- PerfectScale corrige ces trois points : un dimensionnement qui tient compte des révisions et s'adapte au code réellement exécuté, une configuration d'automatisation conservée dans ses propres ressources personnalisées, hors de vos manifestes, et une intégration avec DoiT Cloud Intelligence™ pour les commitments, l'attribution des coûts et la facturation multi-cloud
- Vous pouvez exécuter les deux en parallèle : laissez Cast AI provisionner les nœuds, désactivez son autoscaler de workloads et confiez le right-sizing des workloads à PerfectScale sur les mêmes clusters - aucune migration nécessaire pour comparer
1. Leur autoscaler ne se recalibre pas lors des nouvelles versions
Le Workload Autoscaler de Cast AI dimensionne les workloads à partir d'une fenêtre d'observation, configurable de 3 heures à 7 jours, avec 24 heures par défaut, conditionnée par un score de confiance qui mesure "le ratio entre les points de données métriques collectés et le nombre attendu de points de données sur la période d'observation configurée".
Regardez ce qui déclenche réellement une mise à jour de cette recommandation. Leur documentation liste les déclencheurs : un cycle de régénération de 30 minutes et une utilisation anormale, les événements OOM, les évictions pour pression mémoire, les pics d'utilisation, les blocages CPU et les échecs de startup probe.
La mise en production d'une nouvelle version de votre application ne figure pas dans cette liste.
Déroulez la séquence. À 14h00, vous déployez une release qui modifie le profil mémoire d'une application. La recommandation en cours a été calculée sur une fenêtre dominée par la version précédente. Dans leur mode différé par défaut, "le mutating admission webhook de Cast AI applique la recommandation lorsque les pods sont naturellement recréés, par exemple lors des déploiements applicatifs". Votre déploiement est précisément l'événement qui applique le dimensionnement d'hier à votre code d'aujourd'hui.
Leurs garde-fous existent bel et bien, mais ils sont tous réactifs. La détection de blocage relève la recommandation lorsque le PSI révèle une contention CPU, mais elle ne concerne que le CPU et exige Kubernetes 1.34 ou supérieur. Après un OOMKill, l'ajustement de la marge mémoire ajoute "20 % ou 100 Mi, la valeur la plus élevée des deux", puis la réduit linéairement jusqu'à zéro sur 24 heures. C'est un bon mécanisme de récupération. Mais récupération signifie que le pod est déjà mort.
PerfectScale aborde le même moment par l'autre bout. La prise en compte des révisions limite les recommandations à la révision réellement en cours d'exécution au lieu de mélanger les données des anciennes, et lorsque vous modifiez vous-même les ressources, l'automatisation s'efface devant vous : "PerfectScale ne contredit pas vos changements de développement : même avec l'automatisation activée, PerfectScale accepte immédiatement les modifications de l'utilisateur plutôt que les recommandations en cours. Le système n'augmentera ou ne réduira les ressources que lorsque nous aurons une compréhension claire de la manière dont ces changements se comparent aux schémas d'utilisation."
Toute la différence tient en une phrase. Au moment du déploiement, un système applique ce qu'il a appris avant votre changement. L'autre s'efface jusqu'à ce qu'il ait appris votre changement.
Pour les déploiements progressifs, PerfectScale détecte automatiquement votre stratégie Argo Rollouts, blue-green, canary ou A/B, sans tagging ni configuration manuelle. Vous choisissez le comportement : pause, l'option par défaut, n'applique rien tant que des ReplicaSets concurrents existent ; aggregate fusionne leur utilisation et applique une recommandation unique.
L'enjeu n'est pas d'obtenir un graphique plus propre, mais de garder l'automatisation activée. Les équipes échaudées une fois excluent discrètement leurs plus gros services, et les économies s'envolent avec eux.
Découvrez comment réduire vos coûts Kubernetes sans compromettre vos SLO →
2. Votre configuration d'optimisation n'a rien à faire dans vos manifestes applicatifs
Posez une question plus précise que la question habituelle : non pas où sont mes données, mais qui possède la configuration et dans quel fichier elle se trouve.
Chez Cast AI, les paramètres par workload sont des annotations sur le contrôleur de workload, et leur documentation est explicite sur l'absence d'alternative : "Les annotations sont le seul moyen de surcharger les paramètres de scaling vertical pour des workloads individuels. La console Cast AI ne prend pas en charge les overrides par workload." La référence des paramètres dit la même chose : "Vous pouvez toujours activer ou désactiver l'optimisation pour des workloads individuels via la console, mais tous les autres overrides au niveau workload doivent être configurés par annotations."
Résultat : la politique d'optimisation est disséminée dans vos manifestes applicatifs, dans le même YAML que vos équipes produit modifient, et ce sont les propriétaires des applications qui finissent par la porter. Cast AI documente d'ailleurs la dérive que cela crée : "ces optimisations n'existent que dans l'état du cluster en cours d'exécution. Lorsque vous redéployez un workload depuis Git, les valeurs du manifeste d'origine écrasent les paramètres optimisés, ramenant vos ressources à des valeurs obsolètes et non optimisées."
PerfectScale garde l'optimisation entièrement hors de vos manifestes applicatifs. La configuration d'automatisation constitue son propre ensemble de ressources personnalisées, ClusterAutomationConfig, NamespaceAutomationConfig et WorkloadAutomationConfig, où les paramètres du workload priment sur ceux du namespace, et ceux du namespace sur ceux du cluster. Un seul graphe d'objets, sous la responsabilité de l'équipe plateforme, revu dans sa propre pull request.
L'automatisation ne touche pas à la spec resources de vos Deployments. Extrait de la documentation d'intégration Argo CD : "L'automatisation modifie les ressources au niveau du pod sans affecter la spec des ressources parentes (Deployment, StatefulSet, etc.) ; ArgoCD ne détecte donc aucun changement et ne tentera pas de les annuler." Argo CD et Flux sont tous deux pris en charge.
Et les commandes qui comptent à 2 heures du matin sont des opérations kubectl sur une ressource de votre propre cluster, pas un ticket de support. stopAllAutomation arrête tout à l'échelle du cluster, "en outrepassant tout paramètre d'automatisation existant pour des namespaces ou workloads spécifiques". cleanupAllAutomation va plus loin et "ne se contente pas d'arrêter l'automatisation : il annule aussi toutes les modifications effectuées par les processus d'automatisation, en restaurant les spécifications et paramètres d'origine des ressources".
Avec un seul cluster, c'est une question de préférence. Avec cinquante, c'est la différence entre une équipe plateforme qui pilote l'optimisation et une équipe qui la subit.
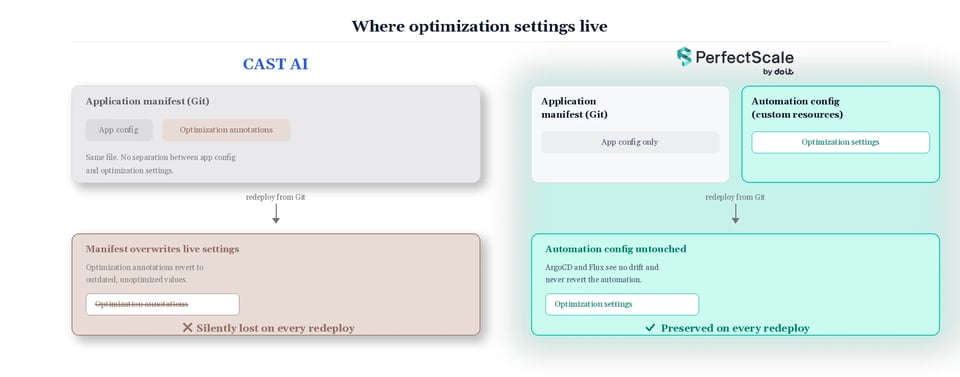 Cast AI mélange les paramètres d'optimisation à vos manifestes applicatifs : un redéploiement depuis Git les écrase silencieusement. PerfectScale garde la configuration d'automatisation à part : elle survit intacte à chaque redéploiement.
3. L'optimisation ne s'arrête pas aux limites du cluster
La troisième raison tient au périmètre plutôt qu'à une fonctionnalité en particulier.
Cast AI suit bien les commitments. Ce qu'il ne fournit pas, c'est l'historique et la réalité de votre facturation. Leur propre documentation : "À l'heure actuelle, le reporting ne fournit qu'un instantané de la situation présente, sans possibilité de consulter les données historiques." L'utilisation n'est "pas mise à jour fréquemment" : elle est recalculée lors des changements de nœuds et de clusters. Et le modèle de coûts sous-jacent repose sur les prix catalogue, pas sur votre facture. Extrait de leur page de gestion des coûts : "Aucun accès à la facturation requis. CAST AI utilise les tarifs publics, vous n'avez donc pas à partager vos données de facturation." C'est un vrai confort lors de l'onboarding, et un vrai plafond par la suite. Nous n'avons trouvé aucune trace d'ingestion des AWS Cost and Usage Reports dans leur documentation.
PerfectScale fait partie de DoiT : la même relation couvre donc le travail qui commence là où le cluster s'arrête.
Les commitments. PerfectScale for Commitments optimise en continu les AWS Savings Plans pour EC2, Fargate et Lambda, ainsi que les Savings Plans base de données pour Aurora et RDS, Aurora Serverless v2, Aurora DSQL, DynamoDB, ElastiCache for Valkey, DocumentDB, Neptune, Keyspaces, Timestream, DMS et OpenSearch, dans le respect des règles d'éligibilité AWS. La prise en charge des CUD Google Cloud est désormais en disponibilité générale, couvrant Compute Engine, Cloud SQL, BigQuery Editions, AlloyDB, Spanner, Firestore, Dataflow, Memorystore, Bigtable et Managed Service for Apache Kafka. Le commitment laddering échelonne plusieurs plans plus petits aux dates qui se chevauchent : "si l'utilisation baisse, seule une petite fraction de vos commitments est impactée".
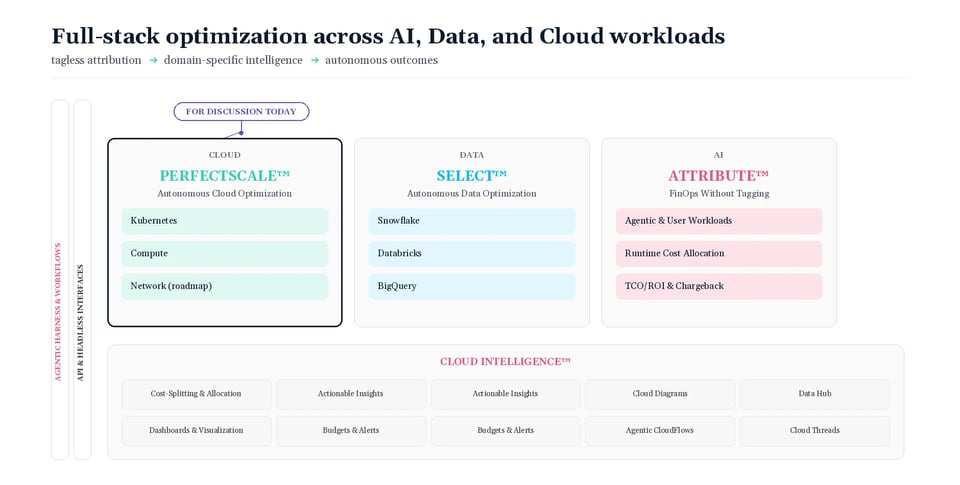
L'attribution. Attribute répond à la question que les tags ne peuvent pas résoudre : quel client ou quelle fonctionnalité a généré cette dépense. Un capteur eBPF léger se déploie via Helm en 15 minutes environ, sans modification de code ni de configuration, et les clusters multi-tenants, bases de données partagées et files de messages sont ventilés selon la consommation observée à l'exécution plutôt que par clés d'allocation.
La facture elle-même, et les personnes. DoiT Cloud Intelligence™ couvre les coûts sur AWS, Google Cloud et Azure, avec des Forward Deployed Engineers qui, comme nous aimons le dire, sont inclus avec la plateforme, pas sur la facture.
Inutile de tout démonter pour vous faire une idée
Soyons transparents sur le parcours d'évaluation. Les deux plateformes opèrent à des couches différentes, vous pouvez donc les exécuter côte à côte : laissez Cast AI provisionner les nœuds, désactivez son autoscaler de workloads pour éviter les changements contradictoires, et confiez le right-sizing des workloads à PerfectScale sur les mêmes clusters. Pas de migration, pas de risque de bascule, et une comparaison sur vos workloads de production plutôt que sur un tableur.
La cerise sur le gâteau
Si vous êtes client Cast AI aujourd'hui, nous prenons la moyenne de vos trois dernières factures mensuelles Cast AI, nous la divisons par deux, et ce montant devient votre prix mensuel fixe PerfectScale pendant 24 mois.
La même mission de fond. Un coût de plateforme réduit environ de moitié. Une automatisation qui s'efface quand vous déployez, une configuration qui vit là où votre équipe plateforme peut la maîtriser, et une plateforme qui continue au-delà du cluster.
Si vous utilisez Cast AI aujourd'hui, le moyen le plus rapide de constater la différence ne coûte rien. Exécutez PerfectScale en parallèle sur les mêmes clusters, sans migration ni remplacement, et comparez les résultats sur vos propres workloads de production. Si les chiffres tiennent la route, nous divisons par deux votre dépense mensuelle moyenne Cast AI et nous la gelons pendant 24 mois.
Réservez un appel et apportez vos trois dernières factures
Offre réservée aux clients Cast AI actuels. Conditions confirmées lors de l'appel.
Questions fréquentes
Pourquoi l'autoscaler de Cast AI ne s'adapte-t-il pas aux nouvelles versions applicatives ?
Le Workload Autoscaler de Cast AI construit ses recommandations de dimensionnement à partir d'une fenêtre d'observation des métriques collectées, généralement de 24 heures par défaut. Selon leur propre documentation, les déclencheurs d'une mise à jour de recommandation incluent un cycle de régénération de 30 minutes, les événements OOM, les évictions pour pression mémoire, les pics d'utilisation, les blocages CPU et les échecs de startup probe.
Un nouveau déploiement applicatif ne figure pas dans cette liste. Ainsi, lorsque vous publiez une version qui modifie le profil mémoire ou CPU de votre application, la recommandation encore en cours a été construite à partir du comportement de la version précédente. Dans le mode différé par défaut de Cast AI, cette recommandation obsolète est appliquée au moment même où vos pods sont recréés pendant le déploiement.
Leurs garde-fous, comme la détection de blocage ou l'ajustement de la marge mémoire après un OOMKill, ne réagissent qu'après l'apparition d'un problème, jamais avant.
Comment PerfectScale gère-t-il le dimensionnement différemment pendant les déploiements ?
PerfectScale s'appuie sur la prise en compte des révisions : les recommandations de ressources sont limitées à la révision réellement en cours d'exécution, plutôt que de mélanger les données des anciennes et des nouvelles versions. Lorsque vous modifiez manuellement les ressources, l'automatisation de PerfectScale s'aligne immédiatement sur vos changements au lieu de les écraser, et ne réajuste qu'après avoir observé comment votre changement se compare aux schémas d'utilisation réels.
Pour les équipes utilisant des stratégies de déploiement progressif, PerfectScale détecte automatiquement les stratégies Argo Rollouts (blue-green, canary ou A/B) sans tagging manuel, et vous laisse choisir entre mettre les recommandations en pause pendant un rollout ou agréger l'utilisation des ReplicaSets concurrents.
Où Cast AI stocke-t-il les paramètres d'optimisation par workload, et pourquoi est-ce important ?
Cast AI impose de définir les overrides de configuration par workload sous forme d'annotations directement sur vos contrôleurs de workloads, dans les mêmes manifestes applicatifs que vos équipes produit modifient. La documentation de Cast AI confirme qu'il n'existe aucune alternative : les annotations sont le seul moyen de surcharger les paramètres de scaling vertical pour des workloads individuels.
Cela crée un vrai problème opérationnel. Comme ces optimisations n'existent que dans l'état du cluster en cours d'exécution, redéployer un workload depuis Git écrase le manifeste avec ses valeurs d'origine non optimisées, annulant silencieusement tout réglage appliqué.
PerfectScale évite ce problème en conservant la configuration d'automatisation dans son propre ensemble de ressources personnalisées (ClusterAutomationConfig, NamespaceAutomationConfig et WorkloadAutomationConfig), entièrement séparées de vos manifestes applicatifs. L'équipe plateforme possède et révise donc les paramètres d'optimisation de manière indépendante, et un redéploiement GitOps via Argo CD ou Flux ne détectera ni n'annulera les ajustements de PerfectScale au niveau des pods.
Que signifie "l'optimisation ne s'arrête pas aux limites du cluster" ?
Cela renvoie à la différence de périmètre entre les deux plateformes dès que l'on regarde au-delà du cluster Kubernetes lui-même. Le reporting de coûts de Cast AI ne fournit qu'un instantané de la situation actuelle, sans possibilité de consulter l'historique des coûts, et les chiffres d'utilisation ne sont pas mis à jour fréquemment. Son modèle de coûts repose en outre sur les prix catalogue publics plutôt que sur votre facture cloud réelle, puisque Cast AI ne requiert pas d'accès à la facturation.
PerfectScale fait partie de DoiT, ce qui étend l'optimisation au-delà du cluster : gestion continue des AWS Savings Plans et des Committed Use Discounts Google Cloud sur un large éventail de services, attribution des coûts jusqu'au niveau du client ou de la fonctionnalité grâce à un capteur eBPF, et visibilité unifiée sur la facturation AWS, Google Cloud et Azure via DoiT Cloud Intelligence™.
Puis-je essayer PerfectScale sans quitter Cast AI au préalable ?
Oui. Les deux plateformes opérant à des couches différentes, vous pouvez les exécuter côte à côte sur les mêmes clusters. Laissez Cast AI gérer le provisionnement des nœuds, désactivez son autoscaler de workloads pour éviter les changements contradictoires, et confiez le right-sizing des workloads à PerfectScale.
Vous pouvez ainsi comparer les deux plateformes directement sur vos workloads de production plutôt que de vous fier à une estimation sur tableur, sans migration ni risque de bascule pendant l'évaluation.
Quelle est l'offre pour les clients Cast AI actuels qui passent à PerfectScale ?
PerfectScale prend la moyenne de vos trois dernières factures mensuelles Cast AI, la divise par deux et en fait votre prix mensuel fixe PerfectScale pendant 24 mois. L'offre est réservée aux clients Cast AI actuels, les conditions étant confirmées lors d'un appel.