
Jede Aussage über Cast AI ist mit der öffentlichen Dokumentation des Anbieters verlinkt, Stand 2. September 2026. Beide Produkte werden häufig aktualisiert – prüfen Sie also die Links, statt uns einfach zu glauben.
TL;DR
Cast AI und PerfectScale optimieren beide Kubernetes-Workloads, unterscheiden sich aber in drei Punkten, die spürbar werden, sobald Sie Produktions-Cluster im großen Maßstab betreiben.
Das Wichtigste im Überblick:
- Deployments hebeln das Sizing von Cast AI aus: Der Autoscaler setzt beim Ausliefern eines neuen Releases keine neue Baseline. Empfehlungen aus der alten Version werden auf Ihren neuen Code angewendet, und die Sicherheitsmechanismen reagieren erst, wenn bereits etwas fehlschlägt (ein OOMKill, ein CPU-Stall)
- Die Konfiguration liegt am falschen Ort: Cast AI verlangt Overrides pro Workload als Annotations direkt in Ihren Applikations-Manifesten. Optimierungseinstellungen liegen damit im selben YAML, das Ihre Produktteams bearbeiten – ein Git-Redeploy kann sie unbemerkt löschen
- Cast AI endet an der Cluster-Grenze: Keine historischen Kostenberichte, keine Verarbeitung des AWS Cost and Usage Report und eine Preisberechnung auf Basis öffentlicher Listenpreise statt Ihrer tatsächlichen Rechnung
- PerfectScale löst alle drei Probleme: Revision-aware Sizing, das sich an Ihrem tatsächlich laufenden Code orientiert, Automatisierungskonfiguration in eigenen Custom Resources außerhalb Ihrer Manifeste sowie die Integration mit DoiT Cloud Intelligence für Commitments, Kostenattribution und Multi-Cloud-Billing
- Sie können beide parallel betreiben: Lassen Sie Cast AI weiterhin Nodes bereitstellen, deaktivieren Sie dessen Workload-Autoscaler und überlassen Sie PerfectScale das Workload-Right-Sizing auf denselben Clustern – der Vergleich erfordert keine Migration
1. Der Autoscaler setzt bei neuen Releases keine neue Baseline
Der Workload Autoscaler von Cast AI dimensioniert Workloads auf Basis eines Look-back-Fensters, konfigurierbar von 3 Stunden bis 7 Tagen, standardmäßig 24 Stunden, kontrolliert durch einen Confidence Score, der "das Verhältnis der gesammelten Metrik-Datenpunkte zur erwarteten Anzahl an Datenpunkten im konfigurierten Look-back-Zeitraum" misst.
Schauen Sie sich an, wodurch sich diese Empfehlung tatsächlich ändert. Die Dokumentation listet die Auslöser: ein 30-minütiger Regenerationszyklus und anomale Nutzung, OOM-Events, Evictions durch Memory Pressure, Nutzungsspitzen, CPU-Stalls und fehlgeschlagene Startup-Probes.
Das Deployment einer neuen Version Ihrer Anwendung steht nicht auf dieser Liste.
Spielen Sie das Szenario also durch. Um 14:00 Uhr deployen Sie ein Release, das das Speicherprofil einer Anwendung verändert. Die aktuell gültige Empfehlung wurde aus einem Fenster berechnet, das von der Vorgängerversion dominiert war. Im standardmäßigen Deferred-Modus gilt: "Der Mutating Admission Webhook von Cast AI wendet die Empfehlung an, wenn Pods auf natürliche Weise neu erstellt werden, zum Beispiel während Application Deployments." Ihr Deploy ist genau das Ereignis, das dem Code von heute das Sizing von gestern verpasst.
Die Sicherheitsmechanismen existieren wirklich – und sie sind alle reaktiv. Die Stall Detection erhöht die Empfehlung, wenn PSI eine CPU-Contention anzeigt, funktioniert aber nur für CPU und benötigt Kubernetes 1.34 oder höher. Nach einem OOMKill fügt das Memory Overhead Adjustment "entweder 20 % oder 100Mi hinzu, je nachdem, was größer ist", und lässt den Aufschlag über 24 Stunden linear auf null abklingen. Das ist ein guter Recovery-Mechanismus. Recovery bedeutet aber: Der Pod ist bereits gestorben.
PerfectScale geht denselben Moment vom anderen Ende an. Revision Awareness begrenzt Empfehlungen auf die tatsächlich laufende Revision, statt Daten aus alten Revisionen zu vermischen, und wenn Sie Ressourcen selbst ändern, gibt Ihnen die Automatisierung den Vortritt: "PerfectScale widerspricht Ihren Entwicklungsänderungen nicht; selbst bei eingeschalteter Automatisierung übernimmt PerfectScale sofort die Änderungen des jeweiligen Nutzers anstelle der aktuellen Empfehlungen. Das System erhöht oder reduziert Ressourcen erst dann, wenn wir klar verstanden haben, wie sich die Änderungen im Vergleich zu den Nutzungsmustern verhalten."
Das ist der Unterschied in einem Satz. Zum Deploy-Zeitpunkt wendet das eine System an, was es vor Ihrer Änderung gelernt hat. Das andere hält sich zurück, bis es Ihre Änderung gelernt hat.
Für gestaffelte Rollouts erkennt PerfectScale Ihre Argo-Rollouts-Strategie automatisch – Blue-Green, Canary oder A/B, ohne Tagging oder manuelle Konfiguration. Sie wählen das Verhalten: Pause, der Standard, wendet nichts an, solange parallele ReplicaSets existieren; Aggregate führt die Auslastung über sie zusammen und wendet eine einzige Empfehlung an.
Es geht nicht um einen schöneren Graphen. Es geht darum, dass die Automatisierung eingeschaltet bleibt. Teams, die sich einmal die Finger verbrannt haben, nehmen ihre größten Services stillschweigend aus der Optimierung heraus – und die Einsparungen verschwinden mit ihnen.
So senken Sie Kubernetes-Kosten, ohne Ihre SLOs zu gefährden →
2. Ihre Optimierungskonfiguration gehört nicht in Ihre Applikations-Manifeste
Stellen Sie eine präzisere Frage als die übliche: nicht, wo Ihre Daten liegen, sondern wer die Konfiguration verantwortet – und in welcher Datei sie steht.
Bei Cast AI sind Einstellungen pro Workload Annotations am Workload-Controller, und die Dokumentation stellt klar, dass es keine Alternative gibt: "Annotations sind der einzige Weg, Vertical-Scaling-Einstellungen für einzelne Workloads zu überschreiben. Die Cast AI Console unterstützt keine Overrides pro Workload." Die Settings-Referenz sagt dasselbe: "Sie können die Optimierung für einzelne Workloads weiterhin über die Console ein- oder ausschalten, aber alle anderen Overrides auf Workload-Ebene müssen über Annotations konfiguriert werden."
Damit ist die Optimierungs-Policy über Ihre Applikations-Manifeste verstreut, im selben YAML, das Ihre Produktteams bearbeiten – und am Ende tragen Ihre App-Owner die Verantwortung dafür. Cast AI dokumentiert auch den Drift, der dadurch entsteht: "Diese Optimierungen existieren nur im Live-Zustand des Clusters. Wenn Sie einen Workload aus Git neu deployen, überschreiben die ursprünglichen Manifest-Werte die optimierten Einstellungen und setzen Ihre Ressourcen auf veraltete, nicht optimierte Werte zurück."
PerfectScale hält die Optimierung vollständig aus Ihren Applikations-Manifesten heraus. Die Automatisierungskonfiguration ist ein eigener Satz Custom Resources, ClusterAutomationConfig, NamespaceAutomationConfig und WorkloadAutomationConfig, wobei Workload-Einstellungen den Namespace überschreiben und der Namespace den Cluster. Ein Objektgraph, in der Verantwortung des Plattform-Teams, reviewt im eigenen Pull Request.
Die Automatisierung rührt die Resources-Spec Ihrer Deployments nicht an. Aus der Argo-CD-Integrationsdoku: "Die Automatisierung ändert Ressourcen auf Pod-Ebene, ohne die Spec der übergeordneten Ressourcen (Deployment, StatefulSet etc.) zu beeinflussen, sodass ArgoCD keine Änderungen erkennt und nicht versucht, sie zurückzusetzen." Argo CD und Flux werden beide unterstützt.
Und die Kontrollen, die um 2 Uhr nachts zählen, sind kubectl-Operationen gegen eine Ressource in Ihrem eigenen Cluster – kein Support-Ticket. stopAllAutomation stoppt alles clusterweit und "überschreibt dabei alle bestehenden Automatisierungseinstellungen für einzelne Namespaces oder Workloads." cleanupAllAutomation geht noch weiter und "stoppt nicht nur die Automatisierung, sondern rollt auch alle von den Automatisierungsprozessen vorgenommenen Änderungen zurück und stellt die ursprünglichen Ressourcenspezifikationen und Einstellungen wieder her."
Bei einem Cluster ist das Geschmackssache. Bei fünfzig ist es der Unterschied zwischen einem Plattform-Team, dem die Optimierung gehört, und einem, das sie nur erbt.
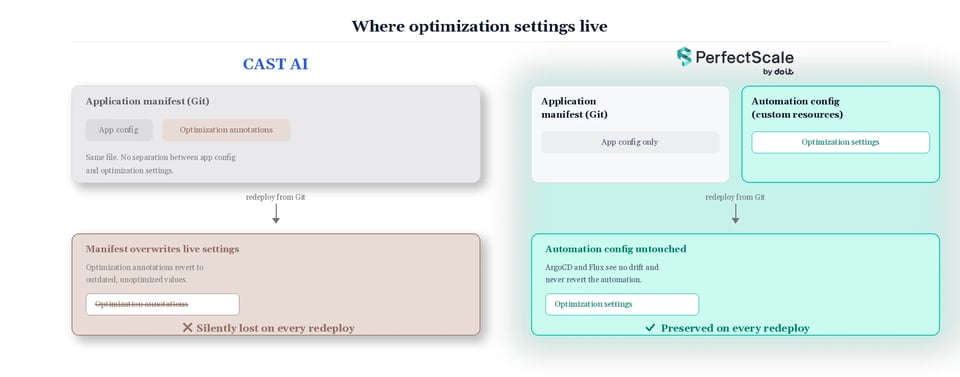 Cast AI mischt Optimierungseinstellungen in Ihre Applikations-Manifeste – ein Git-Redeploy überschreibt sie unbemerkt. PerfectScale hält die Automatisierungskonfiguration getrennt, sodass sie jedes Redeploy unverändert übersteht.
3. Optimierung endet nicht an der Cluster-Grenze
Beim dritten Grund geht es um den Umfang, nicht um ein einzelnes Feature.
Cast AI trackt durchaus Commitments. Was es nicht liefert: die Historie und die tatsächlichen Abrechnungsdaten. Die eigene Doku: "Derzeit bietet das Reporting nur eine Momentaufnahme der aktuellen Situation, ohne die Möglichkeit, historische Daten einzusehen." Die Auslastung wird "nicht häufig aktualisiert" und bei Node- und Cluster-Änderungen neu berechnet. Und das darunterliegende Kostenmodell ist der Listenpreis, nicht Ihre Rechnung. Von der Cost-Management-Seite: "Billing-Zugriff nicht erforderlich. CAST AI verwendet öffentliche Preise, sodass Sie keine Abrechnungsdetails teilen müssen." Beim Onboarding ist das wirklich praktisch – und später eine echte Grenze. Eine Verarbeitung des AWS Cost and Usage Report haben wir nirgendwo in der Dokumentation gefunden.
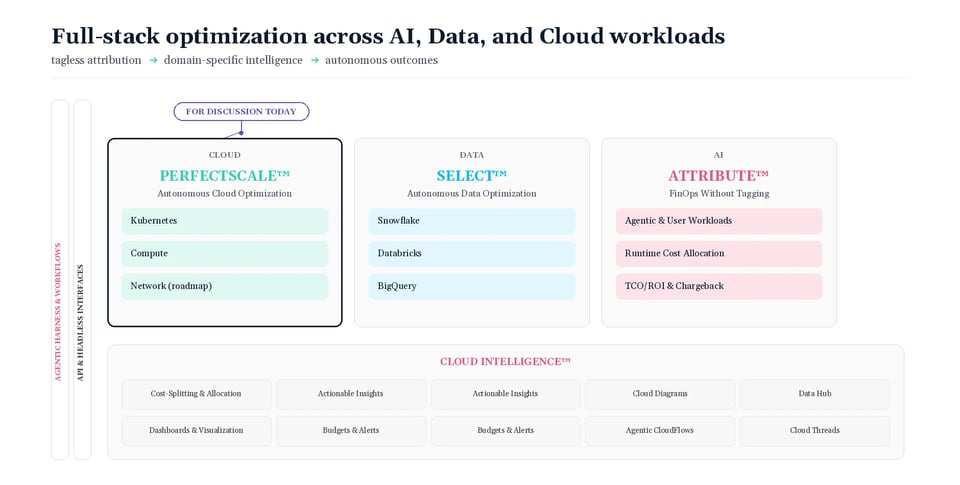
PerfectScale ist Teil von DoiT – dieselbe Partnerschaft deckt also auch die Arbeit ab, die dort beginnt, wo der Cluster endet.
Commitments. PerfectScale for Commitments optimiert AWS Savings Plans kontinuierlich über EC2, Fargate und Lambda hinweg, dazu Database Savings Plans für Aurora und RDS, Aurora Serverless v2, Aurora DSQL, DynamoDB, ElastiCache for Valkey, DocumentDB, Neptune, Keyspaces, Timestream, DMS und OpenSearch – gemäß den AWS-Eligibility-Regeln. Auch die Unterstützung für Google Cloud CUDs ist inzwischen GA und deckt Compute Engine, Cloud SQL, BigQuery Editions, AlloyDB, Spanner, Firestore, Dataflow, Memorystore, Bigtable und Managed Service for Apache Kafka ab. Commitment Laddering staffelt mehrere kleinere Pläne mit überlappenden Laufzeiten, sodass "bei sinkender Nutzung nur ein kleiner Teil Ihrer Commitments betroffen ist."
Attribution. Attribute beantwortet die Frage, an der Tags scheitern: Welcher Kunde oder welches Feature hat diese Ausgaben verursacht? Ein leichtgewichtiger eBPF-Sensor wird per Helm in rund 15 Minuten ausgerollt, ganz ohne Code- oder Konfigurationsänderungen; mandantenfähige Cluster, gemeinsam genutzte Datenbanken und Message Queues werden nach dem tatsächlich beobachteten Laufzeitverbrauch aufgeteilt statt nach Verteilungsschlüsseln.
Die Rechnung selbst – und die Menschen dahinter. DoiT Cloud Intelligence deckt Kosten über AWS, Google Cloud und Azure hinweg ab, mit Forward Deployed Engineers, die, wie wir gerne sagen, mit der Plattform kommen und nicht mit der Rechnung.
Für den Vergleich müssen Sie nichts herausreißen
Beim Evaluierungspfad lohnt sich Klartext. Die beiden Plattformen arbeiten auf unterschiedlichen Ebenen, Sie können sie also parallel betreiben: Lassen Sie Cast AI weiterhin Nodes bereitstellen, deaktivieren Sie dessen Workload-Autoscaler, um widersprüchliche Änderungen zu vermeiden, und überlassen Sie PerfectScale das Workload-Right-Sizing auf denselben Clustern. Keine Migration, kein Wechselrisiko – und ein Vergleich auf Ihren Produktions-Workloads statt in einem Spreadsheet.
Das i-Tüpfelchen
Wenn Sie heute Cast-AI-Kunde sind, nehmen wir den Durchschnitt Ihrer letzten drei monatlichen Cast-AI-Rechnungen, halbieren ihn und machen daraus Ihren festen monatlichen PerfectScale-Preis für 24 Monate.
Dieselbe Kernaufgabe. Ungefähr die halben Plattformkosten. Automatisierung, die beim Deploy nicht dazwischenfunkt, Konfiguration dort, wo Ihr Plattform-Team sie verantworten kann, und eine Plattform, die auch jenseits der Cluster-Grenze weitermacht.
Wenn Sie heute Cast AI einsetzen, kostet der schnellste Weg, den Unterschied zu sehen, gar nichts. Betreiben Sie PerfectScale parallel auf denselben Clustern – keine Migration, kein Rip-and-Replace – und vergleichen Sie die Ergebnisse auf Ihren eigenen Produktions-Workloads. Wenn die Zahlen überzeugen, halbieren wir Ihre durchschnittlichen monatlichen Cast-AI-Ausgaben und schreiben den Preis für 24 Monate fest.
Buchen Sie ein Gespräch – und bringen Sie Ihre letzten drei Rechnungen mit
Das Angebot gilt für aktuelle Cast-AI-Kunden. Die Konditionen werden im Gespräch bestätigt.
Häufig gestellte Fragen
Warum passt sich der Autoscaler von Cast AI nicht an neue Application-Releases an?
Der Workload Autoscaler von Cast AI erstellt seine Sizing-Empfehlungen aus einem Look-back-Fenster gesammelter Metriken, standardmäßig in der Regel 24 Stunden. Laut eigener Dokumentation gehören zu den Auslösern einer aktualisierten Empfehlung ein 30-minütiger Regenerationszyklus, OOM-Events, Evictions durch Memory Pressure, Nutzungsspitzen, CPU-Stalls und fehlgeschlagene Startup-Probes.
Ein neues Application Deployment steht nicht auf dieser Liste. Wenn Sie also ein Release ausliefern, das das Speicher- oder CPU-Profil Ihrer App verändert, basiert die noch gültige Empfehlung auf dem Verhalten der Vorgängerversion. Im standardmäßigen Deferred-Modus von Cast AI wird diese veraltete Empfehlung genau in dem Moment angewendet, in dem Ihre Pods während des Deploys neu erstellt werden.
Die Sicherheitsmechanismen wie Stall Detection und die Memory-Overhead-Anpassung nach einem OOMKill reagieren erst, nachdem ein Problem bereits aufgetreten ist – nicht vorher.
Wie geht PerfectScale beim Sizing während Deployments anders vor?
PerfectScale nutzt Revision Awareness: Ressourcenempfehlungen werden auf die tatsächlich laufende Revision begrenzt, statt Daten aus alten und neuen Versionen zu vermischen. Wenn Sie Ressourcen manuell ändern, übernimmt die Automatisierung von PerfectScale Ihre Änderungen sofort, statt sie zu überschreiben, und justiert erst dann wieder nach, wenn sie beobachtet hat, wie sich Ihre Änderung im Vergleich zu den realen Nutzungsmustern verhält.
Für Teams mit gestaffelten Rollout-Strategien erkennt PerfectScale Argo-Rollouts-Strategien (Blue-Green, Canary oder A/B) automatisch und ohne manuelles Tagging – und Sie entscheiden, ob Empfehlungen während eines Rollouts pausieren oder die Auslastung über parallele ReplicaSets aggregiert wird.
Wo speichert Cast AI Optimierungseinstellungen pro Workload – und warum ist das wichtig?
Cast AI verlangt, dass Konfigurations-Overrides pro Workload als Annotations direkt an den Workload-Controllern gesetzt werden – in denselben Applikations-Manifesten, die Ihre Produktteams bearbeiten. Die eigene Dokumentation von Cast AI bestätigt, dass es keine Alternative gibt: Annotations sind der einzige Weg, Vertical-Scaling-Einstellungen für einzelne Workloads zu überschreiben.
Das schafft ein reales operatives Problem. Weil diese Optimierungen nur im Live-Zustand des Clusters existieren, überschreibt ein Redeploy aus Git das Manifest mit seinen ursprünglichen, nicht optimierten Werten und setzt jedes vorgenommene Tuning unbemerkt zurück.
PerfectScale vermeidet das, indem die Automatisierungskonfiguration in einem eigenen Satz Custom Resources liegt (ClusterAutomationConfig, NamespaceAutomationConfig und WorkloadAutomationConfig) – vollständig getrennt von Ihren Applikations-Manifesten. Das Plattform-Team verantwortet und reviewt die Optimierungseinstellungen unabhängig, und ein GitOps-Redeploy über Argo CD oder Flux wird die Pod-Level-Anpassungen von PerfectScale weder erkennen noch zurücksetzen.
Was bedeutet "Optimierung endet nicht an der Cluster-Grenze"?
Gemeint ist der Unterschied im Umfang beider Plattformen, sobald man über den Kubernetes-Cluster hinausblickt. Das Kosten-Reporting von Cast AI liefert nur eine Momentaufnahme der aktuellen Situation, ohne Zugriff auf historische Kostendaten, und die Auslastungswerte werden nicht häufig aktualisiert. Das Kostenmodell basiert zudem auf öffentlichen Listenpreisen statt auf Ihrer tatsächlichen Cloud-Rechnung, da Cast AI keinen Billing-Zugriff benötigt.
PerfectScale ist Teil von DoiT und erweitert die Optimierung über den Cluster hinaus: kontinuierliches Management von AWS Savings Plans und Google Cloud Committed Use Discounts über eine breite Palette von Services, Kostenattribution bis auf Kunden- oder Feature-Ebene per eBPF-Sensor sowie einheitliche Billing-Transparenz über AWS, Google Cloud und Azure mit DoiT Cloud Intelligence.
Kann ich PerfectScale testen, ohne vorher von Cast AI zu migrieren?
Ja. Da beide Plattformen auf unterschiedlichen Ebenen arbeiten, können Sie sie parallel auf denselben Clustern betreiben. Lassen Sie Cast AI weiterhin das Node-Provisioning übernehmen, deaktivieren Sie dessen Workload-Autoscaler, um widersprüchliche Änderungen zu vermeiden, und überlassen Sie PerfectScale das Workload-Right-Sizing.
So vergleichen Sie beide Plattformen direkt auf Ihren Produktions-Workloads, statt sich auf eine Schätzung im Spreadsheet zu verlassen – ganz ohne Migrations- oder Wechselrisiko während der Evaluierung.
Wie sieht das Angebot für aktuelle Cast-AI-Kunden aus, die zu PerfectScale wechseln?
PerfectScale nimmt den Durchschnitt Ihrer letzten drei monatlichen Cast-AI-Rechnungen, halbiert diesen Betrag und schreibt ihn als Ihren festen monatlichen PerfectScale-Preis für 24 Monate fest. Das Angebot gilt für aktuelle Cast-AI-Kunden; die Konditionen werden in einem Gespräch bestätigt.