


Mientras tus clústeres seguían escalando, nosotros lanzamos un montón de nuevas capacidades y mejoras, grandes y pequeñas, para ayudarte a obtener mejores resultados de optimización.
Este resumen cubre algunas de las cosas clave en las que hemos estado trabajando: desde la optimización de infraestructura y GPU hasta las barreras de protección y la posibilidad de acceder a los insights de PerfectScale fuera de la plataforma.
Vamos a ello.
De la visibilidad de la infraestructura a la acción
La pérdida a nivel de nodo representa una parte importante de la factura de Kubernetes, y optimizarla con confianza no es trivial. Este verano convertimos dos insights de visibilidad en recomendaciones claras y accionables.
Recomendaciones de optimización para Karpenter
Karpenter es tan bueno como la configuración de sus NodePools, y esa configuración suele definirse una sola vez, al inicio, y rara vez se revisa. Mientras tanto, los workloads cambian: se lanzan nuevos servicios con perfiles de CPU y memoria distintos, los patrones de uso evolucionan, y las familias de instancias que tenían sentido hace seis meses hoy pueden resultar demasiado caras o difíciles de conseguir. El resultado es una pérdida silenciosa: nodos infrautilizados, fallas de scheduling y ahorros que se escapan y solo salen a la luz en la factura de la nube o en un pico de pods pendientes.
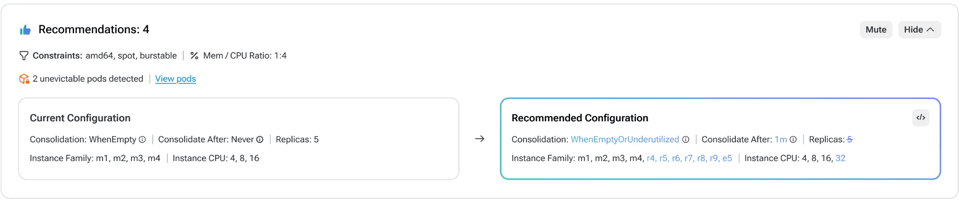
PerfectScale ahora ofrece recomendaciones accionables de optimización de Karpenter, evaluando continuamente la configuración de tus NodePools frente al comportamiento real de los workloads. Detecta configuraciones demasiado restrictivas, desactualizadas o mal alineadas —mala relación CPU-memoria, selección limitada de instancias, oportunidades de consolidación desaprovechadas— y las convierte en decisiones informadas: dónde afinar la consolidación, qué categorías de instancias encajan mejor y cómo ajustar los límites de los NodePools. Con esta nueva capacidad, PerfectScale extiende el ciclo de optimización: los workloads con right-sizing son la base, Karpenter se configura según la demanda real y la infraestructura sigue adaptándose a medida que la demanda cambia.
Recomendaciones para pods no desalojables
En primavera lanzamos visibilidad sobre los pods no desalojables: workloads que quedan "atascados" en un nodo y le impiden reducir su escala, limitando silenciosamente la eficiencia del bin-packing. La visibilidad te mostraba dónde estaban los bloqueos. Ahora, convertimos esos insights en acción.
PerfectScale ahora ofrece recomendaciones basadas en datos para los pods que marca como no desalojables, de modo que puedas resolver los bloqueos de scale-down en unos pocos clics y lograr mejores consolidaciones de nodos y un mejor bin-packing.
Optimización de GPU
Las GPU ya representan una gran parte del costo de un nodo con GPU, por lo que la infrautilización y la capacidad de GPU inactiva pueden traducirse rápidamente en pérdidas de gasto considerables. PerfectScale ya ofrecía visibilidad granular de la utilización y la eficiencia de cómputo, pero eso era solo la mitad del panorama. La memoria es donde los workloads de IA pueden generar verdaderas dificultades operativas: si asignas muy poca, corres el riesgo de OOMs; si asignas de más "por si acaso", terminas pagando por capacidad costosa que nunca se usa.
PerfectScale ahora ofrece visibilidad de la memoria GPU junto con el cómputo GPU, dándote una vista clara de cómo los workloads usan realmente la memoria de la GPU. Esto significa que puedes dimensionar los workloads de IA con base en el uso real en lugar de suposiciones, evitando capacidad innecesaria y reduciendo el riesgo de problemas de rendimiento relacionados con la memoria.
Agrupación de workloads efímeros
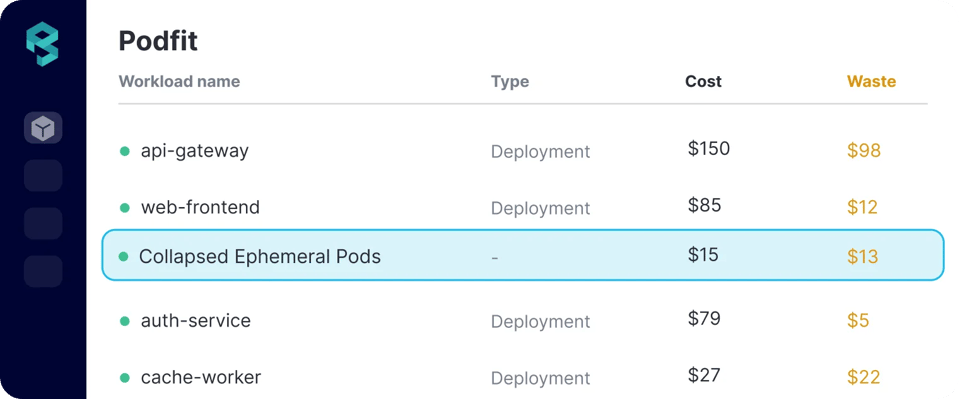
Jobs de Spark, DAGs de Airflow, runners de CI: estos workloads no viven lo suficiente como para que el right-sizing tradicional construya un panorama confiable, y cada pod de corta duración aparece como un punto de datos ruidoso y desconectado.
La agrupación de workloads efímeros consolida estos workloads de corta duración en una sola entidad, eliminando el ruido de cientos de ejecuciones puntuales y dándoles a los usuarios una vista clara de lo que realmente importa.
Barreras de protección para una automatización segura
La confianza en la automatización nace de saber exactamente qué hará y qué no. Este verano lanzamos dos actualizaciones para reforzar aún más el enfoque de PerfectScale, donde la confiabilidad es lo primero.
Detección de CPU fuera de control
No todo pico de CPU es un problema de dimensionamiento. Algunos son síntomas de un problema mayor: un loop de reintentos atascado, un bug que mantiene ocupado un núcleo de CPU, y más. Si no se controlan, estos patrones pueden distorsionar los datos de utilización y llevar a la automatización a tomar decisiones equivocadas.
PerfectScale ahora detecta comportamientos de CPU fuera de control. Esto mantiene las decisiones de dimensionamiento seguras y precisas, y le da a tu equipo una señal temprana cuando algo realmente anda mal, no solo cuando está ocupado.
Soporte de ResourceQuota en modo completo
ResourceQuota siempre ha sido una de las salvaguardas definidas por el sistema en PerfectScale: la automatización y las recomendaciones están acotadas para que nunca superen una cuota de recursos definida por el usuario. Hasta ahora, esto funcionaba en modo de solo reducción cada vez que una recomendación se acercaba al límite.
Con el soporte de ResourceQuota en modo completo, PerfectScale ahora aumenta los recursos de un workload hasta el tope de la cuota cuando el workload lo necesita, en lugar de quedarse corto. Sigues teniendo el mismo techo estricto y la misma protección contra violaciones de cuota, pero ahora todo el rango por debajo de ese techo está disponible para resolver casos reales de aprovisionamiento insuficiente.
PerfectScale más allá de la interfaz
La última pieza del verano no consistió en agregar nuevos insights, sino en hacer que los insights que ya tienes sean más fáciles de acceder y de usar.
Skill de PerfectScale para agentes de IA
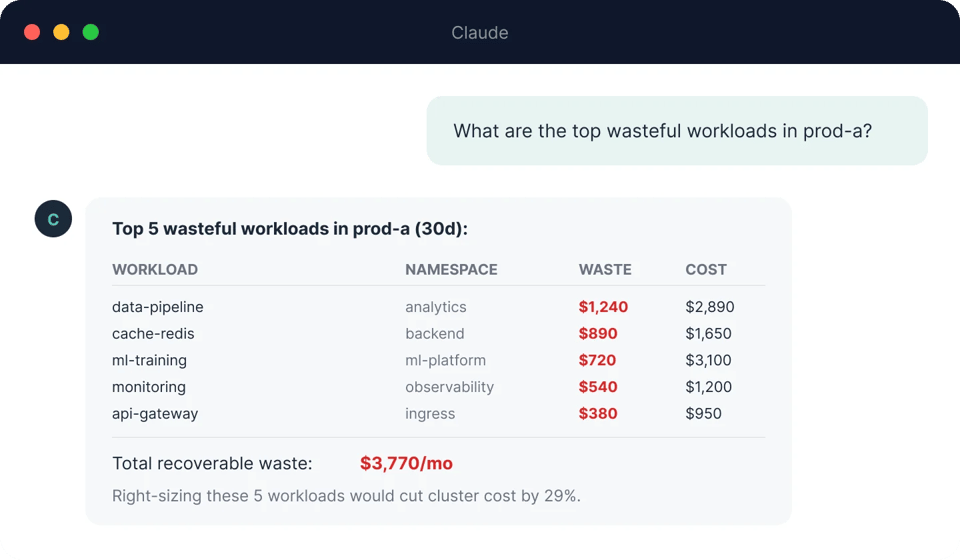
Los datos de optimización de Kubernetes solo son útiles si te llegan donde ya estás trabajando, y para la mayoría de los equipos eso ya no es solo un dashboard. La skill de PerfectScale para agentes de IA lleva los datos de PerfectScale a tus flujos de trabajo agénticos, para que puedas usar agentes de IA como Claude o Codex para consultar y filtrar datos por costo, riesgo, namespace y más. La CLI que la impulsa es open source, genera JSON/JSONL estructurado y está diseñada para funcionar junto a los demás datos operativos que tus agentes ya utilizan.
API pública de InfraFit
Los datos a nivel de nodo llevan un tiempo disponibles en la interfaz. Ahora también están disponibles de forma programática. La API pública de InfraFit amplía la superficie de API de PerfectScale para incluir datos de grupos de nodos y tipos de nodo, así como recomendaciones de Karpenter y de bin-packing. Los equipos pueden llevar insights de costo, pérdida, utilización y optimización a nivel de infraestructura directamente a sus flujos de trabajo de ingeniería.
Para cerrar
Al mirar el verano en retrospectiva, el patrón es claro: la visibilidad se convirtió en acción, las barreras de protección se fortalecieron y los insights de PerfectScale se volvieron más fáciles de usar donde trabaja tu equipo.
Todo vuelve a la misma filosofía de optimización: la optimización de Kubernetes debe ser segura, basada en datos y accionable.
Y no hemos terminado. ¡Viene más!
📖 Encuentra más detalles en nuestra documentación.
🦸♀️ Agenda una llamada con nuestro equipo si quieres el apoyo de expertos.
¿Todavía no usas PerfectScale? Empieza gratis hoy y simplifica la optimización de tus K8s.