


Mentre i Suoi cluster continuavano a scalare, noi abbiamo rilasciato numerose novità e miglioramenti, grandi e piccoli, per aiutarLa a ottenere risultati di ottimizzazione migliori.
Questo recap raccoglie alcuni dei principali fronti su cui abbiamo lavorato: dall'ottimizzazione dell'infrastruttura e delle GPU ai guardrail di sicurezza, fino alla possibilità di usare gli insight di PerfectScale anche fuori dalla piattaforma.
Entriamo nel vivo.
Dalla visibilità sull'infrastruttura all'azione
Lo spreco a livello di nodo incide in modo significativo sulla bolletta Kubernetes, e ottimizzarlo con sicurezza non è banale. Quest'estate abbiamo trasformato due insight di pura visibilità in raccomandazioni chiare e attuabili.
Raccomandazioni per l'ottimizzazione di Karpenter
Karpenter vale quanto la configurazione dei suoi NodePool, una configurazione che di solito viene impostata una sola volta, al lancio, e raramente rivista. Nel frattempo i workloads cambiano: nuovi servizi arrivano con profili CPU/memoria diversi, i pattern di utilizzo si spostano e famiglie di istanze che avevano senso sei mesi fa oggi possono risultare troppo costose o difficili da reperire. Il risultato è uno spreco silenzioso: nodi sottoutilizzati, errori di scheduling e risparmi mancati che emergono solo nella fattura cloud o in un picco di pod in pending.
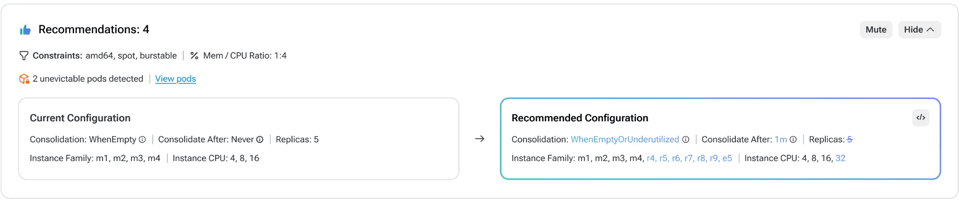
PerfectScale ora fornisce raccomandazioni di ottimizzazione concreta di Karpenter, valutando in modo continuo le impostazioni dei NodePool rispetto al comportamento reale dei workloads. Segnala le configurazioni troppo restrittive, obsolete o disallineate — rapporto CPU/memoria inadeguato, selezione di istanze limitata, opportunità di consolidamento mancate — e le trasforma in decisioni informate: dove stringere il consolidamento, quali categorie di istanze si adattano meglio e come regolare i limiti dei NodePool. Con questa nuova funzionalità PerfectScale estende il ciclo di ottimizzazione: i workloads dimensionati correttamente con il right-sizing forniscono la base, Karpenter viene configurato in base alla domanda reale e l'infrastruttura continua ad adattarsi al variare della domanda.
Raccomandazioni per i pod non evacuabili
In primavera avevamo introdotto la visibilità sui pod non evacuabili: workloads che restano "bloccati" su un nodo e ne impediscono lo scale-down, limitando silenziosamente l'efficienza del bin-packing. La visibilità mostrava dove si trovavano i blocchi. Ora trasformiamo quegli insight in azione.
PerfectScale ora fornisce raccomandazioni data-driven per i pod segnalati come non evacuabili, così può risolvere i blocchi allo scale-down in pochi clic, sbloccando un migliore consolidamento dei nodi e un bin-packing più efficiente.
Ottimizzazione delle GPU
Le GPU rappresentano già una quota importante del costo di un nodo GPU: sottoutilizzo e capacità GPU inattiva possono quindi tradursi rapidamente in una spesa sprecata significativa. PerfectScale offriva già una visibilità granulare su utilizzo ed efficienza del compute, ma era solo metà del quadro. È sulla memoria che i workloads AI possono creare vere difficoltà operative: se si alloca troppo poco si rischiano gli OOM, se si alloca troppo "per sicurezza" si finisce per pagare capacità costosa che non è mai stata utilizzata.
PerfectScale ora offre visibilità sulla memoria GPU accanto al compute GPU, con una visione chiara di come i workloads utilizzano effettivamente la memoria GPU. Questo significa poter dimensionare i workloads AI sulla base dell'uso reale anziché di stime approssimative, evitando capacità superflua e riducendo al tempo stesso il rischio di problemi di performance legati alla memoria.
Raggruppamento dei workloads effimeri
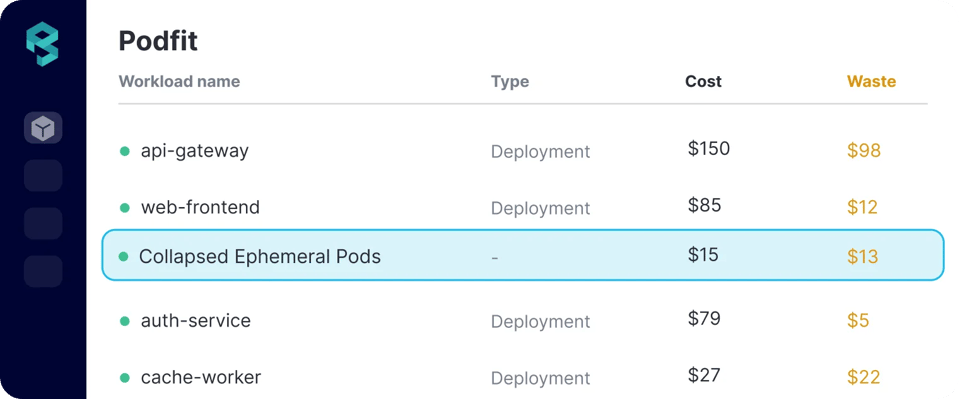
Job Spark, DAG di Airflow, runner CI: questi workloads non vivono abbastanza a lungo perché il right-sizing tradizionale possa costruire un quadro affidabile, e ogni pod di breve durata compare come un punto dati isolato e rumoroso.
Il raggruppamento dei workloads effimeri consolida questi workloads di breve durata in un'unica entità, eliminando il rumore di centinaia di esecuzioni una tantum e offrendo una visione chiara di ciò che conta davvero.
Guardrail che mantengono l'automazione sicura
La fiducia nell'automazione nasce dal sapere esattamente cosa farà — e cosa no. Quest'estate abbiamo rilasciato due aggiornamenti per rendere ancora più solido l'approccio reliability-first di PerfectScale.
Rilevamento del CPU runaway
Non ogni picco di CPU è un problema di dimensionamento. Alcuni sono il sintomo di un problema più grande: un loop di retry bloccato, un bug che tiene occupato un core CPU e altro ancora. Se non controllati, questi pattern possono falsare i dati di utilizzo e indurre l'automazione a prendere decisioni sbagliate.
PerfectScale ora rileva i comportamenti di CPU runaway. Le decisioni di dimensionamento restano così sicure e accurate, e il Suo team riceve un segnale precoce quando qualcosa non funziona davvero, e non è semplicemente sotto carico.
Supporto full-mode per le ResourceQuota
Le ResourceQuota sono da sempre una delle protezioni di sistema di PerfectScale: automazione e raccomandazioni sono limitate in modo da non superare mai una quota di risorse definita dall'utente. Finora, quando una raccomandazione si avvicinava al limite, il meccanismo funzionava in modalità di sola riduzione (decrease-only).
Con il supporto full-mode delle ResourceQuota, PerfectScale ora aumenta le risorse dei workloads fino al tetto della quota quando un workload ne ha bisogno, invece di fermarsi prima. Il limite massimo e la protezione contro le violazioni delle quote restano invariati, ma ora l'intero intervallo al di sotto di quel tetto è disponibile per correggere un reale under-provisioning.
PerfectScale oltre l'interfaccia utente
L'ultimo tassello dell'estate non riguardava l'aggiunta di nuovi insight, ma rendere più facili da consultare e utilizzare quelli già disponibili.
PerfectScale AI agent skill
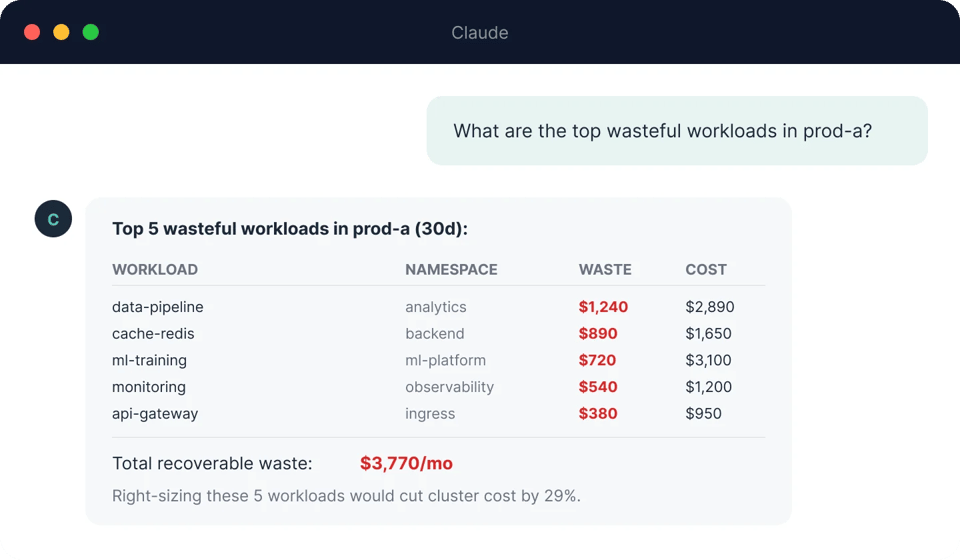
I dati di ottimizzazione Kubernetes sono utili solo se arrivano dove si lavora già, e per la maggior parte dei team questo non significa più solo una dashboard. La PerfectScale AI agent skill porta i dati di PerfectScale nei workflow agentici: può usare agenti AI come Claude o Codex per interrogare e filtrare i dati per costo, rischio, namespace e altro ancora. La CLI alla base è open source, produce output JSON/JSONL strutturato ed è progettata per integrarsi con gli altri dati operativi che i Suoi agenti già utilizzano.
API pubblica InfraFit
I dati a livello di nodo sono disponibili nell'interfaccia già da tempo. Ora sono accessibili anche in modo programmatico. L'API pubblica InfraFit estende la superficie API di PerfectScale con i dati su node group e tipi di nodo, oltre alle raccomandazioni su Karpenter e bin-packing. I team possono portare gli insight su costi, sprechi, utilizzo e ottimizzazione a livello di infrastruttura direttamente nei propri workflow di engineering.
In conclusione
Ripensando all'estate, il filo conduttore è chiaro: la visibilità è diventata azione, i guardrail si sono rafforzati e gli insight di PerfectScale sono diventati più facili da usare lì dove il Suo team lavora.
Tutto riconduce alla stessa filosofia di ottimizzazione: l'ottimizzazione di Kubernetes deve essere sicura, data-driven e attuabile.
E non abbiamo finito: altre novità sono in arrivo!
📖 Trovi maggiori dettagli nella nostra documentazione.
🦸♀️ Prenoti una call con il nostro team se desidera il supporto di un esperto.
Non usa ancora PerfectScale? Inizi gratis oggi stesso e semplifichi il Suo percorso di ottimizzazione K8s.