


クラスターがスケールし続ける間も、私たちはより良い最適化結果をお届けするため、大小さまざまな新機能や改善を数多くリリースしてきました。
このまとめでは、インフラやGPUの最適化から、安全性を守るガードレール、そしてプラットフォームの外でPerfectScaleのインサイトを活用できる仕組みまで、私たちが取り組んできた主なポイントをご紹介します。
それでは見ていきましょう。
インフラの可視化をアクションへ
ノードレベルの無駄はKubernetesコストの大きな部分を占めており、それを自信を持って最適化するのは簡単ではありません。この夏、私たちは可視化にとどまっていた2つのインサイトを、明確で実行可能な推奨事項へと進化させました。
Karpenter最適化の推奨事項
Karpenterの実力はNodePoolの設定次第です。しかもその設定は、通常は導入時に一度行われたきり、見直されることはほとんどありません。その間にもワークロードは変化します。新しいサービスは異なるCPU・メモリ比で登場し、利用パターンは移り変わり、半年前には妥当だったインスタンスファミリーが、今では割高になっていたり調達しにくくなっていたりします。その結果生まれるのが、目に見えない無駄です。使用率の低いノード、スケジューリングの失敗、そしてクラウドの請求書や保留中Podの急増で初めて表面化する、見逃されたコスト削減の機会です。
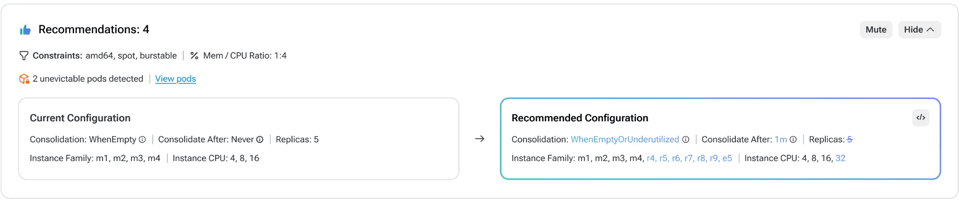
PerfectScaleは、NodePool設定を実際のワークロードの挙動と照らし合わせて継続的に評価し、実行可能なKarpenter最適化の推奨事項を提供するようになりました。範囲が狭すぎる設定、古くなった設定、実態と合っていない設定、CPU・メモリ比のミスマッチ、限定的なインスタンス選択、見逃されたコンソリデーションの機会などを検出し、根拠に基づく意思決定へとつなげます。どこでコンソリデーションを強化すべきか、どのインスタンスカテゴリーがより適しているか、NodePoolの上限をどう調整すべきか、といった判断です。この新機能により、PerfectScaleは最適化のループを拡張します。ライトサイジングされたワークロードが基盤となり、Karpenterは実際の需要に基づいて設定され、需要の変化に合わせてインフラが適応し続けます。
退避不可Podの推奨事項
この春、私たちは退避不可(unevictable)なPodの可視化機能をリリースしました。ノードに「張り付いて」スケールダウンを妨げ、ビンパッキングの効率を静かに低下させるワークロードです。可視化によってブロッカーの所在は分かるようになりました。今回は、そのインサイトをアクションへとつなげます。
PerfectScaleは、退避不可としてフラグ付けしたPodに対してデータドリブンな推奨事項を提示するようになりました。数クリックでスケールダウンのブロッカーを解消し、より効率的なノードコンソリデーションとビンパッキングを実現できます。
GPUの最適化
GPUノードのコストの大部分はGPUそのものが占めるため、使用率の低さやアイドル状態のGPUキャパシティは、あっという間に大きな無駄な支出につながります。PerfectScaleはこれまでも、コンピュートの使用率と効率をきめ細かく可視化してきましたが、それは全体の半分にすぎませんでした。AIワークロードで実際に運用上の問題を引き起こしうるのはメモリです。割り当てが少なすぎればOOMのリスクがあり、「念のため」に多く割り当てれば、一度も使われない高価なキャパシティにお金を払い続けることになります。
PerfectScaleは、GPUコンピュートに加えてGPUメモリの可視化も提供するようになり、ワークロードが実際にGPUメモリをどう使っているかを明確に把握できます。これにより、推測ではなく実際の使用状況に基づいてAIワークロードのサイジングが可能になり、不要なキャパシティを回避しながら、メモリ起因のパフォーマンス問題のリスクも低減できます。
エフェメラルワークロードのグルーピング
SparkジョブやAirflowのDAG、CIランナー。これらのワークロードは、従来のライトサイジングが信頼できる全体像を構築できるほど長くは稼働せず、短命なPodのひとつひとつが、ノイズの多いバラバラなデータポイントとして表示されてしまいます。
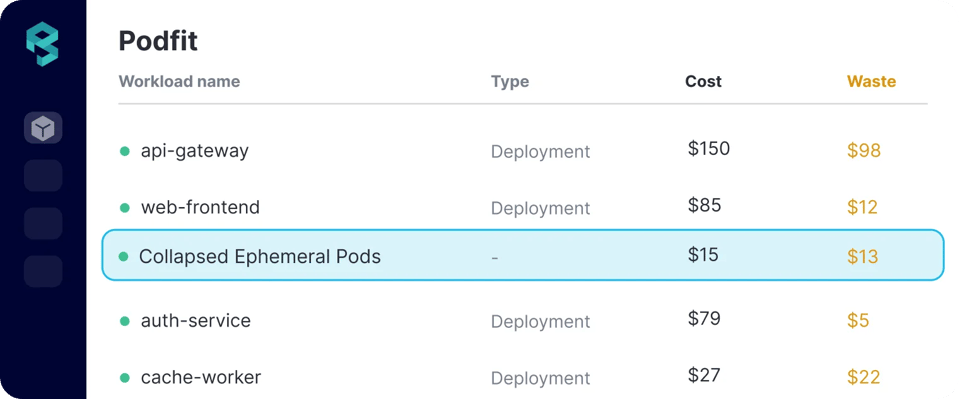
エフェメラルワークロードのグルーピングは、こうした短命なワークロードを単一のエンティティに統合します。何百もの単発実行によるノイズを取り除き、本当に重要な情報を明確に把握できるようにします。
自動化を安全に保つガードレール
自動化への信頼は、それが何をして何をしないのかを正確に把握できることから生まれます。この夏、PerfectScaleの信頼性ファーストのアプローチをさらに強化する2つのアップデートをお届けしました。
CPU暴走の検知
すべてのCPUスパイクがサイジングの問題とは限りません。スタックしたリトライループや、CPUコアを占有し続けるバグなど、より大きな問題の兆候である場合もあります。放置すれば、こうしたパターンは使用率データを歪め、自動化が誤った判断を下す原因になります。
PerfectScaleは、CPUの暴走的な挙動を検知できるようになりました。これによりサイジングの判断を安全かつ正確に保つと同時に、単に負荷が高いだけではなく本当に問題が起きているときに、チームへ早期のシグナルを届けます。
フルモードのResourceQuotaサポート
ResourceQuotaは以前からPerfectScaleのシステム定義セーフガードのひとつであり、自動化と推奨事項はユーザーが定義したリソースクォータを決して超えないように制限されています。これまでは、推奨事項が上限に近づくと、縮小方向のみのモードで動作していました。
フルモードのResourceQuotaサポートにより、PerfectScaleはワークロードが必要とする場合、手前で止まることなく、クォータ上限ぎりぎりまでワークロードのリソースを増やせるようになりました。これまでと同じ厳格な上限とクォータ違反への保護はそのままに、上限以下の全レンジを、実際のリソース不足の解消に活用できます。
UIの先へ広がるPerfectScale
この夏の最後のピースは、新しいインサイトの追加ではありません。すでにあるインサイトを、より簡単にアクセスして活用できるようにすることでした。
PerfectScale AIエージェントスキル
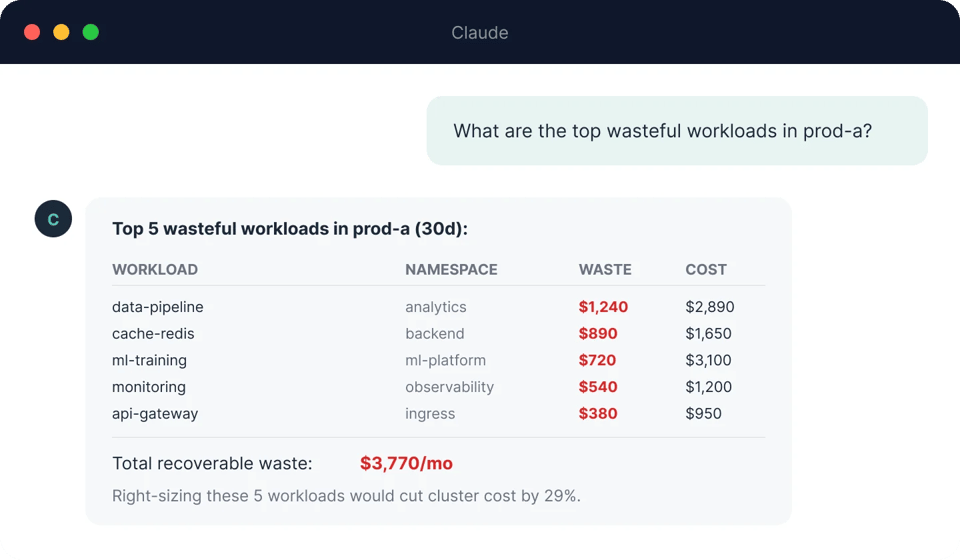
Kubernetesの最適化データは、すでに作業している場所に届いてこそ価値があります。そして多くのチームにとって、その場所はもはやダッシュボードだけではありません。PerfectScale AIエージェントスキルは、PerfectScaleのデータをエージェント型ワークフローに取り込みます。ClaudeやCodexといったAIエージェントを使って、コスト、リスク、ネームスペースなどでデータをクエリ・フィルタリングできます。その基盤となるCLIはオープンソースで、構造化されたJSON/JSONLを出力し、エージェントがすでに利用している他の運用データと組み合わせて動作するように設計されています。
InfraFit公開API
ノードレベルのデータはこれまでもUIで確認できましたが、今回、プログラムからも取得できるようになりました。InfraFit公開APIは、PerfectScaleのAPIを拡張し、ノードグループやノードタイプのデータに加え、Karpenterとビンパッキングの推奨事項も提供します。インフラレベルのコスト、無駄、使用率、最適化のインサイトを、エンジニアリングワークフローへ直接取り込めます。
まとめ
この夏を振り返ると、パターンは明らかです。可視化はアクションになり、ガードレールは強化され、PerfectScaleのインサイトはチームが働く場所でより使いやすくなりました。
すべては同じ最適化哲学に行き着きます。Kubernetesの最適化は、安全で、データドリブンで、実行可能であるべきだ、ということです。
そして、これで終わりではありません。さらなるアップデートが続きます!
🦸♀️ 専門家のサポートが必要な場合は、ぜひ私たちのチームにご相談ください。
PerfectScaleをまだご利用でない方へ: 今すぐ無料で始めて、K8s最適化への道のりをシンプルにしましょう。