


Enquanto seus clusters continuavam escalando, lançamos várias novidades e melhorias, grandes e pequenas, para ajudar você a obter melhores resultados de otimização.
Este resumo cobre algumas das principais frentes em que trabalhamos, da otimização de infraestrutura e GPU aos guardrails de segurança e à disponibilização dos insights do PerfectScale fora da plataforma.
Vamos lá.
Transformando visibilidade de infraestrutura em ação
O desperdício no nível dos nós é uma parte significativa da conta do Kubernetes, e otimizá-lo com confiança não é trivial. Neste verão, transformamos dois insights de visibilidade em recomendações claras e acionáveis.
Recomendações de otimização do Karpenter
O Karpenter é tão bom quanto a configuração dos seus NodePools — e essa configuração costuma ser definida uma única vez, no início, e raramente revisitada. Enquanto isso, os workloads mudam: novos serviços chegam com perfis de CPU e memória diferentes, os padrões de uso mudam, e famílias de instâncias que faziam sentido seis meses atrás podem estar caras demais ou difíceis de conseguir hoje. O resultado é um desperdício silencioso: nós subutilizados, falhas de scheduling e economias perdidas que só aparecem na conta da nuvem ou em um pico de pods pendentes.
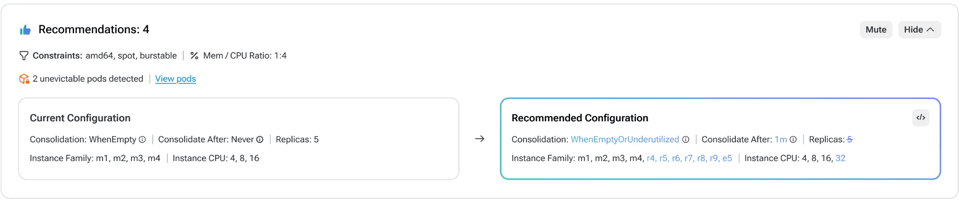
O PerfectScale agora entrega recomendações acionáveis de otimização do Karpenter, avaliando continuamente as configurações dos seus NodePools em relação ao comportamento real dos workloads. Ele sinaliza configurações restritas demais, desatualizadas ou desalinhadas — proporção CPU/memória inadequada, seleção limitada de instâncias, oportunidades de consolidação perdidas — e transforma isso em decisões embasadas: onde intensificar a consolidação, quais categorias de instância se encaixam melhor e como ajustar os limites dos NodePools. Com essa nova capacidade, o PerfectScale amplia o ciclo de otimização: workloads com right-sizing formam a base, o Karpenter é configurado com base na demanda real e a infraestrutura continua se adaptando conforme a demanda muda.
Recomendações para pods unevictable
Lá na primavera, lançamos a visibilidade de pods unevictable: workloads que ficam "presos" em um nó e o impedem de fazer scale-down, limitando silenciosamente a eficiência do seu bin-packing. A visibilidade mostrava onde estavam os bloqueios. Agora, estamos transformando esses insights em ação.
O PerfectScale agora oferece recomendações baseadas em dados para os pods sinalizados como unevictable, permitindo resolver bloqueios de scale-down em poucos cliques e destravar melhores consolidações de nós e bin-packing.
Otimização de GPU
As GPUs já representam uma grande parcela do custo de um nó com GPU, então subutilização e capacidade de GPU ociosa podem se traduzir rapidamente em um desperdício significativo. O PerfectScale já oferecia visibilidade granular de utilização e eficiência de computação, mas isso era só metade do quadro. É na memória que os workloads de IA podem realmente criar dificuldades operacionais: aloque de menos e você corre o risco de OOMs; aloque de mais "por precaução" e acaba pagando por capacidade cara que nunca foi usada.
O PerfectScale agora traz visibilidade da memória de GPU junto com a computação de GPU, dando uma visão clara de como os workloads realmente usam a memória de GPU. Isso significa que você pode dimensionar workloads de IA com base no uso real, e não em suposições, evitando capacidade desnecessária e reduzindo o risco de problemas de desempenho relacionados à memória.
Agrupamento de workloads efêmeros
Jobs do Spark, DAGs do Airflow, runners de CI: esses workloads não vivem tempo suficiente para que o right-sizing tradicional construa um panorama confiável, e cada pod de vida curta aparece como um ponto de dados isolado e ruidoso.
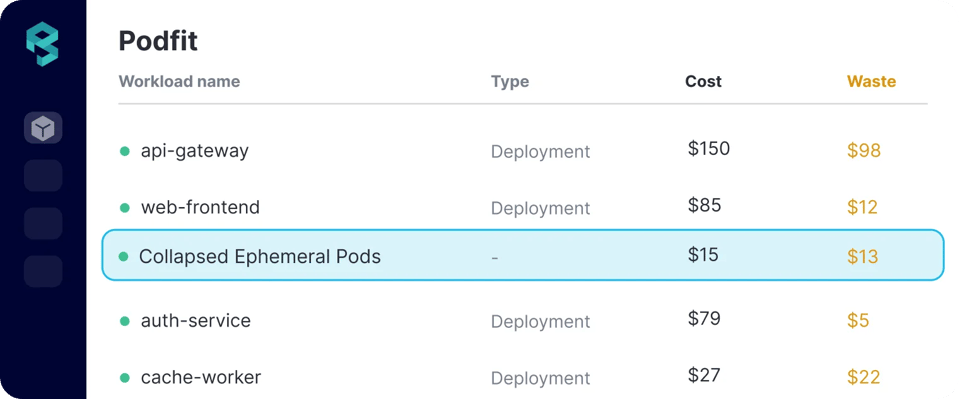
O agrupamento de workloads efêmeros consolida esses workloads de vida curta em uma única entidade, eliminando o ruído de centenas de execuções pontuais e dando aos usuários uma visão clara do que realmente importa.
Guardrails que mantêm a automação segura
A confiança na automação vem de saber exatamente o que ela vai ou não fazer. Neste verão, entregamos duas atualizações para fortalecer ainda mais a abordagem do PerfectScale, que prioriza a confiabilidade.
Detecção de CPU runaway
Nem todo pico de CPU é um problema de dimensionamento. Alguns são sintomas de um problema maior: um loop de retry travado, um bug que mantém um núcleo de CPU ocupado, entre outros. Se não forem tratados, esses padrões podem distorcer os dados de utilização e levar a automação a tomar decisões erradas.
O PerfectScale agora detecta comportamento de CPU runaway. Isso mantém as decisões de dimensionamento seguras e precisas e dá ao seu time um sinal antecipado quando algo está realmente errado, e não apenas ocupado.
Suporte completo a ResourceQuota
O ResourceQuota sempre foi uma das proteções definidas pelo sistema no PerfectScale: automação e recomendações são limitadas para nunca ultrapassar uma quota de recursos definida pelo usuário. Até agora, isso funcionava apenas em modo de redução sempre que uma recomendação se aproximava do limite.
Com o suporte completo a ResourceQuota, o PerfectScale agora aumenta os recursos dos workloads até o teto da quota quando o workload precisa, em vez de parar antes. Você continua com o mesmo teto rígido e a mesma proteção contra violações de quota, mas agora toda a faixa abaixo desse teto fica disponível para resolver casos reais de subprovisionamento.
Levando o PerfectScale além da interface
A última parte do verão não foi sobre adicionar novos insights, e sim sobre tornar os insights que você já tem mais fáceis de acessar e usar.
Skill de agente de IA do PerfectScale
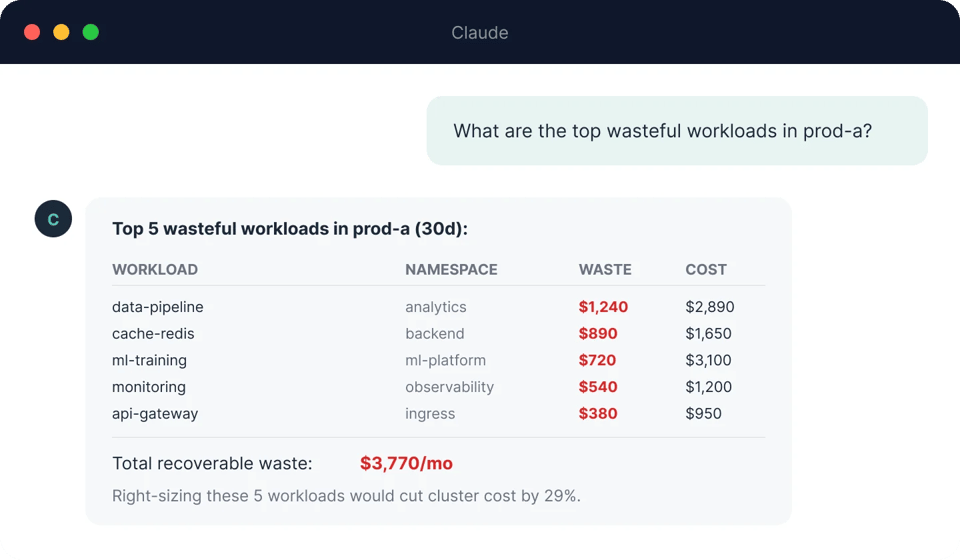
Dados de otimização de Kubernetes só são úteis se chegarem até você onde você já trabalha — e, para a maioria dos times, isso já não é apenas um dashboard. A skill de agente de IA do PerfectScale leva os dados do PerfectScale para seus workflows agênticos, permitindo usar agentes de IA como Claude ou Codex para consultar e filtrar dados por custo, risco, namespace e muito mais. A CLI por trás dela é open source, gera JSON/JSONL estruturado e foi projetada para funcionar junto com os outros dados operacionais que seus agentes já usam.
API pública do InfraFit
Os dados no nível dos nós já estavam disponíveis na interface há algum tempo. Agora, também estão disponíveis de forma programática. A API pública do InfraFit expande a API do PerfectScale para incluir dados de grupos de nós e tipos de nós, além de recomendações de Karpenter e bin-packing. Os times podem levar insights de custo, desperdício, utilização e otimização no nível da infraestrutura diretamente para seus workflows de engenharia.
Para fechar
Olhando para o verão, o padrão é claro: a visibilidade virou ação, os guardrails ficaram mais fortes e os insights do PerfectScale ficaram mais fáceis de usar onde o seu time trabalha.
Tudo volta à mesma filosofia de otimização: a otimização de Kubernetes deve ser segura, orientada por dados e acionável.
E não terminamos por aqui. Vem mais por aí!
📖 Encontre mais detalhes na nossa documentação.
🦸♀️ Agende uma conversa com nosso time se quiser ajuda especializada.
Ainda não usa o PerfectScale? Comece grátis hoje e simplifique sua jornada de otimização de K8s.