


Pendant que vos clusters continuaient de monter en charge, nous avons livré de nombreuses nouveautés et améliorations, petites et grandes, pour vous aider à obtenir de meilleurs résultats d'optimisation.
Ce récapitulatif couvre quelques-uns des chantiers clés sur lesquels nous avons travaillé, de l'optimisation de l'infrastructure et des GPU aux garde-fous de sécurité, en passant par l'accès aux insights PerfectScale en dehors de la plateforme.
C'est parti.
De la visibilité de l'infrastructure à l'action
Le gaspillage au niveau des nœuds représente une part importante de la facture Kubernetes, et l'optimiser en toute confiance n'a rien de trivial. Cet été, nous avons transformé deux insights de visibilité en recommandations claires et actionnables.
Recommandations d'optimisation Karpenter
Karpenter ne vaut que par la configuration de ses NodePools, une configuration généralement définie une seule fois, au lancement, et rarement revisitée. Pendant ce temps, les workloads évoluent : de nouveaux services arrivent avec des profils CPU/mémoire différents, les schémas d'utilisation changent, et des familles d'instances pertinentes il y a six mois peuvent aujourd'hui être trop chères ou difficiles à obtenir. Résultat : un gaspillage silencieux — nœuds sous-utilisés, échecs de scheduling et économies manquées qui ne se révèlent que dans la facture cloud ou dans un pic de pods en attente.
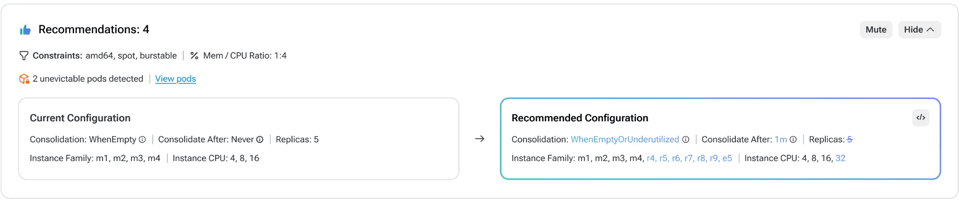
PerfectScale fournit désormais des recommandations d'optimisation Karpenter actionnables, en évaluant en continu la configuration de vos NodePools par rapport au comportement réel des workloads. La solution signale les configurations trop restrictives, obsolètes ou mal alignées — ratio CPU/mémoire inadapté, sélection d'instances limitée, opportunités de consolidation manquées — et les transforme en décisions éclairées : où renforcer la consolidation, quelles catégories d'instances conviennent mieux, et comment ajuster les limites des NodePools. Avec cette nouvelle capacité, PerfectScale étend la boucle d'optimisation : des workloads correctement dimensionnés en constituent la base, Karpenter est configuré selon la demande réelle, et l'infrastructure continue de s'adapter à mesure que la demande évolue.
Recommandations pour les pods non évictables
Au printemps, nous avions lancé la visibilité sur les pods non évictables : des workloads qui restent bloqués sur un nœud et empêchent son scale-down, limitant discrètement l'efficacité de votre bin-packing. La visibilité vous montrait où se trouvaient les blocages. Aujourd'hui, nous transformons ces insights en action.
PerfectScale fournit désormais des recommandations fondées sur les données pour les pods identifiés comme non évictables, afin de résoudre les blocages de scale-down en quelques clics et de débloquer une meilleure consolidation des nœuds et un meilleur bin-packing.
Optimisation GPU
Les GPU représentent déjà une large part du coût d'un nœud GPU : la sous-utilisation et la capacité GPU inactive peuvent donc rapidement se traduire par des dépenses gaspillées considérables. PerfectScale offrait déjà une visibilité granulaire sur l'utilisation et l'efficacité du calcul, mais ce n'était que la moitié du tableau. C'est au niveau de la mémoire que les workloads d'IA peuvent réellement poser des difficultés opérationnelles : allouez trop peu et vous risquez des OOM ; allouez trop, par précaution, et vous finissez par payer une capacité coûteuse qui n'a jamais été utilisée.
PerfectScale offre désormais une visibilité sur la mémoire GPU en complément du calcul GPU, pour une vue claire de la manière dont les workloads utilisent réellement la mémoire GPU. Vous pouvez ainsi dimensionner vos workloads d'IA sur la base de l'usage réel plutôt qu'à l'aveugle, en évitant toute capacité superflue tout en réduisant le risque de problèmes de performance liés à la mémoire.
Regroupement des workloads éphémères
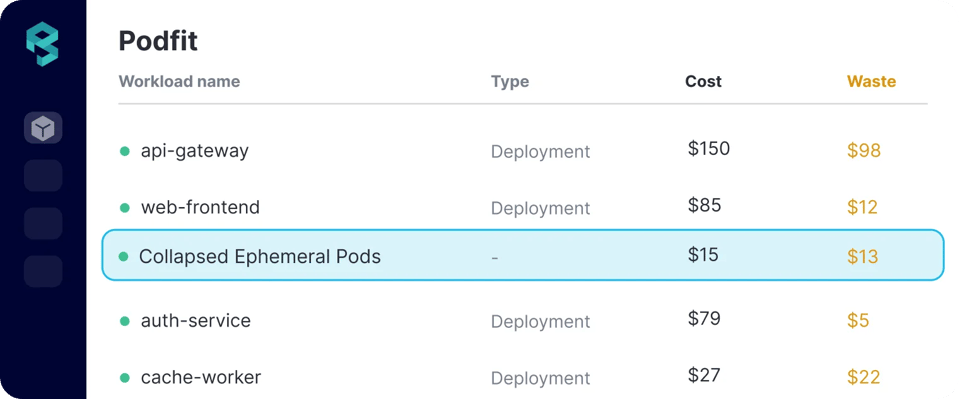
Jobs Spark, DAGs Airflow, runners CI : ces workloads ne vivent pas assez longtemps pour que le right-sizing traditionnel puisse en dresser un portrait fiable, et chaque pod éphémère apparaît comme un point de donnée isolé et bruyant.
Le regroupement des workloads éphémères consolide ces workloads de courte durée en une seule entité, éliminant le bruit de centaines d'exécutions ponctuelles et offrant aux utilisateurs une vue claire de ce qui compte vraiment.
Des garde-fous pour une automatisation sûre
La confiance dans l'automatisation vient du fait de savoir exactement ce qu'elle fera — ou ne fera pas. Cet été, nous avons livré deux mises à jour pour renforcer encore l'approche de PerfectScale, axée avant tout sur la fiabilité.
Détection des emballements CPU
Tous les pics CPU ne relèvent pas d'un problème de dimensionnement. Certains sont le symptôme d'un problème plus profond : une boucle de retry bloquée, un bug qui monopolise un cœur CPU, etc. Non détectés, ces schémas peuvent fausser les données d'utilisation et amener l'automatisation à prendre de mauvaises décisions.
PerfectScale détecte désormais les comportements d'emballement CPU. Les décisions de dimensionnement restent ainsi sûres et précises, et votre équipe reçoit un signal précoce lorsque quelque chose est réellement défaillant, et pas simplement occupé.
Prise en charge complète des ResourceQuota
ResourceQuota a toujours fait partie des garde-fous système de PerfectScale : l'automatisation et les recommandations sont plafonnées pour ne jamais dépasser un quota de ressources défini par l'utilisateur. Jusqu'à présent, ce mécanisme fonctionnait uniquement à la baisse dès qu'une recommandation approchait la limite.
Avec la prise en charge complète des ResourceQuota, PerfectScale augmente désormais les ressources d'un workload jusqu'au plafond du quota lorsque celui-ci en a besoin, au lieu de s'arrêter en chemin. Vous conservez le même plafond strict et la même protection contre les dépassements de quota, mais toute la plage sous ce plafond est maintenant disponible pour corriger un réel sous-provisionnement.
PerfectScale au-delà de l'interface
Le dernier volet de l'été ne consistait pas à ajouter de nouveaux insights, mais à rendre ceux dont vous disposez déjà plus faciles d'accès et d'utilisation.
Le skill d'agent IA PerfectScale
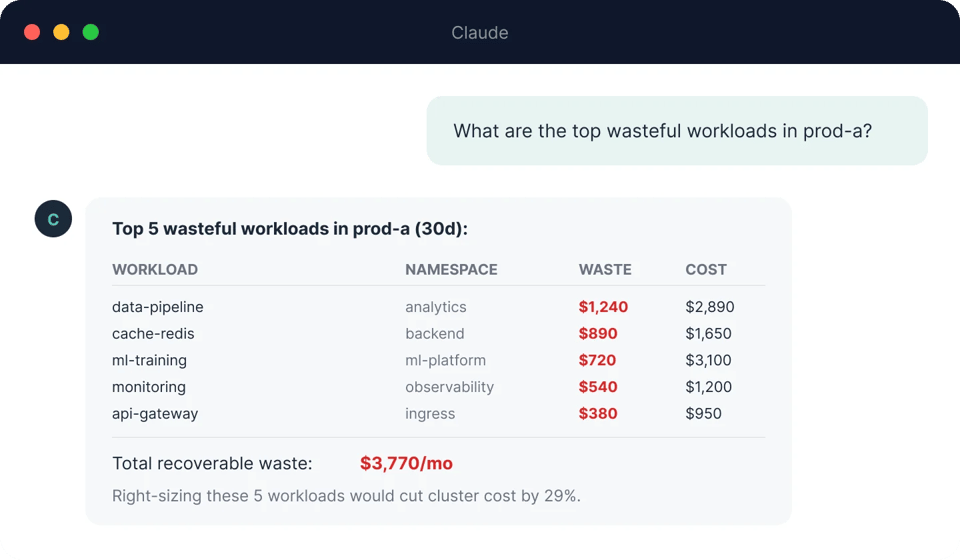
Les données d'optimisation Kubernetes ne sont utiles que si elles vous parviennent là où vous travaillez déjà — et pour la plupart des équipes, ce n'est plus seulement un dashboard. Le skill d'agent IA PerfectScale intègre les données PerfectScale à vos workflows agentiques : vous pouvez utiliser des agents IA comme Claude ou Codex pour interroger et filtrer les données par coût, risque, namespace, et plus encore. La CLI sous-jacente est open source, produit du JSON/JSONL structuré et est conçue pour fonctionner aux côtés des autres données opérationnelles que vos agents utilisent déjà.
L'API publique Infrafit
Les données au niveau des nœuds étaient disponibles dans l'interface depuis un moment. Elles le sont désormais aussi par programmation. L'API publique InfraFit étend la surface d'API de PerfectScale aux données de groupes et de types de nœuds, ainsi qu'aux recommandations Karpenter et de bin-packing. Les équipes peuvent injecter les insights de coût, de gaspillage, d'utilisation et d'optimisation au niveau de l'infrastructure directement dans leurs workflows d'engineering.
Pour conclure
Avec le recul, la tendance de l'été est claire : la visibilité s'est muée en action, les garde-fous se sont renforcés, et les insights PerfectScale sont devenus plus faciles à exploiter là où votre équipe travaille.
Tout revient à la même philosophie d'optimisation : l'optimisation Kubernetes doit être sûre, pilotée par les données et actionnable.
Et ce n'est pas fini. D'autres nouveautés arrivent !
📖 Retrouvez tous les détails dans notre documentation.
🦸♀️ Échangez avec notre équipe si vous souhaitez l'accompagnement d'un expert.
Vous n'utilisez pas encore PerfectScale ? Commencez gratuitement dès aujourd'hui et simplifiez votre optimisation K8s.