


Während Ihre Cluster weiter skaliert haben, haben wir zahlreiche große und kleine neue Funktionen und Verbesserungen ausgeliefert, mit denen Sie noch bessere Optimierungsergebnisse erzielen.
Dieser Rückblick fasst einige der wichtigsten Neuerungen zusammen – von Infrastruktur- und GPU-Optimierung über Sicherheits-Guardrails bis hin zur Verfügbarkeit von PerfectScale-Insights außerhalb der Plattform.
Legen wir los.
Aus Infrastruktur-Transparenz wird konkretes Handeln
Waste auf Node-Ebene macht einen großen Teil der Kubernetes-Rechnung aus – und ihn zuverlässig zu optimieren ist alles andere als trivial. Diesen Sommer haben wir zwei Transparenz-Insights in klare, umsetzbare Empfehlungen verwandelt.
Karpenter-Optimierungsempfehlungen
Karpenter ist nur so gut wie seine NodePool-Konfiguration – und die wird meist einmal beim Start festgelegt und danach selten wieder angefasst. Die Workloads ändern sich jedoch: Neue Services kommen mit anderen CPU-zu-Speicher-Profilen, Nutzungsmuster verschieben sich, und Instanzfamilien, die vor sechs Monaten sinnvoll waren, sind heute womöglich überteuert oder schwer verfügbar. Das Ergebnis ist stiller Waste: unterausgelastete Nodes, Scheduling-Fehler und verpasste Einsparungen, die erst in der Cloud-Rechnung oder bei einem Anstieg an Pending Pods sichtbar werden.
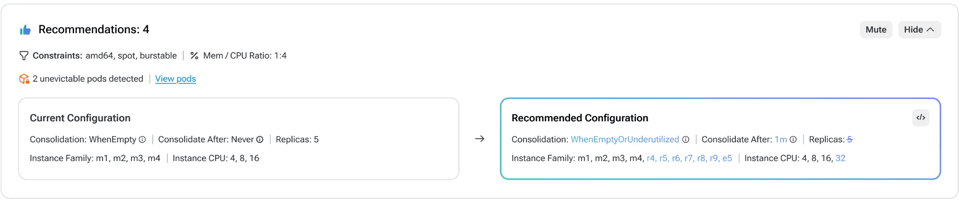
PerfectScale liefert jetzt umsetzbare Karpenter-Optimierungsempfehlungen und gleicht Ihre NodePool-Einstellungen kontinuierlich mit dem tatsächlichen Workload-Verhalten ab. Die Plattform erkennt Konfigurationen, die zu eng, veraltet oder unpassend sind – schlechtes CPU-zu-Speicher-Verhältnis, eingeschränkte Instanzauswahl, verpasste Konsolidierungschancen – und macht daraus fundierte Entscheidungen: wo sich die Konsolidierung straffen lässt, welche Instanzkategorien besser passen und wie sich NodePool-Limits anpassen lassen. Mit dieser neuen Funktion erweitert PerfectScale den Optimierungszyklus: Passgenau dimensionierte Workloads bilden die Grundlage, Karpenter wird auf Basis des realen Bedarfs konfiguriert, und die Infrastruktur passt sich laufend an, wenn sich der Bedarf ändert.
Empfehlungen für unevictable Pods
Bereits im Frühjahr haben wir Transparenz für unevictable Pods eingeführt: Workloads, die auf einem Node "feststecken" und dessen Scale-down blockieren – und so still und leise Ihre Bin-Packing-Effizienz begrenzen. Die Transparenz hat gezeigt, wo die Blocker sitzen. Jetzt machen wir aus diesen Insights konkrete Maßnahmen.
PerfectScale liefert nun datenbasierte Empfehlungen für Pods, die als unevictable markiert wurden. So beheben Sie Scale-down-Blocker mit wenigen Klicks und ermöglichen bessere Node-Konsolidierung und effizienteres Bin-Packing.
GPU-Optimierung
GPUs machen bereits einen Großteil der Kosten eines GPU-Nodes aus – Unterauslastung und ungenutzte GPU-Kapazität führen daher schnell zu erheblichen unnötigen Ausgaben. PerfectScale bot bereits granulare Transparenz zu Compute-Auslastung und -Effizienz, doch das war nur die halbe Wahrheit. Beim Speicher wird es für AI-Workloads operativ heikel: Wer zu wenig zuweist, riskiert OOMs; wer "sicherheitshalber" zu viel zuweist, bezahlt am Ende teure Kapazität, die nie genutzt wurde.
PerfectScale bietet jetzt neben GPU-Compute auch Transparenz über den GPU-Speicher und zeigt klar, wie Workloads GPU-Speicher tatsächlich nutzen. So dimensionieren Sie AI-Workloads auf Basis realer Nutzung statt Bauchgefühl, vermeiden unnötige Kapazität und reduzieren zugleich das Risiko speicherbedingter Performance-Probleme.
Gruppierung ephemerer Workloads
Spark-Jobs, Airflow-DAGs, CI-Runner: Diese Workloads leben nicht lange genug, damit klassisches Right-Sizing ein verlässliches Bild aufbauen kann – und jeder kurzlebige Pod erscheint als eigener, verrauschter, isolierter Datenpunkt.
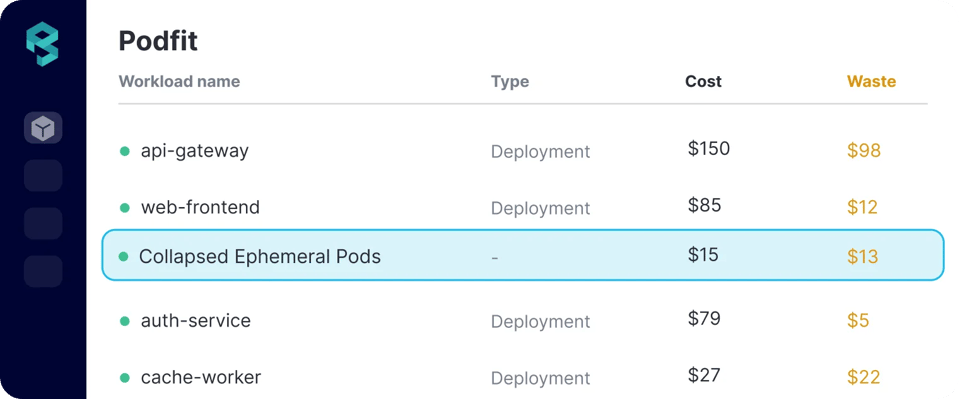
Die Gruppierung ephemerer Workloads fasst diese kurzlebigen Workloads zu einer einzigen Entität zusammen, eliminiert das Rauschen aus Hunderten von Einzelläufen und gibt Nutzern einen klaren Blick auf das, was wirklich zählt.
Guardrails, die Automatisierung sicher machen
Vertrauen in Automatisierung entsteht, wenn man genau weiß, was sie tut – und was nicht. Diesen Sommer haben wir zwei Updates ausgeliefert, die den Reliability-First-Ansatz von PerfectScale noch weiter stärken.
CPU-Runaway-Erkennung
Nicht jeder CPU-Spike ist ein Sizing-Problem. Manche sind Symptom eines größeren Problems: eine hängende Retry-Schleife, ein Bug, der einen CPU-Kern dauerhaft beschäftigt, und mehr. Bleiben solche Muster unentdeckt, können sie die Auslastungsdaten verzerren und die Automatisierung zu falschen Entscheidungen verleiten.
PerfectScale erkennt jetzt CPU-Runaway-Verhalten. So bleiben Sizing-Entscheidungen sicher und präzise – und Ihr Team erhält ein frühes Signal, wenn tatsächlich etwas schiefläuft und nicht nur viel los ist.
ResourceQuota-Unterstützung im Full-Mode
ResourceQuota gehörte schon immer zu den systemseitigen Schutzmechanismen von PerfectScale: Automatisierung und Empfehlungen werden gedeckelt, sodass sie eine benutzerdefinierte Ressourcen-Quota nie überschreiten. Bislang griff das im Decrease-only-Modus, sobald sich eine Empfehlung dem Limit näherte.
Mit der Full-Mode-Unterstützung für ResourceQuota erhöht PerfectScale die Workload-Ressourcen jetzt bis genau an die Quota-Grenze, wenn ein Workload es braucht – statt vorher zu stoppen. Die harte Obergrenze und der Schutz vor Quota-Verletzungen bleiben unverändert, aber der gesamte Spielraum unterhalb dieser Grenze steht nun zur Verfügung, um echtes Under-Provisioning zu beheben.
PerfectScale über die UI hinaus
Beim letzten Baustein des Sommers ging es nicht um neue Insights – sondern darum, die vorhandenen Insights leichter zugänglich und nutzbar zu machen.
PerfectScale AI-Agent-Skill
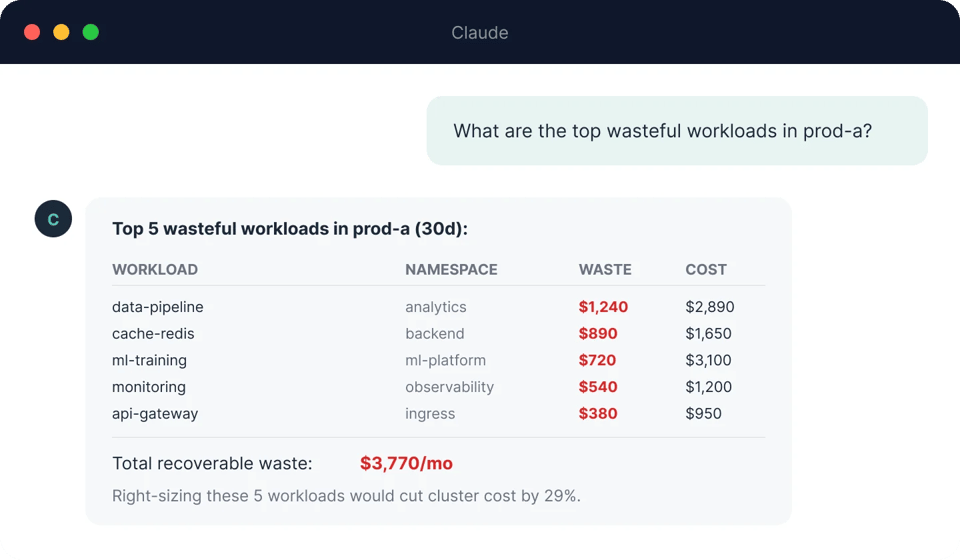
Kubernetes-Optimierungsdaten sind nur dann nützlich, wenn sie Sie dort erreichen, wo Sie ohnehin arbeiten – und das ist für die meisten Teams längst nicht mehr nur ein Dashboard. Der PerfectScale AI-Agent-Skill bringt PerfectScale-Daten in Ihre Agenten-Workflows: Sie können AI-Agenten wie Claude oder Codex nutzen, um Daten nach Kosten, Risiko, Namespace und mehr abzufragen und zu filtern. Das zugrunde liegende CLI ist Open Source, liefert strukturiertes JSON/JSONL und ist so konzipiert, dass es mit den anderen operativen Daten zusammenspielt, die Ihre Agenten bereits nutzen.
Öffentliche Infrafit API
Daten auf Node-Ebene gibt es in der UI schon länger. Jetzt sind sie auch programmatisch verfügbar. Die öffentliche InfraFit API erweitert die PerfectScale-API um Daten zu Node-Gruppen und Node-Typen sowie um Karpenter- und Bin-Packing-Empfehlungen. Teams können Insights zu Kosten, Waste, Auslastung und Optimierung auf Infrastrukturebene direkt in ihre Engineering-Workflows ziehen.
Fazit
Blickt man auf den Sommer zurück, ist das Muster klar: Aus Transparenz wurde konkretes Handeln, die Guardrails wurden stärker, und PerfectScale-Insights lassen sich jetzt einfacher dort nutzen, wo Ihr Team arbeitet.
Alles folgt derselben Optimierungsphilosophie: Kubernetes-Optimierung sollte sicher, datenbasiert und umsetzbar sein.
Und wir sind noch lange nicht fertig. Es kommt noch mehr!
📖 Mehr Details finden Sie in unserer Dokumentation.
🦸♀️ Vereinbaren Sie einen Termin mit unserem Team, wenn Sie Unterstützung von Experten wünschen.
Sie nutzen PerfectScale noch nicht? Starten Sie noch heute kostenlos und vereinfachen Sie Ihre K8s-Optimierung.