


¿Qué son los workloads de Kubernetes?
Los workloads de Kubernetes son aplicaciones, servicios o tareas que se ejecutan en un clúster de Kubernetes. Se ejecutan dentro de Pods, pero normalmente se gestionan mediante recursos de workload de nivel superior que le indican a Kubernetes cómo deben crearse, reemplazarse, escalarse, actualizarse y terminarse los Pods. Cada tipo de recurso de workload ofrece un comportamiento de ciclo de vida distinto, lo que le permite a Kubernetes admitir servicios sin estado, aplicaciones con estado, agentes a nivel de nodo, procesamiento por lotes de una sola ejecución y tareas programadas.
Recursos de workload integrados principales:
| Tipo de workload | Caso de uso principal | Características y comportamiento clave | Ejemplos comunes |
|---|---|---|---|
| Deployment | Aplicaciones sin estado de ejecución continua | Mantiene réplicas de Pods intercambiables mediante ReplicaSets y admite escalado, actualizaciones progresivas, rollback y reemplazo automático de Pods fallidos. | Aplicaciones web, APIs, microservicios |
| StatefulSet | Aplicaciones con estado que requieren identidad o almacenamiento estables | Asigna a los Pods nombres e identidades estables, admite la creación y terminación ordenadas y puede asociar cada réplica con su propio persistent volume claim. | Clústeres de PostgreSQL, bases de datos distribuidas, Kafka |
| DaemonSet | Servicios a nivel de nodo | Garantiza que un Pod se ejecute en cada nodo elegible o en nodos seleccionados, y agrega o elimina Pods automáticamente a medida que los nodos correspondientes se unen al clúster o lo abandonan. | Recolectores de logs, agentes de monitoreo, agentes de red y almacenamiento |
| Job | Tareas finitas o por lotes | Crea uno o más Pods y les da seguimiento hasta alcanzar el número requerido de ejecuciones exitosas; admite ejecución secuencial y en paralelo. | Migraciones de bases de datos, procesamiento por lotes, scripts administrativos |
| CronJob | Tareas recurrentes programadas | Crea Jobs según un calendario cron y puede controlar la concurrencia, las ejecuciones omitidas y la retención de Jobs completados. | Respaldos, generación de reportes, limpieza, sincronización periódica |
| ReplicaSet | Mantener un número fijo de réplicas idénticas de Pods | Garantiza que el número especificado de Pods coincidentes permanezca disponible y reemplaza los Pods fallidos o eliminados según sea necesario. Suele crearlo y gestionarlo un Deployment, en lugar de usarse directamente. | Gestión de réplicas subyacente a los Deployments |
Buenas prácticas para workloads:
- Define requests y limits de recursos precisos: Establece requests realistas de CPU y memoria para la programación, y usa los limits con cuidado para evitar un consumo excesivo sin provocar throttling innecesario ni eventos OOMKilled.
- Aplica right-sizing continuo a los workloads: Compara el uso histórico de CPU y memoria con los requests y limits configurados, y ajústalos a medida que cambia la demanda de la aplicación.
- Usa el controlador de workload adecuado: Usa Deployments para servicios sin estado, StatefulSets para workloads que necesitan identidad o almacenamiento estables, DaemonSets para servicios a nivel de nodo, Jobs para tareas finitas y CronJobs para trabajos programados.
- Configura probes de readiness, liveness y startup: Usa las probes para controlar cuándo un Pod puede recibir tráfico, detectar fallas irrecuperables de la aplicación y proteger los workloads de arranque lento frente a reinicios prematuros.
- Usa Pod Disruption Budgets para aplicaciones críticas: Limita cuántas réplicas pueden no estar disponibles durante interrupciones voluntarias, como los drenajes de nodos y el mantenimiento.
- Distribuye las réplicas entre nodos y zonas de disponibilidad: Usa anti-affinity de Pods o topology spread constraints para reducir el impacto de las fallas de nodos o zonas.
- Combina el autoescalado de workloads y del clúster: Coordina el HPA u otros mecanismos de autoescalado de workloads con el autoescalado de nodos para que las réplicas adicionales cuenten con capacidad suficiente en el clúster.
Este artículo forma parte de una serie sobre el scheduling en Kubernetes
En este artículo:
- Workloads de Kubernetes vs. Workload API
- Tipos de workloads de Kubernetes
- Workloads de IA y machine learning en Kubernetes
- Ciclo de vida de un workload de Kubernetes
- Monitoreo de workloads de Kubernetes
- Buenas prácticas para la gestión de workloads de Kubernetes
Workloads de Kubernetes vs. Workload API
Un workload de Kubernetes es el recurso que representa y gestiona una aplicación o tarea que se ejecuta en el clúster. Algunos ejemplos son un Deployment, StatefulSet, DaemonSet, Job o CronJob. Estos objetos describen el estado deseado del workload, como la imagen de contenedor a ejecutar, el número de réplicas, la estrategia de actualización y los requisitos de programación.
Una workload API es la interfaz de la API de Kubernetes que se usa para crear, leer, actualizar, eliminar, escalar o gestionar de cualquier otra forma esos objetos de workload. Por ejemplo, un Deployment es un objeto de workload, mientras que la API de Deployment, expuesta a través del grupo de API apps/v1 de Kubernetes, proporciona las operaciones y el esquema que usan herramientas como kubectl, los controladores y el código de las aplicaciones para manipular recursos de Deployment.
La distinción, por lo tanto, está entre el recurso que se gestiona y la API que se usa para gestionarlo. Un StatefulSet es un workload; la API de StatefulSet permite a los clientes crear o modificar objetos StatefulSet. Del mismo modo, un Job es un workload, mientras que la API de Job brinda acceso programático a los recursos de tipo Job.
Esta distinción cobra especial importancia al crear operadores, automatizaciones, herramientas de plataforma o integraciones personalizadas. Estos sistemas interactúan con Kubernetes a través de las workload APIs en lugar de manipular directamente los contenedores o pods en ejecución, lo que permite al plano de control de Kubernetes reconciliar el estado solicitado del workload.
Tipos de workloads de Kubernetes
Kubernetes ofrece varios recursos de workload para distintos requisitos de aplicación. Cada recurso gestiona pods, pero aplica reglas diferentes de programación, escalado, actualización y reemplazo de pods. Elegir el recurso correcto depende de si la aplicación es sin estado, con estado, específica de nodo o está diseñada para ejecutarse durante un tiempo limitado.
Deployments
Un Deployment gestiona aplicaciones sin estado que necesitan una o más réplicas de pods intercambiables. Defines la imagen de contenedor deseada, el número de réplicas y la configuración del pod, y el Deployment trabaja de forma continua para mantener ese estado.
Los Deployments también admiten actualizaciones controladas de la aplicación. Pueden reemplazar gradualmente los pods antiguos por nuevos durante una actualización progresiva y permiten hacer rollback a una revisión anterior si una actualización falla. Los Deployments gestionan los pods a través de ReplicaSets en lugar de crearlos directamente.
Ejemplo:
apiVersion: apps/v1kind: Deploymentspec: replicas: 3StatefulSets
Un StatefulSet gestiona aplicaciones cuyos pods necesitan identidades estables, un orden predecible o almacenamiento persistente. A diferencia de los pods de un Deployment, los pods de un StatefulSet reciben nombres persistentes como database-0 y database-1.
Los StatefulSets pueden crear y terminar pods en un orden definido y asociar cada pod con su propio persistent volume claim. Estas propiedades los hacen útiles para bases de datos, almacenes de datos distribuidos y otras aplicaciones donde las réplicas individuales no son intercambiables.
Ejemplo:
apiVersion: apps/v1kind: StatefulSetspec: serviceName: database replicas: 2DaemonSets
Un DaemonSet garantiza que un pod se ejecute en cada nodo elegible o en un grupo seleccionado de nodos. Cuando un nodo coincidente se une al clúster, Kubernetes crea el pod en ese nodo. Cuando el nodo se elimina, su pod del DaemonSet desaparece con él.
Los DaemonSets se usan habitualmente para servicios a nivel de nodo, como recolectores de logs, agentes de monitoreo, componentes de almacenamiento y software de red. Los node selectors, las reglas de afinidad y las tolerations pueden restringir qué nodos reciben los pods.
Ejemplo:
apiVersion: apps/v1kind: DaemonSetmetadata: name: node-agentJobs
Un Job ejecuta uno o más pods hasta que una tarea específica se completa con éxito. A diferencia de un Deployment, que mantiene una aplicación en ejecución continua, un Job da seguimiento a las ejecuciones exitosas y deja de crear pods una vez que se cumplen sus requisitos de finalización.
Los Jobs son útiles para tareas finitas como migraciones de bases de datos, procesamiento de datos, cálculos por lotes y operaciones administrativas. Pueden ejecutar una sola tarea o varias tareas de forma secuencial o en paralelo.
Ejemplo:
apiVersion: batch/v1kind: Jobmetadata: name: migrationCronJobs
Un CronJob crea Jobs según un calendario recurrente expresado en sintaxis cron. Kubernetes evalúa el calendario e inicia un Job cuando llega el momento de ejecución configurado.
Los CronJobs son adecuados para tareas recurrentes como respaldos, generación de reportes, operaciones de limpieza y sincronización periódica de datos. Su configuración también puede controlar las ejecuciones concurrentes, los horarios omitidos y la retención de Jobs completados.
Ejemplo:
apiVersion: batch/v1kind: CronJobspec: schedule: "0 2 * * *"ReplicaSets
Un ReplicaSet mantiene un número especificado de réplicas idénticas de pods. Si un pod falla o se elimina, el ReplicaSet crea un reemplazo. Si existen demasiados pods coincidentes, elimina los sobrantes.
Los ReplicaSets suelen gestionarse de forma indirecta a través de Deployments. Un Deployment crea nuevos ReplicaSets cuando cambia su plantilla de pod y los usa para realizar actualizaciones progresivas y rollbacks. Crear ReplicaSets directamente suele ser innecesario cuando un Deployment ofrece la gestión del ciclo de vida requerida.
Ejemplo:
apiVersion: apps/v1kind: ReplicaSetspec: replicas: 3Workloads de IA y machine learning en Kubernetes
Kubernetes puede ejecutar workloads de IA y machine learning como entrenamiento de modelos, entrenamiento distribuido, procesamiento por lotes e inferencia. Estos workloads también se ejecutan en Pods, pero suelen tener requisitos más exigentes que las aplicaciones convencionales, en particular en cuanto a aceleradores, disponibilidad de recursos y coordinación de múltiples Pods.
Requisitos de GPU y aceleradores
Los workloads de IA/ML dependen con frecuencia de GPUs u otro hardware especializado. Kubernetes admite device plugins que exponen hardware como las GPUs de AMD y NVIDIA como recursos programables.
Esto permite a los equipos:
- Solicitar GPUs para Pods específicos.
- Programar workloads solo en nodos con el hardware de aceleración adecuado.
- Usar etiquetas de nodo, selectors y afinidad para apuntar a tipos de GPU específicos.
- Gestionar la capacidad de GPU junto con otros recursos de Kubernetes como CPU y memoria.
Workloads distribuidos de IA y ML
Los trabajos de entrenamiento de gran escala pueden estar compuestos por varios Pods relacionados, como un driver y un conjunto de workers. Programar estos Pods de forma independiente puede ser ineficiente, porque el workload podría no avanzar a menos que haya suficientes workers disponibles al mismo tiempo.
La Workload API de Kubernetes aborda este tipo de requisito al permitir agrupar Pods relacionados y asignarles políticas de programación. Por ejemplo, el gang scheduling puede usar un enfoque de todo o nada en el que el grupo requerido de Pods se programa en conjunto, en lugar de permitir que solo una parte de un trabajo distribuido consuma recursos.
Ubicación de workloads para IA/ML
La ubicación también puede afectar el rendimiento de IA/ML. El entrenamiento distribuido suele implicar una comunicación intensa entre workers, por lo que Kubernetes puede usar una programación consciente del workload y de la topología para coordinar dónde se ejecutan los Pods relacionados.
Estas capacidades pueden ayudar a las organizaciones a:
- Mantener los workers distribuidos dentro de los dominios de topología adecuados.
- Reducir la latencia de comunicación entre Pods relacionados.
- Evitar trabajos de entrenamiento programados parcialmente que no pueden avanzar de forma útil.
- Asignar con mayor eficiencia los recursos escasos de GPU y aceleradores.
Ciclo de vida de un workload de Kubernetes
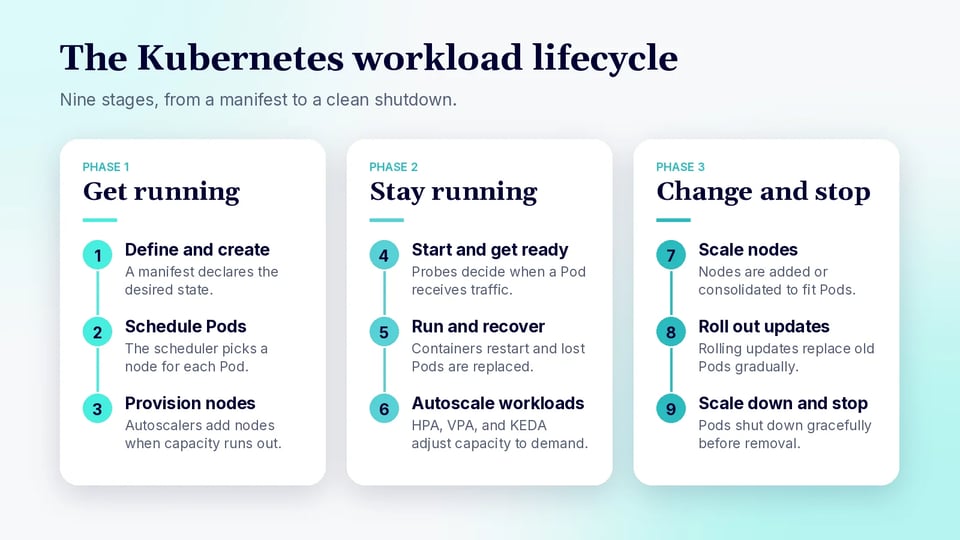
Un workload de Kubernetes atraviesa varias etapas, desde su declaración inicial hasta la programación, la ejecución, el escalado, las actualizaciones y su eventual terminación. Los entornos modernos de Kubernetes pueden automatizar buena parte de este ciclo de vida, incluido tanto el escalado a nivel de aplicación como el aprovisionamiento dinámico de los nodos subyacentes.
1. Definición y creación del workload
El ciclo de vida comienza cuando defines un recurso de workload como un Deployment, StatefulSet, DaemonSet, Job o CronJob. El manifiesto especifica el estado deseado de la aplicación, incluidas las imágenes de contenedor, el número de réplicas, los requests y limits de recursos, la configuración del entorno, los requisitos de almacenamiento y las restricciones de programación.
Cuando el recurso se envía a la API de Kubernetes, el controlador correspondiente comienza a reconciliar el estado real del clúster con el estado deseado. Por ejemplo, un controlador de Deployment crea y gestiona ReplicaSets, que a su vez mantienen los Pods requeridos.
2. Programación de Pods
Los Pods recién creados suelen comenzar sin un nodo asignado. El scheduler de Kubernetes evalúa los nodos disponibles y selecciona la ubicación adecuada en función de factores como:
- Requests de CPU y memoria
- Node selectors y afinidad de nodos
- Afinidad y anti-afinidad de Pods
- Taints y tolerations
- Topology spread constraints
- Requisitos de almacenamiento y hardware
Kubernetes también admite scheduling gates, que pueden mantener un Pod fuera del scheduler hasta que se cumplan condiciones externas. Una vez seleccionado un nodo apropiado, el Pod queda vinculado a ese nodo.
3. Aprovisionamiento de nodos cuando la capacidad es insuficiente
Si el scheduler no puede ubicar un Pod porque no hay capacidad adecuada disponible, el autoescalado de nodos puede aprovisionar infraestructura adicional.
Las versiones modernas de Kubernetes distinguen esto del autoescalado de workloads. Los autoescaladores de nodos reaccionan ante Pods no programables y aprovisionan nodos que satisfacen sus requisitos de recursos y programación. Actualmente, Kubernetes reconoce tanto a Cluster Autoscaler como a Karpenter como implementaciones patrocinadas por SIG Autoscaling.
Karpenter adopta un enfoque más dinámico en este proceso. En lugar de depender únicamente de grupos de nodos predefinidos, puede usar las restricciones de NodePool y los requisitos de los Pods pendientes para seleccionar y aprovisionar la capacidad de nodo adecuada. También gestiona operaciones más amplias del ciclo de vida de los nodos, incluidas la consolidación y el reemplazo de nodos.
4. Inicio y readiness del Pod
Cuando un Pod llega a su nodo asignado, el kubelet lo prepara e inicia sus contenedores. Las aplicaciones pueden requerir un tiempo de inicialización antes de estar listas para atender tráfico.
Kubernetes ofrece varias probes para gestionar esta etapa:
- Las startup probes determinan cuándo una aplicación se inicializó correctamente.
- Las readiness probes determinan cuándo un Pod debería recibir tráfico.
- Las liveness probes detectan contenedores que están en ejecución pero en mal estado y deben reiniciarse.
Por lo tanto, un Pod puede estar en ejecución sin considerarse todavía listo para atender solicitudes.
5. Operación en tiempo de ejecución y gestión de la salud
Una vez listos, los Pods ejecutan el workload de su aplicación mientras Kubernetes trabaja continuamente para mantener el estado declarado.
Si un contenedor falla, el kubelet puede reiniciarlo según su política de reinicio. Si un Pod gestionado por un Deployment o StatefulSet desaparece por completo, el controlador del workload puede crear un reemplazo. Las verificaciones de readiness también pueden retirar temporalmente los Pods en mal estado de los endpoints de servicio sin necesariamente reiniciarlos.
6. Autoescalado de workloads
Durante la operación, Kubernetes puede ajustar la capacidad del workload a medida que cambia la demanda. Las versiones actuales de Kubernetes admiten varios enfoques en lugar de depender de un único mecanismo de escalado.
- Horizontal Pod Autoscaler (HPA): Cambia el número de réplicas en función de métricas de CPU, memoria, personalizadas o externas.
- Vertical Pod Autoscaler (VPA): Ajusta los requests y limits de recursos según los requisitos del workload. El VPA se instala por separado y no forma parte del núcleo de la API de Kubernetes.
- Redimensionamiento vertical in-place: Kubernetes puede redimensionar los recursos de CPU y memoria asignados a los contenedores sin reemplazar necesariamente el Pod. El escalado vertical in-place de Pods es estable a partir de Kubernetes 1.35.
- KEDA: Agrega autoescalado basado en eventos a partir de fuentes como colas, sistemas de streaming, bases de datos y plataformas de monitoreo.
KEDA resulta especialmente útil cuando el escalado debe seguir eventos de la aplicación en lugar de la utilización de CPU o memoria. Puede escalar Deployments, StatefulSets y otros recursos escalables, incluido el escalado de workloads entre cero y una réplica antes de usar el HPA para seguir escalando. KEDA también puede crear y escalar Jobs de Kubernetes mediante ScaledJob.
7. Escalado y consolidación de nodos
Un aumento en las réplicas del workload no significa automáticamente que los nodos existentes tengan espacio suficiente para ejecutarlas. Por eso, el autoescalado de workloads y el de nodos suelen operar en conjunto.
Por ejemplo:
- El HPA o KEDA aumenta el número de Pods en respuesta a la demanda.
- Algunos Pods nuevos quedan sin programar porque el clúster no tiene capacidad.
- Un autoescalador de nodos aprovisiona nodos adicionales.
- El scheduler ubica los Pods pendientes en la capacidad recién disponible.
El proceso también funciona a la inversa. Cuando la demanda disminuye, el autoescalado de workloads elimina los Pods innecesarios y el autoescalado de nodos puede consolidar la infraestructura subutilizada.
Con Karpenter, la consolidación puede eliminar o reemplazar nodos vacíos o subutilizados, lo que ayuda al clúster a adaptar su infraestructura al workload en lugar de simplemente mantener grupos de nodos fijos.
8. Actualizaciones y despliegues del workload
Los workloads cambian con frecuencia a lo largo de su vida a medida que los equipos despliegan nuevas imágenes de contenedor, configuraciones, ajustes de recursos o versiones de la aplicación.
Para los Deployments, Kubernetes suele realizar una actualización progresiva: crea gradualmente Pods basados en la nueva especificación mientras termina los Pods antiguos. Esto permite que las aplicaciones sigan disponibles mientras se introduce una nueva versión. El comportamiento del despliegue se puede controlar con ajustes como maxSurge y maxUnavailable.
Los controladores continúan reconciliando el workload hasta que los Pods en ejecución coinciden con el estado deseado actualizado.
9. Reducción de escala y terminación
Los Pods pueden terminarse por eliminación manual, reducción de escala del workload, actualizaciones progresivas, interrupciones de nodo o consolidación de nodos.
Durante una terminación normal, Kubernetes le da a la aplicación la oportunidad de apagarse de forma controlada. El Pod se retira del tráfico de servicio habitual, los contenedores reciben una señal de terminación y Kubernetes espera el período de gracia configurado antes de detener por la fuerza los procesos restantes.
Cuando la demanda del workload cae, los autoescaladores pueden reducir el número de réplicas, y los autoescaladores de nodos como Karpenter pueden luego consolidar o eliminar la capacidad que ya no se necesita.
Monitoreo de workloads de Kubernetes
El monitoreo de los workloads de Kubernetes debe ir más allá de mostrar si los Pods están en ejecución. El objetivo es identificar problemas de capacidad, inestabilidad de las aplicaciones, cuellos de botella de programación y asignación ineficiente de recursos, y luego usar esos hallazgos para afinar la configuración de recursos, las políticas de autoescalado y la configuración del workload.
Utilización de CPU y memoria
Las métricas de CPU y memoria ayudan a determinar si los workloads tienen suficientes recursos para funcionar de manera confiable sin reservar más capacidad del clúster de la que necesitan.
Métricas a monitorear
- Uso de CPU: CPU realmente consumida por cada contenedor y Pod.
- Requests de CPU: CPU reservada para fines de programación.
- Limits de CPU: CPU máxima que un contenedor puede usar, cuando hay limits configurados.
- Throttling de CPU: Tiempo durante el cual se impide que un contenedor use más CPU por haber alcanzado su limit de CPU.
- Uso de memoria y working set: Memoria consumida activamente por el workload.
- Requests y limits de memoria: Memoria reservada y memoria máxima permitida para el contenedor.
- Tendencias de utilización: Patrones históricos de uso, incluidos picos, utilización sostenida y crecimiento gradual de la memoria.
Comparar la utilización real con los requests resulta especialmente útil, porque los requests influyen tanto en la programación de los Pods como en el comportamiento del Horizontal Pod Autoscaler cuando se usan métricas de utilización de recursos.
Consejos de optimización
Usa los datos de utilización para aplicar right-sizing a los requests de recursos en lugar de depender solo de estimaciones iniciales. Los workloads consistentemente subutilizados pueden tener requests innecesariamente altos, mientras que los que se acercan con regularidad a sus recursos disponibles pueden requerir más capacidad.
Considera acciones como:
- Ajustar los requests de CPU y memoria para reflejar mejor la demanda observada.
- Investigar el throttling de CPU sostenido antes de simplemente aumentar los limits.
- Aumentar los limits de memoria cuando la demanda legítima del workload supera la configuración actual.
- Investigar el crecimiento constante de la memoria en busca de posibles fugas de memoria.
- Usar HPA, VPA u otros mecanismos de autoescalado cuando los requisitos de recursos cambian significativamente con la demanda.
- Revisar percentiles de largo plazo y períodos pico en lugar de optimizar con base en una sola instantánea.
Reinicios y fallas de Pods
Las métricas de reinicios y fallas revelan una inestabilidad del workload que podría no ser evidente a partir de la fase actual del Pod. Un Pod puede reportar Running mientras uno de sus contenedores falla y se reinicia repetidamente.
Métricas y señales a monitorear
- Conteo y tasa de reinicios de contenedores
- Motivo de terminación del contenedor
- Códigos de salida
- Estados actuales y anteriores de los contenedores
- Probes de startup, readiness y liveness fallidas
- Eventos de CrashLoopBackOff
- Errores de descarga de imágenes y de configuración
- Logs de la aplicación antes y después de un reinicio
Monitorear las tasas de reinicio a lo largo del tiempo suele ser más útil que reaccionar ante un reinicio aislado. Los aumentos repentinos o los bucles de reinicio persistentes son indicadores más sólidos de un problema subyacente.
Consejos para la resolución de problemas y la optimización
La respuesta adecuada depende de por qué se reinició el contenedor. Comienza por el motivo de terminación, el estado anterior del contenedor, los eventos de Kubernetes y los logs de la aplicación.
Entre las acciones habituales se incluyen:
- Corregir fallos de la aplicación o excepciones no controladas.
- Ajustar las probes demasiado agresivas para los tiempos de arranque o de respuesta de la aplicación.
- Corregir Secrets, ConfigMaps, volúmenes o variables de entorno faltantes.
- Aumentar la memoria cuando los reinicios se deben a condiciones de OOM.
- Investigar servicios downstream no disponibles cuando las fallas coinciden con errores de dependencias.
- Revisar los despliegues recientes cuando las tasas de reinicio aumentan justo después de un rollout.
Evita tratar los reinicios únicamente como un problema de capacidad. Aumentar los recursos no resolverá fallas causadas por bugs de la aplicación, configuraciones inválidas o probes de salud mal configuradas.
Pods pendientes y no programables
Los Pods en estado Pending pueden indicar que la demanda del workload superó la capacidad disponible del clúster o que las restricciones de programación impiden que Kubernetes encuentre un nodo elegible.
Métricas y señales a monitorear
- Número de Pods en Pending
- Tiempo que los Pods permanecen en Pending
- Conteo de Pods no programables
- Eventos del scheduler y motivos de rechazo
- CPU, memoria, GPUs y otros recursos solicitados
- Capacidad disponible en los nodos elegibles
- Requisitos de afinidad de nodos y selectors
- Taints y tolerations
- Topology spread constraints
- Condiciones de programación y montaje de PersistentVolumes
La antigüedad de los Pods en Pending es particularmente útil. Las demoras breves de programación pueden ser normales, mientras que los Pods que permanecen sin programar por períodos prolongados suelen requerir intervención.
Consejos para resolver cuellos de botella de programación
Primero identifica si el problema se debe a capacidad insuficiente o a reglas de programación demasiado restrictivas.
Entre las acciones posibles se incluyen:
- Aplicar right-sizing a los requests de recursos cuando los Pods solicitan bastante más capacidad de la que realmente necesitan.
- Corregir node selectors, reglas de afinidad o tolerations que restringen la ubicación de forma innecesaria.
- Revisar los requisitos de topology spread cuando Kubernetes no encuentra suficientes nodos elegibles.
- Asegurar que los workloads de GPU u otros especializados tengan acceso a nodos compatibles.
- Agregar capacidad al clúster cuando la demanda legítima del workload supera los recursos disponibles.
- Configurar el autoescalado de nodos para que la nueva capacidad se aprovisione automáticamente.
En entornos con escalado dinámico, los Pods que siguen en Pending también deberían motivar una revisión de la capa de aprovisionamiento de nodos. Por ejemplo, Karpenter puede aprovisionar nodos según los requisitos de los Pods no programables, pero sus restricciones de NodePool deben seguir permitiendo la creación de la capacidad de instancias adecuada.
Contenedores OOMKilled
OOMKilled indica que un contenedor fue terminado por el mecanismo de gestión de falta de memoria del sistema operativo. Una causa común es un contenedor que intenta consumir más memoria de la que permite su limit configurado.
Métricas y señales a monitorear
- Motivo de terminación del contenedor: OOMKilled
- Código de salida 137
- Working set de memoria
- Requests y limits de memoria
- Consumo pico de memoria
- Utilización de memoria inmediatamente antes de la terminación
- Frecuencia de reinicios tras eventos de OOM
- Crecimiento de la memoria a largo plazo
Las métricas históricas son especialmente valiosas porque las métricas actuales del contenedor se restablecen después de un reinicio.
Consejos para prevenir OOM kills
Comienza por determinar si el uso de memoria representa una demanda legítima de la aplicación o un comportamiento anómalo.
Entre las optimizaciones posibles se incluyen:
- Aumentar los limits de memoria cuando los workloads normales requieren legítimamente más capacidad.
- Elevar los requests de memoria cuando los Pods consumen de forma consistente bastante más memoria de la solicitada.
- Investigar fugas de memoria en la aplicación cuando el uso crece de manera continua con el tiempo.
- Limitar la concurrencia o el tamaño de los lotes cuando solicitudes individuales provocan grandes picos de memoria.
- Revisar las cachés, la configuración del heap de la JVM y la configuración de memoria a nivel de aplicación.
- Usar datos históricos de utilización para establecer configuraciones de recursos realistas.
- Evaluar el autoescalado vertical cuando los requisitos de memoria cambian sustancialmente con el tiempo.
Aumentar repetidamente los limits de memoria sin identificar la causa puede ocultar problemas de la aplicación y elevar los costos de infraestructura. Por eso, los cambios de recursos deben basarse en el comportamiento del workload y el uso histórico, y no solo en los eventos de OOM.
Buenas prácticas para la gestión de workloads de Kubernetes
Define requests y limits de recursos precisos
Establece los requests de CPU y memoria con base en requisitos realistas del workload. El scheduler usa los requests al decidir dónde ubicar los pods, por lo que valores demasiado altos pueden desperdiciar capacidad del clúster o dejar pods pendientes. Los requests demasiado bajos pueden derivar en nodos sobrecargados.
Usa limits donde brinden una protección útil contra el consumo excesivo de recursos. Los limits de CPU pueden provocar throttling, mientras que superar un limit de memoria puede resultar en un contenedor OOMKilled. Prueba la configuración de limits bajo una carga representativa en lugar de elegir valores arbitrarios.
Aplica right-sizing continuo a los workloads
Los requisitos de recursos cambian a medida que evolucionan el código de la aplicación, el tráfico y los patrones de uso. Revisa con regularidad el consumo real de CPU y memoria y compáralo con los requests y limits configurados.
Usa métricas históricas en lugar de instantáneas breves al hacer right-sizing de los workloads. Ten en cuenta el uso normal, la demanda pico, los requisitos de arranque y el crecimiento esperado. Esto ayuda a reducir la capacidad ociosa sin dejar a las aplicaciones vulnerables ante picos predecibles.
Usa el controlador de workload adecuado
Elige un controlador según cómo necesita ejecutarse la aplicación. Usa Deployments para aplicaciones sin estado de ejecución continua y StatefulSets cuando las réplicas requieren identidades estables, operaciones ordenadas o almacenamiento persistente.
Los DaemonSets son apropiados para software que debe ejecutarse en nodos seleccionados, como agentes de monitoreo o de red. Usa Jobs para tareas finitas y CronJobs para ejecuciones programadas. Seleccionar el controlador correcto brinda el comportamiento de ciclo de vida adecuado sin necesidad de lógica de gestión personalizada.
Configura probes de readiness, liveness y startup
Usa readiness probes para determinar cuándo un pod puede recibir tráfico de forma segura. Una readiness probe fallida retira el pod de los endpoints normales del Service sin reiniciar su contenedor, lo que la hace adecuada para condiciones temporales como fallas de dependencias o la inicialización.
Usa liveness probes para detectar aplicaciones que no pueden recuperarse sin un reinicio. Las startup probes son útiles para aplicaciones con tiempos de inicialización largos o impredecibles, porque evitan que las verificaciones de liveness reinicien la aplicación antes de que complete el arranque.
Configura con cuidado las rutas, los umbrales, los intervalos y los timeouts de las probes. Las probes demasiado agresivas pueden generar fallas al reiniciar aplicaciones sanas pero temporalmente lentas.
Usa Pod Disruption Budgets para aplicaciones críticas
Un PodDisruptionBudget limita cuántas réplicas de una aplicación pueden no estar disponibles durante interrupciones voluntarias. Estas interrupciones pueden ocurrir durante operaciones como el drenaje de nodos, el mantenimiento del clúster o algunas actividades de autoescalado.
Configura un presupuesto usando minAvailable o maxUnavailable según los requisitos de redundancia de la aplicación. Un presupuesto no previene todos los tipos de falla, como una caída inesperada de un nodo, y no puede garantizar disponibilidad cuando una aplicación tiene muy pocas réplicas.
Evita presupuestos que hagan imposible el mantenimiento rutinario. El workload necesita suficientes réplicas sanas para que Kubernetes cumpla con el presupuesto mientras expulsa pods de forma segura.
Distribuye las réplicas entre nodos y zonas de disponibilidad
Tener varias réplicas ofrece una protección limitada si todas se ejecutan en el mismo nodo o en el mismo dominio de falla. Usa anti-affinity de pods o topology spread constraints para distribuir las réplicas entre nodos, zonas u otros límites de topología.
La distribución reduce el impacto de las fallas de nodos y de zonas de disponibilidad. También puede evitar que el mantenimiento de un solo nodo retire demasiada capacidad de la aplicación de una vez.
Equilibra los requisitos de resiliencia con la flexibilidad de programación. Las reglas de ubicación estrictas pueden dejar pods pendientes cuando el clúster no tiene suficientes nodos adecuados en la topología requerida.
Combina el autoescalado de workloads y del clúster
El autoescalado de workloads y el del clúster abordan problemas de capacidad distintos. El HorizontalPodAutoscaler puede aumentar o reducir las réplicas de la aplicación según métricas, mientras que el autoescalado a nivel de nodo puede ajustar la capacidad del clúster cuando los pods no se pueden programar con los recursos existentes.
Estos mecanismos deben configurarse en conjunto. Escalar un Deployment aporta poco si las nuevas réplicas quedan pendientes porque el clúster no tiene capacidad. Del mismo modo, agregar nodos no aumenta automáticamente las réplicas de la aplicación cuando sube la demanda.
Los requests de recursos precisos son importantes para ambos mecanismos, porque afectan las decisiones de programación y de capacidad. Define rangos de escalado razonables y monitorea el comportamiento del escalado para evitar cambios excesivos, respuestas lentas a la demanda o un uso innecesario de infraestructura.
Preguntas frecuentes
¿Qué es un workload de Kubernetes? Un workload de Kubernetes es una aplicación, servicio o tarea que se ejecuta en un clúster. Los workloads se ejecutan dentro de Pods, pero normalmente se gestionan mediante recursos de nivel superior que le indican a Kubernetes cómo crear, reemplazar, escalar, actualizar y terminar esos Pods.
¿Cuáles son los principales tipos de workloads de Kubernetes? Los recursos de workload integrados principales son los Deployments, StatefulSets, DaemonSets, Jobs, CronJobs y ReplicaSets. Cada uno responde a una necesidad distinta, como servicios sin estado, aplicaciones con estado, agentes a nivel de nodo, tareas de una sola ejecución y tareas programadas.
¿Cuál es la diferencia entre un Deployment y un StatefulSet? Un Deployment gestiona aplicaciones sin estado cuyas réplicas de Pods son intercambiables. Un StatefulSet es para aplicaciones cuyos Pods necesitan nombres estables, un orden predecible o su propio almacenamiento persistente, como las bases de datos.
¿Cuál es la diferencia entre un Job y un CronJob? Un Job ejecuta uno o más Pods hasta que una tarea finaliza con éxito, como una migración de base de datos. Un CronJob crea Jobs según un calendario recurrente escrito en sintaxis cron, lo que resulta adecuado para tareas como respaldos y generación de reportes.
¿Cuál es la diferencia entre un workload de Kubernetes y la Workload API? Un workload es el recurso que se gestiona, como un Deployment o un Job. La workload API es la interfaz de la API de Kubernetes que las herramientas, los controladores y las aplicaciones usan para crear, leer, actualizar, eliminar y escalar esos recursos.
¿Por qué mi Pod está atascado en Pending? Los Pods en Pending suelen significar que el clúster no tiene capacidad o que las reglas de programación impiden que Kubernetes encuentre un nodo elegible. Revisa los eventos del scheduler y luego los requests de recursos, los node selectors, las reglas de afinidad, las tolerations y las topology spread constraints. El autoescalado de nodos puede agregar capacidad cuando la demanda es legítima.
Cómo optimizar los workloads de Kubernetes con PerfectScale
PerfectScale by DoiT es una plataforma para optimizar los recursos en todos tus clústeres de Kubernetes. Tras un despliegue único con Helm, ofrece insights accionables y optimización autónoma en todo tu stack de K8s, desde los workloads individuales hasta los nodos subyacentes. Funciona con autoescaladores como HPA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning y Google Autopilot. Es compatible con nubes públicas como EKS, GKE y AKS, nubes privadas como OpenShift, y entornos on-premises e híbridos.
Capacidades clave de PerfectScale:
- Right-sizing autónomo de workloads: Podfit ofrece una vista granular de la salud y los costos del clúster, identifica la pérdida de recursos y los problemas de resiliencia, y propone recomendaciones basadas en datos para aplicar right-sizing a los workloads. También puedes configurar la automatización para una optimización inmediata.
- Recomendaciones de configuración de autoescalado: Recibe recomendaciones accionables para mejorar tus configuraciones de HPA y KEDA, de modo que los workloads escalen de forma eficiente con la demanda.
- Optimización de workloads efímeros y de ML: Aplica right-sizing de forma autónoma a workloads efímeros como Airflow y los Jobs de Spark, para que los entornos dinámicos se mantengan optimizados.
- Automatización consciente de las revisiones: PerfectScale evalúa cada nueva versión de código y se adapta a los requisitos cambiantes del workload, de modo que sus optimizaciones nunca contradicen tus cambios de desarrollo.
- Optimización a nivel de nodo: Infrafit brinda visibilidad de la utilización de los nodos para ayudarte a eliminar la capacidad ociosa, elegir los nodos adecuados para tus workloads y maximizar la efectividad de autoescaladores de nodos como Karpenter.
- Alertas en tiempo real priorizadas: Atiende los riesgos de resiliencia y los picos de costos con una priorización basada en el impacto, y recibe alertas en Slack, Datadog, MS Teams, PagerDuty y otras herramientas.
- Reportes de tendencias y gobernanza: Da seguimiento a las métricas de costos, pérdida y riesgo a lo largo del tiempo en clústeres, grupos de nodos, namespaces y workloads para mejorar los pronósticos y el análisis de causa raíz.