


Cosa sono i workloads Kubernetes?
I workloads Kubernetes sono applicazioni, servizi o attività eseguiti su un cluster Kubernetes. Vengono eseguiti all'interno dei Pod, ma di norma sono gestiti tramite risorse workload di livello superiore che indicano a Kubernetes come i Pod devono essere creati, sostituiti, scalati, aggiornati e terminati. Risorse workload diverse offrono comportamenti diversi del ciclo di vita, consentendo a Kubernetes di supportare servizi stateless, applicazioni stateful, agent a livello di nodo, elaborazioni batch una tantum e attività pianificate.
Risorse workload integrate principali:
| Tipo di workload | Caso d'uso principale | Caratteristiche e comportamento | Esempi comuni |
|---|---|---|---|
| Deployment | Applicazioni stateless in esecuzione continua | Mantiene repliche di Pod intercambiabili tramite i ReplicaSet e supporta scaling, rolling update, rollback e sostituzione automatica dei Pod in errore. | Applicazioni web, API, microservizi |
| StatefulSet | Applicazioni stateful che richiedono identità o storage stabili | Assegna ai Pod nomi e identità stabili, supporta creazione e terminazione ordinate e può associare a ogni replica una propria persistent volume claim. | Cluster PostgreSQL, database distribuiti, Kafka |
| DaemonSet | Servizi a livello di nodo | Garantisce l'esecuzione di un Pod su ogni nodo idoneo o su nodi selezionati e aggiunge o rimuove automaticamente i Pod quando i nodi corrispondenti entrano o escono dal cluster. | Collettori di log, agent di monitoraggio, agent di rete e storage |
| Job | Attività finite o batch | Crea uno o più Pod e li monitora fino al raggiungimento del numero richiesto di completamenti riusciti; supporta l'esecuzione sequenziale e parallela. | Migrazioni di database, elaborazione batch, script amministrativi |
| CronJob | Attività ricorrenti pianificate | Crea Job secondo una pianificazione cron e può controllare concorrenza, esecuzioni mancate e conservazione dei Job completati. | Backup, generazione di report, pulizia, sincronizzazione periodica |
| ReplicaSet | Mantenimento di un numero fisso di repliche di Pod identiche | Garantisce che il numero specificato di Pod corrispondenti rimanga disponibile, sostituendo quelli in errore o eliminati. Di solito viene creato e gestito da un Deployment anziché direttamente. | Gestione delle repliche alla base dei Deployment |
Best practice per i workloads:
- Definire request e limit delle risorse accurati: Impostare request di CPU e memoria realistiche per lo scheduling e usare i limit con attenzione per prevenire consumi eccessivi senza causare throttling inutile o eventi OOMKilled.
- Fare right-sizing continuo dei workloads: Confrontare l'utilizzo storico di CPU e memoria con request e limit configurati e adeguarli al variare della domanda applicativa.
- Usare il controller di workload appropriato: Deployment per i servizi stateless, StatefulSet per i workloads che richiedono identità o storage stabili, DaemonSet per i servizi a livello di nodo, Job per le attività finite e CronJob per le attività pianificate.
- Configurare le probe di readiness, liveness e startup: Usare le probe per controllare l'idoneità a ricevere traffico, rilevare guasti applicativi irreversibili e proteggere i workloads con avvio lento da riavvii prematuri.
- Usare i Pod Disruption Budget per le applicazioni critiche: Limitare il numero di repliche che possono risultare non disponibili durante interruzioni volontarie come drain dei nodi e manutenzione.
- Distribuire le repliche tra nodi e zone di disponibilità: Usare pod anti-affinity o topology spread constraint per ridurre l'impatto dei guasti di nodi o zone.
- Combinare l'autoscaling dei workloads e del cluster: Coordinare HPA o altri meccanismi di autoscaling dei workloads con l'autoscaling dei nodi, in modo che le repliche aggiuntive dispongano di capacità del cluster sufficiente per essere eseguite.
Questo articolo fa parte di una serie di approfondimenti sullo scheduling di Kubernetes
In questo articolo:
- Workloads Kubernetes vs. Workload API
- I tipi di workloads Kubernetes
- Workloads di AI e machine learning in Kubernetes
- Il ciclo di vita dei workloads Kubernetes
- Il monitoraggio dei workloads Kubernetes
- Best practice per la gestione dei workloads Kubernetes
Workloads Kubernetes vs. Workload API
Un workload Kubernetes è la risorsa concreta che rappresenta e gestisce un'applicazione o un'attività in esecuzione nel cluster. Ne sono esempi Deployment, StatefulSet, DaemonSet, Job o CronJob. Questi oggetti descrivono lo stato desiderato del workload, come l'immagine container da eseguire, il numero di repliche, la strategia di aggiornamento e i requisiti di scheduling.
Una workload API è l'interfaccia API di Kubernetes utilizzata per creare, leggere, aggiornare, eliminare, scalare o comunque gestire questi oggetti workload. Ad esempio, un Deployment è un oggetto workload, mentre la Deployment API, esposta tramite il gruppo API apps/v1 di Kubernetes, fornisce le operazioni e lo schema usati da strumenti come kubectl, dai controller e dal codice applicativo per manipolare le risorse Deployment.
La distinzione è quindi tra la risorsa gestita e l'API usata per gestirla. Uno StatefulSet è un workload; la StatefulSet API consente ai client di creare o modificare oggetti StatefulSet. Allo stesso modo, un Job è un workload, mentre la Job API fornisce accesso programmatico alle risorse Job.
Questa distinzione diventa particolarmente importante quando si sviluppano operator, automazioni, strumenti di piattaforma o integrazioni personalizzate. Questi sistemi interagiscono con Kubernetes tramite le workload API anziché manipolare direttamente container o pod in esecuzione, consentendo al control plane di Kubernetes di riconciliare lo stato richiesto del workload.
I tipi di workloads Kubernetes
Kubernetes offre diverse risorse workload per requisiti applicativi differenti. Ogni risorsa gestisce i pod, ma applica regole diverse per scheduling, scaling, aggiornamenti e sostituzione dei pod. La scelta della risorsa giusta dipende dal fatto che l'applicazione sia stateless, stateful, legata a un nodo specifico o progettata per un'esecuzione di durata limitata.
Deployment
Un Deployment gestisce applicazioni stateless che necessitano di una o più repliche di pod intercambiabili. Si definiscono l'immagine container desiderata, il numero di repliche e la configurazione dei pod, e il Deployment lavora continuamente per mantenere quello stato.
I Deployment supportano anche aggiornamenti applicativi controllati. Possono sostituire gradualmente i vecchi pod con quelli nuovi durante un rolling update e supportano il rollback a una revisione precedente in caso di aggiornamento fallito. I Deployment gestiscono i pod tramite i ReplicaSet anziché crearli direttamente.
Esempio:
apiVersion: apps/v1kind: Deploymentspec: replicas: 3StatefulSet
Uno StatefulSet gestisce applicazioni i cui pod necessitano di identità stabili, ordinamento prevedibile o storage persistente. A differenza dei pod di un Deployment, i pod di uno StatefulSet ricevono nomi persistenti come database-0 e database-1.
Gli StatefulSet possono creare e terminare i pod in un ordine definito e associare a ciascun pod una propria persistent volume claim. Queste proprietà li rendono utili per database, data store distribuiti e altre applicazioni in cui le singole repliche non sono intercambiabili.
Esempio:
apiVersion: apps/v1kind: StatefulSetspec: serviceName: database replicas: 2DaemonSet
Un DaemonSet garantisce che un pod venga eseguito su ogni nodo idoneo o su un gruppo selezionato di nodi. Quando un nodo corrispondente entra nel cluster, Kubernetes crea il pod su quel nodo. Quando il nodo viene rimosso, il relativo pod del DaemonSet scompare con esso.
I DaemonSet sono comunemente utilizzati per servizi a livello di nodo come collettori di log, agent di monitoraggio, componenti di storage e software di rete. Node selector, regole di affinity e toleration possono limitare i nodi che ricevono i pod.
Esempio:
apiVersion: apps/v1kind: DaemonSetmetadata: name: node-agentJob
Un Job esegue uno o più pod fino al completamento riuscito di un'attività specificata. A differenza di un Deployment, che mantiene un'applicazione in esecuzione continua, un Job tiene traccia dei completamenti riusciti e smette di creare pod una volta soddisfatti i requisiti di completamento.
I Job sono utili per attività finite come migrazioni di database, elaborazione di dati, calcoli batch e operazioni amministrative. Possono eseguire una singola attività oppure più attività in sequenza o in parallelo.
Esempio:
apiVersion: batch/v1kind: Jobmetadata: name: migrationCronJob
Un CronJob crea Job secondo una pianificazione ricorrente espressa in sintassi cron. Kubernetes valuta la pianificazione e avvia un Job quando arriva l'orario di esecuzione configurato.
I CronJob sono adatti ad attività ricorrenti come backup, generazione di report, operazioni di pulizia e sincronizzazione periodica dei dati. La loro configurazione può inoltre controllare le esecuzioni concorrenti, le pianificazioni mancate e la conservazione dei Job completati.
Esempio:
apiVersion: batch/v1kind: CronJobspec: schedule: "0 2 * * *"ReplicaSet
Un ReplicaSet mantiene un numero specificato di repliche di pod identiche. Se un pod fallisce o viene eliminato, il ReplicaSet ne crea uno sostitutivo. Se esistono troppi pod corrispondenti, rimuove quelli in eccesso.
I ReplicaSet vengono di solito gestiti indirettamente tramite i Deployment. Un Deployment crea nuovi ReplicaSet quando il suo template di pod cambia e li usa per eseguire rolling update e rollback. Creare direttamente i ReplicaSet è in genere superfluo quando un Deployment fornisce già la gestione del ciclo di vita necessaria.
Esempio:
apiVersion: apps/v1kind: ReplicaSetspec: replicas: 3Workloads di AI e machine learning in Kubernetes
Kubernetes può eseguire workloads di AI e machine learning come training di modelli, training distribuito, elaborazione batch e inferenza. Questi workloads vengono comunque eseguiti nei Pod, ma spesso hanno requisiti più esigenti rispetto alle applicazioni tradizionali, in particolare per quanto riguarda acceleratori, disponibilità delle risorse e coordinamento di più Pod.
Requisiti di GPU e acceleratori
I workloads AI/ML dipendono spesso da GPU o altro hardware specializzato. Kubernetes supporta device plugin che espongono hardware come le GPU AMD e NVIDIA sotto forma di risorse schedulabili.
Questo consente ai team di:
- Richiedere GPU per Pod specifici.
- Schedulare i workloads solo sui nodi dotati dell'hardware acceleratore appropriato.
- Usare label dei nodi, selector e affinity per indirizzare tipi specifici di GPU.
- Gestire la capacità GPU insieme ad altre risorse Kubernetes come CPU e memoria.
Workloads di AI e ML distribuiti
I job di training di grandi dimensioni possono essere composti da più Pod correlati, ad esempio un driver e un insieme di worker. Schedulare questi Pod in modo indipendente può essere inefficiente, perché il workload potrebbe non riuscire ad avanzare se un numero sufficiente di worker non è disponibile contemporaneamente.
La Workload API di Kubernetes risponde a questo tipo di requisito consentendo di raggruppare i Pod correlati e assegnare loro policy di scheduling. Ad esempio, il gang scheduling può adottare un approccio all-or-nothing in cui il gruppo di Pod richiesto viene schedulato insieme, evitando che solo una parte di un job distribuito consumi risorse.
Posizionamento dei workloads per AI/ML
Anche il posizionamento può influire sulle prestazioni AI/ML. Il training distribuito comporta spesso una comunicazione intensa tra i worker, quindi Kubernetes può usare uno scheduling workload-aware e topology-aware per coordinare dove vengono eseguiti i Pod correlati.
Queste funzionalità possono aiutare le organizzazioni a:
- Mantenere i worker distribuiti all'interno di domini topologici appropriati.
- Ridurre la latenza di comunicazione tra Pod correlati.
- Evitare job di training schedulati solo parzialmente e incapaci di fare progressi utili.
- Allocare in modo più efficiente le limitate risorse di GPU e acceleratori.
Il ciclo di vita dei workloads Kubernetes
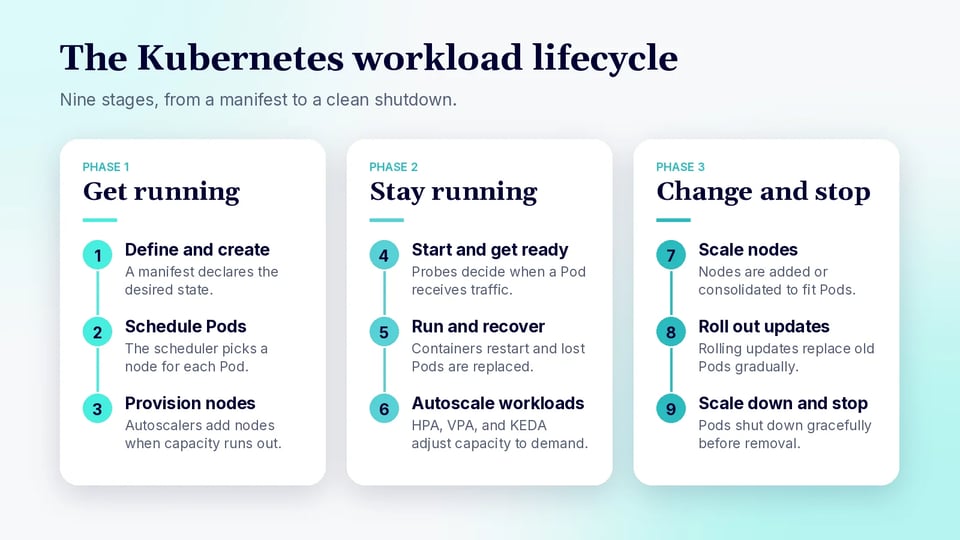
Un workload Kubernetes attraversa diverse fasi: dalla dichiarazione iniziale allo scheduling, all'esecuzione, allo scaling, agli aggiornamenti e infine alla terminazione. Gli ambienti Kubernetes moderni possono automatizzare gran parte di questo ciclo di vita, incluso sia lo scaling a livello applicativo sia il provisioning dinamico dei nodi sottostanti.
1. Definizione e creazione del workload
Il ciclo di vita inizia quando si definisce una risorsa workload come Deployment, StatefulSet, DaemonSet, Job o CronJob. Il manifest specifica lo stato desiderato dell'applicazione, incluse le immagini container, il numero di repliche, request e limit delle risorse, la configurazione dell'ambiente, i requisiti di storage e i vincoli di scheduling.
Quando la risorsa viene inviata all'API di Kubernetes, il controller pertinente inizia a riconciliare lo stato effettivo del cluster con quello desiderato. Ad esempio, un controller Deployment crea e gestisce i ReplicaSet, che a loro volta mantengono i Pod richiesti.
2. Scheduling dei Pod
I Pod appena creati iniziano in genere senza un nodo assegnato. Lo scheduler di Kubernetes valuta i nodi disponibili e seleziona il posizionamento più adatto in base a fattori come:
- Request di CPU e memoria
- Node selector e node affinity
- Pod affinity e anti-affinity
- Taint e toleration
- Topology spread constraint
- Requisiti di storage e hardware
Kubernetes supporta inoltre gli scheduling gate, che possono tenere un Pod fuori dallo scheduler finché non vengono soddisfatte condizioni esterne. Una volta selezionato un nodo appropriato, il Pod viene associato a quel nodo.
3. Provisioning dei nodi quando la capacità è insufficiente
Se lo scheduler non può posizionare un Pod perché non è disponibile capacità adeguata, l'autoscaling dei nodi può effettuare il provisioning di infrastruttura aggiuntiva.
Le versioni moderne di Kubernetes distinguono questo meccanismo dall'autoscaling dei workloads. Gli autoscaler di nodi reagiscono ai Pod non schedulabili ed effettuano il provisioning di nodi che soddisfano i loro requisiti di risorse e scheduling. Kubernetes identifica attualmente sia Cluster Autoscaler sia Karpenter come implementazioni sponsorizzate dal SIG Autoscaling.
Karpenter adotta un approccio più dinamico a questo processo. Invece di affidarsi esclusivamente a gruppi di nodi predefiniti, può usare i vincoli dei NodePool e i requisiti dei Pod in attesa per selezionare ed effettuare il provisioning della capacità di nodo più adatta. Gestisce inoltre operazioni più ampie del ciclo di vita dei nodi, inclusi consolidamento e sostituzione dei nodi.
4. Avvio e readiness dei Pod
Quando un Pod raggiunge il nodo assegnato, il kubelet lo prepara e ne avvia i container. Le applicazioni possono richiedere un tempo di inizializzazione prima di essere pronte a servire traffico.
Kubernetes fornisce diverse probe per gestire questa fase:
- Le startup probe determinano quando un'applicazione si è inizializzata correttamente.
- Le readiness probe determinano quando un Pod deve ricevere traffico.
- Le liveness probe rilevano i container in esecuzione ma non integri, che devono essere riavviati.
Un Pod può quindi essere in esecuzione senza essere ancora considerato pronto a gestire richieste.
5. Esecuzione e gestione dello stato di salute
Una volta pronti, i Pod eseguono il proprio workload applicativo mentre Kubernetes lavora continuamente per mantenere lo stato dichiarato.
Se un container fallisce, il kubelet può riavviarlo secondo la sua restart policy. Se un Pod gestito da un Deployment o uno StatefulSet scompare del tutto, il controller del workload può crearne uno sostitutivo. I controlli di readiness possono inoltre rimuovere temporaneamente i Pod non integri dagli endpoint del servizio senza necessariamente riavviarli.
6. Autoscaling dei workloads
Durante l'esecuzione, Kubernetes può adeguare la capacità dei workloads al variare della domanda. Le versioni attuali di Kubernetes supportano diversi approcci anziché affidarsi a un unico meccanismo di scaling.
- Horizontal Pod Autoscaler (HPA): modifica il numero di repliche in base a metriche di CPU, memoria, personalizzate o esterne.
- Vertical Pod Autoscaler (VPA): regola request e limit delle risorse in base ai requisiti del workload. VPA si installa separatamente e non fa parte dell'API core di Kubernetes.
- Ridimensionamento verticale in-place: Kubernetes può ridimensionare le risorse CPU e memoria assegnate ai container senza necessariamente sostituire il Pod. Lo scaling verticale in-place dei Pod è stabile a partire da Kubernetes 1.35.
- KEDA: aggiunge l'autoscaling event-driven basato su sorgenti come code, sistemi di streaming, database e piattaforme di monitoraggio.
KEDA è particolarmente utile quando lo scaling deve seguire gli eventi applicativi anziché l'utilizzo di CPU o memoria. Può scalare Deployment, StatefulSet e altre risorse scalabili, incluso lo scaling dei workloads tra zero e una replica prima di usare HPA per uno scaling ulteriore. KEDA può inoltre creare e scalare i Job di Kubernetes tramite ScaledJob.
7. Scaling e consolidamento dei nodi
Un aumento delle repliche di un workload non significa automaticamente che i nodi esistenti abbiano spazio sufficiente per eseguirle. L'autoscaling dei workloads e quello dei nodi operano quindi spesso insieme.
Ad esempio:
- HPA o KEDA aumenta il numero di Pod in risposta alla domanda.
- Alcuni nuovi Pod diventano non schedulabili perché il cluster non ha capacità.
- Un autoscaler di nodi effettua il provisioning di nodi aggiuntivi.
- Lo scheduler posiziona i Pod in attesa sulla capacità appena resa disponibile.
Il processo funziona anche al contrario. Quando la domanda diminuisce, l'autoscaling dei workloads rimuove i Pod superflui e l'autoscaling dei nodi può consolidare l'infrastruttura sottoutilizzata.
Con Karpenter, il consolidamento può rimuovere o sostituire nodi vuoti o sottoutilizzati, aiutando il cluster ad adattare la propria infrastruttura al workload invece di limitarsi a mantenere gruppi di nodi fissi.
8. Aggiornamenti e rollout dei workloads
I workloads cambiano spesso durante la loro vita, man mano che i team distribuiscono nuove immagini container, configurazioni, impostazioni delle risorse o versioni applicative.
Per i Deployment, Kubernetes esegue in genere un rolling update, creando gradualmente Pod basati sulla nuova specifica mentre termina quelli precedenti. In questo modo le applicazioni restano disponibili durante l'introduzione di una nuova versione. Il comportamento del rollout può essere controllato tramite impostazioni come maxSurge e maxUnavailable.
I controller continuano a riconciliare il workload finché i Pod in esecuzione non corrispondono allo stato desiderato aggiornato.
9. Scale-down e terminazione
I Pod possono essere terminati a causa di eliminazione manuale, scale-down del workload, rolling update, interruzione dei nodi o consolidamento dei nodi.
Durante la terminazione normale, Kubernetes offre all'applicazione l'opportunità di arrestarsi in modo controllato. Il Pod viene rimosso dal traffico di servizio ordinario, i container ricevono un segnale di terminazione e Kubernetes attende il termination grace period configurato prima di arrestare forzatamente eventuali processi rimanenti.
Quando la domanda del workload cala, gli autoscaler possono ridurre il numero di repliche e gli autoscaler di nodi come Karpenter possono successivamente consolidare o rimuovere la capacità non più necessaria.
Il monitoraggio dei workloads Kubernetes
Il monitoraggio dei workloads Kubernetes non dovrebbe limitarsi a mostrare se i Pod sono in esecuzione. L'obiettivo è identificare problemi di capacità, instabilità applicativa, colli di bottiglia nello scheduling e allocazioni inefficienti delle risorse, per poi usare questi risultati per mettere a punto le impostazioni delle risorse, le policy di autoscaling e la configurazione dei workloads.
Utilizzo di CPU e memoria
Le metriche di CPU e memoria aiutano a stabilire se i workloads dispongono di risorse sufficienti per funzionare in modo affidabile senza riservare più capacità del cluster di quanta ne serva.
Metriche da monitorare
- Utilizzo CPU: CPU effettivamente consumata da ogni container e Pod.
- Request di CPU: CPU riservata ai fini dello scheduling.
- Limit di CPU: CPU massima utilizzabile da un container, quando i limit sono configurati.
- Throttling della CPU: tempo in cui a un container viene impedito di usare CPU aggiuntiva perché ha raggiunto il proprio limit di CPU.
- Utilizzo memoria e working set: memoria attivamente consumata dal workload.
- Request e limit di memoria: memoria riservata e memoria massima consentita per il container.
- Tendenze di utilizzo: pattern di utilizzo storici, inclusi picchi, utilizzo prolungato e crescita graduale della memoria.
Confrontare l'utilizzo effettivo con le request è particolarmente utile, perché le request influenzano sia lo scheduling dei Pod sia il comportamento dell'Horizontal Pod Autoscaler quando si usano metriche di utilizzo delle risorse.
Suggerimenti per l'ottimizzazione
Usare i dati di utilizzo per fare right-sizing delle request anziché affidarsi solo alle stime iniziali. I workloads costantemente sottoutilizzati possono avere request inutilmente elevate, mentre quelli che si avvicinano regolarmente alle risorse disponibili possono richiedere più capacità.
Valutare azioni come:
- Adeguare le request di CPU e memoria per riflettere meglio la domanda osservata.
- Indagare il throttling prolungato della CPU prima di limitarsi ad aumentare i limit.
- Aumentare i limit di memoria quando una domanda legittima del workload supera le impostazioni attuali.
- Indagare la crescita costante della memoria per individuare possibili memory leak.
- Usare HPA, VPA o altri meccanismi di autoscaling quando i requisiti di risorse cambiano significativamente con la domanda.
- Esaminare percentili di lungo periodo e periodi di picco anziché ottimizzare su un singolo snapshot.
Riavvii e failure dei Pod
Le metriche di riavvio e failure rivelano instabilità dei workloads che potrebbero non essere evidenti dalla fase attuale del Pod. Un Pod può risultare Running mentre uno dei suoi container va ripetutamente in crash e si riavvia.
Metriche e segnali da monitorare
- Numero e frequenza dei riavvii dei container
- Motivo della terminazione del container
- Exit code
- Stato attuale e precedente dei container
- Startup, readiness e liveness probe fallite
- Eventi CrashLoopBackOff
- Errori di image pull e di configurazione
- Log applicativi prima e dopo un riavvio
Monitorare la frequenza dei riavvii nel tempo è in genere più utile che reagire a un riavvio isolato. Aumenti improvvisi o loop di riavvio persistenti sono indicatori più forti di un problema sottostante.
Suggerimenti per il troubleshooting e l'ottimizzazione
La risposta appropriata dipende dal motivo per cui il container si è riavviato. Iniziare dal motivo di terminazione, dallo stato precedente del container, dagli eventi Kubernetes e dai log applicativi.
Tra le azioni comuni:
- Correggere crash applicativi o eccezioni non gestite.
- Adeguare le probe troppo aggressive rispetto ai tempi di avvio o di risposta dell'applicazione.
- Correggere Secret, ConfigMap, volumi o variabili d'ambiente mancanti.
- Aumentare la memoria quando i riavvii sono causati da condizioni OOM.
- Indagare servizi a valle non disponibili quando i failure coincidono con errori di dipendenze.
- Rivedere i deployment recenti quando la frequenza dei riavvii aumenta subito dopo un rollout.
Evitare di trattare i riavvii solo come un problema di capacità. Aumentare le risorse non risolverà failure causati da bug applicativi, configurazioni non valide o health probe configurate in modo errato.
Pod Pending e non schedulabili
I Pod in stato Pending possono indicare che la domanda dei workloads ha superato la capacità disponibile del cluster o che i vincoli di scheduling impediscono a Kubernetes di trovare un nodo idoneo.
Metriche e segnali da monitorare
- Numero di Pod Pending
- Tempo in cui i Pod rimangono Pending
- Numero di Pod non schedulabili
- Eventi dello scheduler e motivi di rifiuto
- CPU, memoria, GPU e altre risorse richieste
- Capacità disponibile sui nodi idonei
- Requisiti di node affinity e selector
- Taint e toleration
- Topology spread constraint
- Condizioni di scheduling e attach dei PersistentVolume
L'età dei Pod Pending è particolarmente utile. Brevi ritardi di scheduling possono essere normali, mentre i Pod che restano non schedulabili per periodi prolungati richiedono di solito un intervento.
Suggerimenti per risolvere i colli di bottiglia nello scheduling
Identificare innanzitutto se il problema è causato da capacità insufficiente o da regole di scheduling eccessivamente restrittive.
Tra le azioni possibili:
- Fare right-sizing delle request quando i Pod richiedono una capacità sostanzialmente superiore a quella realmente necessaria.
- Correggere node selector, regole di affinity o toleration che limitano inutilmente il posizionamento.
- Rivedere i requisiti di topology spread quando Kubernetes non trova abbastanza nodi idonei.
- Garantire che i workloads GPU o altri workloads specializzati abbiano accesso a nodi compatibili.
- Aggiungere capacità al cluster quando una domanda legittima dei workloads supera le risorse disponibili.
- Configurare l'autoscaling dei nodi in modo che la nuova capacità possa essere fornita automaticamente.
Negli ambienti scalati dinamicamente, Pod Pending persistenti dovrebbero inoltre innescare una revisione del livello di provisioning dei nodi. Ad esempio, Karpenter può effettuare il provisioning di nodi in base ai requisiti dei Pod non schedulabili, ma i vincoli dei suoi NodePool devono comunque consentire la creazione di capacità di istanze adeguata.
Container OOMKilled
OOMKilled indica che un container è stato terminato dalla gestione out-of-memory del sistema operativo. Una causa comune è un container che tenta di consumare più memoria di quanta ne consenta il limit configurato.
Metriche e segnali da monitorare
- Motivo di terminazione del container: OOMKilled
- Exit code 137
- Working set della memoria
- Request e limit di memoria
- Consumo di memoria di picco
- Utilizzo della memoria immediatamente prima della terminazione
- Frequenza dei riavvii dopo eventi OOM
- Crescita della memoria a lungo termine
Le metriche storiche sono particolarmente preziose perché le metriche correnti dei container vengono azzerate dopo un riavvio del container.
Suggerimenti per prevenire gli OOM kill
Iniziare stabilendo se l'utilizzo di memoria rappresenta una domanda applicativa legittima o un comportamento anomalo.
Tra le ottimizzazioni possibili:
- Aumentare i limit di memoria quando workloads normali richiedono legittimamente più capacità.
- Alzare le request di memoria quando i Pod consumano costantemente molta più memoria di quanta ne richiedano.
- Indagare memory leak applicativi quando l'utilizzo cresce continuamente nel tempo.
- Limitare la concorrenza o le dimensioni dei batch quando singole richieste causano grandi picchi di memoria.
- Rivedere cache, impostazioni dell'heap JVM e configurazione della memoria a livello applicativo.
- Usare i dati di utilizzo storici per stabilire impostazioni delle risorse realistiche.
- Valutare l'autoscaling verticale quando i requisiti di memoria cambiano sostanzialmente nel tempo.
Aumentare ripetutamente i limit di memoria senza identificarne la causa può nascondere problemi applicativi e far crescere i costi infrastrutturali. Le modifiche alle risorse dovrebbero quindi basarsi sul comportamento del workload e sull'utilizzo storico, non solo sugli eventi OOM.
Best practice per la gestione dei workloads Kubernetes
Definire request e limit delle risorse accurati
Impostare le request di CPU e memoria in base a requisiti realistici dei workloads. Lo scheduler usa le request per decidere dove posizionare i pod, quindi valori troppo alti possono sprecare capacità del cluster o lasciare i pod in attesa. Request troppo basse possono portare a nodi sovraccarichi.
Usare i limit dove offrono una protezione utile contro il consumo eccessivo di risorse. I limit di CPU possono causare throttling, mentre il superamento di un limit di memoria può portare a un container OOMKilled. Testare le impostazioni dei limit sotto un carico rappresentativo anziché scegliere valori arbitrari.
Fare right-sizing continuo dei workloads
I requisiti di risorse cambiano con l'evolvere di codice applicativo, traffico e pattern di utilizzo. Esaminare regolarmente il consumo effettivo di CPU e memoria e confrontarlo con request e limit configurati.
Per il right-sizing dei workloads, usare metriche storiche anziché brevi snapshot. Tenere conto dell'utilizzo normale, dei picchi di domanda, dei requisiti di avvio e della crescita prevista. Questo aiuta a ridurre la capacità inutilizzata senza rendere le applicazioni vulnerabili a picchi prevedibili.
Usare il controller di workload appropriato
Scegliere il controller in base a come l'applicazione deve essere eseguita. Usare i Deployment per applicazioni stateless in esecuzione continua e gli StatefulSet quando le repliche richiedono identità stabili, operazioni ordinate o storage persistente.
I DaemonSet sono adatti al software che deve essere eseguito su nodi selezionati, come agent di monitoraggio o di rete. Usare i Job per le attività finite e i CronJob per le esecuzioni pianificate. Scegliere il controller corretto fornisce il comportamento del ciclo di vita senza richiedere logiche di gestione personalizzate.
Configurare le probe di readiness, liveness e startup
Usare le readiness probe per determinare quando un pod può ricevere traffico in sicurezza. Una readiness probe fallita rimuove il pod dagli endpoint Service ordinari senza riavviarne il container, il che la rende adatta a condizioni temporanee come failure delle dipendenze o fasi di inizializzazione.
Usare le liveness probe per rilevare applicazioni che non possono riprendersi senza un riavvio. Le startup probe sono utili per applicazioni con tempi di inizializzazione lunghi o imprevedibili, perché impediscono ai controlli di liveness di riavviare l'applicazione prima del completamento dell'avvio.
Configurare con cura percorsi, soglie, intervalli e timeout delle probe. Probe troppo aggressive possono creare failure riavviando applicazioni sane ma temporaneamente lente.
Usare i Pod Disruption Budget per le applicazioni critiche
Un PodDisruptionBudget limita quante repliche di un'applicazione possono risultare non disponibili durante le interruzioni volontarie. Queste interruzioni possono verificarsi durante operazioni come il drain dei nodi, la manutenzione del cluster o alcune attività di autoscaling.
Configurare un budget usando minAvailable o maxUnavailable in base ai requisiti di ridondanza dell'applicazione. Un budget non previene ogni tipo di guasto, come un'interruzione imprevista di un nodo, e non può garantire disponibilità quando un'applicazione ha un numero troppo basso di repliche.
Evitare budget che rendano impossibile la manutenzione ordinaria. Il workload ha bisogno di abbastanza repliche sane perché Kubernetes possa rispettare il budget durante l'eviction sicura dei pod.
Distribuire le repliche tra nodi e zone di disponibilità
Più repliche offrono una protezione limitata se vengono tutte eseguite sullo stesso nodo o nello stesso dominio di guasto. Usare pod anti-affinity o topology spread constraint per distribuire le repliche tra nodi, zone o altri confini topologici.
La distribuzione riduce l'impatto dei guasti di nodi e zone di disponibilità. Può inoltre evitare che la manutenzione su un singolo nodo rimuova in una sola volta troppa capacità applicativa.
Bilanciare i requisiti di resilienza con la flessibilità dello scheduling. Regole di posizionamento rigide possono lasciare i pod in attesa quando il cluster non dispone di abbastanza nodi adatti nella topologia richiesta.
Combinare l'autoscaling dei workloads e del cluster
L'autoscaling dei workloads e quello del cluster risolvono problemi di capacità diversi. L'HorizontalPodAutoscaler può aumentare o diminuire le repliche applicative in base alle metriche, mentre l'autoscaling a livello di nodo può adeguare la capacità del cluster quando i pod non possono essere schedulati con le risorse esistenti.
Questi meccanismi vanno configurati insieme. Scalare un Deployment serve a poco se le nuove repliche restano in attesa perché il cluster non ha capacità. Allo stesso modo, aggiungere nodi non aumenta automaticamente le repliche applicative quando la domanda cresce.
Request accurate sono importanti per entrambi i meccanismi, perché influenzano le decisioni di scheduling e di capacità. Impostare intervalli di scaling ragionevoli e monitorare il comportamento dello scaling per evitare modifiche eccessive, risposte lente alla domanda o utilizzo inutile dell'infrastruttura.
FAQ
Che cos'è un workload Kubernetes? Un workload Kubernetes è un'applicazione, un servizio o un'attività in esecuzione su un cluster. I workloads vengono eseguiti all'interno dei Pod, ma di norma sono gestiti tramite risorse di livello superiore che indicano a Kubernetes come creare, sostituire, scalare, aggiornare e terminare quei Pod.
Quali sono i principali tipi di workloads Kubernetes? Le risorse workload integrate principali sono Deployment, StatefulSet, DaemonSet, Job, CronJob e ReplicaSet. Ognuna risponde a un'esigenza diversa, come servizi stateless, applicazioni stateful, agent a livello di nodo, attività una tantum e attività pianificate.
Qual è la differenza tra un Deployment e uno StatefulSet? Un Deployment gestisce applicazioni stateless le cui repliche di Pod sono intercambiabili. Uno StatefulSet è pensato per applicazioni i cui Pod necessitano di nomi stabili, ordinamento prevedibile o storage persistente dedicato, come i database.
Qual è la differenza tra un Job e un CronJob? Un Job esegue uno o più Pod fino al completamento riuscito di un'attività, come una migrazione di database. Un CronJob crea Job secondo una pianificazione ricorrente scritta in sintassi cron, adatta ad attività come backup e generazione di report.
Qual è la differenza tra un workload Kubernetes e la Workload API? Un workload è la risorsa gestita, come un Deployment o un Job. La workload API è l'interfaccia API di Kubernetes che strumenti, controller e applicazioni usano per creare, leggere, aggiornare, eliminare e scalare quelle risorse.
Perché il mio Pod è bloccato in Pending? I Pod in Pending di solito indicano che il cluster non ha capacità o che le regole di scheduling impediscono a Kubernetes di trovare un nodo idoneo. Controllare gli eventi dello scheduler, quindi esaminare request delle risorse, node selector, regole di affinity, toleration e topology spread constraint. L'autoscaling dei nodi può aggiungere capacità quando la domanda è legittima.
Come ottimizzare i workloads Kubernetes con PerfectScale
PerfectScale by DoiT è una piattaforma per ottimizzare le risorse in ogni cluster Kubernetes. Dopo un unico deployment via Helm, offre insight concreti e attuabili e ottimizzazione autonoma su tutto lo stack K8s, dai singoli workloads ai nodi sottostanti. Funziona con autoscaler come HPA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning e Google Autopilot. Supporta cloud pubblici come EKS, GKE e AKS, cloud privati come OpenShift e ambienti on-premises e ibridi.
Funzionalità chiave di PerfectScale:
- Right-sizing autonomo dei workloads: Podfit offre una vista granulare di salute e costi del cluster, identifica risorse sprecate e problemi di resilienza e fornisce raccomandazioni data-driven per il right-sizing dei workloads. È inoltre possibile configurare l'automazione per un'ottimizzazione immediata.
- Raccomandazioni di configurazione per l'autoscaling: raccomandazioni concrete per migliorare le configurazioni di HPA e KEDA, in modo che i workloads scalino in modo efficiente con la domanda.
- Ottimizzazione dei workloads effimeri e ML: right-sizing autonomo dei workloads effimeri come Airflow e i Job Spark, per mantenere ottimizzati anche gli ambienti dinamici.
- Automazione consapevole delle revisioni: PerfectScale valuta ogni nuova release di codice e si adatta ai requisiti mutevoli dei workloads, così le sue ottimizzazioni non contraddicono mai le modifiche di sviluppo.
- Ottimizzazione a livello di nodo: Infrafit offre visibilità sull'utilizzo dei nodi per aiutare a eliminare la capacità inattiva, selezionare i nodi giusti per i workloads e massimizzare l'efficacia di autoscaler di nodi come Karpenter.
- Avvisi in tempo reale con priorità: affrontare rischi di resilienza e picchi di costo con una prioritizzazione basata sull'impatto e ricevere avvisi in Slack, Datadog, MS Teams, PagerDuty e altri strumenti.
- Report su tendenze e governance: monitorare nel tempo le metriche di costo, spreco e rischio su cluster, gruppi di nodi, namespace e workloads per migliorare previsioni e analisi delle root cause.
Scopra come PerfectScale ottimizza continuamente prestazioni e costi dei workloads Kubernetes