


Kubernetesワークロードとは
Kubernetesワークロードとは、Kubernetesクラスター上で実行されるアプリケーション、サービス、タスクのことです。ワークロードはPod内で実行されますが、通常は、Podの作成・置き換え・スケーリング・更新・終了の方法をKubernetesに指示する上位のワークロードリソースを通じて管理されます。ワークロードリソースごとにライフサイクルの挙動が異なるため、Kubernetesはステートレスなサービス、ステートフルなアプリケーション、ノードレベルのエージェント、単発のバッチ処理、スケジュール実行タスクなどに対応できます。
コアとなる組み込みワークロードリソース:
| ワークロードタイプ | 主なユースケース | 主な特徴と動作 | 代表的な例 |
|---|---|---|---|
| Deployment | ステートレスで常時稼働するアプリケーション | ReplicaSetを通じて交換可能なPodレプリカを維持し、スケーリング、ローリングアップデート、ロールバック、障害Podの自動置き換えをサポートします。 | Webアプリケーション、API、マイクロサービス |
| StatefulSet | 安定したIDやストレージを必要とするステートフルアプリケーション | Podに安定した名前とIDを付与し、順序付きの作成と終了をサポートし、各レプリカに専用の永続ボリュームクレームを関連付けられます。 | PostgreSQLクラスター、分散データベース、Kafka |
| DaemonSet | ノードレベルのサービス | 対象となるすべてのノード、または選択したノード上でPodが稼働することを保証し、条件に合致するノードのクラスターへの参加・離脱に応じてPodを自動的に追加・削除します。 | ログコレクター、監視エージェント、ネットワーク・ストレージエージェント |
| Job | 有限のタスクやバッチ処理 | 1つ以上のPodを作成し、必要な成功完了数に達するまで追跡します。逐次実行と並列実行をサポートします。 | データベースマイグレーション、バッチ処理、管理スクリプト |
| CronJob | スケジュールされた定期タスク | cronスケジュールに従ってJobを作成し、同時実行、実行漏れ、完了済みJobの保持を制御できます。 | バックアップ、レポート生成、クリーンアップ、定期同期 |
| ReplicaSet | 同一のPodレプリカを一定数維持 | 条件に合致するPodが指定した数だけ利用可能な状態を保ち、障害や削除が発生したPodを必要に応じて置き換えます。通常は直接ではなくDeploymentによって作成・管理されます。 | Deploymentの基盤となるレプリカ管理 |
ワークロードのベストプラクティス:
- 正確なリソースrequestsとlimitsを定義する: スケジューリングのために現実的なCPU・メモリのrequestsを設定し、不要なスロットリングやOOMKilledイベントを引き起こすことなく過剰な消費を防ぐため、limitsは慎重に使用します。
- ワークロードを継続的にライトサイジングする: 過去のCPU・メモリ使用量を設定済みのrequestsおよびlimitsと比較し、アプリケーションの需要の変化に応じて調整します。
- 適切なワークロードコントローラーを使用する: ステートレスなサービスにはDeployment、安定したIDやストレージが必要なワークロードにはStatefulSet、ノードレベルのサービスにはDaemonSet、有限のタスクにはJob、スケジュール実行にはCronJobを使用します。
- readiness・liveness・startupプローブを設定する: プローブを使ってトラフィック受信の可否を制御し、回復不能なアプリケーション障害を検出し、起動の遅いワークロードを早すぎる再起動から保護します。
- 重要なアプリケーションにはPod Disruption Budgetを使用する: ノードのdrainやメンテナンスなどの自発的な中断時に、利用不可となるレプリカ数を制限します。
- レプリカをノードとアベイラビリティゾーンに分散する: Podのanti-affinityやtopology spread constraintsを使用して、ノードやゾーンの障害の影響を軽減します。
- ワークロードとクラスターのオートスケーリングを組み合わせる: HPAなどのワークロードオートスケーリングとノードオートスケーリングを連携させ、追加されたレプリカを実行するのに十分なクラスター容量を確保します。
本記事は、Kubernetesスケジューリングに関する連載記事の一部です。
本記事の内容:
- KubernetesワークロードとWorkload APIの違い
- Kubernetesワークロードの種類
- KubernetesにおけるAI・機械学習ワークロード
- Kubernetesワークロードのライフサイクル
- Kubernetesワークロードの監視
- Kubernetesワークロード管理のベストプラクティス
KubernetesワークロードとWorkload APIの違い
Kubernetesワークロードとは、クラスター内で実行されるアプリケーションやタスクを表し、管理するリソースそのものです。Deployment、StatefulSet、DaemonSet、Job、CronJobなどが該当します。これらのオブジェクトは、実行するコンテナイメージ、レプリカ数、更新戦略、スケジューリング要件など、ワークロードの望ましい状態を記述します。
ワークロードAPIとは、これらのワークロードオブジェクトの作成、読み取り、更新、削除、スケーリングなどの管理に使用されるKubernetes APIインターフェースです。たとえば、Deploymentはワークロードオブジェクトであり、Kubernetesのapps/v1 APIグループを通じて公開されるDeployment APIは、kubectlなどのツール、コントローラー、アプリケーションコードがDeploymentリソースを操作するために使用する操作とスキーマを提供します。
つまり、この違いは管理対象のリソースとそれを管理するためのAPIの違いです。StatefulSetはワークロードであり、StatefulSet APIはクライアントがStatefulSetオブジェクトを作成・変更できるようにします。同様に、Jobはワークロードであり、Job APIはJobリソースへのプログラムによるアクセスを提供します。
この区別は、オペレーター、自動化、プラットフォームツール、カスタム統合を構築する際に特に重要になります。これらのシステムは、稼働中のコンテナやPodを直接操作するのではなく、ワークロードAPIを通じてKubernetesとやり取りすることで、Kubernetesコントロールプレーンが要求されたワークロードの状態を調整できるようにします。
Kubernetesワークロードの種類
Kubernetesは、さまざまなアプリケーション要件に対応する複数のワークロードリソースを提供しています。各リソースはPodを管理しますが、スケジューリング、スケーリング、更新、Podの置き換えに関するルールはそれぞれ異なります。適切なリソースの選択は、アプリケーションがステートレスか、ステートフルか、ノード固有か、あるいは有限時間の実行を想定しているかによって決まります。
Deployment
Deploymentは、1つ以上の交換可能なPodレプリカを必要とするステートレスアプリケーションを管理します。望ましいコンテナイメージ、レプリカ数、Pod構成を定義すると、Deploymentはその状態を継続的に維持するよう動作します。
Deploymentは制御されたアプリケーション更新もサポートします。ローリングアップデート中に古いPodを新しいPodへ段階的に置き換え、更新が失敗した場合には以前のリビジョンへのロールバックをサポートします。DeploymentはPodを直接作成するのではなく、ReplicaSetを通じて管理します。
例:
apiVersion: apps/v1kind: Deploymentspec: replicas: 3StatefulSet
StatefulSetは、Podに安定したID、予測可能な順序、永続ストレージが必要なアプリケーションを管理します。DeploymentのPodとは異なり、StatefulSetのPodにはdatabase-0、database-1のような永続的な名前が付与されます。
StatefulSetは、定義された順序でPodを作成・終了し、各Podに専用の永続ボリュームクレームを関連付けることができます。これらの特性により、データベース、分散データストアなど、個々のレプリカが交換可能でないアプリケーションに適しています。
例:
apiVersion: apps/v1kind: StatefulSetspec: serviceName: database replicas: 2DaemonSet
DaemonSetは、対象となるすべてのノード、または選択したノードグループ上でPodが稼働することを保証します。条件に合致するノードがクラスターに参加すると、Kubernetesはそのノード上にPodを作成します。ノードが削除されると、そのDaemonSetのPodも一緒に消えます。
DaemonSetは、ログコレクター、監視エージェント、ストレージコンポーネント、ネットワークソフトウェアなど、ノードレベルのサービスに広く使用されます。ノードセレクター、affinityルール、tolerationsにより、Podを配置するノードを制限できます。
例:
apiVersion: apps/v1kind: DaemonSetmetadata: name: node-agentJob
Jobは、指定されたタスクが正常に完了するまで1つ以上のPodを実行します。アプリケーションを継続的に稼働させるDeploymentとは異なり、Jobは成功完了数を追跡し、完了要件を満たすとPodの作成を停止します。
Jobは、データベースマイグレーション、データ処理、バッチ計算、管理操作などの有限タスクに役立ちます。単一のタスクを実行することも、複数のタスクを逐次または並列に実行することもできます。
例:
apiVersion: batch/v1kind: Jobmetadata: name: migrationCronJob
CronJobは、cron構文で表現された定期スケジュールに従ってJobを作成します。Kubernetesはスケジュールを評価し、設定された実行時刻になるとJobを開始します。
CronJobは、バックアップ、レポート生成、クリーンアップ操作、定期的なデータ同期などの繰り返しタスクに適しています。設定により、同時実行、実行漏れ、完了済みJobの保持も制御できます。
例:
apiVersion: batch/v1kind: CronJobspec: schedule: "0 2 * * *"ReplicaSet
ReplicaSetは、指定された数の同一Podレプリカを維持します。Podが障害を起こしたり削除されたりすると、ReplicaSetは代替を作成します。条件に合致するPodが多すぎる場合は、余分なPodを削除します。
ReplicaSetは通常、Deploymentを通じて間接的に管理されます。DeploymentはPodテンプレートが変更されると新しいReplicaSetを作成し、それを利用してローリングアップデートやロールバックを実行します。Deploymentが必要なライフサイクル管理を提供する場合、ReplicaSetを直接作成する必要は一般的にありません。
例:
apiVersion: apps/v1kind: ReplicaSetspec: replicas: 3KubernetesにおけるAI・機械学習ワークロード
Kubernetesは、モデルトレーニング、分散トレーニング、バッチ処理、推論といったAI・機械学習ワークロードを実行できます。これらのワークロードもPod内で実行されますが、特にアクセラレーター、リソースの可用性、複数Podの連携といった点で、従来のアプリケーションよりも要件が厳しい場合が多くあります。
GPUとアクセラレーターの要件
AI/MLワークロードは、多くの場合GPUなどの特殊なハードウェアに依存します。Kubernetesは、AMDやNVIDIAのGPUなどのハードウェアをスケジュール可能なリソースとして公開するデバイスプラグインをサポートしています。
これにより、チームは次のことが可能になります。
- 特定のPodに対してGPUをリクエストする。
- 適切なアクセラレーターハードウェアを備えたノードにのみワークロードをスケジュールする。
- ノードラベル、セレクター、affinityを使用して特定のGPUタイプを指定する。
- CPUやメモリなど他のKubernetesリソースと合わせてGPU容量を管理する。
分散AI・MLワークロード
大規模なトレーニングジョブは、ドライバーと複数のワーカーなど、関連する複数のPodで構成されることがあります。十分な数のワーカーが同時に利用可能でない限りワークロードが進行できないため、これらのPodを個別にスケジュールすると非効率になる可能性があります。
Kubernetes Workload APIは、関連するPodをグループ化してスケジューリングポリシーを割り当てられるようにすることで、この種の要件に対応します。たとえば、ギャングスケジューリングでは、分散ジョブの一部だけがリソースを消費することを許さず、必要なPodグループを一括でスケジュールするオール・オア・ナッシング方式を採用できます。
AI/MLのためのワークロード配置
配置はAI/MLのパフォーマンスにも影響します。分散トレーニングではワーカー間の通信が多く発生するため、Kubernetesはワークロードやトポロジーを考慮したスケジューリングを使用して、関連するPodの実行場所を調整できます。
これらの機能は、組織が次のことを行うのに役立ちます。
- 分散ワーカーを適切なトポロジードメイン内に維持する。
- 関連するPod間の通信レイテンシーを削減する。
- 一部のPodしかスケジュールされず処理を進められないトレーニングジョブを回避する。
- 希少なGPUやアクセラレーターリソースをより効率的に割り当てる。
Kubernetesワークロードのライフサイクル
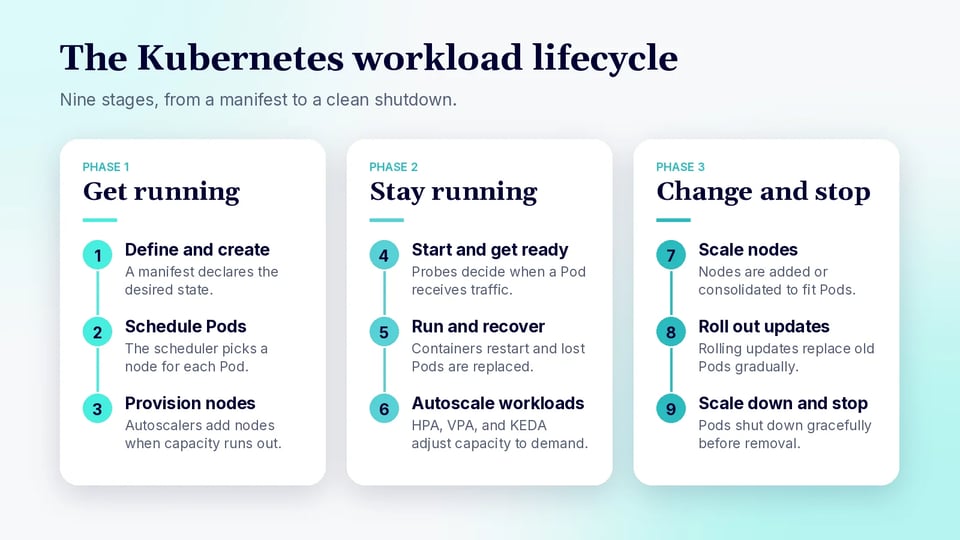
Kubernetesワークロードは、最初の宣言からスケジューリング、実行、スケーリング、更新、最終的な終了まで、複数のステージを経て進行します。最新のKubernetes環境では、アプリケーションレベルのスケーリングと基盤となるノードの動的プロビジョニングの両方を含め、このライフサイクルの多くを自動化できます。
1. ワークロードの定義と作成
ライフサイクルは、Deployment、StatefulSet、DaemonSet、Job、CronJobなどのワークロードリソースを定義することから始まります。マニフェストには、コンテナイメージ、レプリカ数、リソースのrequestsとlimits、環境設定、ストレージ要件、スケジューリング制約など、アプリケーションの望ましい状態を指定します。
リソースがKubernetes APIに送信されると、該当するコントローラーがクラスターの実際の状態と望ましい状態の調整を開始します。たとえば、DeploymentコントローラーはReplicaSetを作成・管理し、ReplicaSetが必要なPodを維持します。
2. Podのスケジューリング
新しく作成されたPodは、通常、ノードが割り当てられていない状態から始まります。Kubernetesスケジューラーは利用可能なノードを評価し、次のような要素に基づいて適切な配置先を選択します。
- CPUとメモリのrequests
- ノードセレクターとnode affinity
- Podのaffinityとanti-affinity
- Taintsとtolerations
- Topology spread constraints
- ストレージとハードウェアの要件
Kubernetesはスケジューリングゲートもサポートしており、外部条件が満たされるまでPodをスケジューラーの対象外にしておくことができます。適切なノードが選択されると、Podはそのノードにバインドされます。
3. 容量不足時のノードプロビジョニング
適切な容量がないためにスケジューラーがPodを配置できない場合、ノードオートスケーリングによって追加のインフラをプロビジョニングできます。
最新のKubernetesでは、これをワークロードオートスケーリングとは区別しています。ノードオートスケーラーはスケジュール不能なPodに反応し、そのリソース要件とスケジューリング要件を満たすノードをプロビジョニングします。Kubernetesは現在、Cluster AutoscalerとKarpenterの両方をSIG Autoscalingが支援する実装として位置付けています。
Karpenterは、このプロセスに対してより動的なアプローチを採用しています。事前定義されたノードグループだけに依存するのではなく、NodePoolの制約と保留中のPodの要件に基づいて、適切なノード容量を選択・プロビジョニングできます。また、ノードの統合や置き換えを含む、より広範なノードライフサイクル操作も管理します。
4. Podの起動と準備完了
Podが割り当てられたノードに到達すると、kubeletがPodを準備してコンテナを起動します。アプリケーションは、トラフィックを処理できるようになるまでに初期化時間を必要とする場合があります。
Kubernetesはこのステージを管理するために複数のプローブを提供しています。
- Startupプローブ:アプリケーションが正常に初期化されたタイミングを判定します。
- Readinessプローブ:Podがトラフィックを受信すべきタイミングを判定します。
- Livenessプローブ:稼働しているものの正常でなく、再起動が必要なコンテナを検出します。
したがって、Podは実行中であっても、まだリクエストを処理する準備ができていないと見なされる場合があります。
5. 実行時の運用とヘルス管理
準備が整うと、Podはアプリケーションの処理を実行し、Kubernetesは宣言された状態を維持するために継続的に動作します。
コンテナに障害が発生した場合、kubeletは再起動ポリシーに従ってコンテナを再起動できます。DeploymentやStatefulSetが管理するPodが完全に消失した場合は、ワークロードコントローラーが代替を作成できます。Readinessチェックは、必ずしも再起動することなく、異常なPodをサービスエンドポイントから一時的に除外することもできます。
6. ワークロードのオートスケーリング
運用中、Kubernetesは需要の変化に応じてワークロードの容量を調整できます。現在のKubernetesは、単一のスケーリングメカニズムに依存するのではなく、複数のアプローチをサポートしています。
- Horizontal Pod Autoscaler(HPA): CPU、メモリ、カスタムメトリクス、外部メトリクスに基づいてレプリカ数を変更します。
- Vertical Pod Autoscaler(VPA): ワークロードの要件に基づいてリソースのrequestsとlimitsを調整します。VPAはKubernetesのコアAPIの一部ではなく、別途インストールします。
- インプレースでの垂直リサイズ: Kubernetesは、必ずしもPodを置き換えることなく、コンテナに割り当てられたCPUとメモリリソースをリサイズできます。Podのインプレース垂直スケーリングはKubernetes 1.35で安定版となりました。
- KEDA: キュー、ストリーミングシステム、データベース、監視プラットフォームなどのソースに基づく、イベント駆動型のオートスケーリングを追加します。
KEDAは、CPUやメモリの使用率ではなくアプリケーションイベントに応じてスケーリングすべき場合に特に有用です。Deployment、StatefulSet、その他のスケーラブルなリソースをスケールでき、HPAでさらにスケールする前に、ワークロードをゼロと1レプリカの間でスケールすることも可能です。また、KEDAはScaledJobを通じてKubernetes Jobの作成とスケーリングも行えます。
7. ノードのスケーリングと統合
ワークロードのレプリカが増えても、既存のノードにそれらを実行する十分な余裕があるとは限りません。そのため、ワークロードオートスケーリングとノードオートスケーリングは連携して動作することがよくあります。
例:
- HPAまたはKEDAが需要に応じてPod数を増やす。
- クラスターの容量不足により、一部の新しいPodがスケジュール不能になる。
- ノードオートスケーラーが追加ノードをプロビジョニングする。
- スケジューラーが保留中のPodを新たに利用可能になった容量に配置する。
このプロセスは逆方向にも機能します。需要が減少すると、ワークロードオートスケーリングが不要なPodを削除し、ノードオートスケーリングが十分に活用されていないインフラを統合できます。
Karpenterの統合機能では、空または低稼働のノードを削除・置き換えることができ、単に固定のノードグループを維持するのではなく、クラスターのインフラをワークロードに適応させるのに役立ちます。
8. ワークロードの更新とロールアウト
チームが新しいコンテナイメージ、設定、リソース設定、アプリケーションバージョンをデプロイするのに伴い、ワークロードはそのライフサイクルの中で頻繁に変化します。
Deploymentの場合、Kubernetesは通常ローリングアップデートを実行し、新しい仕様に基づくPodを段階的に作成しながら、古いPodを終了します。これにより、新バージョンの導入中もアプリケーションの可用性を維持できます。ロールアウトの挙動は、maxSurgeやmaxUnavailableなどの設定で制御できます。
コントローラーは、稼働中のPodが更新後の望ましい状態と一致するまで、ワークロードの調整を続けます。
9. スケールダウンと終了
Podは、手動削除、ワークロードのスケールダウン、ローリングアップデート、ノードの中断、ノードの統合などにより終了することがあります。
通常の終了時、Kubernetesはアプリケーションに正常にシャットダウンする機会を与えます。Podは通常のサービストラフィックから除外され、コンテナは終了シグナルを受信し、Kubernetesは設定された終了猶予期間が経過するまで待ってから、残っているプロセスを強制停止します。
ワークロードの需要が低下すると、オートスケーラーはレプリカ数を削減でき、Karpenterなどのノードオートスケーラーは、不要になった容量をその後統合または削除できます。
Kubernetesワークロードの監視
Kubernetesワークロードの監視は、Podが稼働しているかどうかを示すだけでは不十分です。目的は、容量の問題、アプリケーションの不安定さ、スケジューリングのボトルネック、非効率なリソース割り当てを特定し、その知見をリソース設定、オートスケーリングポリシー、ワークロード構成のチューニングに活用することです。
CPUとメモリの使用率
CPUとメモリのメトリクスは、ワークロードが必要以上のクラスター容量を確保することなく、安定して動作するのに十分なリソースを持っているかどうかを判断するのに役立ちます。
監視すべきメトリクス
- CPU使用量: 各コンテナおよびPodが実際に消費したCPU。
- CPU requests: スケジューリングのために予約されたCPU。
- CPU limits: limitsが設定されている場合に、コンテナが使用できる最大CPU。
- CPUスロットリング: CPU limitに達したためにコンテナが追加のCPUを使用できなかった時間。
- メモリ使用量とワーキングセット: ワークロードが実際に消費しているメモリ。
- メモリのrequestsとlimits: コンテナに予約されたメモリと許可される最大メモリ。
- 使用率のトレンド: ピーク、持続的な使用率、緩やかなメモリ増加を含む過去の使用パターン。
実際の使用率をrequestsと比較することは特に有用です。リソース使用率メトリクスを使用する場合、requestsはPodのスケジューリングとHorizontal Pod Autoscalerの動作の両方に影響するためです。
最適化のヒント
初期の見積もりだけに頼るのではなく、使用率データを活用してリソースrequestsをライトサイジングしましょう。一貫して使用率の低いワークロードはrequestsが不必要に高い可能性があり、利用可能なリソースの上限に頻繁に近づくワークロードはより多くの容量を必要とする可能性があります。
次のようなアクションを検討してください。
- 観測された需要をより正確に反映するよう、CPUとメモリのrequestsを調整する。
- limitsを単純に引き上げる前に、持続的なCPUスロットリングを調査する。
- 正当なワークロード需要が現在の設定を超える場合は、メモリlimitsを引き上げる。
- 継続的なメモリ増加についてメモリリークの可能性を調査する。
- リソース要件が需要に応じて大きく変化する場合は、HPA、VPA、その他のオートスケーリングメカニズムを使用する。
- 単一のスナップショットを基準に最適化するのではなく、長期的なパーセンタイルとピーク期間を確認する。
Podの再起動と障害
再起動と障害のメトリクスは、現在のPodフェーズからは分かりにくいワークロードの不安定さを明らかにします。コンテナの1つが繰り返しクラッシュして再起動していても、PodはRunningと報告されることがあります。
監視すべきメトリクスとシグナル
- コンテナの再起動回数と再起動率
- コンテナの終了理由
- 終了コード
- 現在および以前のコンテナの状態
- startup、readiness、livenessプローブの失敗
- CrashLoopBackOffイベント
- イメージ取得エラーや設定エラー
- 再起動前後のアプリケーションログ
単発の再起動に反応するよりも、時間の経過に伴う再起動率を監視するほうが一般的に有用です。急激な増加や継続的な再起動ループは、根本的な問題のより強い兆候です。
トラブルシューティングと最適化のヒント
適切な対応は、コンテナが再起動した理由によって異なります。まずは終了理由、以前のコンテナ状態、Kubernetesイベント、アプリケーションログを確認しましょう。
一般的なアクションは次のとおりです。
- アプリケーションのクラッシュや未処理の例外を修正する。
- アプリケーションの起動時間や応答時間に対して厳しすぎるプローブを調整する。
- 不足しているSecret、ConfigMap、ボリューム、環境変数を修正する。
- OOM状態が再起動の原因である場合は、メモリを増やす。
- 障害が依存関係のエラーと同時に発生している場合は、利用不能なダウンストリームサービスを調査する。
- ロールアウト直後に再起動率が上昇した場合は、直近のデプロイを確認する。
再起動を単なる容量の問題として扱わないようにしましょう。リソースを増やしても、アプリケーションのバグ、無効な設定、誤って構成されたヘルスプローブに起因する障害は解決しません。
Pending状態・スケジュール不能なPod
Pending状態のPodは、ワークロードの需要が利用可能なクラスター容量を超えていること、またはスケジューリング制約によってKubernetesが適格なノードを見つけられないことを示している可能性があります。
監視すべきメトリクスとシグナル
- Pending状態のPod数
- PodがPendingのままである時間
- スケジュール不能なPod数
- スケジューラーのイベントと拒否理由
- リクエストされたCPU、メモリ、GPU、その他のリソース
- 適格なノード上の利用可能な容量
- Node affinityとセレクターの要件
- Taintsとtolerations
- Topology spread constraints
- PersistentVolumeのスケジューリングとアタッチの状態
Pending状態のPodの経過時間は特に有用です。短時間のスケジューリング遅延は正常な場合もありますが、長期間スケジュール不能なままのPodには通常、対応が必要です。
スケジューリングのボトルネックを解消するヒント
まず、問題の原因が容量不足なのか、過度に厳しいスケジューリングルールなのかを特定しましょう。
考えられるアクションは次のとおりです。
- Podが実際に必要とする量を大幅に上回る容量をリクエストしている場合は、リソースrequestsをライトサイジングする。
- 配置を不必要に制限しているノードセレクター、affinityルール、tolerationsを修正する。
- Kubernetesが十分な適格ノードを見つけられない場合は、topology spreadの要件を見直す。
- GPUなどの特殊なワークロードが互換性のあるノードにアクセスできることを確認する。
- 正当なワークロード需要が利用可能なリソースを超えている場合は、クラスター容量を追加する。
- 新しい容量が自動的にプロビジョニングされるよう、ノードオートスケーリングを設定する。
動的にスケールする環境でPendingが続くPodがある場合は、ノードプロビジョニングレイヤーの見直しも行うべきです。たとえば、Karpenterはスケジュール不能なPodの要件に基づいてノードをプロビジョニングできますが、そのNodePool制約が適切なインスタンス容量の作成を許可している必要があります。
OOMKilledコンテナ
OOMKilledは、オペレーティングシステムのメモリ不足(out-of-memory)処理によってコンテナが終了させられたことを示します。よくある原因の1つは、コンテナが設定されたlimitを超えるメモリを消費しようとしたことです。
監視すべきメトリクスとシグナル
- コンテナの終了理由:OOMKilled
- 終了コード137
- メモリのワーキングセット
- メモリのrequestsとlimits
- ピーク時のメモリ消費量
- 終了直前のメモリ使用率
- OOMイベント後の再起動頻度
- 長期的なメモリ増加
コンテナの再起動後は現在のコンテナメトリクスがリセットされるため、過去のメトリクスは特に貴重です。
OOM Killを防ぐヒント
まず、メモリ使用量が正当なアプリケーション需要によるものか、異常な動作によるものかを判断しましょう。
考えられる最適化は次のとおりです。
- 通常のワークロードが正当な理由でより多くの容量を必要とする場合は、メモリlimitsを引き上げる。
- Podがリクエスト量を大幅に上回るメモリを一貫して消費している場合は、メモリrequestsを引き上げる。
- 使用量が時間とともに増え続ける場合は、アプリケーションのメモリリークを調査する。
- 個々のリクエストが大きなメモリスパイクを引き起こす場合は、同時実行数やバッチサイズを制限する。
- キャッシュ、JVMヒープ設定、アプリケーションレベルのメモリ設定を見直す。
- 過去の使用率データを活用して現実的なリソース設定を確立する。
- メモリ要件が時間とともに大きく変化する場合は、垂直オートスケーリングを検討する。
原因を特定せずにメモリlimitsを繰り返し引き上げると、アプリケーションの問題が隠れ、インフラコストが増加する可能性があります。したがって、リソースの変更は、OOMイベントだけでなく、ワークロードの挙動と過去の使用状況に基づいて行うべきです。
Kubernetesワークロード管理のベストプラクティス
正確なリソースrequestsとlimitsを定義する
現実的なワークロード要件に基づいてCPUとメモリのrequestsを設定しましょう。スケジューラーはPodの配置先を決定する際にrequestsを使用するため、値が高すぎるとクラスター容量の無駄やPodの保留が発生し、低すぎるとノードの過負荷につながる可能性があります。
過剰なリソース消費に対する有効な保護となる場面でlimitsを使用しましょう。CPU limitsはスロットリングを引き起こす可能性があり、メモリlimitを超えるとコンテナがOOMKilledになる場合があります。任意の値を選ぶのではなく、代表的な負荷の下でlimit設定をテストしてください。
ワークロードを継続的にライトサイジングする
リソース要件は、アプリケーションコード、トラフィック、使用パターンの変化とともに変わります。実際のCPUとメモリの消費量を定期的に確認し、設定済みのrequestsおよびlimitsと比較しましょう。
ワークロードのライトサイジングには、短時間のスナップショットではなく過去のメトリクスを使用しましょう。通常の使用量、ピーク時の需要、起動時の要件、想定される成長を考慮します。これにより、予測可能なスパイクに対してアプリケーションを脆弱にすることなく、未使用の容量を削減できます。
適切なワークロードコントローラーを使用する
アプリケーションの実行方法に基づいてコントローラーを選択しましょう。ステートレスで常時稼働するアプリケーションにはDeploymentを、レプリカに安定したID、順序付き操作、永続ストレージが必要な場合はStatefulSetを使用します。
DaemonSetは、監視エージェントやネットワークエージェントなど、選択したノード上で稼働する必要があるソフトウェアに適しています。有限タスクにはJob、スケジュール実行にはCronJobを使用します。正しいコントローラーを選択すれば、独自の管理ロジックを作らなくてもライフサイクル動作が得られます。
Readiness・Liveness・Startupプローブを設定する
Readinessプローブを使用して、Podが安全にトラフィックを受信できるタイミングを判定しましょう。Readinessプローブが失敗すると、コンテナを再起動することなくPodが通常のServiceエンドポイントから除外されるため、依存関係の障害や初期化などの一時的な状態に適しています。
再起動なしでは回復できないアプリケーションを検出するにはLivenessプローブを使用します。Startupプローブは、起動完了前にlivenessチェックがアプリケーションを再起動してしまうことを防ぐため、初期化に時間がかかる、または初期化時間が予測しにくいアプリケーションに有用です。
プローブのパス、しきい値、間隔、タイムアウトは慎重に設定しましょう。過度に厳しいプローブは、正常だが一時的に遅いアプリケーションを再起動させ、障害を生み出す可能性があります。
重要なアプリケーションにはPod Disruption Budgetを使用する
PodDisruptionBudgetは、自発的な中断時に利用不可にできるアプリケーションのレプリカ数を制限します。これらの中断は、ノードのdrain、クラスターメンテナンス、一部のオートスケーリング操作などで発生する可能性があります。
アプリケーションの冗長性要件に応じて、minAvailableまたはmaxUnavailableを使用してバジェットを設定しましょう。バジェットは予期しないノード障害などすべての種類の障害を防げるわけではなく、アプリケーションのレプリカが少なすぎる場合に可用性を提供することもできません。
日常的なメンテナンスを不可能にしてしまうバジェットは避けましょう。KubernetesがPodを安全に退避しながらバジェットを満たせるだけの、十分な数の正常なレプリカがワークロードに必要です。
レプリカをノードとアベイラビリティゾーンに分散する
複数のレプリカがあっても、すべてが同じノードや同じ障害ドメイン上で稼働していては、十分な保護になりません。Podのanti-affinityやtopology spread constraintsを使用して、レプリカをノード、ゾーン、その他のトポロジー境界に分散させましょう。
分散により、ノードやアベイラビリティゾーンの障害による影響が軽減されます。また、単一ノードのメンテナンスによってアプリケーション容量が一度に失われすぎることも防げます。
回復力の要件とスケジューリングの柔軟性のバランスを取りましょう。配置ルールが厳しすぎると、必要なトポロジー全体に十分な適格ノードがない場合にPodが保留のままになる可能性があります。
ワークロードとクラスターのオートスケーリングを組み合わせる
ワークロードオートスケーリングとクラスターオートスケーリングは、異なる容量の問題に対応します。HorizontalPodAutoscalerはメトリクスに応じてアプリケーションのレプリカを増減でき、ノードレベルのオートスケーリングは既存リソースでPodをスケジュールできない場合にクラスター容量を調整できます。
これらのメカニズムは一緒に設定すべきです。クラスターに容量がなく新しいレプリカが保留のままでは、Deploymentをスケールしてもほとんど意味がありません。同様に、ノードを追加しても、需要の増加時にアプリケーションのレプリカが自動的に増えるわけではありません。
正確なリソースrequestsは、スケジューリングと容量の決定に影響するため、両方のメカニズムにとって重要です。適切なスケーリング範囲を設定し、スケーリング動作を監視して、過剰な変動、需要への遅い応答、不要なインフラ使用を避けましょう。
よくある質問
Kubernetesワークロードとは何ですか? Kubernetesワークロードとは、クラスター上で実行されるアプリケーション、サービス、タスクのことです。ワークロードはPod内で実行されますが、通常は、Podの作成・置き換え・スケーリング・更新・終了の方法をKubernetesに指示する上位リソースを通じて管理されます。
Kubernetesワークロードの主な種類は何ですか? コアとなる組み込みワークロードリソースは、Deployment、StatefulSet、DaemonSet、Job、CronJob、ReplicaSetです。それぞれ、ステートレスなサービス、ステートフルなアプリケーション、ノードレベルのエージェント、単発タスク、スケジュール実行タスクといった異なるニーズに対応します。
DeploymentとStatefulSetの違いは何ですか? Deploymentは、Podレプリカが交換可能なステートレスアプリケーションを管理します。StatefulSetは、データベースなど、Podに安定した名前、予測可能な順序、専用の永続ストレージが必要なアプリケーション向けです。
JobとCronJobの違いは何ですか? Jobは、データベースマイグレーションなど、タスクが正常に完了するまで1つ以上のPodを実行します。CronJobは、cron構文で記述された定期スケジュールに従ってJobを作成するもので、バックアップやレポート生成などのタスクに適しています。
KubernetesワークロードとWorkload APIの違いは何ですか? ワークロードは、DeploymentやJobなど、管理対象となるリソースです。ワークロードAPIは、ツール、コントローラー、アプリケーションがこれらのリソースの作成、読み取り、更新、削除、スケーリングに使用するKubernetes APIインターフェースです。
PodがPendingのまま進まないのはなぜですか? Pending状態のPodは通常、クラスターの容量不足か、スケジューリングルールによってKubernetesが適格なノードを見つけられないことを意味します。スケジューラーのイベントを確認した上で、リソースrequests、ノードセレクター、affinityルール、tolerations、topology spread constraintsを確認してください。需要が正当な場合は、ノードオートスケーリングで容量を追加できます。
PerfectScaleでKubernetesワークロードを最適化する方法
PerfectScale by DoiTは、すべてのKubernetesクラスターのリソースを最適化するプラットフォームです。一度Helmでデプロイするだけで、個々のワークロードから基盤となるノードまで、K8sスタック全体にわたって実用的なインサイトと自律的な最適化を提供します。HPA、Karpenter、Cluster Autoscaler、EKS Auto Mode、Fargate、Node Auto Provisioning、Google Autopilotなどのオートスケーラーと連携します。EKS、GKE、AKSなどのパブリッククラウド、OpenShiftなどのプライベートクラウド、さらにオンプレミスおよびハイブリッド環境をサポートします。
PerfectScaleの主な機能:
- 自律的なワークロードのライトサイジング: Podfitはクラスターの健全性とコストを詳細に可視化し、無駄なリソースや回復力の問題を特定し、ワークロードをライトサイジングするためのデータドリブンな推奨事項を提供します。自動化を設定して即時に最適化することも可能です。
- オートスケーリング設定の推奨: HPAやKEDAの設定を改善するための実用的な推奨事項を取得し、需要に応じてワークロードを効率的にスケールさせます。
- 一時的ワークロードとMLワークロードの最適化: AirflowやSpark Jobsなどの一時的なワークロードを自律的にライトサイジングし、動的な環境を常に最適化された状態に保ちます。
- リビジョンを認識する自動化: PerfectScaleは新しいコードリリースのたびに評価を行い、変化するワークロード要件に適応するため、最適化が開発上の変更と矛盾することはありません。
- ノードレベルの最適化: Infrafitはノード使用率を可視化し、アイドル容量の排除、ワークロードに適したノードの選択、Karpenterなどのノードオートスケーラーの効果の最大化を支援します。
- 優先順位付けされたリアルタイムアラート: 影響度に基づく優先順位付けで回復力リスクとコスト急増に対処し、Slack、Datadog、MS Teams、PagerDutyなどのツールでアラートを受信できます。
- トレンドとガバナンスのレポート: クラスター、ノードグループ、namespace、ワークロードにわたるコスト、無駄、リスクのメトリクスを経時的に追跡し、予測と根本原因分析を改善します。