


O que são workloads no Kubernetes?
Workloads do Kubernetes são aplicações, serviços ou tarefas executados em um cluster Kubernetes. Eles rodam dentro de Pods, mas normalmente são gerenciados por meio de recursos de workload de nível superior, que indicam ao Kubernetes como os Pods devem ser criados, substituídos, escalados, atualizados e encerrados. Diferentes recursos de workload oferecem comportamentos de ciclo de vida distintos, permitindo que o Kubernetes dê suporte a serviços stateless, aplicações stateful, agentes no nível do nó, processamento em lote pontual e tarefas agendadas.
Principais recursos de workload nativos:
| Tipo de workload | Caso de uso principal | Principais características e comportamento | Exemplos comuns |
|---|---|---|---|
| Deployment | Aplicações stateless em execução contínua | Mantém réplicas de Pods intercambiáveis por meio de ReplicaSets e oferece suporte a escalonamento, rolling updates, rollback e substituição automática de Pods com falha. | Aplicações web, APIs, microsserviços |
| StatefulSet | Aplicações stateful que exigem identidade ou armazenamento estáveis | Dá aos Pods nomes e identidades estáveis, oferece suporte a criação e encerramento ordenados e pode associar cada réplica ao seu próprio persistent volume claim. | Clusters PostgreSQL, bancos de dados distribuídos, Kafka |
| DaemonSet | Serviços no nível do nó | Garante que um Pod seja executado em todos os nós elegíveis ou em nós selecionados e adiciona ou remove Pods automaticamente conforme nós correspondentes entram ou saem do cluster. | Coletores de logs, agentes de monitoramento, agentes de rede e armazenamento |
| Job | Tarefas finitas ou em lote | Cria um ou mais Pods e os acompanha até atingir o número necessário de conclusões bem-sucedidas; oferece suporte a execução sequencial e paralela. | Migrações de banco de dados, processamento em lote, scripts administrativos |
| CronJob | Tarefas recorrentes agendadas | Cria Jobs de acordo com um agendamento cron e pode controlar concorrência, execuções perdidas e retenção de Jobs concluídos. | Backups, geração de relatórios, limpeza, sincronização periódica |
| ReplicaSet | Manutenção de um número fixo de réplicas de Pods idênticos | Garante que o número especificado de Pods correspondentes permaneça disponível, substituindo Pods com falha ou excluídos conforme necessário. Normalmente é criado e gerenciado por um Deployment, e não diretamente. | Gerenciamento de réplicas por trás dos Deployments |
Boas práticas para workloads:
- Defina requests e limits de recursos precisos: configure requests de CPU e memória realistas para o agendamento e use limits com cuidado para evitar consumo excessivo sem causar throttling desnecessário ou eventos OOMKilled.
- Faça right-sizing contínuo dos workloads: compare o uso histórico de CPU e memória com os requests e limits configurados e ajuste-os conforme a demanda da aplicação muda.
- Use o controlador de workload adequado: use Deployments para serviços stateless, StatefulSets para workloads que precisam de identidade ou armazenamento estáveis, DaemonSets para serviços no nível do nó, Jobs para tarefas finitas e CronJobs para trabalhos agendados.
- Configure probes de readiness, liveness e startup: use probes para controlar a elegibilidade de tráfego, detectar falhas irrecuperáveis da aplicação e proteger workloads de inicialização lenta contra reinícios prematuros.
- Use Pod Disruption Budgets para aplicações críticas: limite quantas réplicas podem ficar indisponíveis durante interrupções voluntárias, como drenagem de nós e manutenção.
- Distribua réplicas entre nós e zonas de disponibilidade: use pod anti-affinity ou topology spread constraints para reduzir o impacto de falhas de nó ou de zona.
- Combine autoescalonamento de workloads e do cluster: coordene o HPA ou outros mecanismos de autoescalonamento de workloads com o autoescalonamento de nós, para que as réplicas adicionais tenham capacidade suficiente no cluster para rodar.
Este artigo faz parte de uma série sobre agendamento no Kubernetes
Neste artigo:
- Workloads do Kubernetes vs. Workload API
- Tipos de workloads no Kubernetes
- Workloads de IA e machine learning no Kubernetes
- Ciclo de vida dos workloads no Kubernetes
- Monitoramento de workloads no Kubernetes
- Boas práticas de gerenciamento de workloads no Kubernetes
Workloads do Kubernetes vs. Workload API
Um workload do Kubernetes é o recurso que, de fato, representa e gerencia uma aplicação ou tarefa em execução no cluster. Exemplos incluem um Deployment, StatefulSet, DaemonSet, Job ou CronJob. Esses objetos descrevem o estado desejado do workload, como a imagem de contêiner a ser executada, o número de réplicas, a estratégia de atualização e os requisitos de agendamento.
Uma workload API é a interface da API do Kubernetes usada para criar, ler, atualizar, excluir, escalar ou gerenciar de outra forma esses objetos de workload. Por exemplo, um Deployment é um objeto de workload, enquanto a API de Deployment, exposta pelo grupo de API apps/v1 do Kubernetes, fornece as operações e o schema usados por ferramentas como kubectl, controladores e código de aplicação para manipular recursos de Deployment.
A distinção, portanto, é entre o recurso que está sendo gerenciado e a API usada para gerenciá-lo. Um StatefulSet é um workload; a API de StatefulSet permite que clientes criem ou modifiquem objetos StatefulSet. Da mesma forma, um Job é um workload, enquanto a API de Job oferece acesso programático aos recursos de Job.
Essa distinção se torna especialmente importante na construção de operators, automações, ferramentas de plataforma ou integrações personalizadas. Esses sistemas interagem com o Kubernetes por meio das workload APIs, em vez de manipular diretamente contêineres ou pods em execução, permitindo que o control plane do Kubernetes reconcilie o estado de workload solicitado.
Tipos de workloads no Kubernetes
O Kubernetes oferece vários recursos de workload para diferentes requisitos de aplicação. Cada recurso gerencia pods, mas usa regras diferentes para agendamento, escalonamento, atualizações e substituição de pods. A escolha do recurso certo depende de a aplicação ser stateless, stateful, específica de nó ou projetada para rodar por tempo limitado.
Deployments
Um Deployment gerencia aplicações stateless que precisam de uma ou mais réplicas de pods intercambiáveis. Você define a imagem de contêiner desejada, o número de réplicas e a configuração do pod, e o Deployment trabalha continuamente para manter esse estado.
Deployments também oferecem suporte a atualizações controladas da aplicação. Eles podem substituir gradualmente pods antigos por novos durante um rolling update e permitem rollback para uma revisão anterior se uma atualização falhar. Deployments gerenciam pods por meio de ReplicaSets, em vez de criá-los diretamente.
Exemplo:
apiVersion: apps/v1kind: Deploymentspec: replicas: 3StatefulSets
Um StatefulSet gerencia aplicações cujos pods precisam de identidades estáveis, ordenação previsível ou armazenamento persistente. Diferentemente dos pods de um Deployment, os pods de um StatefulSet recebem nomes persistentes, como database-0 e database-1.
StatefulSets podem criar e encerrar pods em uma ordem definida e associar cada pod ao seu próprio persistent volume claim. Essas propriedades os tornam úteis para bancos de dados, armazenamentos de dados distribuídos e outras aplicações em que as réplicas individuais não são intercambiáveis.
Exemplo:
apiVersion: apps/v1kind: StatefulSetspec: serviceName: database replicas: 2DaemonSets
Um DaemonSet garante que um pod seja executado em todos os nós elegíveis ou em um grupo selecionado de nós. Quando um nó correspondente entra no cluster, o Kubernetes cria o pod nesse nó. Quando o nó é removido, seu pod do DaemonSet desaparece junto.
DaemonSets são comumente usados para serviços no nível do nó, como coletores de logs, agentes de monitoramento, componentes de armazenamento e software de rede. Node selectors, regras de afinidade e tolerations podem restringir quais nós recebem os pods.
Exemplo:
apiVersion: apps/v1kind: DaemonSetmetadata: name: node-agentJobs
Um Job executa um ou mais pods até que uma tarefa especificada seja concluída com sucesso. Diferentemente de um Deployment, que mantém uma aplicação rodando continuamente, um Job acompanha as conclusões bem-sucedidas e para de criar pods assim que seus requisitos de conclusão são atendidos.
Jobs são úteis para tarefas finitas, como migrações de banco de dados, processamento de dados, cálculos em lote e operações administrativas. Eles podem executar uma única tarefa ou várias tarefas de forma sequencial ou paralela.
Exemplo:
apiVersion: batch/v1kind: Jobmetadata: name: migrationCronJobs
Um CronJob cria Jobs de acordo com um agendamento recorrente expresso em sintaxe cron. O Kubernetes avalia o agendamento e inicia um Job quando chega o horário de execução configurado.
CronJobs são adequados para tarefas recorrentes, como backups, geração de relatórios, operações de limpeza e sincronização periódica de dados. Sua configuração também pode controlar execuções simultâneas, agendamentos perdidos e a retenção de Jobs concluídos.
Exemplo:
apiVersion: batch/v1kind: CronJobspec: schedule: "0 2 * * *"ReplicaSets
Um ReplicaSet mantém um número especificado de réplicas de pods idênticos. Se um pod falha ou é excluído, o ReplicaSet cria um substituto. Se existirem pods correspondentes em excesso, ele remove os pods excedentes.
ReplicaSets normalmente são gerenciados de forma indireta por meio de Deployments. Um Deployment cria novos ReplicaSets quando seu template de pod muda e os usa para realizar rolling updates e rollbacks. Criar ReplicaSets diretamente costuma ser desnecessário quando um Deployment fornece o gerenciamento de ciclo de vida necessário.
Exemplo:
apiVersion: apps/v1kind: ReplicaSetspec: replicas: 3Workloads de IA e machine learning no Kubernetes
O Kubernetes pode executar workloads de IA e machine learning, como treinamento de modelos, treinamento distribuído, processamento em lote e inferência. Esses workloads também rodam em Pods, mas costumam ter requisitos mais exigentes do que aplicações convencionais, especialmente em relação a aceleradores, disponibilidade de recursos e coordenação de vários Pods.
Requisitos de GPU e aceleradores
Workloads de IA/ML frequentemente dependem de GPUs ou de outros hardwares especializados. O Kubernetes oferece suporte a device plugins que expõem hardware, como GPUs AMD e NVIDIA, como recursos agendáveis.
Isso permite que as equipes:
- Solicitem GPUs para Pods específicos.
- Agendem workloads apenas em nós com o hardware de aceleração adequado.
- Usem labels de nó, selectors e afinidade para direcionar tipos específicos de GPU.
- Gerenciem a capacidade de GPU junto com outros recursos do Kubernetes, como CPU e memória.
Workloads distribuídos de IA e ML
Jobs grandes de treinamento podem consistir em vários Pods relacionados, como um driver e um conjunto de workers. Agendar esses Pods de forma independente pode ser ineficiente, porque o workload pode não conseguir progredir a menos que haja workers suficientes disponíveis ao mesmo tempo.
A Workload API do Kubernetes atende a esse tipo de requisito ao permitir que Pods relacionados sejam agrupados e recebam políticas de agendamento. Por exemplo, o gang scheduling pode usar uma abordagem de tudo ou nada, em que o grupo necessário de Pods é agendado em conjunto, em vez de permitir que apenas parte de um job distribuído consuma recursos.
Posicionamento de workloads para IA/ML
O posicionamento também pode afetar a performance de IA/ML. O treinamento distribuído costuma envolver comunicação significativa entre os workers, então o Kubernetes pode usar agendamento com reconhecimento de workload e de topologia para coordenar onde os Pods relacionados são executados.
Esses recursos podem ajudar as organizações a:
- Manter os workers distribuídos dentro de domínios de topologia adequados.
- Reduzir a latência de comunicação entre Pods relacionados.
- Evitar jobs de treinamento parcialmente agendados que não conseguem progredir de forma útil.
- Alocar recursos escassos de GPU e aceleradores com mais eficiência.
Ciclo de vida dos workloads no Kubernetes
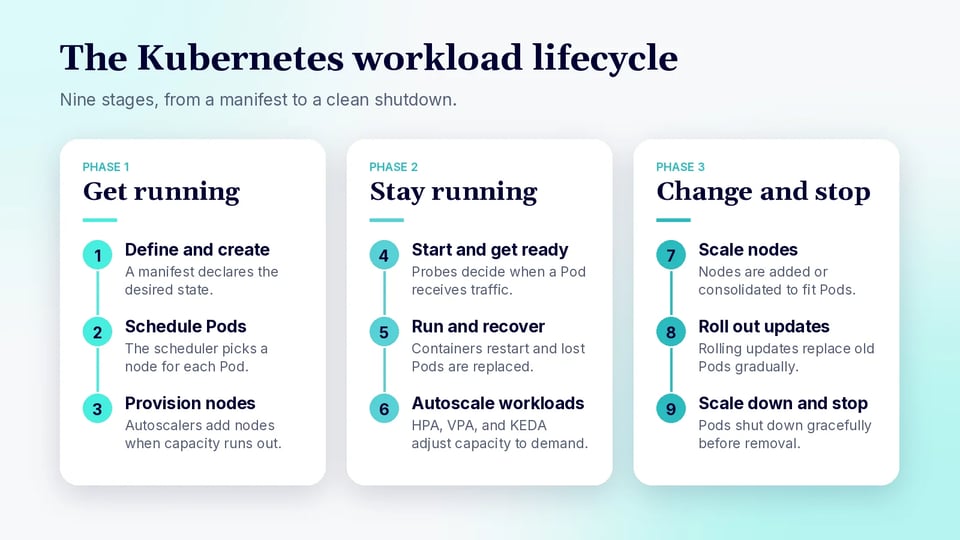
Um workload do Kubernetes passa por vários estágios, desde sua declaração inicial até o agendamento, a execução, o escalonamento, as atualizações e o eventual encerramento. Ambientes Kubernetes modernos podem automatizar boa parte desse ciclo de vida, incluindo tanto o escalonamento no nível da aplicação quanto o provisionamento dinâmico dos nós subjacentes.
1. Definição e criação do workload
O ciclo de vida começa quando você define um recurso de workload, como um Deployment, StatefulSet, DaemonSet, Job ou CronJob. O manifesto especifica o estado desejado da aplicação, incluindo imagens de contêiner, número de réplicas, requests e limits de recursos, configuração de ambiente, requisitos de armazenamento e restrições de agendamento.
Quando o recurso é enviado à API do Kubernetes, o controlador correspondente começa a reconciliar o estado real do cluster com o estado desejado. Por exemplo, um controlador de Deployment cria e gerencia ReplicaSets, que por sua vez mantêm os Pods necessários.
2. Agendamento de Pods
Pods recém-criados geralmente começam sem um nó atribuído. O scheduler do Kubernetes avalia os nós disponíveis e seleciona o posicionamento adequado com base em fatores como:
- Requests de CPU e memória
- Node selectors e afinidade de nós
- Afinidade e anti-afinidade de pods
- Taints e tolerations
- Topology spread constraints
- Requisitos de armazenamento e hardware
O Kubernetes também oferece suporte a scheduling gates, que podem manter um Pod fora do scheduler até que condições externas sejam satisfeitas. Depois que um nó adequado é selecionado, o Pod é vinculado a esse nó.
3. Provisionamento de nós quando a capacidade é insuficiente
Se o scheduler não consegue posicionar um Pod porque não há capacidade adequada disponível, o autoescalonamento de nós pode provisionar infraestrutura adicional.
O Kubernetes moderno distingue isso do autoescalonamento de workloads. Autoescaladores de nós reagem a Pods não agendáveis e provisionam nós que atendem aos seus requisitos de recursos e agendamento. Atualmente, o Kubernetes identifica tanto o Cluster Autoscaler quanto o Karpenter como implementações patrocinadas pelo SIG Autoscaling.
O Karpenter adota uma abordagem mais dinâmica nesse processo. Em vez de depender apenas de grupos de nós predefinidos, ele pode usar as restrições de NodePool e os requisitos dos Pods pendentes para selecionar e provisionar a capacidade de nós adequada. Ele também gerencia operações mais amplas do ciclo de vida dos nós, incluindo consolidação e substituição de nós.
4. Inicialização e prontidão dos Pods
Depois que um Pod chega ao nó atribuído, o kubelet prepara o Pod e inicia seus contêineres. As aplicações podem precisar de tempo de inicialização antes de estarem prontas para atender tráfego.
O Kubernetes fornece várias probes para gerenciar essa etapa:
- Startup probes determinam quando uma aplicação foi inicializada com sucesso.
- Readiness probes determinam quando um Pod deve receber tráfego.
- Liveness probes detectam contêineres que estão em execução, mas não íntegros, e que devem ser reiniciados.
Um Pod pode, portanto, estar em execução sem ainda ser considerado pronto para atender requisições.
5. Operação em runtime e gerenciamento de integridade
Quando prontos, os Pods executam o workload da aplicação enquanto o Kubernetes trabalha continuamente para manter o estado declarado.
Se um contêiner falha, o kubelet pode reiniciá-lo de acordo com sua política de reinício. Se um Pod gerenciado por um Deployment ou StatefulSet desaparece por completo, o controlador do workload pode criar um substituto. As verificações de readiness também podem remover temporariamente Pods não íntegros dos endpoints de serviço sem necessariamente reiniciá-los.
6. Autoescalonamento de workloads
Durante a operação, o Kubernetes pode ajustar a capacidade do workload conforme a demanda muda. As versões atuais do Kubernetes oferecem suporte a várias abordagens, em vez de depender de um único mecanismo de escalonamento.
- Horizontal Pod Autoscaler (HPA): altera o número de réplicas com base em métricas de CPU, memória, personalizadas ou externas.
- Vertical Pod Autoscaler (VPA): ajusta os requests e limits de recursos com base nos requisitos do workload. O VPA é instalado separadamente, e não faz parte da API principal do Kubernetes.
- Redimensionamento vertical in-place: o Kubernetes pode redimensionar os recursos de CPU e memória atribuídos a contêineres sem necessariamente substituir o Pod. O escalonamento vertical in-place de Pods é estável a partir do Kubernetes 1.35.
- KEDA: adiciona autoescalonamento orientado a eventos com base em fontes como filas, sistemas de streaming, bancos de dados e plataformas de monitoramento.
O KEDA é particularmente útil quando o escalonamento deve acompanhar eventos da aplicação, e não a utilização de CPU ou memória. Ele pode escalar Deployments, StatefulSets e outros recursos escaláveis, incluindo o escalonamento de workloads entre zero e uma réplica antes de usar o HPA para escalonamento adicional. O KEDA também pode criar e escalar Jobs do Kubernetes por meio do ScaledJob.
7. Escalonamento e consolidação de nós
Um aumento nas réplicas do workload não significa automaticamente que os nós existentes têm espaço suficiente para executá-las. Por isso, o autoescalonamento de workloads e o autoescalonamento de nós costumam operar em conjunto.
Por exemplo:
- O HPA ou o KEDA aumenta o número de Pods em resposta à demanda.
- Alguns Pods novos ficam não agendáveis porque o cluster não tem capacidade.
- Um autoescalador de nós provisiona nós adicionais.
- O scheduler posiciona os Pods pendentes na capacidade recém-disponível.
O processo também funciona no sentido inverso. Quando a demanda diminui, o autoescalonamento de workloads remove Pods desnecessários, e o autoescalonamento de nós pode consolidar a infraestrutura subutilizada.
Com o Karpenter, a consolidação pode remover ou substituir nós vazios ou subutilizados, ajudando o cluster a adaptar sua infraestrutura ao workload, em vez de simplesmente manter grupos de nós fixos.
8. Atualizações e rollouts de workloads
Workloads mudam com frequência ao longo de sua vida, conforme as equipes implantam novas imagens de contêiner, configurações, ajustes de recursos ou versões da aplicação.
Para Deployments, o Kubernetes normalmente executa um rolling update, criando gradualmente Pods com base na nova especificação enquanto encerra os Pods mais antigos. Isso permite que as aplicações permaneçam disponíveis enquanto uma nova versão é introduzida. O comportamento do rollout pode ser controlado por meio de configurações como maxSurge e maxUnavailable.
Os controladores continuam reconciliando o workload até que os Pods em execução correspondam ao estado desejado atualizado.
9. Redução de escala e encerramento
Pods podem ser encerrados devido a exclusão manual, redução de escala do workload, rolling updates, interrupção de nós ou consolidação de nós.
Durante o encerramento normal, o Kubernetes dá à aplicação a oportunidade de desligar de forma controlada. O Pod é removido do tráfego normal de serviço, os contêineres recebem um sinal de encerramento e o Kubernetes aguarda o período de tolerância configurado antes de interromper à força quaisquer processos restantes.
Quando a demanda do workload cai, os autoescaladores podem reduzir o número de réplicas, e autoescaladores de nós como o Karpenter podem, em seguida, consolidar ou remover a capacidade que não é mais necessária.
Monitoramento de workloads no Kubernetes
O monitoramento de workloads no Kubernetes deve ir além de mostrar se os Pods estão em execução. O objetivo é identificar problemas de capacidade, instabilidade da aplicação, gargalos de agendamento e alocação ineficiente de recursos — e, em seguida, usar essas descobertas para ajustar configurações de recursos, políticas de autoescalonamento e a configuração dos workloads.
Utilização de CPU e memória
As métricas de CPU e memória ajudam a determinar se os workloads têm recursos suficientes para operar de forma confiável sem reservar mais capacidade do cluster do que o necessário.
Métricas para monitorar
- Uso de CPU: CPU realmente consumida por cada contêiner e Pod.
- Requests de CPU: CPU reservada para fins de agendamento.
- Limits de CPU: CPU máxima que um contêiner pode usar, quando limits estão configurados.
- Throttling de CPU: tempo em que um contêiner é impedido de usar CPU adicional por ter atingido seu limit de CPU.
- Uso de memória e working set: memória ativamente consumida pelo workload.
- Requests e limits de memória: memória reservada e memória máxima permitida para o contêiner.
- Tendências de utilização: padrões históricos de uso, incluindo picos, utilização sustentada e crescimento gradual de memória.
Comparar a utilização real com os requests é particularmente útil, porque os requests influenciam tanto o agendamento dos Pods quanto o comportamento do Horizontal Pod Autoscaler quando métricas de utilização de recursos são usadas.
Dicas de otimização
Use os dados de utilização para fazer right-sizing dos requests de recursos, em vez de depender apenas de estimativas iniciais. Workloads consistentemente subutilizados podem ter requests desnecessariamente altos, enquanto workloads que se aproximam regularmente dos recursos disponíveis podem precisar de mais capacidade.
Considere ações como:
- Ajustar os requests de CPU e memória para refletir melhor a demanda observada.
- Investigar throttling de CPU sustentado antes de simplesmente aumentar os limits.
- Aumentar os limits de memória quando a demanda legítima do workload excede as configurações atuais.
- Investigar o crescimento constante de memória em busca de possíveis vazamentos de memória.
- Usar HPA, VPA ou outros mecanismos de autoescalonamento quando os requisitos de recursos mudam significativamente com a demanda.
- Analisar percentis de longo prazo e períodos de pico, em vez de otimizar com base em um único snapshot.
Reinícios e falhas de Pods
As métricas de reinício e falha revelam instabilidades do workload que podem não ser óbvias pela fase atual do Pod. Um Pod pode reportar Running enquanto um de seus contêineres trava e reinicia repetidamente.
Métricas e sinais para monitorar
- Contagem e taxa de reinícios de contêineres
- Motivo de encerramento do contêiner
- Códigos de saída
- Estados atuais e anteriores do contêiner
- Falhas em probes de startup, readiness e liveness
- Eventos de CrashLoopBackOff
- Erros de pull de imagem e de configuração
- Logs da aplicação antes e depois de um reinício
Monitorar as taxas de reinício ao longo do tempo costuma ser mais útil do que reagir a um reinício isolado. Aumentos repentinos ou loops persistentes de reinício são indicadores mais fortes de um problema subjacente.
Dicas de troubleshooting e otimização
A resposta adequada depende do motivo do reinício do contêiner. Comece pelo motivo de encerramento, pelo estado anterior do contêiner, pelos eventos do Kubernetes e pelos logs da aplicação.
Ações comuns incluem:
- Corrigir travamentos da aplicação ou exceções não tratadas.
- Ajustar probes agressivas demais para os tempos de inicialização ou de resposta da aplicação.
- Corrigir Secrets, ConfigMaps, volumes ou variáveis de ambiente ausentes.
- Aumentar a memória quando os reinícios são causados por condições de OOM.
- Investigar serviços downstream indisponíveis quando as falhas coincidem com erros de dependência.
- Revisar deployments recentes quando as taxas de reinício aumentam logo após um rollout.
Evite tratar reinícios apenas como um problema de capacidade. Aumentar recursos não resolverá falhas causadas por bugs da aplicação, configuração inválida ou probes de integridade configuradas incorretamente.
Pods pendentes e não agendáveis
Pods pendentes podem indicar que a demanda dos workloads excedeu a capacidade disponível do cluster ou que restrições de agendamento impedem o Kubernetes de encontrar um nó elegível.
Métricas e sinais para monitorar
- Número de Pods em Pending
- Tempo que os Pods permanecem em Pending
- Contagem de Pods não agendáveis
- Eventos do scheduler e motivos de rejeição
- CPU, memória, GPUs e outros recursos solicitados
- Capacidade disponível nos nós elegíveis
- Requisitos de afinidade de nós e selectors
- Taints e tolerations
- Topology spread constraints
- Condições de agendamento e anexação de PersistentVolumes
O tempo de permanência dos Pods em Pending é particularmente útil. Pequenos atrasos de agendamento podem ser normais, enquanto Pods que permanecem não agendáveis por longos períodos geralmente exigem intervenção.
Dicas para resolver gargalos de agendamento
Primeiro, identifique se o problema é causado por capacidade insuficiente ou por regras de agendamento restritivas demais.
Ações possíveis incluem:
- Fazer right-sizing dos requests de recursos quando os Pods solicitam muito mais capacidade do que realmente precisam.
- Corrigir node selectors, regras de afinidade ou tolerations que restringem o posicionamento desnecessariamente.
- Revisar os requisitos de topology spread quando o Kubernetes não encontra nós elegíveis suficientes.
- Garantir que workloads de GPU ou outros workloads especializados tenham acesso a nós compatíveis.
- Adicionar capacidade ao cluster quando a demanda legítima dos workloads excede os recursos disponíveis.
- Configurar o autoescalonamento de nós para que nova capacidade possa ser provisionada automaticamente.
Em ambientes escalados dinamicamente, Pods em Pending persistentes também devem motivar uma revisão da camada de provisionamento de nós. Por exemplo, o Karpenter pode provisionar nós com base nos requisitos de Pods não agendáveis, mas suas restrições de NodePool ainda precisam permitir a criação de capacidade de instância adequada.
Contêineres OOMKilled
OOMKilled indica que um contêiner foi encerrado pelo tratamento de falta de memória (out-of-memory) do sistema operacional. Uma causa comum é um contêiner tentando consumir mais memória do que o limit configurado permite.
Métricas e sinais para monitorar
- Motivo de encerramento do contêiner: OOMKilled
- Código de saída 137
- Working set de memória
- Requests e limits de memória
- Pico de consumo de memória
- Utilização de memória imediatamente antes do encerramento
- Frequência de reinícios após eventos de OOM
- Crescimento de memória no longo prazo
Métricas históricas são especialmente valiosas, porque as métricas atuais do contêiner são zeradas depois que ele reinicia.
Dicas para evitar OOM kills
Comece determinando se o uso de memória representa uma demanda legítima da aplicação ou um comportamento anormal.
Otimizações possíveis incluem:
- Aumentar os limits de memória quando workloads normais precisam legitimamente de mais capacidade.
- Elevar os requests de memória quando os Pods consomem consistentemente muito mais memória do que o solicitado.
- Investigar vazamentos de memória da aplicação quando o uso cresce continuamente ao longo do tempo.
- Limitar concorrência ou tamanhos de lote quando requisições individuais causam grandes picos de memória.
- Revisar caches, configurações de heap da JVM e a configuração de memória no nível da aplicação.
- Usar dados históricos de utilização para estabelecer configurações de recursos realistas.
- Avaliar o autoescalonamento vertical quando os requisitos de memória mudam substancialmente ao longo do tempo.
Aumentar repetidamente os limits de memória sem identificar a causa pode esconder problemas da aplicação e aumentar os custos de infraestrutura. Por isso, mudanças de recursos devem se basear no comportamento do workload e no uso histórico, e não apenas em eventos de OOM.
Boas práticas de gerenciamento de workloads no Kubernetes
Defina requests e limits de recursos precisos
Defina requests de CPU e memória com base em requisitos realistas dos workloads. O scheduler usa os requests ao decidir onde posicionar os pods, então valores altos demais podem desperdiçar capacidade do cluster ou deixar pods pendentes. Requests baixos demais podem levar a nós sobrecarregados.
Use limits onde eles oferecem proteção útil contra consumo excessivo de recursos. Limits de CPU podem causar throttling, enquanto exceder um limit de memória pode resultar em um contêiner OOMKilled. Teste as configurações de limits sob carga representativa, em vez de escolher valores arbitrários.
Faça right-sizing contínuo dos workloads
Os requisitos de recursos mudam conforme o código da aplicação, o tráfego e os padrões de uso evoluem. Revise regularmente o consumo real de CPU e memória e compare-o com os requests e limits configurados.
Use métricas históricas em vez de snapshots curtos ao fazer right-sizing dos workloads. Leve em conta o uso normal, a demanda de pico, os requisitos de inicialização e o crescimento esperado. Isso ajuda a reduzir a capacidade ociosa sem deixar as aplicações vulneráveis a picos previsíveis.
Use o controlador de workload adequado
Escolha um controlador com base em como a aplicação precisa rodar. Use Deployments para aplicações stateless em execução contínua e StatefulSets quando as réplicas exigem identidades estáveis, operações ordenadas ou armazenamento persistente.
DaemonSets são adequados para software que deve rodar em nós selecionados, como agentes de monitoramento ou de rede. Use Jobs para tarefas finitas e CronJobs para execução agendada. Selecionar o controlador correto fornece o comportamento de ciclo de vida sem exigir lógica de gerenciamento personalizada.
Configure probes de readiness, liveness e startup
Use readiness probes para determinar quando um pod pode receber tráfego com segurança. Uma readiness probe com falha remove o pod dos endpoints normais do Service sem reiniciar seu contêiner, o que a torna adequada para condições temporárias, como falhas de dependências ou inicialização.
Use liveness probes para detectar aplicações que não conseguem se recuperar sem um reinício. Startup probes são úteis para aplicações com tempos de inicialização longos ou imprevisíveis, porque evitam que as verificações de liveness reiniciem a aplicação antes da conclusão da inicialização.
Configure com cuidado os caminhos, limiares, intervalos e timeouts das probes. Probes agressivas demais podem gerar falhas ao reiniciar aplicações saudáveis, mas temporariamente lentas.
Use Pod Disruption Budgets para aplicações críticas
Um PodDisruptionBudget limita quantas réplicas de uma aplicação podem ficar indisponíveis durante interrupções voluntárias. Essas interrupções podem ocorrer durante operações como drenagem de nós, manutenção do cluster ou algumas atividades de autoescalonamento.
Configure um budget usando minAvailable ou maxUnavailable de acordo com os requisitos de redundância da aplicação. Um budget não impede todo tipo de falha, como uma interrupção inesperada de nó, e não garante disponibilidade quando uma aplicação tem poucas réplicas.
Evite budgets que tornem a manutenção de rotina impossível. O workload precisa de réplicas saudáveis suficientes para que o Kubernetes consiga respeitar o budget enquanto remove (evict) pods com segurança.
Distribua réplicas entre nós e zonas de disponibilidade
Várias réplicas oferecem proteção limitada se todas rodam no mesmo nó ou no mesmo domínio de falha. Use pod anti-affinity ou topology spread constraints para distribuir réplicas entre nós, zonas ou outros limites de topologia.
A distribuição reduz o impacto de falhas de nós e de zonas de disponibilidade. Ela também pode evitar que a manutenção em um único nó remova capacidade demais da aplicação de uma só vez.
Equilibre os requisitos de resiliência com a flexibilidade de agendamento. Regras rígidas de posicionamento podem deixar pods pendentes quando o cluster não tem nós adequados suficientes na topologia exigida.
Combine autoescalonamento de workloads e do cluster
O autoescalonamento de workloads e o autoescalonamento do cluster resolvem problemas de capacidade diferentes. O HorizontalPodAutoscaler pode aumentar ou diminuir as réplicas da aplicação de acordo com métricas, enquanto o autoescalonamento no nível de nós pode ajustar a capacidade do cluster quando os pods não podem ser agendados com os recursos existentes.
Esses mecanismos devem ser configurados em conjunto. Escalar um Deployment traz pouco benefício se as novas réplicas permanecem pendentes porque o cluster não tem capacidade. Da mesma forma, adicionar nós não aumenta automaticamente as réplicas da aplicação quando a demanda cresce.
Requests de recursos precisos são importantes para ambos os mecanismos, porque afetam decisões de agendamento e capacidade. Defina faixas de escalonamento sensatas e monitore o comportamento do escalonamento para evitar mudanças excessivas, respostas lentas à demanda ou uso desnecessário de infraestrutura.
Perguntas frequentes
O que é um workload no Kubernetes? Um workload do Kubernetes é uma aplicação, serviço ou tarefa executada em um cluster. Os workloads rodam dentro de Pods, mas normalmente são gerenciados por meio de recursos de nível superior que indicam ao Kubernetes como criar, substituir, escalar, atualizar e encerrar esses Pods.
Quais são os principais tipos de workloads no Kubernetes? Os principais recursos de workload nativos são Deployments, StatefulSets, DaemonSets, Jobs, CronJobs e ReplicaSets. Cada um atende a uma necessidade diferente, como serviços stateless, aplicações stateful, agentes no nível do nó, tarefas pontuais e tarefas agendadas.
Qual é a diferença entre um Deployment e um StatefulSet? Um Deployment gerencia aplicações stateless cujas réplicas de Pods são intercambiáveis. Um StatefulSet é para aplicações cujos Pods precisam de nomes estáveis, ordenação previsível ou armazenamento persistente próprio, como bancos de dados.
Qual é a diferença entre um Job e um CronJob? Um Job executa um ou mais Pods até que uma tarefa seja concluída com sucesso, como uma migração de banco de dados. Um CronJob cria Jobs em um agendamento recorrente escrito em sintaxe cron, o que é adequado para tarefas como backups e geração de relatórios.
Qual é a diferença entre um workload do Kubernetes e a Workload API? Um workload é o recurso que está sendo gerenciado, como um Deployment ou um Job. A workload API é a interface da API do Kubernetes que ferramentas, controladores e aplicações usam para criar, ler, atualizar, excluir e escalar esses recursos.
Por que meu Pod está preso em Pending? Pods em Pending geralmente significam que o cluster não tem capacidade ou que regras de agendamento impedem o Kubernetes de encontrar um nó elegível. Verifique os eventos do scheduler e, em seguida, analise requests de recursos, node selectors, regras de afinidade, tolerations e topology spread constraints. O autoescalonamento de nós pode adicionar capacidade quando a demanda é legítima.
Como otimizar workloads no Kubernetes com PerfectScale
O PerfectScale by DoiT é uma plataforma para otimizar recursos em todos os clusters Kubernetes. Após uma implantação única via Helm, ele entrega insights acionáveis e otimização autônoma em toda a sua stack K8s, dos workloads individuais aos nós subjacentes. Funciona com autoescaladores como HPA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning e Google Autopilot. Oferece suporte a nuvens públicas como EKS, GKE e AKS, nuvens privadas como OpenShift, além de ambientes on-premises e híbridos.
Principais recursos do PerfectScale:
- Right-sizing autônomo de workloads: o Podfit oferece uma visão granular da integridade e dos custos do cluster, identifica recursos desperdiçados e problemas de resiliência e fornece recomendações baseadas em dados para fazer right-sizing dos workloads. Você também pode configurar automação para otimização imediata.
- Recomendações de configuração de autoescalonamento: receba recomendações acionáveis para melhorar suas configurações de HPA e KEDA, para que os workloads escalem com eficiência conforme a demanda.
- Otimização de workloads efêmeros e de ML: faça right-sizing autônomo de workloads efêmeros, como Airflow e Spark Jobs, para que ambientes dinâmicos permaneçam otimizados.
- Automação sensível a revisões: o PerfectScale avalia cada novo release de código e se ajusta às mudanças nos requisitos dos workloads, para que suas otimizações nunca contradigam as alterações do seu desenvolvimento.
- Otimização no nível dos nós: o Infrafit oferece visibilidade da utilização dos nós para ajudar a eliminar capacidade ociosa, escolher os nós certos para seus workloads e maximizar a eficácia de autoescaladores de nós como o Karpenter.
- Alertas em tempo real priorizados: trate riscos de resiliência e picos de custo com priorização orientada a impacto e receba alertas no Slack, Datadog, MS Teams, PagerDuty e outras ferramentas.
- Relatórios de tendências e governança: acompanhe métricas de custo, desperdício e risco ao longo do tempo entre clusters, grupos de nós, namespaces e workloads para melhorar previsões e análises de causa raiz.