


Que sont les workloads Kubernetes ?
Les workloads Kubernetes sont des applications, des services ou des tâches qui s'exécutent sur un cluster Kubernetes. Ils s'exécutent au sein de Pods, mais sont généralement gérés via des ressources de workload de plus haut niveau qui indiquent à Kubernetes comment les Pods doivent être créés, remplacés, mis à l'échelle, mis à jour et arrêtés. Les différentes ressources de workload offrent des comportements de cycle de vie distincts, ce qui permet à Kubernetes de prendre en charge des services stateless, des applications stateful, des agents au niveau des nœuds, des traitements batch ponctuels et des tâches planifiées.
Les ressources de workload intégrées de base :
| Type de workload | Cas d'usage principal | Fonctionnalités et comportement clés | Exemples courants |
|---|---|---|---|
| Deployment | Applications stateless s'exécutant en continu | Maintient des réplicas de Pods interchangeables via des ReplicaSets et prend en charge la mise à l'échelle, les rolling updates, le rollback et le remplacement automatique des Pods défaillants. | Applications web, API, microservices |
| StatefulSet | Applications stateful nécessitant une identité ou un stockage stables | Attribue aux Pods des noms et des identités stables, prend en charge la création et l'arrêt ordonnés, et peut associer chaque réplica à sa propre persistent volume claim. | Clusters PostgreSQL, bases de données distribuées, Kafka |
| DaemonSet | Services au niveau des nœuds | Garantit qu'un Pod s'exécute sur chaque nœud éligible ou sur des nœuds sélectionnés, et ajoute ou supprime automatiquement des Pods lorsque des nœuds correspondants rejoignent ou quittent le cluster. | Collecteurs de logs, agents de monitoring, agents réseau et de stockage |
| Job | Tâches finies ou batch | Crée un ou plusieurs Pods et les suit jusqu'à ce que le nombre requis d'exécutions réussies soit atteint ; prend en charge l'exécution séquentielle et parallèle. | Migrations de bases de données, traitements batch, scripts d'administration |
| CronJob | Tâches récurrentes planifiées | Crée des Jobs selon une planification cron et peut contrôler la concurrence, les exécutions manquées et la rétention des Jobs terminés. | Sauvegardes, génération de rapports, nettoyage, synchronisation périodique |
| ReplicaSet | Maintien d'un nombre fixe de réplicas de Pods identiques | Garantit que le nombre spécifié de Pods correspondants reste disponible, en remplaçant les Pods défaillants ou supprimés si nécessaire. Généralement créé et géré par un Deployment plutôt que directement. | Gestion des réplicas sous-jacente aux Deployments |
Bonnes pratiques pour les workloads :
- Définir des requests et limits de ressources précises : définissez des requests CPU et mémoire réalistes pour la planification, et utilisez les limits avec discernement afin d'éviter une consommation excessive sans provoquer de throttling inutile ni d'événements OOMKilled.
- Pratiquer le right-sizing des workloads en continu : comparez l'utilisation CPU et mémoire historique avec les requests et limits configurées, puis ajustez-les à mesure que la demande applicative évolue.
- Utiliser le contrôleur de workload approprié : utilisez des Deployments pour les services stateless, des StatefulSets pour les workloads nécessitant une identité ou un stockage stables, des DaemonSets pour les services au niveau des nœuds, des Jobs pour les tâches finies et des CronJobs pour les tâches planifiées.
- Configurer les probes readiness, liveness et startup : utilisez les probes pour contrôler l'éligibilité au trafic, détecter les défaillances applicatives irrécupérables et protéger les workloads à démarrage lent contre des redémarrages prématurés.
- Utiliser des Pod Disruption Budgets pour les applications critiques : limitez le nombre de réplicas pouvant être indisponibles lors de perturbations volontaires telles que les drains de nœuds et la maintenance.
- Répartir les réplicas entre nœuds et zones de disponibilité : utilisez l'anti-affinité de pods ou les topology spread constraints pour réduire l'impact des défaillances de nœuds ou de zones.
- Combiner l'autoscaling des workloads et du cluster : coordonnez le HPA ou d'autres mécanismes d'autoscaling de workloads avec l'autoscaling des nœuds afin que les réplicas supplémentaires disposent d'une capacité de cluster suffisante pour s'exécuter.
Cet article fait partie d'une série consacrée à la planification Kubernetes
Dans cet article :
- Workloads Kubernetes et API Workload : quelle différence ?
- Les types de workloads Kubernetes
- Workloads d'IA et de machine learning dans Kubernetes
- Le cycle de vie des workloads Kubernetes
- Le monitoring des workloads Kubernetes
- Bonnes pratiques de gestion des workloads Kubernetes
Workloads Kubernetes et API Workload : quelle différence ?
Un workload Kubernetes est la ressource concrète qui représente et gère une application ou une tâche s'exécutant dans le cluster. Il peut s'agir par exemple d'un Deployment, d'un StatefulSet, d'un DaemonSet, d'un Job ou d'un CronJob. Ces objets décrivent l'état souhaité du workload : image de conteneur à exécuter, nombre de réplicas, stratégie de mise à jour et exigences de planification.
Une API de workload est l'interface de l'API Kubernetes utilisée pour créer, lire, mettre à jour, supprimer, mettre à l'échelle ou gérer de toute autre manière ces objets de workload. Par exemple, un Deployment est un objet de workload, tandis que l'API Deployment, exposée via le groupe d'API apps/v1 de Kubernetes, fournit les opérations et le schéma utilisés par des outils comme kubectl, les contrôleurs et le code applicatif pour manipuler les ressources Deployment.
La distinction se fait donc entre la ressource gérée et l'API utilisée pour la gérer. Un StatefulSet est un workload ; l'API StatefulSet permet aux clients de créer ou de modifier des objets StatefulSet. De même, un Job est un workload, tandis que l'API Job fournit un accès programmatique aux ressources Job.
Cette distinction devient particulièrement importante lors de la création d'opérateurs, d'automatisations, d'outils de plateforme ou d'intégrations personnalisées. Ces systèmes interagissent avec Kubernetes via les API de workload plutôt qu'en manipulant directement les conteneurs ou pods en cours d'exécution, ce qui permet au plan de contrôle Kubernetes de réconcilier l'état de workload demandé.
Les types de workloads Kubernetes
Kubernetes propose plusieurs ressources de workload répondant à différents besoins applicatifs. Chaque ressource gère des pods, mais applique des règles différentes en matière de planification, de mise à l'échelle, de mise à jour et de remplacement des pods. Le choix de la bonne ressource dépend de la nature de l'application : stateless, stateful, liée à un nœud ou conçue pour s'exécuter pendant une durée limitée.
Deployments
Un Deployment gère des applications stateless nécessitant un ou plusieurs réplicas de pods interchangeables. Vous définissez l'image de conteneur souhaitée, le nombre de réplicas et la configuration des pods, et le Deployment travaille en continu pour maintenir cet état.
Les Deployments prennent également en charge des mises à jour applicatives contrôlées. Ils peuvent remplacer progressivement les anciens pods par de nouveaux lors d'un rolling update et permettent un rollback vers une révision antérieure en cas d'échec de la mise à jour. Les Deployments gèrent les pods via des ReplicaSets plutôt qu'en les créant directement.
Exemple :
apiVersion: apps/v1kind: Deploymentspec: replicas: 3StatefulSets
Un StatefulSet gère des applications dont les pods ont besoin d'identités stables, d'un ordre prévisible ou d'un stockage persistant. Contrairement aux pods d'un Deployment, les pods d'un StatefulSet reçoivent des noms persistants tels que database-0 et database-1.
Les StatefulSets peuvent créer et arrêter les pods dans un ordre défini et associer chaque pod à sa propre persistent volume claim. Ces propriétés les rendent utiles pour les bases de données, les magasins de données distribués et toute application où les réplicas individuels ne sont pas interchangeables.
Exemple :
apiVersion: apps/v1kind: StatefulSetspec: serviceName: database replicas: 2DaemonSets
Un DaemonSet garantit qu'un pod s'exécute sur chaque nœud éligible, ou sur un groupe de nœuds sélectionnés. Lorsqu'un nœud correspondant rejoint le cluster, Kubernetes y crée le pod. Lorsque le nœud est retiré, son pod DaemonSet disparaît avec lui.
Les DaemonSets sont couramment utilisés pour les services au niveau des nœuds : collecteurs de logs, agents de monitoring, composants de stockage et logiciels réseau. Les node selectors, les règles d'affinité et les tolerations permettent de restreindre les nœuds qui reçoivent les pods.
Exemple :
apiVersion: apps/v1kind: DaemonSetmetadata: name: node-agentJobs
Un Job exécute un ou plusieurs pods jusqu'à ce qu'une tâche donnée se termine avec succès. Contrairement à un Deployment, qui maintient une application en fonctionnement continu, un Job suit les exécutions réussies et cesse de créer des pods une fois ses exigences de complétion atteintes.
Les Jobs sont utiles pour les tâches finies : migrations de bases de données, traitement de données, calculs batch et opérations d'administration. Ils peuvent exécuter une tâche unique ou plusieurs tâches, de manière séquentielle ou parallèle.
Exemple :
apiVersion: batch/v1kind: Jobmetadata: name: migrationCronJobs
Un CronJob crée des Jobs selon une planification récurrente exprimée en syntaxe cron. Kubernetes évalue la planification et démarre un Job lorsque l'heure d'exécution configurée arrive.
Les CronJobs conviennent aux tâches récurrentes : sauvegardes, génération de rapports, opérations de nettoyage et synchronisation périodique des données. Leur configuration permet également de contrôler les exécutions concurrentes, les planifications manquées et la rétention des Jobs terminés.
Exemple :
apiVersion: batch/v1kind: CronJobspec: schedule: "0 2 * * *"ReplicaSets
Un ReplicaSet maintient un nombre spécifié de réplicas de pods identiques. Si un pod échoue ou est supprimé, le ReplicaSet en crée un remplaçant. Si trop de pods correspondants existent, il supprime les pods excédentaires.
Les ReplicaSets sont généralement gérés indirectement via des Deployments. Un Deployment crée de nouveaux ReplicaSets lorsque son template de pod change et les utilise pour effectuer les rolling updates et les rollbacks. Créer directement des ReplicaSets est en général inutile lorsqu'un Deployment fournit la gestion du cycle de vie requise.
Exemple :
apiVersion: apps/v1kind: ReplicaSetspec: replicas: 3Workloads d'IA et de machine learning dans Kubernetes
Kubernetes peut exécuter des workloads d'IA et de machine learning : entraînement de modèles, entraînement distribué, traitement batch et inférence. Ces workloads s'exécutent toujours dans des Pods, mais leurs exigences sont souvent plus élevées que celles d'applications classiques, notamment en matière d'accélérateurs, de disponibilité des ressources et de coordination de plusieurs Pods.
Besoins en GPU et accélérateurs
Les workloads IA/ML dépendent fréquemment de GPU ou d'autres matériels spécialisés. Kubernetes prend en charge des device plugins qui exposent du matériel comme les GPU AMD et NVIDIA en tant que ressources planifiables.
Cela permet aux équipes de :
- Demander des GPU pour des Pods spécifiques.
- Planifier les workloads uniquement sur des nœuds disposant du matériel accélérateur approprié.
- Utiliser les labels de nœuds, les selectors et l'affinité pour cibler des types de GPU particuliers.
- Gérer la capacité GPU aux côtés des autres ressources Kubernetes comme le CPU et la mémoire.
Workloads d'IA et de ML distribués
Les grands jobs d'entraînement peuvent être constitués de plusieurs Pods liés, par exemple un driver et un ensemble de workers. Planifier ces Pods indépendamment peut s'avérer inefficace, car le workload peut être incapable de progresser tant qu'un nombre suffisant de workers n'est pas disponible simultanément.
L'API Workload de Kubernetes répond à ce type d'exigence en permettant de regrouper des Pods liés et de leur assigner des politiques de planification. Par exemple, le gang scheduling peut adopter une approche tout-ou-rien dans laquelle le groupe de Pods requis est planifié ensemble, au lieu de laisser une partie seulement d'un job distribué consommer des ressources.
Placement des workloads IA/ML
Le placement peut aussi influencer les performances IA/ML. L'entraînement distribué implique souvent des communications importantes entre workers ; Kubernetes peut donc recourir à une planification tenant compte des workloads et de la topologie pour coordonner l'emplacement des Pods liés.
Ces capacités aident les organisations à :
- Maintenir les workers distribués dans des domaines de topologie appropriés.
- Réduire la latence de communication entre Pods liés.
- Éviter les jobs d'entraînement partiellement planifiés, incapables de progresser utilement.
- Allouer plus efficacement les ressources GPU et accélérateurs, souvent rares.
Le cycle de vie des workloads Kubernetes
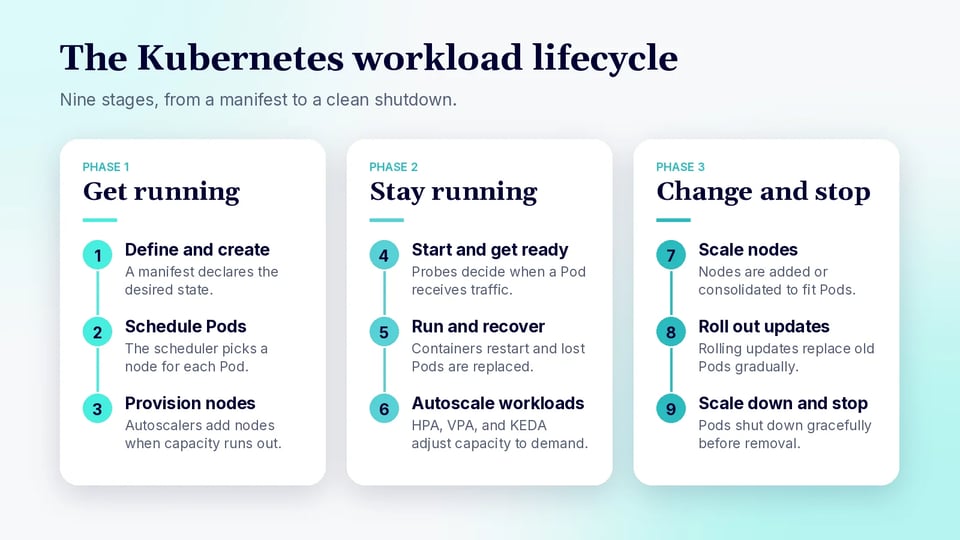
Un workload Kubernetes traverse plusieurs étapes, de sa déclaration initiale à la planification, l'exécution, la mise à l'échelle, les mises à jour et, finalement, l'arrêt. Les environnements Kubernetes modernes peuvent automatiser une grande partie de ce cycle de vie, y compris la mise à l'échelle au niveau applicatif et le provisionnement dynamique des nœuds sous-jacents.
1. Définition et création du workload
Le cycle de vie commence lorsque vous définissez une ressource de workload telle qu'un Deployment, un StatefulSet, un DaemonSet, un Job ou un CronJob. Le manifeste spécifie l'état souhaité de l'application : images de conteneurs, nombre de réplicas, requests et limits de ressources, configuration d'environnement, exigences de stockage et contraintes de planification.
Lorsque la ressource est soumise à l'API Kubernetes, le contrôleur concerné commence à réconcilier l'état réel du cluster avec l'état souhaité. Par exemple, un contrôleur de Deployment crée et gère des ReplicaSets, qui maintiennent à leur tour les Pods requis.
2. Planification des Pods
Les Pods nouvellement créés démarrent généralement sans nœud assigné. Le scheduler Kubernetes évalue les nœuds disponibles et sélectionne un placement adapté en fonction de facteurs tels que :
- Les requests CPU et mémoire
- Les node selectors et l'affinité de nœud
- L'affinité et l'anti-affinité de pods
- Les taints et tolerations
- Les topology spread constraints
- Les exigences de stockage et de matériel
Kubernetes prend également en charge les scheduling gates, qui peuvent maintenir un Pod hors du scheduler tant que des conditions externes ne sont pas satisfaites. Une fois un nœud approprié sélectionné, le Pod y est lié.
3. Provisionnement de nœuds en cas de capacité insuffisante
Si le scheduler ne peut pas placer un Pod faute de capacité adaptée, l'autoscaling des nœuds peut provisionner une infrastructure supplémentaire.
Les versions modernes de Kubernetes distinguent ce mécanisme de l'autoscaling des workloads. Les autoscalers de nœuds réagissent aux Pods non planifiables et provisionnent des nœuds satisfaisant leurs exigences de ressources et de planification. Kubernetes identifie actuellement Cluster Autoscaler et Karpenter comme implémentations sponsorisées par le SIG Autoscaling.
Karpenter adopte une approche plus dynamique de ce processus. Au lieu de s'appuyer uniquement sur des groupes de nœuds prédéfinis, il peut utiliser les contraintes des NodePools et les exigences des Pods en attente pour sélectionner et provisionner la capacité de nœuds adéquate. Il gère également des opérations plus larges du cycle de vie des nœuds, y compris la consolidation et le remplacement des nœuds.
4. Démarrage et readiness des Pods
Lorsqu'un Pod atteint son nœud assigné, le kubelet le prépare et démarre ses conteneurs. Les applications peuvent nécessiter un temps d'initialisation avant d'être prêtes à servir du trafic.
Kubernetes fournit plusieurs probes pour gérer cette étape :
- Les startup probes déterminent quand une application s'est correctement initialisée.
- Les readiness probes déterminent quand un Pod doit recevoir du trafic.
- Les liveness probes détectent les conteneurs en cours d'exécution mais défaillants, qui doivent être redémarrés.
Un Pod peut donc être en cours d'exécution sans encore être considéré comme prêt à traiter des requêtes.
5. Fonctionnement et gestion de la santé
Une fois prêts, les Pods exécutent leur workload applicatif tandis que Kubernetes travaille en continu à maintenir l'état déclaré.
Si un conteneur échoue, le kubelet peut le redémarrer selon sa politique de redémarrage. Si un Pod géré par un Deployment ou un StatefulSet disparaît entièrement, le contrôleur de workload peut en créer un remplaçant. Les vérifications de readiness peuvent aussi retirer temporairement les Pods défaillants des endpoints de service sans nécessairement les redémarrer.
6. Autoscaling des workloads
En fonctionnement, Kubernetes peut ajuster la capacité des workloads à mesure que la demande évolue. Les versions actuelles de Kubernetes prennent en charge plusieurs approches plutôt que de reposer sur un mécanisme de scaling unique.
- Horizontal Pod Autoscaler (HPA) : modifie le nombre de réplicas en fonction de métriques CPU, mémoire, personnalisées ou externes.
- Vertical Pod Autoscaler (VPA) : ajuste les requests et limits de ressources selon les besoins du workload. Le VPA s'installe séparément et ne fait pas partie de l'API Kubernetes de base.
- Redimensionnement vertical in-place : Kubernetes peut redimensionner les ressources CPU et mémoire attribuées aux conteneurs sans nécessairement remplacer le Pod. Le scaling vertical in-place des Pods est stable depuis Kubernetes 1.35.
- KEDA : ajoute un autoscaling piloté par les événements, basé sur des sources comme les files d'attente, les systèmes de streaming, les bases de données et les plateformes de monitoring.
KEDA est particulièrement utile lorsque le scaling doit suivre les événements applicatifs plutôt que l'utilisation CPU ou mémoire. Il peut mettre à l'échelle les Deployments, les StatefulSets et d'autres ressources scalables, y compris faire passer les workloads de zéro à un réplica avant d'utiliser le HPA pour aller plus loin. KEDA peut également créer et mettre à l'échelle des Jobs Kubernetes via ScaledJob.
7. Mise à l'échelle et consolidation des nœuds
Une augmentation du nombre de réplicas ne signifie pas automatiquement que les nœuds existants disposent de la place nécessaire pour les exécuter. L'autoscaling des workloads et celui des nœuds fonctionnent donc souvent de concert.
Par exemple :
- Le HPA ou KEDA augmente le nombre de Pods en réponse à la demande.
- Certains nouveaux Pods deviennent non planifiables faute de capacité dans le cluster.
- Un autoscaler de nœuds provisionne des nœuds supplémentaires.
- Le scheduler place les Pods en attente sur la capacité nouvellement disponible.
Le processus fonctionne aussi dans l'autre sens. Lorsque la demande diminue, l'autoscaling des workloads supprime les Pods superflus, et l'autoscaling des nœuds peut consolider l'infrastructure sous-utilisée.
Avec Karpenter, la consolidation peut supprimer ou remplacer les nœuds vides ou sous-utilisés, aidant le cluster à adapter son infrastructure au workload plutôt qu'à maintenir simplement des groupes de nœuds fixes.
8. Mises à jour et rollouts des workloads
Les workloads évoluent fréquemment au cours de leur vie, au gré du déploiement de nouvelles images de conteneurs, configurations, paramètres de ressources ou versions applicatives.
Pour les Deployments, Kubernetes effectue généralement un rolling update : il crée progressivement des Pods basés sur la nouvelle spécification tout en arrêtant les anciens. Les applications restent ainsi disponibles pendant l'introduction d'une nouvelle version. Le comportement du rollout peut être contrôlé via des paramètres comme maxSurge et maxUnavailable.
Les contrôleurs poursuivent la réconciliation du workload jusqu'à ce que les Pods en cours d'exécution correspondent au nouvel état souhaité.
9. Réduction de capacité et arrêt
Les Pods peuvent être arrêtés suite à une suppression manuelle, une réduction de capacité du workload, un rolling update, une perturbation de nœud ou une consolidation de nœuds.
Lors d'un arrêt normal, Kubernetes donne à l'application l'occasion de s'arrêter proprement. Le Pod est retiré du trafic de service normal, les conteneurs reçoivent un signal d'arrêt, et Kubernetes attend la période de grâce configurée avant de forcer l'arrêt des processus restants.
Lorsque la demande baisse, les autoscalers peuvent réduire le nombre de réplicas, et les autoscalers de nœuds comme Karpenter peuvent ensuite consolider ou supprimer la capacité devenue inutile.
Le monitoring des workloads Kubernetes
Le monitoring des workloads Kubernetes ne doit pas se limiter à indiquer si les Pods s'exécutent. L'objectif est d'identifier les problèmes de capacité, l'instabilité applicative, les goulots d'étranglement de planification et les allocations de ressources inefficaces, puis d'exploiter ces constats pour affiner les paramètres de ressources, les politiques d'autoscaling et la configuration des workloads.
Utilisation CPU et mémoire
Les métriques CPU et mémoire aident à déterminer si les workloads disposent de ressources suffisantes pour fonctionner de manière fiable, sans réserver plus de capacité de cluster que nécessaire.
Métriques à surveiller
- Utilisation CPU : CPU réellement consommé par chaque conteneur et Pod.
- Requests CPU : CPU réservé pour la planification.
- Limits CPU : CPU maximal qu'un conteneur peut utiliser, lorsque des limits sont configurées.
- Throttling CPU : temps pendant lequel un conteneur est empêché d'utiliser du CPU supplémentaire parce qu'il a atteint sa limit CPU.
- Utilisation mémoire et working set : mémoire activement consommée par le workload.
- Requests et limits mémoire : mémoire réservée et mémoire maximale autorisée pour le conteneur.
- Tendances d'utilisation : historique des usages, y compris les pics, l'utilisation soutenue et la croissance progressive de la mémoire.
Comparer l'utilisation réelle aux requests est particulièrement utile, car les requests influencent à la fois la planification des Pods et le comportement du Horizontal Pod Autoscaler lorsque des métriques d'utilisation des ressources sont utilisées.
Conseils d'optimisation
Appuyez-vous sur les données d'utilisation pour dimensionner les requests au plus juste, au lieu de vous fier uniquement aux estimations initiales. Les workloads constamment sous-utilisés peuvent avoir des requests inutilement élevées, tandis que ceux qui approchent régulièrement de leurs ressources disponibles peuvent nécessiter davantage de capacité.
Envisagez des actions telles que :
- Ajuster les requests CPU et mémoire pour mieux refléter la demande observée.
- Analyser un throttling CPU soutenu avant d'augmenter simplement les limits.
- Augmenter les limits mémoire lorsque la demande légitime du workload dépasse les paramètres actuels.
- Analyser une croissance régulière de la mémoire à la recherche de fuites potentielles.
- Recourir au HPA, au VPA ou à d'autres mécanismes d'autoscaling lorsque les besoins en ressources varient fortement avec la demande.
- Examiner les percentiles de long terme et les périodes de pointe plutôt que d'optimiser à partir d'un instantané unique.
Redémarrages et défaillances des Pods
Les métriques de redémarrage et de défaillance révèlent une instabilité des workloads qui n'est pas forcément visible dans la phase courante du Pod. Un Pod peut afficher Running alors que l'un de ses conteneurs plante et redémarre en boucle.
Métriques et signaux à surveiller
- Nombre et taux de redémarrages des conteneurs
- Raison de l'arrêt du conteneur
- Codes de sortie
- États actuel et précédent des conteneurs
- Échecs des probes startup, readiness et liveness
- Événements CrashLoopBackOff
- Erreurs de pull d'image et de configuration
- Logs applicatifs avant et après un redémarrage
Suivre les taux de redémarrage dans le temps est généralement plus utile que de réagir à un redémarrage isolé. Des hausses soudaines ou des boucles de redémarrage persistantes sont des indicateurs plus solides d'un problème sous-jacent.
Conseils de dépannage et d'optimisation
La réponse appropriée dépend de la raison du redémarrage du conteneur. Commencez par la raison de l'arrêt, l'état précédent du conteneur, les événements Kubernetes et les logs applicatifs.
Actions courantes :
- Corriger les plantages applicatifs ou les exceptions non gérées.
- Ajuster les probes trop agressives par rapport aux temps de démarrage ou de réponse de l'application.
- Corriger les Secrets, ConfigMaps, volumes ou variables d'environnement manquants.
- Augmenter la mémoire lorsque les redémarrages sont causés par des conditions OOM.
- Analyser l'indisponibilité des services en aval lorsque les défaillances coïncident avec des erreurs de dépendances.
- Passer en revue les déploiements récents lorsque les taux de redémarrage augmentent juste après un rollout.
Évitez de traiter les redémarrages uniquement comme un problème de capacité. Augmenter les ressources ne résoudra pas les défaillances causées par des bugs applicatifs, une configuration invalide ou des probes de santé mal configurées.
Pods en Pending et non planifiables
Des Pods en Pending peuvent indiquer que la demande des workloads a dépassé la capacité disponible du cluster, ou que des contraintes de planification empêchent Kubernetes de trouver un nœud éligible.
Métriques et signaux à surveiller
- Nombre de Pods en Pending
- Durée pendant laquelle les Pods restent en Pending
- Nombre de Pods non planifiables
- Événements du scheduler et raisons de rejet
- CPU, mémoire, GPU et autres ressources demandés
- Capacité disponible sur les nœuds éligibles
- Exigences d'affinité de nœud et de selectors
- Taints et tolerations
- Topology spread constraints
- Conditions de planification et d'attachement des PersistentVolumes
L'âge des Pods en Pending est particulièrement révélateur. De brefs délais de planification peuvent être normaux, tandis que des Pods non planifiables pendant de longues périodes nécessitent généralement une intervention.
Conseils pour résoudre les goulots d'étranglement de planification
Identifiez d'abord si le problème provient d'une capacité insuffisante ou de règles de planification trop restrictives.
Actions possibles :
- Pratiquer le right-sizing des requests lorsque les Pods demandent nettement plus de capacité que nécessaire.
- Corriger les node selectors, règles d'affinité ou tolerations qui restreignent inutilement le placement.
- Revoir les exigences de topology spread lorsque Kubernetes ne trouve pas assez de nœuds éligibles.
- S'assurer que les workloads GPU ou autres workloads spécialisés ont accès à des nœuds compatibles.
- Ajouter de la capacité au cluster lorsque la demande légitime dépasse les ressources disponibles.
- Configurer l'autoscaling des nœuds pour que la nouvelle capacité soit provisionnée automatiquement.
Dans les environnements à mise à l'échelle dynamique, des Pods en Pending persistants doivent aussi déclencher une revue de la couche de provisionnement des nœuds. Par exemple, Karpenter peut provisionner des nœuds en fonction des exigences des Pods non planifiables, mais ses contraintes de NodePool doivent tout de même permettre la création d'une capacité d'instances adaptée.
Conteneurs OOMKilled
OOMKilled indique qu'un conteneur a été arrêté par le mécanisme de gestion out-of-memory du système d'exploitation. Une cause fréquente est un conteneur tentant de consommer plus de mémoire que sa limit configurée ne l'autorise.
Métriques et signaux à surveiller
- Raison d'arrêt du conteneur : OOMKilled
- Code de sortie 137
- Working set mémoire
- Requests et limits mémoire
- Consommation mémoire maximale
- Utilisation mémoire juste avant l'arrêt
- Fréquence des redémarrages après des événements OOM
- Croissance de la mémoire sur le long terme
Les métriques historiques sont particulièrement précieuses, car les métriques courantes d'un conteneur sont réinitialisées après son redémarrage.
Conseils pour prévenir les OOM kills
Commencez par déterminer si l'utilisation mémoire correspond à une demande applicative légitime ou à un comportement anormal.
Optimisations possibles :
- Augmenter les limits mémoire lorsque les workloads normaux nécessitent légitimement plus de capacité.
- Relever les requests mémoire lorsque les Pods consomment systématiquement bien plus de mémoire que demandé.
- Rechercher d'éventuelles fuites mémoire applicatives lorsque l'utilisation croît continuellement dans le temps.
- Limiter la concurrence ou la taille des lots lorsque des requêtes individuelles provoquent de forts pics de mémoire.
- Revoir les caches, les paramètres de heap JVM et la configuration mémoire applicative.
- Exploiter les données d'utilisation historiques pour définir des paramètres de ressources réalistes.
- Évaluer l'autoscaling vertical lorsque les besoins en mémoire évoluent fortement dans le temps.
Augmenter sans cesse les limits mémoire sans identifier la cause peut masquer des problèmes applicatifs et accroître les coûts d'infrastructure. Les modifications de ressources doivent donc s'appuyer sur le comportement du workload et l'historique d'utilisation, et non sur les seuls événements OOM.
Bonnes pratiques de gestion des workloads Kubernetes
Définir des requests et limits de ressources précises
Définissez les requests CPU et mémoire en fonction des besoins réels des workloads. Le scheduler s'appuie sur les requests pour décider où placer les pods : des valeurs trop élevées peuvent gaspiller de la capacité de cluster ou laisser des pods en attente, tandis que des requests trop basses peuvent conduire à des nœuds surchargés.
Utilisez des limits lorsqu'elles offrent une protection utile contre une consommation excessive de ressources. Les limits CPU peuvent provoquer du throttling, tandis que le dépassement d'une limit mémoire peut entraîner un conteneur OOMKilled. Testez les valeurs de limits sous une charge représentative plutôt que de choisir des valeurs arbitraires.
Pratiquer le right-sizing des workloads en continu
Les besoins en ressources évoluent avec le code applicatif, le trafic et les modes d'utilisation. Examinez régulièrement la consommation réelle de CPU et de mémoire et comparez-la aux requests et limits configurées.
Utilisez des métriques historiques plutôt que de courts instantanés pour le right-sizing des workloads. Tenez compte de l'utilisation normale, des pics de demande, des besoins au démarrage et de la croissance attendue. Vous réduirez ainsi la capacité inutilisée sans rendre les applications vulnérables aux pics prévisibles.
Utiliser le contrôleur de workload approprié
Choisissez un contrôleur selon le mode de fonctionnement de l'application. Utilisez des Deployments pour les applications stateless s'exécutant en continu et des StatefulSets lorsque les réplicas nécessitent des identités stables, des opérations ordonnées ou un stockage persistant.
Les DaemonSets conviennent aux logiciels devant s'exécuter sur des nœuds sélectionnés, comme les agents de monitoring ou réseau. Utilisez des Jobs pour les tâches finies et des CronJobs pour l'exécution planifiée. Choisir le bon contrôleur fournit le comportement de cycle de vie attendu sans logique de gestion personnalisée.
Configurer les probes readiness, liveness et startup
Utilisez les readiness probes pour déterminer quand un pod peut recevoir du trafic en toute sécurité. Une readiness probe en échec retire le pod des endpoints de Service sans redémarrer son conteneur, ce qui convient aux conditions temporaires comme les défaillances de dépendances ou l'initialisation.
Utilisez les liveness probes pour détecter les applications incapables de se rétablir sans redémarrage. Les startup probes sont utiles pour les applications dont l'initialisation est longue ou imprévisible, car elles empêchent les vérifications de liveness de redémarrer l'application avant la fin du démarrage.
Configurez soigneusement les chemins, seuils, intervalles et timeouts des probes. Des probes trop agressives peuvent créer des défaillances en redémarrant des applications saines mais temporairement lentes.
Utiliser des Pod Disruption Budgets pour les applications critiques
Un PodDisruptionBudget limite le nombre de réplicas d'une application pouvant être indisponibles lors de perturbations volontaires. Ces perturbations peuvent survenir lors d'opérations telles que le drain de nœuds, la maintenance du cluster ou certaines activités d'autoscaling.
Configurez un budget via minAvailable ou maxUnavailable selon les exigences de redondance de l'application. Un budget ne prévient pas tous les types de défaillance, comme une panne de nœud inattendue, et il ne peut pas garantir la disponibilité si l'application dispose de trop peu de réplicas.
Évitez les budgets qui rendent la maintenance de routine impossible. Le workload a besoin de suffisamment de réplicas sains pour que Kubernetes respecte le budget tout en évinçant les pods en toute sécurité.
Répartir les réplicas entre nœuds et zones de disponibilité
Plusieurs réplicas offrent une protection limitée s'ils s'exécutent tous sur le même nœud ou dans le même domaine de défaillance. Utilisez l'anti-affinité de pods ou les topology spread constraints pour répartir les réplicas entre nœuds, zones ou autres frontières de topologie.
La répartition réduit l'impact des défaillances de nœuds et de zones de disponibilité. Elle peut aussi éviter qu'une maintenance sur un seul nœud ne retire trop de capacité applicative d'un coup.
Trouvez l'équilibre entre exigences de résilience et flexibilité de planification. Des règles de placement strictes peuvent laisser des pods en attente lorsque le cluster ne dispose pas d'assez de nœuds adaptés dans la topologie requise.
Combiner l'autoscaling des workloads et du cluster
L'autoscaling des workloads et celui du cluster répondent à des problèmes de capacité différents. Le HorizontalPodAutoscaler peut augmenter ou diminuer les réplicas applicatifs selon des métriques, tandis que l'autoscaling au niveau des nœuds peut ajuster la capacité du cluster lorsque les pods ne peuvent pas être planifiés avec les ressources existantes.
Ces mécanismes doivent être configurés ensemble. Mettre à l'échelle un Deployment n'a guère d'intérêt si les nouveaux réplicas restent en attente faute de capacité dans le cluster. De même, ajouter des nœuds n'augmente pas automatiquement les réplicas applicatifs lorsque la demande croît.
Des requests précises sont importantes pour les deux mécanismes, car elles influencent les décisions de planification et de capacité. Définissez des plages de scaling raisonnables et surveillez le comportement du scaling afin d'éviter des changements excessifs, des réponses trop lentes à la demande ou une utilisation inutile de l'infrastructure.
FAQ
Qu'est-ce qu'un workload Kubernetes ? Un workload Kubernetes est une application, un service ou une tâche qui s'exécute sur un cluster. Les workloads s'exécutent dans des Pods, mais ils sont généralement gérés via des ressources de plus haut niveau qui indiquent à Kubernetes comment créer, remplacer, mettre à l'échelle, mettre à jour et arrêter ces Pods.
Quels sont les principaux types de workloads Kubernetes ? Les ressources de workload intégrées de base sont les Deployments, StatefulSets, DaemonSets, Jobs, CronJobs et ReplicaSets. Chacune répond à un besoin différent : services stateless, applications stateful, agents au niveau des nœuds, tâches ponctuelles et tâches planifiées.
Quelle est la différence entre un Deployment et un StatefulSet ? Un Deployment gère des applications stateless dont les réplicas de Pods sont interchangeables. Un StatefulSet est destiné aux applications dont les Pods ont besoin de noms stables, d'un ordre prévisible ou de leur propre stockage persistant, comme les bases de données.
Quelle est la différence entre un Job et un CronJob ? Un Job exécute un ou plusieurs Pods jusqu'à ce qu'une tâche se termine avec succès, par exemple une migration de base de données. Un CronJob crée des Jobs selon une planification récurrente écrite en syntaxe cron, ce qui convient aux tâches comme les sauvegardes et la génération de rapports.
Quelle est la différence entre un workload Kubernetes et l'API Workload ? Un workload est la ressource gérée, par exemple un Deployment ou un Job. L'API de workload est l'interface de l'API Kubernetes que les outils, contrôleurs et applications utilisent pour créer, lire, mettre à jour, supprimer et mettre à l'échelle ces ressources.
Pourquoi mon Pod reste-t-il bloqué en Pending ? Des Pods en Pending signifient généralement que le cluster manque de capacité ou que des règles de planification empêchent Kubernetes de trouver un nœud éligible. Vérifiez les événements du scheduler, puis examinez les requests de ressources, les node selectors, les règles d'affinité, les tolerations et les topology spread constraints. L'autoscaling des nœuds peut ajouter de la capacité lorsque la demande est légitime.
Optimiser les workloads Kubernetes avec PerfectScale
PerfectScale by DoiT est une plateforme d'optimisation des ressources pour tous vos clusters Kubernetes. Après un déploiement Helm unique, elle fournit des insights actionnables et une optimisation autonome sur l'ensemble de votre stack K8s, des workloads individuels jusqu'aux nœuds sous-jacents. Elle fonctionne avec des autoscalers tels que HPA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning et Google Autopilot. Elle prend en charge les clouds publics comme EKS, GKE et AKS, les clouds privés comme OpenShift, ainsi que les environnements on-premises et hybrides.
Capacités clés de PerfectScale :
- Right-sizing autonome des workloads : Podfit offre une vue granulaire de la santé et des coûts du cluster, identifie le gaspillage de ressources et les risques de résilience, et fournit des recommandations basées sur les données pour le right-sizing des workloads. Vous pouvez également mettre en place une automatisation pour une optimisation immédiate.
- Recommandations de configuration d'autoscaling : recevez des recommandations actionnables pour améliorer vos configurations HPA et KEDA afin que les workloads suivent efficacement la demande.
- Optimisation des workloads éphémères et ML : right-sizing autonome des workloads éphémères comme Airflow et les Jobs Spark, pour que les environnements dynamiques restent optimisés.
- Automatisation tenant compte des révisions : PerfectScale évalue chaque nouvelle release de code et s'adapte aux besoins changeants des workloads, de sorte que ses optimisations ne contredisent jamais vos évolutions de développement.
- Optimisation au niveau des nœuds : Infrafit offre une visibilité sur l'utilisation des nœuds pour éliminer la capacité inutilisée, sélectionner les bons nœuds pour vos workloads et maximiser l'efficacité des autoscalers de nœuds comme Karpenter.
- Alertes temps réel priorisées : traitez les risques de résilience et les pics de coûts grâce à une priorisation par impact, et recevez des alertes dans Slack, Datadog, MS Teams, PagerDuty et d'autres outils.
- Rapports de tendances et de gouvernance : suivez dans le temps les métriques de coûts, de gaspillage et de risque à travers clusters, groupes de nœuds, namespaces et workloads pour améliorer vos prévisions et vos analyses de cause racine.